
主题
客户端最佳实践
在大量服务端与工具场景下扩展 MCP 宿主应用的模式。
当 MCP 宿主应用(例如智能体)连接到越来越多的 MCP 服务端,并累积获得对成百上千个工具的访问权限时,朴素的工具管理方式就会失效。把所有工具定义预先加载到模型的上下文窗口中会浪费 token、增加延迟,并降低模型性能。在顺序执行的工具调用之间,把庞大的中间结果经由模型传递,会进一步加剧这一问题。
有两种模式可以应对这些挑战:渐进式发现,它控制工具定义何时进入上下文;以及程序化工具调用,它控制工具如何被调用。
渐进式工具发现
朴素的 MCP 宿主实现会在每次对话开始时,把每个已连接服务端的工具定义直接传给模型。对于少量工具而言,这完全合理。但当宿主可以访问数十个服务端、暴露数百个工具时,仅这些定义就可能消耗掉上下文窗口的大部分,而此时模型甚至还没读到用户的消息。
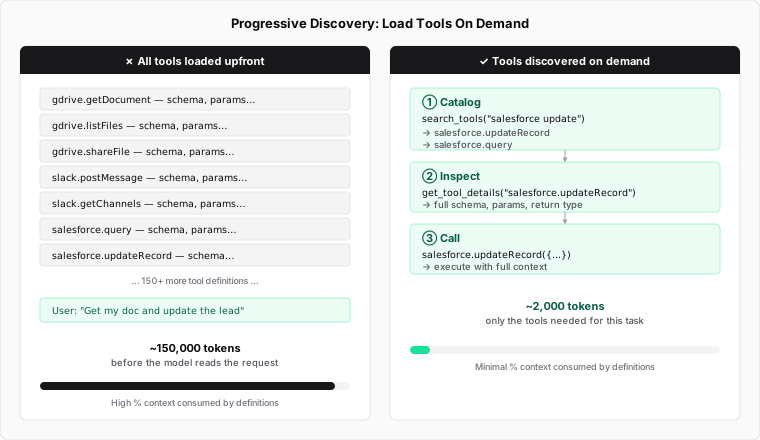
渐进式发现可以避免这一点:
- 宿主照常通过
tools/list获取工具定义,但推迟将其注入模型的上下文。 - 宿主向模型提供一个轻量的
search_tools元工具。 - 宿主仅在需要时才把完整定义加载到上下文中。
何时使用渐进式发现
当工具定义占据上下文窗口的很大一部分时,最适合使用渐进式发现。对于少量工具、且工具定义只占上下文窗口一小部分的情况,加载全部工具没有问题。一旦工具定义占据了可用上下文窗口的显著部分,客户端就应切换到渐进式发现。我们建议客户端实现阈值来决定何时切换:
- 以上下文窗口的百分比形式实现阈值。例如 1%-5%。
- 加载工具定义。一旦达到阈值,就切换到渐进式发现。
选择发现策略
一旦模型调用 search_tools 工具,我们就需要选择一种搜索策略:
- 基于关键词:关键词匹配(BM25、正则)。简单有效,尤其适用于描述性的工具名称和描述。
- 基于嵌入:对工具描述进行向量相似度检索。能更好地处理同义词和语义匹配。
- 基于子智能体:由次级模型(通常是小型快速模型,如 Claude Haiku 或 Gemini Flash)为任务选择工具。这通常效果很好,但可能比基于嵌入或基于关键词的方案成本更高。
- 混合:组合多种方法。例如,跨关键词与嵌入排名进行打分,或根据用例或查询选择不同的策略。
一些模型提供商已经提供内置的工具搜索。例如,OpenAI 和 Anthropic 原生支持这一能力;请查阅你的提供商的文档以了解等效功能。在可用时,你可能更倾向于使用平台的工具搜索,而非自定义实现。当提供商不提供该能力,或你需要专门的检索逻辑(例如领域特定的排序或访问控制过滤)时,再自行构建。
下面的三层模式详细说明了基于自定义搜索的方法,但分层原则(编目、检视、执行)无论采用何种检索机制都适用。
使用渐进式发现
渐进式发现的一种常见实现采用基于搜索的三层方法:
第 1 层:编目。 宿主暴露一小组用于搜索可用能力的元工具。search_tools 工具接受自然语言查询,并返回匹配的工具名称及简要描述。
typescript
// The model calls a lightweight search tool
search_tools({ query: "update salesforce record" })

// Returns concise matches: names and one-line descriptions only
→ [
    { name: "salesforce_updateRecord", description: "Update fields on a Salesforce object" },
    { name: "salesforce_upsertRecord", description: "Insert or update based on external ID" }
]第 2 层:检视。 一旦模型确定了候选工具,它只获取该工具的完整定义(输入 schema、输出 schema、文档)。
typescript
// The model inspects only the tool it needs
get_tool_details({ name: "salesforce_updateRecord" });这会返回单个工具的完整 schema:
json
{
  "name": "salesforce_updateRecord",
  "description": "Updates a record in Salesforce",
  "inputSchema": {
    "type": "object",
    "properties": {
      "objectType": {
        "type": "string",
        "description": "Salesforce object type"
      },
      "recordId": { "type": "string", "description": "Record ID to update" },
      "data": { "type": "object", "description": "Fields to update" }
    },
    "required": ["objectType", "recordId", "data"]
  }
}第 3 层:执行。 模型在完全了解工具接口的情况下调用该工具,且只加载了它需要的定义。
这种模式大幅减少了 token 用量,并能提升工具选择准确率:模型专注于少数相关工具,而不是扫描数百个无关工具。其他发现策略(嵌入、子智能体等)遵循相同的分层原则,只是在编目层替换为不同的检索机制。
动态服务端管理
渐进式发现不仅适用于单个工具,也适用于整个服务端。宿主不必在启动时连接到每个已配置的服务端,而是可以:
- 维护一个可用服务端及其高层描述的注册表。
- 仅当模型确定需要某个服务端的能力时才连接到该服务端。
- 断开与当前任务不再相关的服务端,释放上下文。
sequenceDiagram
    participant Model
    participant Host
    participant Registry
    participant Server

    Model->>Host: search_available_servers("CRM")
    Host->>Registry: Query available servers
    Registry-->>Host: Salesforce server (not connected)
    Host-->>Model: Salesforce server available

    Model->>Host: enable_server("salesforce")
    Host->>Server: server/discover
    Server-->>Host: Supported versions + capabilities
    Host->>Server: tools/list
    Server-->>Host: Tool definitions
    Host-->>Model: Salesforce server connected

    Note over Model: Task complete

    Model->>Host: disable_server("salesforce")
    Host-->>Model: Server disconnected, context freed
这对通用智能体尤其有效,因为用户的意图在开始时并不明确。智能体从一小组始终在线的服务端开始,按需连接其他服务端。结合智能体技能,技能文件可以声明它需要哪些 MCP 服务端,宿主仅在该技能被调用时才连接它们。
实现指南
在实现渐进式发现时:
| 指南 | 理由 |
|---|---|
| 提供多个详细层级 | 让模型在仅名称、名称加描述、或完整 schema 响应之间选择。 |
| 缓存工具定义 | 一旦从服务端获取,就在宿主侧记忆该定义,这样之后重新注入时无需再次往返 tools/list。这与当前位于模型上下文中的内容相互独立。 |
在 list_changed 时刷新 | 当服务端发送 notifications/tools/list_changed 时,重新索引搜索编目。 |
| 按服务端对工具分组 | 按工具来源服务端组织呈现工具,以便模型对相关能力进行推理。 |
缓存
每个列表结果(例如 tools/list),以及每个 server/discover 和 resources/read 结果,都携带 ttlMs 和 cacheScope 提示。请按规范中缓存工具的定义遵循它们。特别地,一旦收到 list_changed 通知,即使其 TTL 尚未到期,也应将缓存的列表视为过期。
与提示缓存(Prompt Caching)的交互
大多数提供商都会缓存提示前缀,包括 tools 数组。在对话中途添加或移除工具定义会使该缓存失效,由此产生的未命中可能比你所移除的定义消耗更多 token。为保持缓存:
- 将新发现的定义追加到缓存断点之后,而不是重新排序
tools数组;或者让每次调用都经由一个稳定的call_tool({name, args})元工具,使该数组永不改变。 - 将服务端断开视为对话边界操作,而非每轮操作。
- 在查阅上述工具搜索链接的同时,也查阅你的提供商的缓存文档。
程序化工具调用 / 代码模式
在直接工具调用中,每次工具调用都是一次往返:模型生成工具调用,客户端执行它,完整结果再流回模型的上下文。当任务需要串联多个工具时(读取文档、转换它、写入其他地方),每个中间结果都要经过模型,即使模型与这些结果毫无关系,也会消耗 token 并增加延迟。
程序化工具调用(有时称为“代码模式”)为客户端提供了一种有效组合工具调用的方式。模型不直接调用工具,而是编写调用工具的代码。代码在沙箱环境中执行,只有最终结果返回给模型。
程序化工具调用功能强大,可以更高效地使用 MCP 工具和资源,但要求客户端实现沙箱环境。
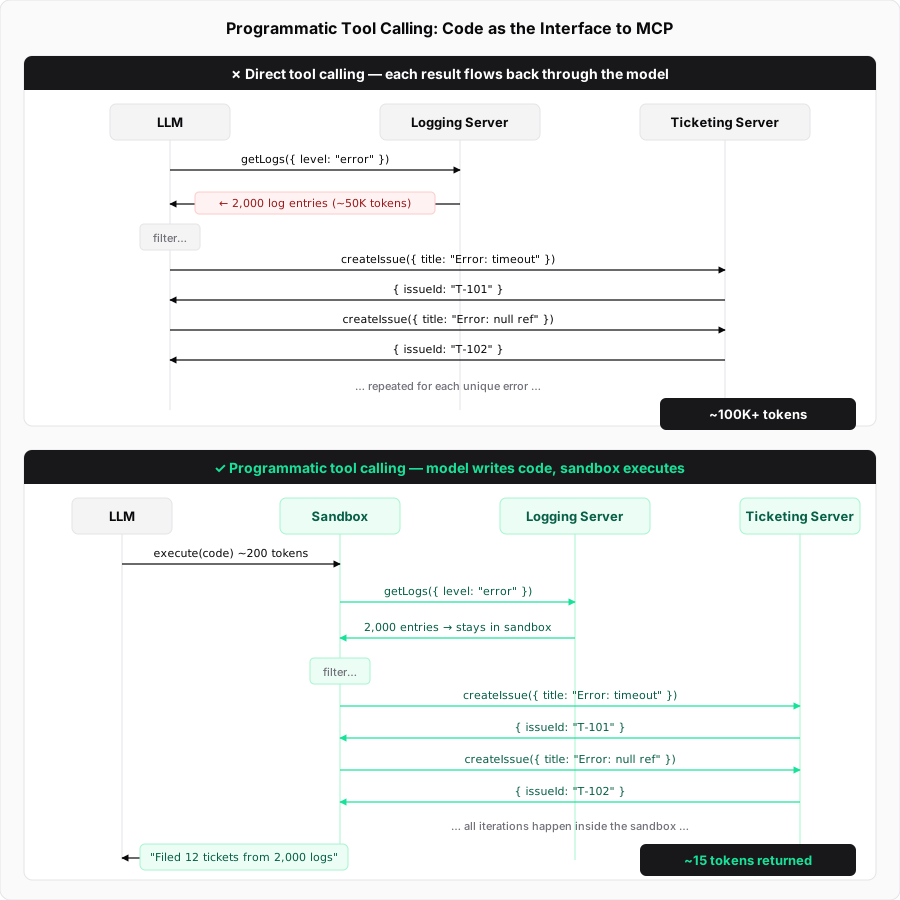
工作原理
宿主把 MCP 工具 schema 转换为沙箱内可用的类型化 API。当模型需要工具时,它编写脚本并执行。
第 1 步:从 MCP schema 生成程序化 API。 宿主读取每个服务端的工具定义,并基于每个工具的参数和 outputSchema 生成类型化函数:
typescript
// Auto-generated from the Logging MCP server's tool schema
interface LogEntry {
  timestamp: string;
  message: string;
  level: string;
}

function logging_getLogs(input: {
  level: "error" | "warn" | "info";
  since: number;
}): Promise<{ entries: LogEntry[] }> {
  return mcp.callTool<{ entries: LogEntry[] }>("logging_getLogs", input);
}

// Auto-generated from the Ticketing MCP server's tool schema
function ticketing_createIssue(input: {
  title: string;
  body?: string;
  priority: "low" | "medium" | "high";
}): Promise<{ issueId: string }> {
  return mcp.callTool<{ issueId: string }>("ticketing_createIssue", input);
}MCP 服务端可以为每个工具提供可选的 outputSchema。当存在输出 schema 时,宿主可以生成精确的返回类型(如上面的 LogEntry)。
当缺少输出 schema 时,优先采用简单路径:
- 使用泛型类型并继续。 接受
any或string,并在下游处理非结构化输出。真正的解决办法是由服务端作者提供outputSchema。 - 使用快速模型提取类型化结果,适用于循环之外的单次调用。通过与被 MCP 工具调用相同的桩拦截路径,暴露一个由宿主代理的
extract(value, ExpectedType)辅助函数,使沙箱本身永不打开网络连接。该辅助函数路由到一个小型模型(例如 Claude Haiku 或 Gemini Flash),将值强制转换为ExpectedType。这会增加每次调用的延迟,并可能产生幻觉或丢失字段,因此在使用前应针对ExpectedType校验结果。
第 2 步:模型针对这些 API 编写代码。 模型不进行多次工具调用并在其间让完整结果流经上下文,而是编写单个脚本。考虑这样一个任务:“找出过去一小时内的所有错误日志,并为每个唯一错误提交一个工单。”在直接工具调用下,数千条日志条目会流经模型的上下文。使用代码时,模型在沙箱内进行过滤:
typescript
// Model-generated code, executes in sandbox
const logs = await logging_getLogs({
  level: "error",
  since: Date.now() - 3600000,
});

// Filter and deduplicate inside the sandbox, not in the model's context
const uniqueErrors = new Map<string, LogEntry>();
for (const log of logs.entries) {
  if (!uniqueErrors.has(log.message)) {
    uniqueErrors.set(log.message, log);
  }
}

for (const [message, log] of uniqueErrors) {
  await ticketing_createIssue({
    title: `Error: ${message}`,
    body: `First seen: ${log.timestamp}\nOccurrences: ${
      logs.entries.filter((l) => l.message === message).length
    }`,
    priority: "high",
  });
}

console.log(
  `Filed ${uniqueErrors.size} tickets from ${logs.entries.length} error logs`,
);第 3 步:沙箱执行代码。 沙箱内的函数调用被拦截,并通过宿主代理路由回相应的 MCP 服务端。日志数据和工单创建直接在服务端之间流动,从不进入模型的上下文。只有 console.log 输出,即一行摘要,返回给模型。
选择沙箱
合适的沙箱取决于你希望模型编写哪种语言、你的宿主应用的语言,以及你需要的隔离程度。下表列出的是示例运行时,而非推荐;请根据你的用例评估其成熟度:
| 沙箱语言 | 运行时 / 库 | 宿主语言 | 方式 |
|---|---|---|---|
| JavaScript | Deno、isolated-vm | Rust / Node / CLI | 基于 V8 的运行时,具有细粒度权限。可以禁用所有权限以实现完全锁定。 |
| Python | Monty (实验性) | Rust | 为 AI 用例构建的极简 Python 解释器。默认无 I/O。 |
| TypeScript | pctx (早期阶段) | Python / Rust | 以库的形式整合代码模式概念,并提供底层 Rust 支持。 |
| 任意(通过 Wasm) | Wasmtime | Rust / C / Go | 将任意语言编译为 Wasm,并以基于能力的安全模型运行。 |
无论采用哪种沙箱,集成模式都相同:宿主注入函数桩,通过进程内或 stdio 通道拦截调用(这样网络权限可以保持完全拒绝),并将它们作为 tools/call 请求分派给 MCP 服务端。
执行架构
该实现包含三个组件:
flowchart LR
    subgraph Host["MCP Host"]
        A[LLM] -->|writes code| B[Sandbox]
        B -->|function call| C[MCP Client]
        C -->|return value| B
        B -->|console output| A
    end
    C -->|tool call| D[MCP Server A]
    C -->|tool call| E[MCP Server B]
    D -->|result| C
    E -->|result| C
沙箱在无直接网络访问的隔离环境中运行模型生成的代码。它与外部世界的唯一接口是通过生成的函数桩,这些桩将调用路由回宿主。
宿主充当代理。它接收来自沙箱的函数调用,将它们映射到正确的 MCP 服务端,执行工具调用,并把结果返回给沙箱。授权 token 和凭据由宿主持有,绝不暴露给生成的代码。
模型只能看到沙箱返回的内容,通常是 console.log 语句的输出或最终返回值。这使模型(以及客户端开发者)能够精确控制进入上下文窗口的内容。
安全考量
程序化工具调用引入了代码执行面,需要谨慎的沙箱化:
- 逐调用授权:就规范而言,代理仍然是 MCP 宿主。对源自沙箱的调用,应施加与直接调用相同的人在环确认策略(参见工具:安全)。批准脚本并不等于对其运行时发起的每次工具调用给予一揽子批准;宿主可以给予分类批准(例如“本次脚本运行允许
ticketing_createIssue”),而不是每次迭代都提示,但代理仍必须针对该授权评估每次调用。 - 跨服务端数据流:来自一个服务端的工具结果对另一个服务端而言是不可信输入。代理应对经代理的调用施加与直接调用相同的输入审查策略;仅靠输出截断并不能防止数据外泄。
- 网络隔离:沙箱不应有直接网络访问。所有外部通信都经由宿主代理,由它执行授权和访问控制。
- 不暴露凭据:API 密钥和 token 由宿主持有。生成的代码调用类型化函数;宿主在转发到服务端时添加认证。
- 资源限制:对沙箱执行设置超时和内存限制,以防止脚本失控。
- 输出过滤:在把沙箱控制台输出反馈给模型之前,对其进行校验和截断。
错误处理
MCP 工具错误以带有 isError: true 的成功响应形式到达,而不是传输失败。生成的包装器应将其转换为抛出的异常,以便模型编写的代码可以使用 try/catch。如果未捕获的错误终止了脚本,应将其作为脚本结果呈现,以便模型自我纠正;模型负责报告任何已提交的部分副作用。
组合使用两种模式
渐进式发现与程序化工具调用可以很好地协同工作。模型使用发现工具确定它需要哪些工具,加载它们的 schema,然后编写一个脚本在一次执行中调用多个工具。这种组合同时最小化了工具定义的 token 成本和工具结果的 token 成本,使模型的上下文专注于推理,而不是在其间传递数据。