
主题
概述
欢迎!
LangChain4j 的目标,是把 LLM 集成到 Java 应用的过程尽量简化。
它是这样做到的:
- 统一的 API: LLM 提供者(如 OpenAI 或 Google Vertex AI)以及嵌入(向量)存储(如 Pinecone 或 Milvus) 都使用各自专有的 API。LangChain4j 提供统一的 API,使你无需为每一家学习和实现专用接口。 想要尝试不同的 LLM 或嵌入存储时,可以在它们之间轻松切换,而无需重写代码。 LangChain4j 目前已支持 20 多个主流 LLM 提供者 和 30 多个嵌入存储。
- 完备的工具箱: 自 2023 年初以来,社区构建了大量由 LLM 驱动的应用, 并沉淀出许多通用的抽象、模式与技术。LangChain4j 已将它们打磨为一套开箱即用的组件。 我们的工具箱涵盖从底层的提示词模板、聊天记忆管理、函数调用, 到高层的智能体(Agents)与 RAG 等模式。 针对每一个抽象,我们都提供一个接口,并附带多种基于常见技术的开箱即用实现。 无论你是在构建聊天机器人,还是开发一套从数据摄入到检索的完整 RAG 流水线, LangChain4j 都提供了丰富的选择。
- 大量示例: 这些 示例 演示了如何着手构建各类 LLM 驱动的应用, 为你提供灵感,让你能迅速开始开发。
LangChain4j 的开发始于 2023 年初 ChatGPT 热潮之际。 我们注意到,面对数量众多的 Python 和 JavaScript LLM 库与框架,Java 世界缺少对应品, 我们必须补上这一空白!
并非 LangChain (Python) 的移植
尽管名字相近,但 LangChain4j 并不是 LangChain (Python) 的 Java 移植版——它是为 Java 而生,而非移植而来。 它是一个地道的 Java 库,从底层就围绕 Java 的惯例设计: 类型安全、POJO、注解、接口、依赖注入、流式 API,以及对 Quarkus、Spring Boot、 Helidon 和 Micronaut 的一流集成。 它的 API、内部实现与发布节奏都与 Python 版 LangChain 项目相互独立。
我们持续关注社区的动态,力求尽快纳入新的技术与集成, 让你始终站在前沿。 本库正处于活跃开发中。虽然部分特性仍在完善, 但核心功能已经就绪,你现在就可以开始构建 LLM 驱动的应用!
为了更便捷地集成,LangChain4j 还提供与 Quarkus、Spring Boot、Helidon 和 Micronaut 的集成
LangChain4j 特性
- 集成 20 多个 LLM 提供者
- 集成 30 多个嵌入(向量)存储
- 集成 20 多个嵌入模型
- 集成 5 多个聊天记忆存储
- 集成 5 多个图像生成模型
- 集成 5 多个评分(重排序)模型
- 集成一个内容审核模型(OpenAI)
- 支持文本与图像作为输入(多模态)
- AI 服务(高层 LLM API)
- 智能体与 Agentic AI
- 技能(Skills)
- 提示词模板
- 持久化与内存态 聊天记忆 算法的实现:消息窗口与词元窗口
- LLM 响应的流式传输
- 面向常用 Java 类型与自定义 POJO 的输出解析器
- 工具(函数调用)
- 动态工具(执行动态生成的 LLM 代码)
- RAG(检索增强生成):
- 摄入:
- 从多种来源(文件系统、URL、GitHub、Azure Blob Storage、Amazon S3 等)导入各类文档(TXT、PDF、DOC、PPT、XLS 等)
- 使用多种切分算法将文档切分为更小的片段
- 对文档和片段进行后处理
- 使用嵌入模型对片段做嵌入
- 将嵌入存入嵌入(向量)存储
- 检索(简单与高级):
- 查询变换(扩展、压缩)
- 查询路由
- 从向量存储及任意自定义来源检索
- 重排序
- 倒数排名融合(Reciprocal Rank Fusion)
- 自定义 RAG 流程中的每一步
- 摄入:
- 文本分类
- 用于词元化与词元计数估算的工具
- Kotlin 扩展:借助 Kotlin 协程能力,对聊天交互进行异步非阻塞处理。
两个抽象层级
LangChain4j 运作在两个抽象层级上:
- 底层。在这一层,你拥有最大的自由度,可以访问所有底层组件,例如 ChatModel、
UserMessage、AiMessage、EmbeddingStore、Embedding等。 它们是你的 LLM 驱动应用的“原子构件”。 你可以完全掌控如何组合它们,但需要编写更多的胶水代码。 - 高层。在这一层,你通过 AI 服务 这样的高层 API 与 LLM 交互, 它把所有的复杂性与样板代码都对你隐藏起来。 你仍然保留调整与微调行为的灵活性,只是这一切都以声明式的方式完成。
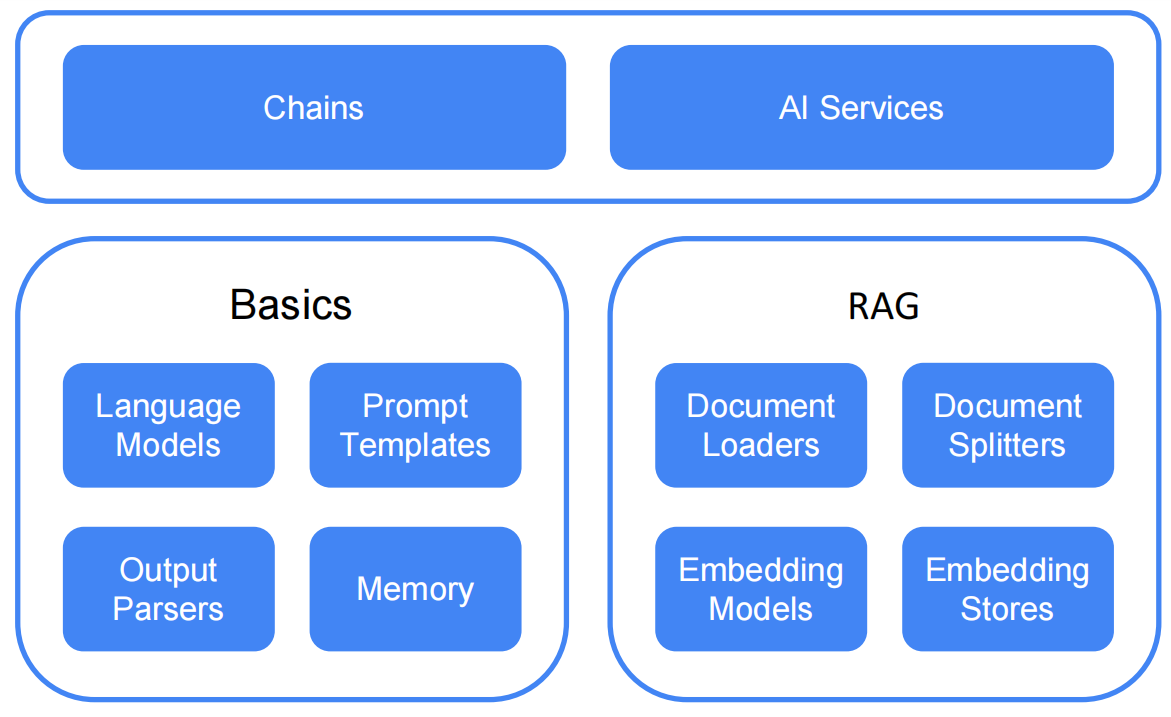
LangChain4j 库结构
LangChain4j 采用模块化设计,包含:
langchain4j-core模块,它定义了核心抽象(例如ChatModel和EmbeddingStore)及其 API。- 主
langchain4j模块,包含诸如文档加载器、聊天记忆 实现等实用工具,以及 AI 服务 这样的高层特性。 - 一大批
langchain4j-{integration}模块,每个模块都将各家 LLM 提供者与嵌入存储集成到 LangChain4j。 你可以独立使用langchain4j-{integration}模块。若需要更多特性,只需再引入主langchain4j依赖即可。
LangChain4j 代码仓库
使用场景
你可能会问:我为什么需要这一切? 下面举一些例子:
- 你想实现一个自定义的、由 AI 驱动的聊天机器人,它能访问你的数据并按你期望的方式行事:
- 客服聊天机器人,能够:
- 礼貌地回答客户问题
- 受理/更改/取消订单
- 教育助手,能够:
- 教授各种学科
- 讲解不清楚的部分
- 评估用户的理解程度/知识水平
- 客服聊天机器人,能够:
- 你想处理大量非结构化数据(文件、网页等),并从中抽取结构化信息。 例如:
- 从客户评价和客服聊天历史中提炼洞见
- 从竞争对手网站中提取有价值的信息
- 从求职者的简历中提炼洞见
- 你想生成信息,例如:
- 为每一位客户量身定制的邮件
- 为你的应用/网站生成内容:
- 博客文章
- 故事
- 你想转换信息,例如:
- 摘要
- 校对与改写
- 翻译
社区集成
LangChain4j 在社区仓库 中维护了一些集成。 它们提供与主仓库中集成相同的功能。 二者唯一的区别在于:社区仓库的构件(artifact)与包名不同于主仓库(即在构件名和包名中带有 community 前缀)。 创建社区仓库是为了将部分集成的维护分离出来,从而更容易维护主仓库。