
主题
RAG(检索增强生成)
LLM 的知识限于它被训练时所用的数据。若你想让 LLM 了解领域专有知识或内部数据,你可以:
- 使用 RAG,本节我们将讲解
- 用你的数据对 LLM 做微调
- 把 RAG 与微调结合起来
什么是 RAG?
简单地说,RAG 就是找出你数据中相关的信息片段,并在发送给 LLM 之前注入到提示词里的方法。这样 LLM 就能获得(希望是)相关的信息,并能够用这些信息来回复,从而应能降低产生幻觉的概率。
相关的信息片段可以用各种信息检索方法找到。最流行的有:
- 全文(关键词)搜索。这种方法使用像 TF-IDF 与 BM25 这样的技术 通过匹配查询(例如用户在问什么)中的关键词与文档库来搜索文档。它依据这些关键词在每个文档中出现的频率与相关性对结果排序。
- 向量搜索,也称"语义搜索"。 文本文档用嵌入模型被转换为数值向量。随后它依据查询向量与文档向量之间的余弦相似度或其他相似度/距离度量来查找并排序文档,从而捕捉更深层的语义。
- 混合。组合多种搜索方法(例如 全文 + 向量)通常能提升搜索的效果。
目前,本页主要聚焦向量搜索。全文与混合搜索目前仅由 Azure AI Search 集成与 Elasticsearch 支持,详见 AzureAiSearchContentRetriever 与 ElasticsearchContentRetriever。我们计划在不久的将来把 RAG 工具箱扩展到包含全文与混合搜索。
RAG 的阶段
RAG 过程分为两个独立的阶段:索引与检索。LangChain4j 为两个阶段都提供了工具。
索引
在索引阶段,文档会被预处理,以便在检索阶段支持高效搜索。
这个过程会因所用信息检索方法而异。对向量搜索,通常包括清理文档、用额外数据与元数据丰富它们、把它们切分为更小的片段(即分块)、将这些片段嵌入,并最终存入嵌入存储(即向量数据库)。
索引阶段通常离线进行,意味着不需要终端用户等待其完成。这可以通过例如一个 cron 定时任务在周末每周重新索引一次公司内部文档来实现。负责索引的代码也可以是一个只处理索引任务的独立应用。
然而,在某些场景下,终端用户可能想上传他们自己的文档,好让 LLM 能够访问。这种情况下,索引应在线进行,并成为主应用的一部分。
下面是索引阶段的一个简化图: 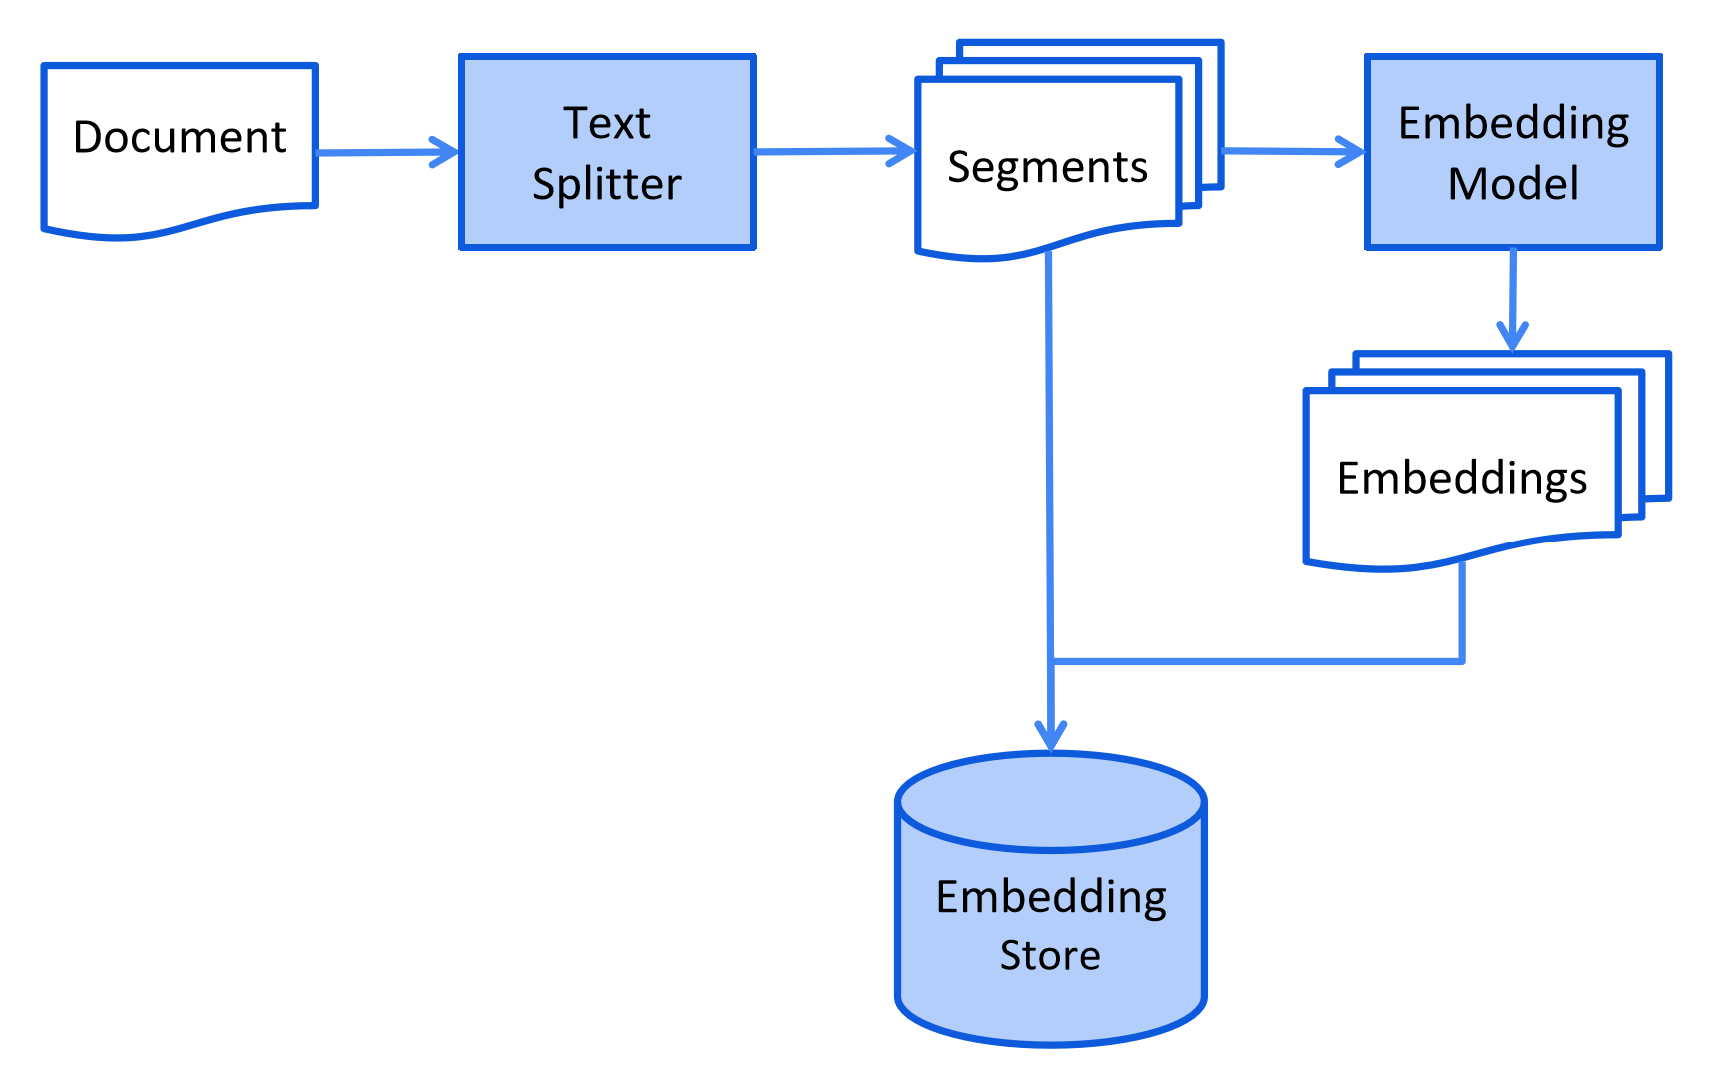
检索(Retrieval)
检索阶段通常在线进行,在用户提交一个需要用已索引文档来回答的问题时。
这个过程会因所用信息检索方法而异。对向量搜索,通常包括嵌入用户的查询(问题)并在嵌入存储中做相似度搜索。随后相关的片段(原文档的片段)被注入提示词并发送给 LLM。
下面是检索阶段的一个简化图: 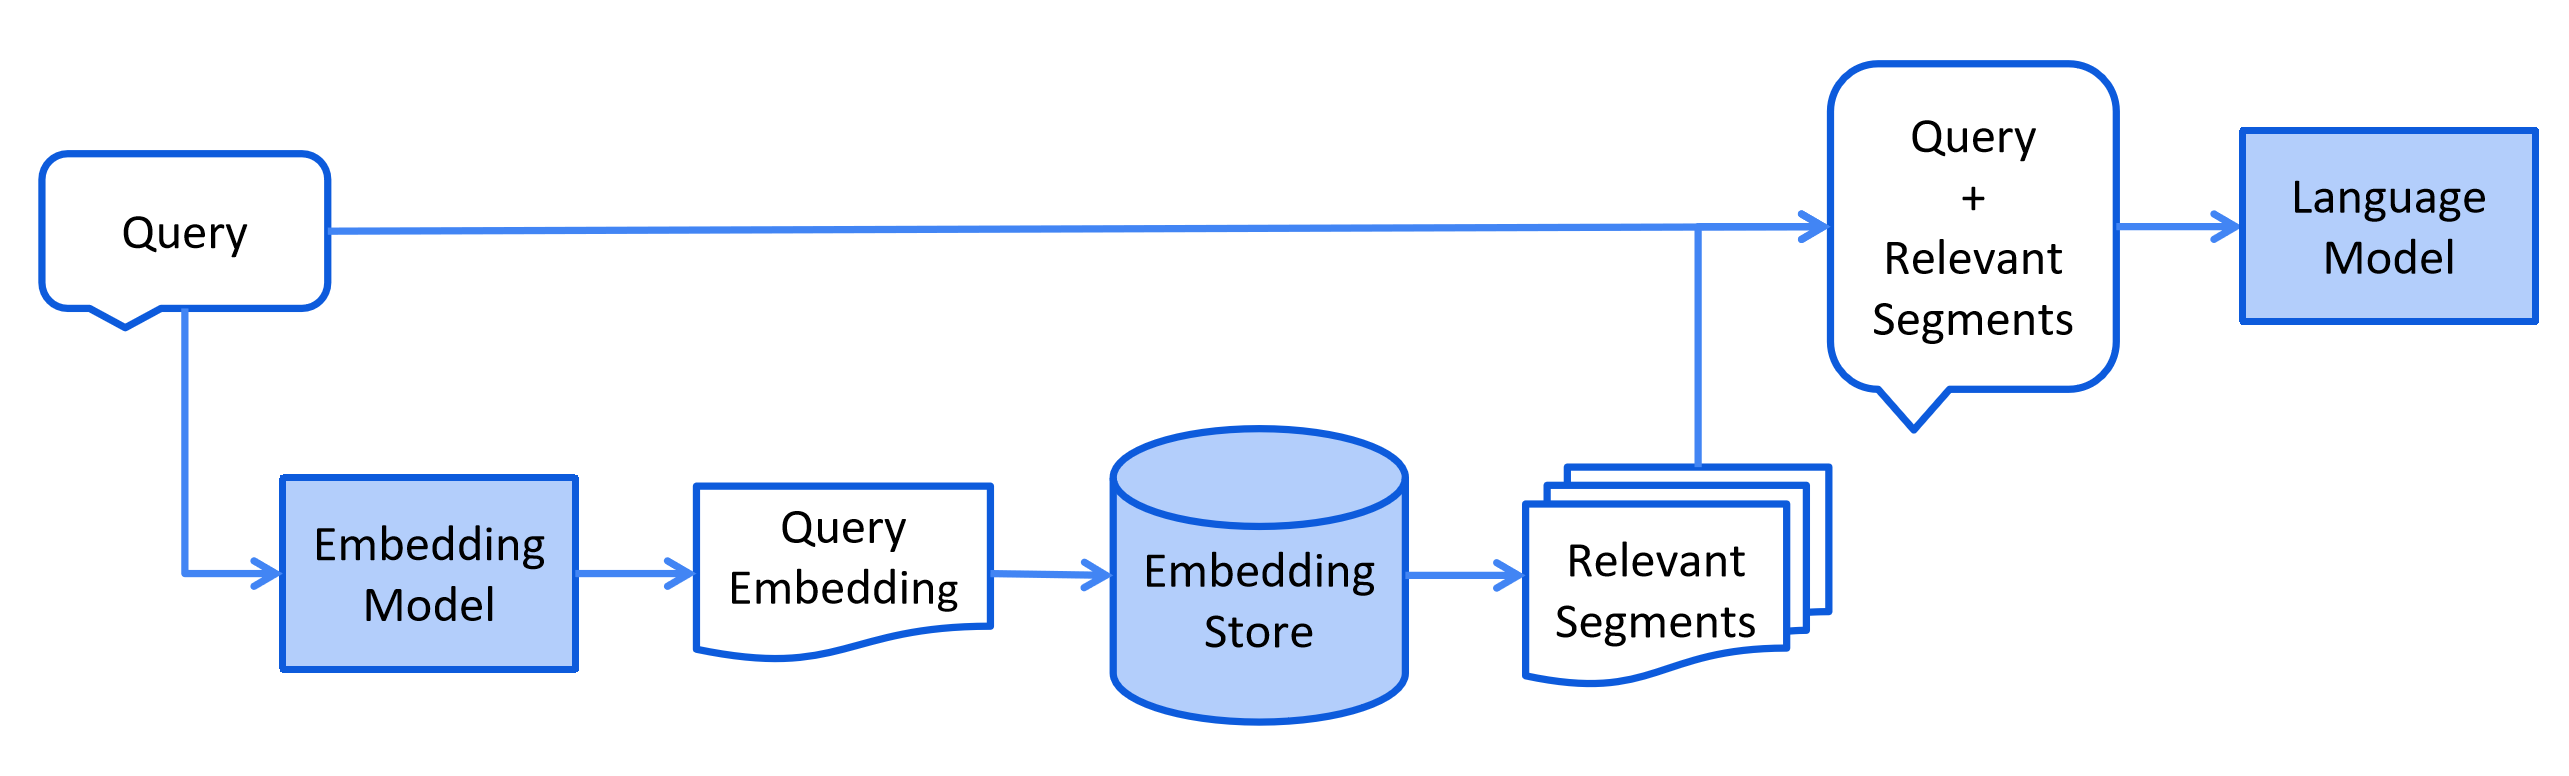
LangChain4j 中的 RAG 风味
LangChain4j 提供三种 RAG 风味:
- Easy RAG:上手 RAG 最简单的方式
- Naive RAG:一个使用向量搜索的 RAG 基础实现
- Advanced RAG:一个模块化的 RAG 框架,允许额外的步骤,例如 查询转换、从多个来源检索,以及重排序
Easy RAG
LangChain4j 有一个"Easy RAG"特性,让上手 RAG 尽可能容易。你不必了解嵌入、选择向量库、找到合适的嵌入模型、琢磨如何解析和切分文档等。只要指向你的文档,LangChain4j 就会施展魔法。
若你需要可定制的 RAG,请跳到下一节。
如果你使用 Quarkus,还有一种更简单的 Easy RAG 方式。请阅读 Quarkus 文档。
NOTE
这种"Easy RAG"的质量,当然会低于一个量身定做的 RAG 配置。但这是学习 RAG 和/或做一个概念验证最简单的方式。之后,你能从 Easy RAG 平滑过渡到更高级的 RAG,逐步调整和定制越来越多的方面。
- 导入
langchain4j-easy-rag依赖:
xml
<dependency>
    <groupId>dev.langchain4j</groupId>
    <artifactId>langchain4j-easy-rag</artifactId>
    <version>1.22.0-beta32</version>
</dependency>- 让我们加载你的文档:
java
List<Document> documents = FileSystemDocumentLoader.loadDocuments("/home/langchain4j/documentation");这会加载指定目录下的所有文件。
What is happening under the hood?
The Apache Tika library, which supports a wide variety of document types, is used to detect document types and parse them. Since we did not explicitly specify which DocumentParser to use, the FileSystemDocumentLoader will load an ApacheTikaDocumentParser, provided by langchain4j-easy-rag dependency through SPI.
如何定制文档加载?
若你想从所有子目录加载文档,可以使用 loadDocumentsRecursively 方法:
java
List<Document> documents = FileSystemDocumentLoader.loadDocumentsRecursively("/home/langchain4j/documentation");此外,你可以用 glob 或 regex 过滤文档:
java
PathMatcher pathMatcher = FileSystems.getDefault().getPathMatcher("glob:*.pdf");
List<Document> documents = FileSystemDocumentLoader.loadDocuments("/home/langchain4j/documentation", pathMatcher);NOTE
当使用 loadDocumentsRecursively 方法时,你可能想在 glob 中用双星号(而非单个):glob:**.pdf。
- 现在,我们需要预处理文档,并把它们存入一个专门的嵌入存储,也称向量数据库。 这很有必要,好在用户提问时能快速找到相关的信息片段。我们可以用我们 30 多个受支持的嵌入存储中的任何一个,但为简单起见,这里用内存版:
java
InMemoryEmbeddingStore<TextSegment> embeddingStore = new InMemoryEmbeddingStore<>();
EmbeddingStoreIngestor.ingest(documents, embeddingStore);What is happening under the hood?
EmbeddingStoreIngestor通过 SPI 从langchain4j-easy-rag依赖加载一个DocumentSplitter。 每个Document被切分为更小的片段(TextSegment),每段至多 300 个词元,并有 30 词元的重叠。EmbeddingStoreIngestor通过 SPI 从langchain4j-easy-rag依赖加载一个EmbeddingModel。 每个TextSegment用EmbeddingModel被转换为一个Embedding。
NOTE
我们选择了 bge-small-en-v1.5 作为 Easy RAG 的默认嵌入模型。它在 MTEB 排行榜上取得了亮眼分数,且其量化版仅占 24 兆空间。因此我们可以轻松把它加载进内存,并用 ONNX Runtime 在同一进程内运行。
没错,你可以完全离线、不依赖任何外部服务,在同一个 JVM 进程内把文本转换为嵌入。LangChain4j 提供了一些流行的嵌入模型开箱即用。
- 所有
TextSegment-Embedding对被存入EmbeddingStore。
- 最后一步是创建一个 AI 服务,作为我们通往 LLM 的 API:
java
interface Assistant {

    String chat(String userMessage);
}

ChatModel chatModel = OpenAiChatModel.builder()
    .apiKey(System.getenv("OPENAI_API_KEY"))
    .modelName(GPT_4_O_MINI)
    .build();

Assistant assistant = AiServices.builder(Assistant.class)
    .chatModel(chatModel)
    .chatMemory(MessageWindowChatMemory.withMaxMessages(10))
    .contentRetriever(EmbeddingStoreContentRetriever.from(embeddingStore))
.build();这里,我们配置 Assistant 使用一个 OpenAI LLM 来回答用户问题、记住会话中最近 10 条消息,并从含有我们文档的 EmbeddingStore 中检索相关内容。
- 现在我们可以和它聊天了!
java
String answer = assistant.chat("How to do Easy RAG with LangChain4j?");RAG 核心 API
LangChain4j 提供了丰富的 API 集,让你能轻松构建自定义 RAG 流水线,从简单的到高级的都有。本节我们讲解主要的领域类与 API。
Document
Document 类表示一个完整文档,例如单个 PDF 文件或一个网页。目前,Document 只能表示文本信息,但未来的更新也将让它支持图像与表格。
常用方法
Document.text()返回Document的文本Document.metadata()返回Document的Metadata(见下文"Metadata"一节)Document.toTextSegment()把Document转换为一个TextSegment(见下文"TextSegment"一节)Document.from(String, Metadata)从文本与Metadata创建一个DocumentDocument.from(String)从文本创建一个Metadata为空的Document
元数据
每个 Document 都含有 Metadata。它存储关于该 Document 的元信息,例如其名称、来源、最后更新日期、所有者,或任何其他相关细节。
Metadata 以键值 map 存储,键为 String 类型,值可以是以下类型之一:String、Integer、Long、Float、Double、UUID。
Metadata 在多个方面很有用:
- 当把
Document的内容包含进给 LLM 的提示词时, 也可以包含元数据条目,为 LLM 提供可参考的额外信息。例如,提供Document名称与来源能帮助提升 LLM 对内容的理解。 - 当搜索相关内容以包含进提示词时, 可以按
Metadata条目过滤。例如,你可以把语义搜索收窄到只属于某个特定所有者的Document。 - 当
Document的来源被更新时(例如某个特定的文档页面), 可以通过其元数据条目(例如 "id"、"source" 等)轻松定位对应的Document,并在EmbeddingStore中同步更新它。
常用方法
Metadata.from(Map)从一个Map创建MetadataMetadata.put(String key, String value)/put(String, int)等,向Metadata添加条目Metadata.putAll(Map)向Metadata添加多个条目Metadata.getString(String key)/getInteger(String key)等,返回Metadata条目的值,并转型为所需类型Metadata.containsKey(String key)检查Metadata是否含有指定键的条目Metadata.remove(String key)按键从Metadata移除条目Metadata.copy()返回Metadata的一份副本Metadata.toMap()把Metadata转换为一个MapMetadata.merge(Metadata)把当前Metadata与另一个Metadata合并
Document Loader
你可以从一个 String 创建 Document,但更简单的方法是使用库内自带的文档加载器之一:
- 来自
langchain4j模块的FileSystemDocumentLoader - 来自
langchain4j模块的ClassPathDocumentLoader - 来自
langchain4j模块的UrlDocumentLoader - 来自
langchain4j-document-loader-amazon-s3模块的AmazonS3DocumentLoader - 来自
langchain4j-document-loader-azure-storage-blob模块的AzureBlobStorageDocumentLoader - 来自
langchain4j-document-loader-github模块的GitHubDocumentLoader - 来自
langchain4j-document-loader-google-cloud-storage模块的GoogleCloudStorageDocumentLoader - 来自
langchain4j-document-loader-selenium模块的SeleniumDocumentLoader - 来自
langchain4j-document-loader-playwright模块的PlaywrightDocumentLoader - 来自
langchain4j-document-loader-tencent-cos模块的TencentCosDocumentLoader
文档解析器
Document 可以表示各种格式的,如 PDF、DOC、TXT 等。要解析这些格式,有一个 DocumentParser 接口,库内自带若干实现:
- 来自
langchain4j模块的TextDocumentParser,可解析纯文本格式的文件(例如 TXT、HTML、MD 等) - 来自
langchain4j-document-parser-apache-pdfbox模块的ApachePdfBoxDocumentParser,可解析 PDF 文件 - 来自
langchain4j-document-parser-apache-poi模块的ApachePoiDocumentParser,可解析 MS Office 文件格式 (例如 DOC、DOCX、PPT、PPTX、XLS、XLSX 等) - 来自
langchain4j-document-parser-apache-tika模块的ApacheTikaDocumentParser, 它能自动检测并解析几乎所有现有的文件格式 - 来自
langchain4j-document-parser-docling模块的DoclingDocumentParser, 它使用 Docling Java 与 Docling 来处理文档。 - 来自
langchain4j-document-parser-markdown模块的MarkdownDocumentParser, 可解析 markdown 格式的文件 - 来自
langchain4j-document-parser-yaml模块的YamlDocumentParser, 可解析 yaml 格式的文件
下面是一个如何从文件系统加载一个或多个 Document 的示例:
java
// Load a single document
Document document = FileSystemDocumentLoader.loadDocument("/home/langchain4j/file.txt", new TextDocumentParser());

// Load all documents from a directory
List<Document> documents = FileSystemDocumentLoader.loadDocuments("/home/langchain4j", new TextDocumentParser());

// Load all *.txt documents from a directory
PathMatcher pathMatcher = FileSystems.getDefault().getPathMatcher("glob:*.txt");
List<Document> documents = FileSystemDocumentLoader.loadDocuments("/home/langchain4j", pathMatcher, new TextDocumentParser());

// Load all documents from a directory and its subdirectories
List<Document> documents = FileSystemDocumentLoader.loadDocumentsRecursively("/home/langchain4j", new TextDocumentParser());你也可以在不显式指定 DocumentParser 的情况下加载文档。那种情况下,会使用一个默认的 DocumentParser。默认的通过 SPI 加载(例如来自 langchain4j-document-parser-apache-tika 或 langchain4j-easy-rag,若导入了其中之一)。若通过 SPI 找不到任何 DocumentParser,则以 TextDocumentParser 作为回退。
文档转换器
DocumentTransformer 的实现可以执行多种文档转换,例如:
- 清洗:这包括从
Document的文本中去除不必要的噪声,从而节省词元、减少干扰。 - 过滤:把某些特定的
Document完全排除在搜索之外。 - 丰富:可以向
Document添加额外信息,以提升搜索结果。 - 摘要:可以对
Document做摘要,并把简短摘要存入Metadata以便后续包含进每个TextSegment(下文讲解)中,从而改善搜索。 - 等等。
在这一阶段也可以添加、修改或移除 Metadata 条目。
目前,唯一开箱即用的实现是 langchain4j-document-transformer-jsoup 模块中的 HtmlToTextDocumentTransformer,它能从原始 HTML 中抽取所需的文本内容与元数据条目。
由于没有放之四海而皆准的解决方案,我们推荐针对你独一无二的数据,实现你自己的 DocumentTransformer。
图转换器
GraphTransformer 是一个接口,它通过抽取语义图元素(如节点与关系),把非结构化的 Document 对象转换为结构化的 GraphDocument。它非常适合把原始文本转换为结构化的语义图
GraphTransformer 把原始文档转换为 GraphDocument。这些文档包括:
- 一组节点(
GraphNode),表示文本中的实体或概念。 - 一组关系(
GraphEdge),表示这些实体如何相连。 - 作为
source的原始Document。
默认实现是 LLMGraphTransformer,它用语言模型(例如 OpenAI)借助提示词工程从自然语言中抽取图信息。
主要收益
- 实体与关系抽取:识别关键概念及其语义连接。
- 图表示:输出可直接集成进知识图谱或图数据库。
- 模型驱动的解析:用大语言模型从非结构化文本中推断结构。
Maven 依赖
xml
<dependency>
  <groupId>dev.langchain4j</groupId>
  <artifactId>langchain4j-community-llm-graph-transformer</artifactId>
  <version>${latest version here}</version>
</dependency>用法示例
java
import dev.langchain4j.data.document.Document;
import dev.langchain4j.model.openai.OpenAiChatModel;
import dev.langchain4j.community.data.document.graph.GraphDocument;
import dev.langchain4j.community.data.document.graph.GraphNode;
import dev.langchain4j.community.data.document.graph.GraphEdge;
import dev.langchain4j.community.data.document.transformer.graph.GraphTransformer;
import dev.langchain4j.community.data.document.transformer.graph.llm.LLMGraphTransformer;

import java.time.Duration;
import java.util.Set;

public class GraphTransformerExample {
    public static void main(String[] args) {
        // Create a GraphTransformer backed by an LLM
        GraphTransformer transformer = new LLMGraphTransformer(
            OpenAiChatModel.builder()
                .apiKey(System.getenv("OPENAI_API_KEY"))
                .timeout(Duration.ofSeconds(60))
                .build()
        );

        // Input document
        Document document = Document.from("Barack Obama was born in Hawaii and served as the 44th President of the United States.");

        // Transform the document
        GraphDocument graphDocument = transformer.transform(document);

        // Access nodes and relationships
        Set<GraphNode> nodes = graphDocument.nodes();
        Set<GraphEdge> relationships = graphDocument.relationships();

        nodes.forEach(System.out::println);
        relationships.forEach(System.out::println);
    }
}输出示例
GraphNode(name=Barack Obama, type=Person)
GraphNode(name=Hawaii, type=Location)
GraphEdge(from=Barack Obama, predicate=was born in, to=Hawaii)

GraphEdge(from=Barack Obama, predicate=served as, to=President of the United States)文本片段
一旦你的 Document 被加载,就该把它们切分(分块)为更小的片段了。LangChain4j 的领域模型中有一个 TextSegment 类,表示 Document 的一个片段。顾名思义,TextSegment 只能表示文本信息。
切分还是不切分?
有几方面原因让你希望只把少数相关片段、而非整个知识库放进提示词:
- LLM 有有限的上下文窗口,整个知识库可能装不下
- 你在提示词中提供的信息越多,LLM 处理和响应所需时间越长
- 你在提示词中提供的信息越多,付费越多
- 提示词中的无关信息可能干扰 LLM,增加产生幻觉的概率
- 你在提示词中提供的信息越多,越难解释 LLM 的回答基于哪条信息
我们可以通过把知识库切分为更小、更易消化的片段来应对这些问题。这些片段该多大?这是个好问题。一如既往地,视情况而定。
目前有两种被广泛使用的方法:
- 每个文档(例如一个 PDF 文件、一个网页等)都是原子的、不可分割的。 在 RAG 流水线的检索期间,会检索出 N 个最相关的文档并注入提示词。这种情况下你多半需要使用长上下文 LLM,因为文档可能相当长。若检索完整文档对你很重要——例如你不能漏掉某些细节时——这种方式很合适。
- 优点:不丢失任何上下文。
- 缺点:
- 消耗更多词元。
- 有时,文档包含多个章节/主题,并非全部与查询相关。
- 向量搜索的质量会受损,因为大小不一的完整文档被压缩成了一个固定长度的向量。
- 文档被切分为更小的片段,例如章节、段落,有时甚至句子。 在 RAG 流水线的检索期间,会检索出 N 个最相关的片段并注入提示词。挑战在于确保每个片段提供足够的上下文/信息让 LLM 能理解。缺失上下文会导致 LLM 误解给定的片段并产生幻觉。一种常见策略是用带重叠的方式把文档切分为片段,但这不能完全解决问题。有一些高级技术可以在这里帮忙,例如"句子窗口检索"、"自动合并检索"以及"父文档检索"。这里不展开细节,但本质上,这些方法有助于围绕检索到的片段拉取更多上下文,为 LLM 提供检索片段前后方的额外信息。
- 优点:
- 向量搜索质量更好。
- 词元消耗更少。
- 缺点:仍可能丢失一些上下文。
常用方法
TextSegment.text()返回TextSegment的文本TextSegment.metadata()返回TextSegment的MetadataTextSegment.from(String, Metadata)从文本与Metadata创建一个TextSegmentTextSegment.from(String)从文本创建一个Metadata为空的TextSegment
文档切分器
LangChain4j 有一个 DocumentSplitter 接口,自带若干开箱即用的实现:
DocumentByParagraphSplitterDocumentByLineSplitterDocumentBySentenceSplitterDocumentByWordSplitterDocumentByCharacterSplitterDocumentByRegexSplitter- 递归:
DocumentSplitters.recursive(...)
它们的工作方式如下:
- 你实例化一个
DocumentSplitter,指定期望的TextSegment大小,以及可选的、 以字符或词元计的重叠量。 - 你调用
DocumentSplitter的split(Document)或splitAll(List<Document>)方法。 DocumentSplitter把给定的Document切分为更小的单元, 这些单元的性质随切分器而异。例如,DocumentByParagraphSplitter把文档划分为段落(由两个或更多连续换行符界定),而DocumentBySentenceSplitter使用 OpenNLP 库的句子检测器把文档切分为句子,以此类推。- 随后
DocumentSplitter把这些更小的单元(段落、句子、词等)组合成TextSegment, 尽量在单个TextSegment中容纳尽可能多的单元,而不超过第 1 步设定的上限。若某些单元仍然太大、装不进一个TextSegment,它会调用一个子切分器。那是另一个能把装不下的单元切分得更细的DocumentSplitter。所有Metadata条目都会从Document复制到每个TextSegment。每个文本片段会被加上一个唯一元数据条目 "index"。第一个TextSegment含有index=0,第二个index=1,依此类推。
文本片段转换器
TextSegmentTransformer 与 DocumentTransformer(上文所述)类似,但它转换的是 TextSegment。
与 DocumentTransformer 一样,没有放之四海而皆准的解决方案,所以我们推荐针对你独一无二的数据,实现你自己的 TextSegmentTransformer。
有一个能显著改善检索的技巧,就是在每个 TextSegment 中包含 Document 的标题或一段简短摘要。
嵌入
Embedding 类封装了一个数值向量,代表被嵌入内容(通常是文本,例如一个 TextSegment)的"语义"。
关于向量嵌入的更多内容请阅读这里:
- https://www.elastic.co/what-is/vector-embedding
- https://www.pinecone.io/learn/vector-embeddings/
- https://cloud.google.com/blog/topics/developers-practitioners/meet-ais-multitool-vector-embeddings
常用方法
Embedding.dimension()返回嵌入向量的维度(其长度)CosineSimilarity.between(Embedding, Embedding)计算两个Embedding之间的余弦相似度Embedding.normalize()归一化嵌入向量(就地)
嵌入模型
EmbeddingModel 接口代表一种把文本转换为 Embedding 的特殊模型。
当前受支持的嵌入模型见这里。
常用方法
EmbeddingModel.embed(String)嵌入给定文本EmbeddingModel.embed(TextSegment)嵌入给定的TextSegmentEmbeddingModel.embedAll(List<TextSegment>)嵌入所有给定的TextSegmentEmbeddingModel.dimension()返回该模型产出的Embedding的维度
请求/响应 API 与逐次调用参数
除上述便捷方法外,EmbeddingModel 还接受一个 EmbeddingRequest 并返回一个 EmbeddingResponse,这让你能传入逐次调用参数:
java
EmbeddingResponse response = embeddingModel.embed(EmbeddingRequest.builder()
    .input("What is the capital of France?")
    .inputType(EmbeddingInputType.QUERY) // query vs document, see the section below
    .dimensions(256)                     // reduce output dimensionality (on models that support it)
    .build());

List<Embedding> embeddings = response.embeddings();逐次调用参数是严格选择接入的:每个提供者通过 supportedParameters() 声明它支持什么。若一个请求使用了模型不支持的参数,它会快速失败并抛出 UnsupportedFeatureException,而不是静默忽略。另见查询与文档嵌入。
多模态嵌入
一些模型把图像(以及文本+图像交错)嵌入同一个向量空间。用 Content 块构建输入;在支持的模型上(Cohere Embed v4、Voyage 多模态、Google Gemini Embedding 2、Amazon Titan Multimodal、Jina CLIP 等),这些块会被融合为一个嵌入:
java
EmbeddingResponse response = embeddingModel.embed(EmbeddingRequest.builder()
    .input(TextContent.from("a photo of a cat"), ImageContent.from("https://example.com/cat.png"))
.build());模型通过 supportedContentTypes() 声明它支持的模态;把图像传给纯文本模型会快速失败并抛出 UnsupportedFeatureException。EmbeddingModel 的可观测性(监听器)在可观测性教程中讲解。
嵌入存储
EmbeddingStore 接口是 Embedding 的存储,也称向量数据库。它支持存储并高效检索相似(在嵌入空间中邻近)的 Embedding。
当前受支持的嵌入存储见这里。
EmbeddingStore 可以只存 Embedding,也可以连同对应的 TextSegment 一起存:
- 它可以只按 ID 存储
Embedding。原始被嵌入数据可存于别处,用 ID 关联。 - 它可以同时存储
Embedding与被嵌入的原始数据(通常是TextSegment)。
常用方法
EmbeddingStore.add(Embedding)把给定的Embedding加入存储并返回一个随机 IDEmbeddingStore.add(String id, Embedding)把给定的Embedding连同指定 ID 加入存储EmbeddingStore.add(Embedding, TextSegment)把给定的Embedding连同关联的TextSegment加入存储并返回一个随机 IDEmbeddingStore.addAll(List<Embedding>)把一组给定的Embedding加入存储并返回随机 ID 列表EmbeddingStore.addAll(List<Embedding>, List<TextSegment>)把一组给定的Embedding连同各自关联的TextSegment加入存储并返回随机 ID 列表EmbeddingStore.addAll(List<String> ids, List<Embedding>, List<TextSegment>)把一组给定的Embedding连同各自指定的 ID 与TextSegment加入存储EmbeddingStore.search(EmbeddingSearchRequest)搜索最相似的EmbeddingEmbeddingStore.remove(String id)按 ID 从存储移除单个EmbeddingEmbeddingStore.removeAll(Collection<String> ids)从存储移除所有 ID 出现在给定集合中的Embedding。EmbeddingStore.removeAll(Filter)从存储移除所有匹配指定Filter的EmbeddingEmbeddingStore.removeAll()从存储移除全部Embedding
EmbeddingSearchRequest
EmbeddingSearchRequest 表示一次在 EmbeddingStore 中的搜索请求。它有如下属性:
Embedding queryEmbedding:作为参照的嵌入。int maxResults:返回的最大结果数。这是可选参数。默认:3。double minScore:最低分数,范围 0 到 1(含)。只有分数 >=minScore的嵌入会被返回。这是可选参数。默认:0。Filter filter:搜索期间施加于Metadata的过滤器。只有Metadata匹配该Filter的TextSegment会被返回。
Filter
Filter 允许在向量搜索时按 Metadata 条目过滤。
目前,以下 Filter 类型/操作受支持:
IsEqualToIsNotEqualToIsGreaterThanIsGreaterThanOrEqualToIsLessThanIsLessThanOrEqualToIsInIsNotInContainsStringAndNotOr
NOTE
并非所有嵌入存储都支持按 Metadata 过滤,请见这里的"Filtering by Metadata"列。
一些支持按 Metadata 过滤的存储并不支持所有可能的 Filter 类型/操作。例如,ContainsString 目前仅由 Milvus、PgVector 与 Qdrant 支持。
关于 Filter 的更多细节可在这里找到。
EmbeddingSearchResult
EmbeddingSearchResult 表示一次在 EmbeddingStore 中的搜索结果。它包含一个 EmbeddingMatch 列表。
Embedding Match
EmbeddingMatch 表示一个被匹配的 Embedding,连同它的相关性分数、ID 与原始被嵌入数据(通常是 TextSegment)。
嵌入存储摄入器
EmbeddingStoreIngestor 表示一个摄入流水线,负责把 Document 摄入到 EmbeddingStore。
在最简单的配置中,EmbeddingStoreIngestor 用指定的 EmbeddingModel 嵌入提供的 Document,并把它们连同各自的 Embedding 存入指定的 EmbeddingStore:
java
EmbeddingStoreIngestor ingestor = EmbeddingStoreIngestor.builder()
        .embeddingModel(embeddingModel)
        .embeddingStore(embeddingStore)
        .build();

ingestor.ingest(document1);
ingestor.ingest(document2, document3);
IngestionResult ingestionResult = ingestor.ingest(List.of(document4, document5, document6));EmbeddingStoreIngestor 中所有 ingest() 方法都返回一个 IngestionResult。IngestionResult 含有有用的信息,包括 TokenUsage,显示嵌入使用了多少词元。
可选地,EmbeddingStoreIngestor 可以用指定的 DocumentTransformer 转换 Document。若你想在嵌入前清洗、丰富或格式化 Document,这会很有用。
可选地,EmbeddingStoreIngestor 可以用指定的 DocumentSplitter 把 Document 切分为 TextSegment。当 Document 很大、你想把它们切分为更小的 TextSegment 以提升相似度搜索质量、并减少发送给 LLM 的提示词大小与成本时,这会很有用。
可选地,EmbeddingStoreIngestor 可以用指定的 TextSegmentTransformer 转换 TextSegment。若你想在嵌入前清洗、丰富或格式化 TextSegment,这会很有用。
一个示例:
java
EmbeddingStoreIngestor ingestor = EmbeddingStoreIngestor.builder()

    // adding userId metadata entry to each Document to be able to filter by it later
    .documentTransformer(document -> {
        document.metadata().put("userId", "12345");
        return document;
    })

    // splitting each Document into TextSegments of 1000 tokens each, with a 200-token overlap
    .documentSplitter(DocumentSplitters.recursive(1000, 200, new OpenAiTokenCountEstimator("gpt-4o-mini")))

    // adding a name of the Document to each TextSegment to improve the quality of search
    .textSegmentTransformer(textSegment -> TextSegment.from(
            textSegment.metadata().getString("file_name") + "\n" + textSegment.text(),
            textSegment.metadata()
    ))

    .embeddingModel(embeddingModel)
    .embeddingStore(embeddingStore)
.build();查询与文档嵌入(选择接入)
一些嵌入模型(例如 Cohere Embed v4、Voyage、Google)在文档与查询以不同方式嵌入时能取得更好的检索质量。你可以声明输入类型来接入:在 EmbeddingStoreIngestor 上(针对被索引的片段)用 DOCUMENT,在 EmbeddingStoreContentRetriever 上(针对查询)用 QUERY,见 Embedding Store Content Retriever。
java
EmbeddingStoreIngestor ingestor = EmbeddingStoreIngestor.builder()
    .embeddingModel(embeddingModel)
    .embeddingStore(embeddingStore)
    .embeddingInputType(EmbeddingInputType.DOCUMENT)
.build();当未设置 embeddingInputType 时,不发送任何输入类型。设置后,所选的 EmbeddingModel 必须支持该输入类型参数(见其 supportedParameters()),否则嵌入会快速失败并抛出 UnsupportedFeatureException。
朴素 RAG
一旦我们的文档被摄入(见前几节),我们可以创建一个 EmbeddingStoreContentRetriever 来启用朴素 RAG 功能。
当使用 AI 服务 时,可以按如下方式配置朴素 RAG:
java
ContentRetriever contentRetriever = EmbeddingStoreContentRetriever.builder()
    .embeddingStore(embeddingStore)
    .embeddingModel(embeddingModel)
    .maxResults(5)
    .minScore(0.75)
    .build();

Assistant assistant = AiServices.builder(Assistant.class)
    .chatModel(model)
    .contentRetriever(contentRetriever)
.build();高级 RAG
高级 RAG 可以用 LangChain4j 的以下核心组件实现:
QueryTransformerQueryRouterContentRetrieverContentAggregatorContentInjector
下图展示了这些组件如何协同工作: 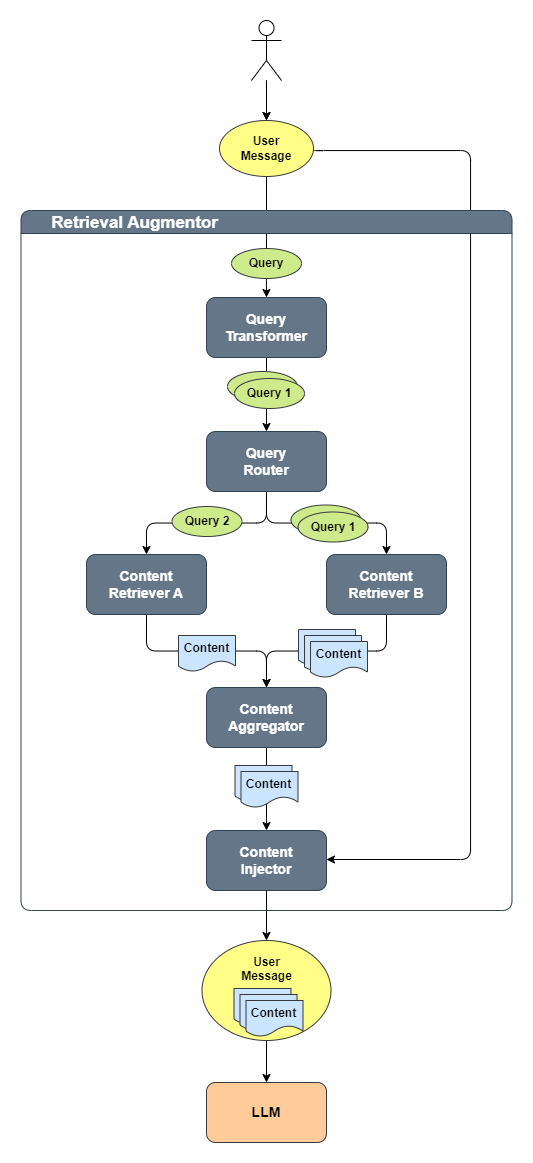
过程如下:
- 用户产生一个
UserMessage,它被转换为一个Query QueryTransformer把该Query转换成一个或多个Query- 每个
Query由QueryRouter路由到一个或多个ContentRetriever - 每个
ContentRetriever为每个Query检索相关的Content ContentAggregator把所有检索到的Content合并为一个最终的排序列表- 这个
Content列表被注入原始的UserMessage - 最后,含有原始查询与所注入相关内容的
UserMessage被发送给 LLM
更多细节请参考各组件的 Javadoc。
检索增强器
RetrievalAugmentor 是进入 RAG 流水线的入口点。它负责用从各类来源检索到的相关 Content 来增强一个 ChatMessage。
可以在创建 AI 服务 时指定一个 RetrievalAugmentor 实例:
java
Assistant assistant = AiServices.builder(Assistant.class)
    ...
    .retrievalAugmentor(retrievalAugmentor)
.build();每次调用 AI 服务时,指定的 RetrievalAugmentor 都会被调用来增强当前的 UserMessage。
你可以使用 RetrievalAugmentor 的默认实现(下文描述),也可以实现一个自定义的。
默认检索增强器
LangChain4j 提供了 RetrievalAugmentor 接口的一个开箱即用实现:DefaultRetrievalAugmentor,它应能适配绝大多数 RAG 用例。它的灵感来自这篇文章与这篇论文。建议阅读这些资料以更好地理解该概念。
Query
Query 表示 RAG 流水线中的用户查询。它含有查询的文本与查询元数据。
查询元数据
Query 内的 Metadata 含有在 RAG 流水线各组件中可能有用的信息,例如:
Metadata.userMessage()- 应被增强的原始UserMessageMetadata.chatMemoryId()- 带@MemoryId注解的方法参数的值。更多细节见这里。它可用于识别用户并在检索期间施加访问限制或过滤。Metadata.chatMemory()- 此前所有的ChatMessage。它能帮助理解该Query被提出时的上下文。Metadata.invocationParameters()- 含有调用 AI 服务时可以指定的InvocationParameters:
java
interface Assistant {
    String chat(@UserMessage String userMessage, InvocationParameters parameters);
}

InvocationParameters parameters = InvocationParameters.from(Map.of("userId", "12345"));
String response = assistant.chat("Hello", parameters);InvocationParameters 也能在 AI 服务的其他组件中被访问,例如:
@Tool注解方法ToolProvider:在ToolProviderRequest内ToolArgumentsErrorHandler与ToolExecutionErrorHandler:在ToolErrorContext内
参数存储在一个可变、线程安全的 Map 中。
在 AI 服务的单次调用期间,数据可以在各 AI 服务组件之间经由 InvocationParameters 传递(例如从一个 RAG 组件传到另一个,或从 RAG 组件传到工具)。
查询转换器
QueryTransformer 把给定的 Query 转换成一个或多个 Query。目标是通过修改或扩展原始 Query 来提升检索质量。
一些已知的改善检索的方法包括:
- 查询压缩
- 查询扩展
- 查询改写
- 回退提示(step-back prompting)
- 假设文档嵌入(HyDE)
更多细节可在这里找到。
LangChain4j 还有一个可选的社区 Prompt Repetition 模块,提供 RepeatingQueryTransformer。它在内容检索之前重复检索查询,应当用于转换查询本身,而不是发送给模型的最终增强提示词。
默认查询转换器
DefaultQueryTransformer 是 DefaultRetrievalAugmentor 使用的默认实现。它不对 Query 做任何修改,只是原样传递。
压缩查询转换器
CompressingQueryTransformer 用一个 LLM 把给定的 Query 与此前对话压缩为一个独立的 Query。当用户可能提出引用先前问题或答案的追问时,这很有用。
这里是一个示例:
User: Tell me about John Doe
AI: John Doe was a ...
User: Where did he live?单独的查询 Where did he live? 无法检索到所需信息,因为其中没有对 John Doe 的显式指代,不清楚 he 指的是谁。
使用 CompressingQueryTransformer 时,LLM 会阅读整段对话,并把 Where did he live? 转换为 Where did John Doe live?。
扩展查询转换器
ExpandingQueryTransformer 用一个 LLM 把给定的 Query 扩展为多个 Query。这很有用,因为 LLM 能以各种方式重新措辞和重构 Query,从而帮助检索到更多相关内容。
Content
Content 表示与用户 Query 相关的内容。目前它限于文本内容(即 TextSegment),但未来可能支持其他模态(例如图像、音频、视频等)。
内容检索器
ContentRetriever 用给定的 Query 从一个底层数据源检索 Content。该底层数据源几乎可以是任何东西:
- 嵌入存储
- 全文搜索引擎
- 向量 + 全文的混合搜索
- 网页搜索引擎
- 知识图谱
- SQL 数据库
- 等等。
ContentRetriever 返回的 Content 列表按相关性从高到低排序。
嵌入存储内容检索器
EmbeddingStoreContentRetriever 用 EmbeddingModel 嵌入 Query,从 EmbeddingStore 检索相关 Content。
这里是一个示例:
java
EmbeddingStore embeddingStore = ...
EmbeddingModel embeddingModel = ...

ContentRetriever contentRetriever = EmbeddingStoreContentRetriever.builder()
    .embeddingStore(embeddingStore)
    .embeddingModel(embeddingModel)
    .maxResults(3)
     // maxResults can also be specified dynamically depending on the query
    .dynamicMaxResults(query -> 3)
    .minScore(0.75)
     // minScore can also be specified dynamically depending on the query
    .dynamicMinScore(query -> 0.75)
    .filter(metadataKey("userId").isEqualTo("12345"))
    // filter can also be specified dynamically depending on the query
    .dynamicFilter(query -> {
        String userId = query.metadata().invocationParameters().get("userId");
        return metadataKey("userId").isEqualTo(userId);
    })
    .build();

interface Assistant {
    String chat(@UserMessage String userMessage, InvocationParameters parameters);
}

InvocationParameters parameters = InvocationParameters.from(Map.of("userId", "12345"));
String response = assistant.chat("Hello", parameters);要以 input_type=query 嵌入查询(与摄入器的 DOCUMENT 配对,见查询与文档嵌入),请在检索器上设置输入类型:
java
ContentRetriever contentRetriever = EmbeddingStoreContentRetriever.builder()
    .embeddingStore(embeddingStore)
    .embeddingModel(embeddingModel)
    .embeddingInputType(EmbeddingInputType.QUERY)
.build();默认行为不变(不发送输入类型)。EmbeddingModel 必须支持 input_type 参数。
网页搜索内容检索器
WebSearchContentRetriever 用 WebSearchEngine 从网页检索相关 Content。
所有受支持的 WebSearchEngine 集成可在这里找到。
这里是一个示例:
java
WebSearchEngine googleSearchEngine = GoogleCustomWebSearchEngine.builder()
        .apiKey(System.getenv("GOOGLE_API_KEY"))
        .csi(System.getenv("GOOGLE_SEARCH_ENGINE_ID"))
        .build();

ContentRetriever contentRetriever = WebSearchContentRetriever.builder()
        .webSearchEngine(googleSearchEngine)
        .maxResults(3)
.build();完整示例可在这里找到。
SQL 数据库内容检索器
SqlDatabaseContentRetriever 是 ContentRetriever 的一个实验性实现,位于 langchain4j-experimental-sql 模块。
它用 DataSource 与一个 LLM,为给定的自然语言 Query 生成并执行 SQL 查询。
更多信息见 SqlDatabaseContentRetriever 的 javadoc。
这里是一个示例。
Azure AI Search 内容检索器
AzureAiSearchContentRetriever 是与 Azure AI Search 的集成。它支持全文、向量与混合搜索,也支持重排序。它位于 langchain4j-azure-ai-search 模块。更多信息请参考 AzureAiSearchContentRetriever 的 Javadoc。
Neo4j 内容检索器
Neo4jContentRetriever 是与 Neo4j 图数据库的集成。它把自然语言查询转换为 Neo4j Cypher 查询,并在 Neo4j 中运行这些查询来检索相关信息。它位于 langchain4j-community-neo4j-retriever 模块。
Elasticsearch 内容检索器
ElasticsearchContentRetriever 是与 Elasticsearch 的集成。它支持全文、向量与混合搜索。它位于 langchain4j-elasticsearch 模块。更多信息请参考 ElasticsearchContentRetriever 的 Javadoc。
查询路由器
QueryRouter 负责把 Query 路由到合适的 ContentRetriever。
默认查询路由器
DefaultQueryRouter 是 DefaultRetrievalAugmentor 使用的默认实现。它把每个 Query 路由到所有已配置的 ContentRetriever。
语言模型查询路由器
LanguageModelQueryRouter 用 LLM 来决定把给定的 Query 路由到哪里。
决策模型查询路由器
DecisionModelQueryRouter 用一个决策模型来决定哪些 ContentRetriever 能帮助回答给定的 Query。当没有一个能帮上时,不执行检索。
内容聚合器
ContentAggregator 负责聚合来自以下情况的多个 Content 排序列表:
- 多个
Query - 多个
ContentRetriever - 两者皆有
默认内容聚合器
DefaultContentAggregator 是 ContentAggregator 的默认实现,执行两阶段的倒数排名融合(RRF)。更多细节见 DefaultContentAggregator Javadoc。
重排序内容聚合器
ReRankingContentAggregator 用一个 ScoringModel(如 Cohere)执行重排序。也可以用决策模型,配合 DecisionScoringModel。受支持的打分(重排序)模型完整列表见这里。更多细节见 ReRankingContentAggregator Javadoc。
内容注入器
ContentInjector 负责把 ContentAggregator 返回的 Content 注入 UserMessage。
默认内容注入器
DefaultContentInjector 是 ContentInjector 的默认实现,它只是把 Content 追加到 UserMessage 末尾,并带有前缀 Answer using the following information:。
你可以用 3 种方式定制 Content 注入 UserMessage 的方式:
- 覆盖默认的
PromptTemplate:
java
RetrievalAugmentor retrievalAugmentor = DefaultRetrievalAugmentor.builder()
    .contentInjector(DefaultContentInjector.builder()
        .promptTemplate(PromptTemplate.from("{{userMessage}}\n{{contents}}"))
        .build())
.build();请注意,PromptTemplate 必须含有 与 变量。
- 继承
DefaultContentInjector并覆盖某个format方法 - 实现一个自定义的
ContentInjector
DefaultContentInjector 也支持从检索到的 Content.textSegment() 注入 Metadata 条目:
java
DefaultContentInjector.builder()
    .metadataKeysToInclude(List.of("source"))
.build()那种情况下,TextSegment.text() 会被冠以 "content: " 前缀,且 Metadata 中每个值都会被冠以其键。最终的 UserMessage 会像这样:
How can I cancel my reservation?

Answer using the following information:
content: To cancel a reservation, go to ...
source: ./cancellation_procedure.html

content: Cancellation is allowed for ...
source: ./cancellation_policy.html并行化
当只有一个 Query 和一个 ContentRetriever 时,DefaultRetrievalAugmentor 在同一线程内执行查询路由与内容检索。其他情况下,会用一个 Executor 来并行处理。默认使用一个经过修改的(keepAliveTime 为 1 秒而非 60 秒)Executors.newCachedThreadPool(),但你可以在创建 DefaultRetrievalAugmentor 时提供一个自定义的 Executor 实例:
java
DefaultRetrievalAugmentor.builder()
        ...
        .executor(executor)
.build;访问来源
若你想在使用 AI 服务 时访问来源(用于增强消息的、检索到的 Content),只需把返回类型包装进 Result 类即可轻松做到:
java
interface Assistant {

    Result<String> chat(String userMessage);
}

Result<String> result = assistant.chat("How to do Easy RAG with LangChain4j?");

String answer = result.content();
List<Content> sources = result.sources();流式时,可以用 onRetrieved() 方法指定一个 Consumer<List<Content>>:
java
interface Assistant {

    TokenStream chat(String userMessage);
}

assistant.chat("How to do Easy RAG with LangChain4j?")
    .onRetrieved((List<Content> sources) -> ...)
    .onPartialResponse(...)
    .onCompleteResponse(...)
    .onError(...)
.start();控制存入聊天记忆的内容
当把 RetrievalAugmentor 与 AI 服务 一起使用时,你可以控制是增强后的用户消息(注入了检索到的 Content)还是原始的用户消息被存入聊天记忆。
这一行为通过 AiServices builder 上的 storeRetrievedContentInChatMemory 选项配置。
配置
true(默认) 把增强后的UserMessage(原始查询加检索到的内容)存入聊天记忆。 同一条增强消息也会被发送给 LLM。false只把原始的UserMessage(不含检索到的内容)存入聊天记忆。 增强后的消息在推理期间仍会被发送给 LLM。
只存原始用户消息,在你希望保持聊天历史简洁、贴合用户实际输入、同时仍为 LLM 提供检索上下文以生成答案时很有用。
Example
java
interface Assistant {

    String chat(String userMessage);
}

ChatModel chatModel = OpenAiChatModel.builder()
    .apiKey(System.getenv("OPENAI_API_KEY"))
    .modelName(GPT_4_O_MINI)
    .build();

MessageWindowChatMemory chatMemory =
    MessageWindowChatMemory.withMaxMessages(10);

RetrievalAugmentor retrievalAugmentor =
    DefaultRetrievalAugmentor.builder()
        .contentRetriever(
            EmbeddingStoreContentRetriever.from(embeddingStore, embeddingModel))
        .build();

Assistant assistant = AiServices.builder(Assistant.class)
    .chatModel(chatModel)
    .chatMemory(chatMemory)
    .retrievalAugmentor(retrievalAugmentor)
    // Store only the original user message in chat memory
    .storeRetrievedContentInChatMemory(false)
.build();NOTE
整个检索图都有异步对应版本(augmentAsync、retrieveAsync、routeAsync、aggregateAsync),因此 RAG 不必阻塞线程。未实现其对应版本的组件默认会大声失败而非静默阻塞;请改用 DefaultRetrievalAugmentor 或 EmbeddingStoreContentRetriever 上的 offloadBlocking(true) 把其卸载执行。参见非阻塞与响应式。