
主题
可观测性
AI 服务可观测性
NOTE
AI 服务可观测性是一项实验性特性。其 API 与行为在未来版本中可能变化。
AI 服务可观测性机制让用户能追踪一次 AiService 调用期间正在发生什么。单次调用可能涉及多次 LLM 调用,其中任何一次都可能成功或失败。AI 服务可观测性让用户能追踪完整的调用序列及其结果。
NOTE
AI 服务可观测性能力仅在使用 AI 服务 时可用。它们是更高层的构造,无法应用于 ChatModel 或 StreamingChatModel。
该实现最初位于 Quarkus LangChain4j 扩展,后被回移到此处。
事件的类型
每种事件都有一个唯一标识符,可用于跨多次调用关联事件。每种事件都包含封装在一个 InvocationContext 内的信息。
目前有以下几种事件:
| Event Name | Description |
|---|---|
AiServiceStartedEvent | Invoked when an LLM invocation has started. |
AiServiceRequestIssuedEvent | Invoked just before a request to an LLM is sent. Contains the details of the request being made. It is important to note that this can be invoked multiple times during a single AiService invocation when tools or guardrails exist. Contains information such as the system message and the user message. |
AiServiceResponseReceivedEvent | Invoked when a response from an LLM is received. Contains the LLM response along with the corresponding request. It is important to note that this can be invoked multiple times during a single AiService invocation when tools or guardrails exist. Contains information such as the system message and the user message. Not every invocation will receive this event. If an invocation fails it will receive an AiServiceErrorEvent instead. |
AiServiceErrorEvent | Fired when an invocation with an LLM fails. The failure could be because of network failure, AiService unavailable, input/output guardrails blocking the request, or many other reasons. Contains information about the failure that occurred. |
AiServiceCompletedEvent | Invoked when an LLM invocation has completed successfully. Not every invocation will receive this event. If an invocation fails it will receive an AiServiceErrorEvent instead.Contains information about the result of the invocation. |
ToolExecutedEvent | Invoked when a tool invocation has completed. It is important to note that this can be invoked multiple times within a single LLM invocation. Contains information about the tool request and result. |
ToolCompensatedEvent | Invoked when a tool that had already completed is compensated, because the interaction was later cancelled or failed. Experimental; emitted by the non-blocking AI Service modes. Contains the tool request, its result and the reason for compensation. |
InputGuardrailExecutedEvent | Invoked when an input guardrail validation has been executed. One of these events will be fired for each invocation of a guardrail. Contains information about the input to an individual input guardrail, its output (i.e. was it successful or a failure?), and the execution duration. |
OutputGuardrailExecutedEvent | Invoked when an output guardrail validation has been executed. One of these events will be fired for each invocation of a guardrail. Contains information about the input to an individual output guardrail, its output (i.e. was it successful? failure? a retry? reprompt?), and the execution duration. |
监听某个事件
每种事件类型都有它自己的、可实现以接收该事件的监听器。你可以自行挑选想监听哪些事件。
要监听某个事件,创建一个实现你想监听的那个监听器接口的自有类。以下是可用的监听器接口:
一旦你定义了监听器,就在创建 AI 服务 时注册它们。AiServices 类上有多种 registerListener 方法变体。
例如,你可以按如下方式为某个 AiServiceCompletedEvent 创建并注册一个监听器:
java
import java.time.Instant;
import java.util.List;
import java.util.Optional;
import java.util.UUID;

import dev.langchain4j.observability.api.AiServiceListenerRegistrar;
import dev.langchain4j.observability.api.event.AiServiceCompletedEvent;
import dev.langchain4j.observability.api.listener.AiServiceCompletedListener;
import dev.langchain4j.invocation.InvocationContext;

public class MyAiServiceCompletedListener implements AiServiceCompletedListener {
    @Override
    public void onEvent(AiServiceCompletedEvent event) {
        InvocationContext invocationContext = event.invocationContext();
        Optional<Object> result = event.result();

        // The invocationId will be the same for all events related to the same LLM invocation
        UUID invocationId = invocationContext.invocationId();
        String aiServiceInterfaceName = invocationContext.interfaceName();
        String aiServiceMethodName = invocationContext.methodName();
        List<Object> aiServiceMethodArgs = invocationContext.methodArguments();
        Object chatMemoryId = invocationContext.chatMemoryId();
        Instant eventTimestamp = invocationContext.timestamp();

        // Do something with the data
    }
}

// When creating your AI Service
MyAiServiceCompletedListener myListener = new MyAiServiceCompletedListener();

var myService = AiServices.builder(MyAiService.class)
        .chatModel(chatModel)  // Could also be .streamingChatModel(...)
        .registerListener(myListener)
.build();创建你自己的事件与监听器
AI 服务可观测性能力被设计成可扩展的。如果你想创建自己的事件,可以通过实现 AiServiceEvent 接口来定义你自己的事件。
然后,通过实现 AiServiceListener 接口创建你自己的事件监听器。
一旦你有了事件与监听器,就需要通过获取/管理一个 AiServiceListenerRegistrar 实例并调用 fireEvent(event) 方法来触发该事件。
当事件被触发后,你就可以像对待内置事件那样创建监听器并注册它们。
扩展点
你也可以通过实现 AiServiceListenerRegistrarFactory 并用 Java 服务提供者接口(Java SPI) 注册它,来创建你自己的自定义 AiServiceListenerRegistrar。
当你想管理注册/注销监听器的方式、和/或想管理触发事件的方式时,这会很有用。
聊天模型可观测性
某些 ChatModel 与 StreamingChatModel 的实现(见"可观测性"列)允许配置 ChatModelListener 来监听诸如以下事件:
- 对 LLM 的请求
- 来自 LLM 的响应
- 错误
这些事件包含各种属性,正如 OpenTelemetry 生成式 AI 语义约定所述,例如:
- 请求:
- 消息
- 模型
- 温度
- Top P
- 最大词元
- 工具
- 响应格式
- 等等
- 响应:
- 助手消息
- ID
- 模型
- 词元用量
- 结束原因
- 等等
下面是一个使用 ChatModelListener 的示例:
java
ChatModelListener listener = new ChatModelListener() {

    @Override
    public void onRequest(ChatModelRequestContext requestContext) {
        ChatRequest chatRequest = requestContext.chatRequest();

        List<ChatMessage> messages = chatRequest.messages();
        System.out.println(messages);

        ChatRequestParameters parameters = chatRequest.parameters();
        System.out.println(parameters.modelName());
        System.out.println(parameters.temperature());
        System.out.println(parameters.topP());
        System.out.println(parameters.topK());
        System.out.println(parameters.frequencyPenalty());
        System.out.println(parameters.presencePenalty());
        System.out.println(parameters.maxOutputTokens());
        System.out.println(parameters.stopSequences());
        System.out.println(parameters.toolSpecifications());
        System.out.println(parameters.toolChoice());
        System.out.println(parameters.responseFormat());

        if (parameters instanceof OpenAiChatRequestParameters openAiParameters) {
            System.out.println(openAiParameters.maxCompletionTokens());
            System.out.println(openAiParameters.logitBias());
            System.out.println(openAiParameters.parallelToolCalls());
            System.out.println(openAiParameters.seed());
            System.out.println(openAiParameters.user());
            System.out.println(openAiParameters.store());
            System.out.println(openAiParameters.metadata());
            System.out.println(openAiParameters.serviceTier());
            System.out.println(openAiParameters.reasoningEffort());
        }

        System.out.println(requestContext.modelProvider());

        Map<Object, Object> attributes = requestContext.attributes();
        attributes.put("my-attribute", "my-value");
    }

    @Override
    public void onResponse(ChatModelResponseContext responseContext) {
        ChatResponse chatResponse = responseContext.chatResponse();

        AiMessage aiMessage = chatResponse.aiMessage();
        System.out.println(aiMessage);

        ChatResponseMetadata metadata = chatResponse.metadata();
        System.out.println(metadata.id());
        System.out.println(metadata.modelName());
        System.out.println(metadata.finishReason());

        if (metadata instanceof OpenAiChatResponseMetadata openAiMetadata) {
            System.out.println(openAiMetadata.created());
            System.out.println(openAiMetadata.serviceTier());
            System.out.println(openAiMetadata.systemFingerprint());
        }

        TokenUsage tokenUsage = metadata.tokenUsage();
        System.out.println(tokenUsage.inputTokenCount());
        System.out.println(tokenUsage.outputTokenCount());
        System.out.println(tokenUsage.totalTokenCount());
        if (tokenUsage instanceof OpenAiTokenUsage openAiTokenUsage) {
            System.out.println(openAiTokenUsage.inputTokensDetails().cachedTokens());
            System.out.println(openAiTokenUsage.outputTokensDetails().reasoningTokens());
        }

        ChatRequest chatRequest = responseContext.chatRequest();
        System.out.println(chatRequest);

        System.out.println(responseContext.modelProvider());

        Map<Object, Object> attributes = responseContext.attributes();
        System.out.println(attributes.get("my-attribute"));
    }

    @Override
    public void onError(ChatModelErrorContext errorContext) {
        Throwable error = errorContext.error();
        error.printStackTrace();

        ChatRequest chatRequest = errorContext.chatRequest();
        System.out.println(chatRequest);

        System.out.println(errorContext.modelProvider());

        Map<Object, Object> attributes = errorContext.attributes();
        System.out.println(attributes.get("my-attribute"));
    }
};

ChatModel model = OpenAiChatModel.builder()
        .apiKey(System.getenv("OPENAI_API_KEY"))
        .modelName(GPT_4_O_MINI)
        .listeners(List.of(listener))
        .build();

model.chat("Tell me a joke about Java");attributes map 允许在同一个 ChatModelListener 的 onRequest、onResponse 与 onError 方法之间、以及在多个 ChatModelListener 之间传递信息。若你需要向监听器提供逐次调用的元数据,请使用 ChatRequestOptions。例如,你可以通过 listenerAttributes 把租户或关联标识传给 ChatModelListener。这些选项只在 LangChain4j 的调用链内使用;它们不会被发送给 LLM 提供者。
java
ChatRequest chatRequest = ChatRequest.builder()
        .messages(UserMessage.from("Tell me a joke about Java"))
        .build();

ChatRequestOptions options = ChatRequestOptions.builder()
        .addListenerAttribute("tenantId", "tenant-123")
        .addListenerAttribute("correlationId", "corr-456")
        .build();

model.chat(chatRequest, options);同样的道理适用于 StreamingChatModel.chat(chatRequest, options, handler)。
监听器如何工作
- 监听器以一个
List<ChatModelListener>指定,并按迭代顺序调用。 - 监听器同步地在同一线程上调用。关于流式情形的更多细节见下文。在第一个监听器返回之前,第二个不会被调用。
ChatModelListener.onRequest()方法在调用 LLM 提供者 API 之前即刻被调用。ChatModelListener.onRequest()方法每个请求只调用一次。若调用 LLM 提供者 API 时出错并发生重试,ChatModelListener.onRequest()并不会在每次重试时都被调用。ChatModelListener.onResponse()方法只调用一次,就在从 LLM 提供者收到成功响应之后。ChatModelListener.onError()方法只调用一次。若调用 LLM 提供者 API 时出错并发生重试,ChatModelListener.onError()并不会在每次重试时都被调用。- 若从某个
ChatModelListener方法抛出异常,它会以WARN级别记录。后续监听器的执行会照常继续。 - 经由
ChatModelRequestContext、ChatModelResponseContext与ChatModelErrorContext提供的ChatRequest是最终请求,包含在ChatModel上配置的默认ChatRequestParameters与逐请求的ChatRequestParameters合并在一起的结果。 - 对于
StreamingChatModel,ChatModelListener.onResponse()与ChatModelListener.onError()在一个不同于ChatModelListener.onRequest()的线程上被调用。线程上下文目前不会被自动传播,因此你可能想用attributesmap 把必要的数据从ChatModelListener.onRequest()传递到ChatModelListener.onResponse()或ChatModelListener.onError()。 - 对于
StreamingChatModel,ChatModelListener.onResponse()会在StreamingChatResponseHandler.onCompleteResponse()之前被调用。ChatModelListener.onError()会在StreamingChatResponseHandler.onError()之前被调用。
审核模型可观测性
支持监听器的 ModerationModel 实现(例如 OpenAiModerationModel、MistralAiModerationModel 与 WatsonxModerationModel)允许配置 ModerationModelListener 来监听诸如以下事件:
- 对审核 API 的请求
- 来自审核 API 的响应
- 错误
下面是一个使用 ModerationModelListener 的示例:
java
ModerationModelListener listener = new ModerationModelListener() {

    @Override
    public void onRequest(ModerationModelRequestContext requestContext) {
        ModerationRequest moderationRequest = requestContext.moderationRequest();

        // Access texts being moderated
        System.out.println("Moderating texts: " + moderationRequest.texts());

        System.out.println(requestContext.modelProvider());
        System.out.println(moderationRequest.modelName());

        Map<Object, Object> attributes = requestContext.attributes();
        attributes.put("startTime", System.currentTimeMillis());
    }

    @Override
    public void onResponse(ModerationModelResponseContext responseContext) {
        ModerationResponse moderationResponse = responseContext.moderationResponse();

        Moderation moderation = moderationResponse.moderation();
        System.out.println("Flagged: " + moderation.flagged());
        if (moderation.flagged()) {
            System.out.println("Flagged text: " + moderation.flaggedText());
        }

        ModerationRequest moderationRequest = responseContext.moderationRequest();
        System.out.println(moderationRequest);

        System.out.println(responseContext.modelProvider());
        System.out.println(moderationRequest.modelName());

        Map<Object, Object> attributes = responseContext.attributes();
        Long startTime = (Long) attributes.get("startTime");
        if (startTime != null) {
            System.out.println("Duration: " + (System.currentTimeMillis() - startTime) + "ms");
        }
    }

    @Override
    public void onError(ModerationModelErrorContext errorContext) {
        Throwable error = errorContext.error();
        error.printStackTrace();

        ModerationRequest moderationRequest = errorContext.moderationRequest();
        System.out.println(moderationRequest);

        System.out.println(errorContext.modelProvider());
        System.out.println(moderationRequest.modelName());

        Map<Object, Object> attributes = errorContext.attributes();
        System.out.println(attributes.get("startTime"));
    }
};

ModerationModel model = OpenAiModerationModel.builder()
        .apiKey(System.getenv("OPENAI_API_KEY"))
        .listeners(List.of(listener))
        .build();

model.moderate("Text to check for policy violations");attributes map 允许在同一个 ModerationModelListener 的 onRequest、onResponse 与 onError 方法之间、以及在多个 ModerationModelListener 之间传递信息。
监听器如何工作
- 监听器以一个
List<ModerationModelListener>指定,并按迭代顺序调用。 - 监听器同步地在同一线程上调用。
ModerationModelListener.onRequest()方法在调用审核 API 之前即刻被调用。ModerationModelListener.onRequest()方法每个请求只调用一次。若调用审核 API 时出错并发生重试,ModerationModelListener.onRequest()并不会在每次重试时都被调用。ModerationModelListener.onResponse()方法只调用一次,就在收到成功响应之后。ModerationModelListener.onError()方法只调用一次。若调用审核 API 时出错并发生重试,ModerationModelListener.onError()并不会在每次重试时都被调用。- 若从某个
ModerationModelListener方法抛出异常,它会以WARN级别记录。后续监听器的执行会照常继续。
RAG 可观测性(EmbeddingModel、EmbeddingStore 与 ContentRetriever)
EmbeddingModel、EmbeddingStore 与 ContentRetriever 可以用监听器来观测:
- 延迟(用
attributes度量时长) - 载荷(例如
EmbeddingSearchRequest.queryEmbedding()与检索到的匹配/内容) - 错误
EmbeddingModel 监听器
实现 EmbeddingModelListener:
java
import dev.langchain4j.model.embedding.listener.EmbeddingModelListener;
import dev.langchain4j.model.embedding.listener.EmbeddingModelRequestContext;
import dev.langchain4j.model.embedding.listener.EmbeddingModelResponseContext;
import dev.langchain4j.model.embedding.listener.EmbeddingModelErrorContext;

public class MyEmbeddingModelListener implements EmbeddingModelListener {

    @Override
    public void onRequest(EmbeddingModelRequestContext requestContext) {
        requestContext.attributes().put("startNanos", System.nanoTime());
        // requestContext.embeddingRequest() exposes the inputs, per-call parameters (input_type, dimensions, ...)
        // and multimodal content. requestContext.modelProvider() identifies the provider.
    }

    @Override
    public void onResponse(EmbeddingModelResponseContext responseContext) {
        long startNanos = (long) responseContext.attributes().get("startNanos");
        long durationNanos = System.nanoTime() - startNanos;
        // Do something with duration and/or responseContext.embeddingResponse() (embeddings + metadata)
    }

    @Override
    public void onError(EmbeddingModelErrorContext errorContext) {
        // Do something with errorContext.error()
    }
}通过模型的 listeners(...) builder 方法附加监听器(推荐):
java
EmbeddingModel model = OpenAiEmbeddingModel.builder()
        .apiKey(System.getenv("OPENAI_API_KEY"))
        .modelName("text-embedding-3-small")
        .listeners(List.of(new MyEmbeddingModelListener()))
        .build();

model.embed("hello");该监听器会在 embed(EmbeddingRequest) 以及 embed(String) / embed(TextSegment) 便捷方法周围被通知。
NOTE
你也可以通过用一个 EmbeddingModel#addListener(s) 包装一个已构建的模型来附加监听器:
java
EmbeddingModel observedModel = embeddingModel.addListener(new MyEmbeddingModelListener());

observedModel.embed("hello");这对于向一个已构建的模型、或向一个 builder 未暴露 listeners(...) 的模型添加监听器很方便。当 builder 确实暴露了 listeners(...) 时,请优先用那种方式,因为它无需包装。
EmbeddingStore 监听器
实现 EmbeddingStoreListener:
java
import dev.langchain4j.store.embedding.listener.EmbeddingStoreListener;
import dev.langchain4j.store.embedding.listener.EmbeddingStoreRequestContext;
import dev.langchain4j.store.embedding.listener.EmbeddingStoreResponseContext;
import dev.langchain4j.store.embedding.listener.EmbeddingStoreErrorContext;

public class MyEmbeddingStoreListener implements EmbeddingStoreListener {

    @Override
    public void onRequest(EmbeddingStoreRequestContext<?> requestContext) {
        requestContext.attributes().put("startNanos", System.nanoTime());
    }

    @Override
    public void onResponse(EmbeddingStoreResponseContext<?> responseContext) {
        long startNanos = (long) responseContext.attributes().get("startNanos");
        long durationNanos = System.nanoTime() - startNanos;
        // Do something with duration and/or the response payload (if any), e.g.:
        if (responseContext instanceof EmbeddingStoreResponseContext.Search<?> search) {
            // Do something with search.searchResult()
        }
    }

    @Override
    public void onError(EmbeddingStoreErrorContext<?> errorContext) {
        // Do something with errorContext.error()
    }
}使用 EmbeddingStore#addListener(s) 附加监听器:
java
EmbeddingStore<TextSegment> observedStore = embeddingStore.addListener(new MyEmbeddingStoreListener());

// Use observedStore as usual, e.g. in EmbeddingStoreIngestor / EmbeddingStoreContentRetrieverContentRetriever 监听器
实现 ContentRetrieverListener:
java
import dev.langchain4j.rag.content.retriever.listener.ContentRetrieverListener;
import dev.langchain4j.rag.content.retriever.listener.ContentRetrieverRequestContext;
import dev.langchain4j.rag.content.retriever.listener.ContentRetrieverResponseContext;
import dev.langchain4j.rag.content.retriever.listener.ContentRetrieverErrorContext;

public class MyContentRetrieverListener implements ContentRetrieverListener {

    @Override
    public void onRequest(ContentRetrieverRequestContext requestContext) {
        requestContext.attributes().put("startNanos", System.nanoTime());
    }

    @Override
    public void onResponse(ContentRetrieverResponseContext responseContext) {
        long startNanos = (long) responseContext.attributes().get("startNanos");
        long durationNanos = System.nanoTime() - startNanos;
        // Do something with duration and/or responseContext.contents()
    }

    @Override
    public void onError(ContentRetrieverErrorContext errorContext) {
        // Do something with errorContext.error()
    }
}使用 ContentRetriever#addListener(s) 附加监听器:
java
ContentRetriever observedRetriever = contentRetriever.addListener(new MyContentRetrieverListener());

observedRetriever.retrieve(Query.from("my query"));监听器如何工作
- 监听器以一个
List指定,并按迭代顺序调用。 - 监听器同步地在同一线程上调用。
onRequest()在执行底层操作之前即刻被调用。onResponse()在成功完成后调用一次。onError()在底层操作抛出异常时调用一次。- 若从某个监听器方法抛出异常,它会以
WARN级别记录并被忽略。 attributesmap 允许在同一个监听器的onRequest、onResponse与onError方法之间、以及在多个监听器之间传递信息。
用 Micrometer 做可观测性指标
langchain4j-micrometer-metrics 模块为 LangChain4j 库提供了一个基于 Micrometer 的指标实现。目前,它用一个 ChatModelListener 实现为 ChatModel 与 StreamingChatModel 交互、用一个 EmbeddingModelListener 实现为 EmbeddingModel 交互提供指标,经由 Micrometer 的 MeterRegistry 收集指标。
这些指标的命名遵循 OpenTelemetry 生成式 AI 指标语义约定。(v1.39.0)
⚠️ 实验性:本模块被标记为
@Experimental,未来版本可能有不兼容变化。
⚠️ 警告:生成式 AI 的 OpenTelemetry 语义约定目前是实验性的、尚未稳定。这意味着它们未来可能有不兼容变化。若你遵循这些约定,当约定更新时,你可能需要对你的仪表盘、告警与自动化引入不兼容变更。
指标
目前收集以下指标:
| 指标名 | 类型 | 描述 |
|---|---|---|
gen_ai.client.token.usage | Histogram (DistributionSummary) | 每个聊天模型请求所用的输入与输出词元数,以及每个嵌入模型请求的输入词元数 |
gen_ai.client.operation.duration | Timer | 每个聊天与嵌入模型请求耗时多久,无论成功还是失败 |
gen_ai.client.token.usage 上的标签
| 标签 | 描述 | 示例值 |
|---|---|---|
gen_ai.operation.name | 正在执行的操作 | chat、embeddings |
gen_ai.provider.name | AI 提供者名 | openai、azure.ai.inference、anthropic |
gen_ai.request.model | 来自请求的模型名 | gpt-4、gpt-35-turbo、text-embedding-3-small |
gen_ai.response.model | 来自响应的模型名 | gpt-4-0613 |
gen_ai.token.type | 所统计词元的类型 | input、output(嵌入只记录 input) |
gen_ai.client.operation.duration 上的标签
| 标签 | 描述 | 示例值 |
|---|---|---|
gen_ai.operation.name | 正在执行的操作 | chat、embeddings |
gen_ai.provider.name | AI 提供者名 | openai、azure.ai.inference、anthropic |
gen_ai.request.model | 来自请求的模型名 | gpt-4、gpt-35-turbo、text-embedding-3-small |
gen_ai.response.model | 来自响应的模型名,失败调用时为 unknown | gpt-4-0613、unknown |
outcome | 调用成功还是失败 | SUCCESS、ERROR |
error.type | 异常的类名,成功调用时为 none | none、java.util.concurrent.TimeoutException |
创建 MicrometerMetricsChatModelListener
MicrometerMetricsChatModelListener 为 ChatModel 与 StreamingChatModel 交互收集指标。它需要实例化一个 Micrometer 的 MeterRegistry。
java
import dev.langchain4j.data.message.UserMessage;
import dev.langchain4j.micrometer.metrics.listeners.MicrometerMetricsChatModelListener;
import dev.langchain4j.model.azure.AzureOpenAiChatModel;
import dev.langchain4j.model.chat.request.ChatRequest;
import dev.langchain4j.model.chat.response.ChatResponse;
import io.micrometer.core.instrument.MeterRegistry;

import java.util.List;

// Get the MeterRegistry
MeterRegistry meterRegistry = new SimpleMeterRegistry();

// 1. Create the listener with the MeterRegistry and AI system name
MicrometerMetricsChatModelListener listener =
    new MicrometerMetricsChatModelListener(meterRegistry);

// 2. Add the listener to your ChatModel
AzureOpenAiChatModel chatModel = AzureOpenAiChatModel.builder()
        .endpoint(System.getenv("AZURE_OPENAI_ENDPOINT"))
        .apiKey(System.getenv("AZURE_OPENAI_KEY"))
        .deploymentName(System.getenv("AZURE_OPENAI_DEPLOYMENT_NAME"))
        .listeners(List.of(listener))
        .build();

// 3. Use the chat model as usual - metrics are collected automatically
ChatResponse response = chatModel.chat(ChatRequest.builder()
        .messages(UserMessage.from("Hello!"))
.build());gen_ai.client.operation.duration(嵌入)上的标签
| 标签 | 描述 | 示例值 |
|---|---|---|
gen_ai.operation.name | 正在执行的操作 | embeddings |
gen_ai.provider.name | AI 提供者名 | openai、ollama |
gen_ai.request.model | 来自请求的模型名 | text-embedding-3-small |
gen_ai.response.model | 来自响应的模型名,失败调用时为 unknown | text-embedding-3-small、unknown |
outcome | 调用成功还是失败 | SUCCESS、ERROR |
error.type | 异常的类名,成功调用时为 none | none、java.net.SocketTimeoutException |
创建 MicrometerMetricsEmbeddingModelListener
MicrometerMetricsEmbeddingModelListener 为 EmbeddingModel 交互收集指标。它只以 gen_ai.token.type = input 记录 gen_ai.client.token.usage,因为一次嵌入调用没有输出词元,并为每次调用(无论成功或失败)记录 gen_ai.client.operation.duration。它需要实例化一个 Micrometer 的 MeterRegistry。
java
import dev.langchain4j.data.embedding.Embedding;
import dev.langchain4j.data.segment.TextSegment;
import dev.langchain4j.micrometer.metrics.listeners.MicrometerMetricsEmbeddingModelListener;
import dev.langchain4j.model.openai.OpenAiEmbeddingModel;
import dev.langchain4j.model.output.Response;
import io.micrometer.core.instrument.MeterRegistry;
import io.micrometer.core.instrument.simple.SimpleMeterRegistry;

import java.util.List;

// Get the MeterRegistry
MeterRegistry meterRegistry = new SimpleMeterRegistry();

// 1. Create the listener with the MeterRegistry
MicrometerMetricsEmbeddingModelListener listener =
    new MicrometerMetricsEmbeddingModelListener(meterRegistry);

// 2. Add the listener to your EmbeddingModel
OpenAiEmbeddingModel embeddingModel = OpenAiEmbeddingModel.builder()
        .apiKey(System.getenv("OPENAI_API_KEY"))
        .modelName("text-embedding-3-small")
        .listeners(List.of(listener))
        .build();

// 3. Use the embedding model as usual - metrics are collected automatically
Response<List<Embedding>> embeddings = embeddingModel.embedAll(List.of(TextSegment.from("Hello!")));Micrometer Observation API
这通过 Micrometer Observation API 实现了 ChatModelListener,从而可透明地生成指标与追踪。
这实现在 langchain4j-observation 模块中。
产出的遥测数据
追踪
这会为每次聊天交互提供 span。
示例: 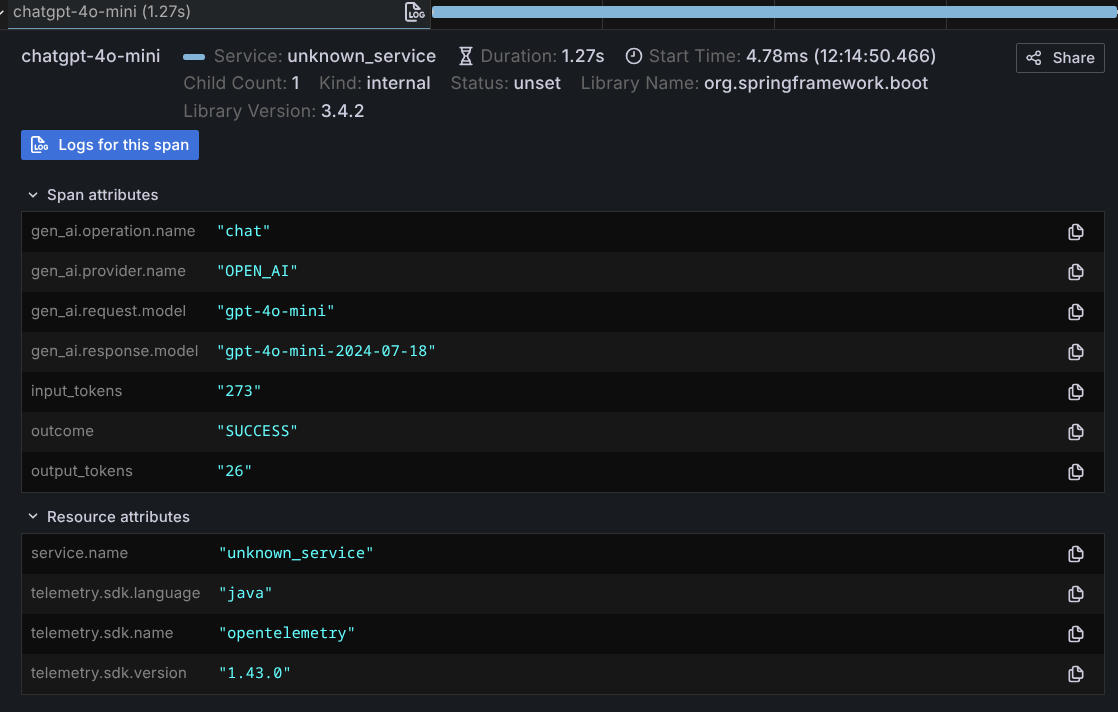
指标
以下为直方图:
- gen_ai_client_token_usage
- gen_ai_client_operation_duration
示例:
log
# HELP gen_ai_client_operation_duration_active_seconds
# TYPE gen_ai_client_operation_duration_active_seconds summary
gen_ai_client_operation_duration_active_seconds_count{gen_ai_operation_name="chat",gen_ai_provider_name="OPEN_AI",gen_ai_request_model="gpt-4o-mini",gen_ai_response_model="unknown",outcome="SUCCESS"} 0
gen_ai_client_operation_duration_active_seconds_sum{gen_ai_operation_name="chat",gen_ai_provider_name="OPEN_AI",gen_ai_request_model="gpt-4o-mini",gen_ai_response_model="unknown",outcome="SUCCESS"} 0.0
# HELP gen_ai_client_operation_duration_active_seconds_max
# TYPE gen_ai_client_operation_duration_active_seconds_max gauge
gen_ai_client_operation_duration_active_seconds_max{gen_ai_operation_name="chat",gen_ai_provider_name="OPEN_AI",gen_ai_request_model="gpt-4o-mini",gen_ai_response_model="unknown",outcome="SUCCESS"} 0.0
# HELP gen_ai_client_operation_duration_seconds
# TYPE gen_ai_client_operation_duration_seconds summary
gen_ai_client_operation_duration_seconds_count{error="none",gen_ai_operation_name="chat",gen_ai_provider_name="OPEN_AI",gen_ai_request_model="gpt-4o-mini",gen_ai_response_model="gpt-4o-mini-2024-07-18",outcome="SUCCESS"} 2
gen_ai_client_operation_duration_seconds_sum{error="none",gen_ai_operation_name="chat",gen_ai_provider_name="OPEN_AI",gen_ai_request_model="gpt-4o-mini",gen_ai_response_model="gpt-4o-mini-2024-07-18",outcome="SUCCESS"} 3.384050045
# HELP gen_ai_client_operation_duration_seconds_max
# TYPE gen_ai_client_operation_duration_seconds_max gauge
gen_ai_client_operation_duration_seconds_max{error="none",gen_ai_operation_name="chat",gen_ai_provider_name="OPEN_AI",gen_ai_request_model="gpt-4o-mini",gen_ai_response_model="gpt-4o-mini-2024-07-18",outcome="SUCCESS"} 2.115592691
# HELP gen_ai_client_token_usage_tokens Measures the quantity of used tokens
# TYPE gen_ai_client_token_usage_tokens summary
gen_ai_client_token_usage_tokens_count{gen_ai_operation_name="chat",gen_ai_provider_name="OPEN_AI",gen_ai_request_model="gpt-4o-mini",gen_ai_response_model="gpt-4o-mini-2024-07-18",gen_ai_token_type="input"} 2
gen_ai_client_token_usage_tokens_sum{gen_ai_operation_name="chat",gen_ai_provider_name="OPEN_AI",gen_ai_request_model="gpt-4o-mini",gen_ai_response_model="gpt-4o-mini-2024-07-18",gen_ai_token_type="input"} 508.0
gen_ai_client_token_usage_tokens_count{gen_ai_operation_name="chat",gen_ai_provider_name="OPEN_AI",gen_ai_request_model="gpt-4o-mini",gen_ai_response_model="gpt-4o-mini-2024-07-18",gen_ai_token_type="output"} 2
gen_ai_client_token_usage_tokens_sum{gen_ai_operation_name="chat",gen_ai_provider_name="OPEN_AI",gen_ai_request_model="gpt-4o-mini",gen_ai_response_model="gpt-4o-mini-2024-07-18",gen_ai_token_type="output"} 53.0
# HELP gen_ai_client_token_usage_tokens_max Measures the quantity of used tokens
# TYPE gen_ai_client_token_usage_tokens_max gauge
gen_ai_client_token_usage_tokens_max{gen_ai_operation_name="chat",gen_ai_provider_name="OPEN_AI",gen_ai_request_model="gpt-4o-mini",gen_ai_response_model="gpt-4o-mini-2024-07-18",gen_ai_token_type="input"} 273.0
gen_ai_client_token_usage_tokens_max{gen_ai_operation_name="chat",gen_ai_provider_name="OPEN_AI",gen_ai_request_model="gpt-4o-mini",gen_ai_response_model="gpt-4o-mini-2024-07-18",gen_ai_token_type="output"} 27.0NOTE
监听器回调不得阻塞。 ChatModelListener 与 EmbeddingModelListener 回调在模型自身的线程上同步调用,且从不被卸载。在同步 API 上,那是调用方的线程;在异步与响应式 API 上,onResponse/onError 运行在读取响应的传输层 I/O 工作线程上。一个在那里做阻塞 I/O 的回调——一次同步的数据库写、一次到可观测性后端的同步 HTTP 调用——会拖住那个工作线程,并在并发下拖累所有在途调用的吞吐。请记录指标或启停 span(内置的 Micrometer 与 Observation 监听器在设计上是非阻塞的);若某个回调确实必须阻塞,请在回调内部把它卸载到你自己的执行器。参见非阻塞与响应式。
Spring Boot 应用中的可观测性
更多细节见这里。
关于如何在 Spring Boot 应用中收集 Micrometer 指标的更多细节见这里。
关于如何把 Micrometer Observation API 库与 SpringBoot 集成的细节可在这里找到。
第三方集成
- Arize Phoenix 是 Arize AI 提供的开源、自托管选项,用于本地追踪检视与实验。
- Arize AX 为生产级的 LangChain4j 应用支持托管云与企业自托管的可观测性。
- 关于构建在追踪之上的评估工作流,参见 Arize 的智能体评估指南与 LLM 评估指南。
OpenTelemetry GenAI 自动埋点
社区维护的 otel-genai-bridges 项目发布了一个 Spring Boot starter,用 OpenTelemetry 生成式 AI 语义约定对 LangChain4j 聊天应用自动埋点。
为什么用它?
- 包装任意
ChatModelbean 并发出 span、事件与指标。 - 开箱即用地捕获提示词、补全、工具调用、延迟、词元用量、成本与 RAG 检索延迟。
- 提供 Docker Compose 示例(Collector → Tempo/Prometheus → Grafana),附带预构建的 Grafana 仪表盘。
上手
把你的 Spring Boot 项目添加该 starter:
xml
<!-- pom.xml -->
<dependency>
  <groupId>com.dineshkumarkummara.otel</groupId>
  <artifactId>langchain4j-otel</artifactId>
  <version>0.1.0-SNAPSHOT</version>
</dependency>通过 application.yaml 启用该 starter:
yaml
otel:
  langchain4j:
    enabled: true
    system: openai
    default-model: gpt-4o
    capture-prompts: true
    capture-completions: true
    cost:
      enabled: true
      input-per-thousand: 0.0005
output-per-thousand: 0.0015嵌套的 cost 段是可选的;当你想要逐词元成本指标时再包含它。
只要该依赖在 classpath 上,该 starter 就会自动定位 ChatModel bean 并用遥测包装它们。
可观测性视图
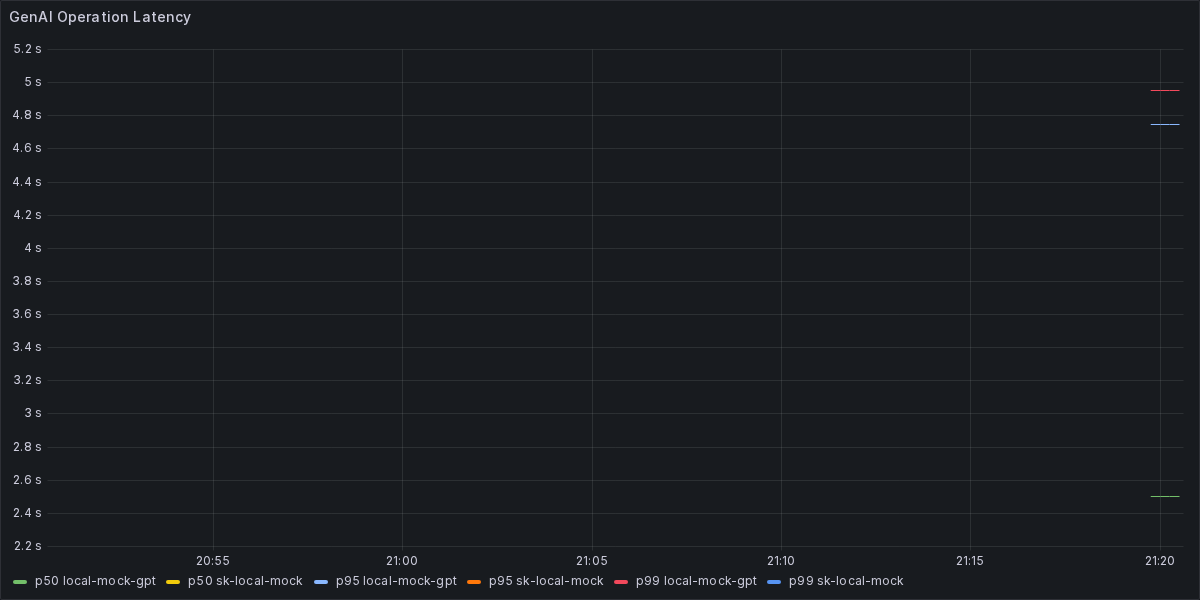
关于一个完整的可运行示例(包括可观测性技术栈与 Semantic Kernel 对齐),参见 dineshkumarkummara/otel-genai-bridges。