
主题
流程
了解如何使用 CrewAI 流程创建和管理 AI 工作流。
概述
CrewAI 流程是一项强大的功能,旨在简化 AI 工作流的创建和管理。流程允许开发者高效地组合和协调编码任务与团队,为构建复杂的 AI 自动化提供稳健的框架。
流程允许你创建结构化、事件驱动的工作流。它们提供一种无缝方式来连接多个任务、管理状态,并控制 AI 应用中的执行流程。借助流程,你可以轻松设计和实现多步骤流程,充分发挥 CrewAI 能力的潜力。
简化工作流创建:轻松将多个团队和任务串联起来,创建复杂的 AI 工作流。
状态管理:流程让管理和共享工作流中不同任务之间的状态变得非常容易。
事件驱动架构:构建在事件驱动模型之上,支持动态且响应式的工作流。
灵活的控制流:在工作流中实现条件逻辑、循环和分支。
开始使用
让我们创建一个简单的流程:你在一个任务中使用 OpenAI 生成一个随机城市,然后在另一个任务中使用该城市生成一条趣闻。
python
from crewai.flow.flow import Flow, listen, start
from dotenv import load_dotenv
from litellm import completion

load_dotenv()

class ExampleFlow(Flow):
    model = "gpt-4o-mini"

    @start()
    def generate_city(self):
        print("Starting flow")
        # Each flow state automatically gets a unique ID
        print(f"Flow State ID: {self.state['id']}")

        response = completion(
            model=self.model,
            messages=[
                {
                    "role": "user",
                    "content": "Return the name of a random city in the world.",
                },
            ],
        )

        random_city = response["choices"][0]["message"]["content"]
        # Store the city in our state
        self.state["city"] = random_city
        print(f"Random City: {random_city}")

        return random_city

    @listen(generate_city)
    def generate_fun_fact(self, random_city):
        response = completion(
            model=self.model,
            messages=[
                {
                    "role": "user",
                    "content": f"Tell me a fun fact about {random_city}",
                },
            ],
        )

        fun_fact = response["choices"][0]["message"]["content"]
        # Store the fun fact in our state
        self.state["fun_fact"] = fun_fact
        return fun_fact

flow = ExampleFlow()
flow.plot()
result = flow.kickoff()

print(f"Generated fun fact: {result}")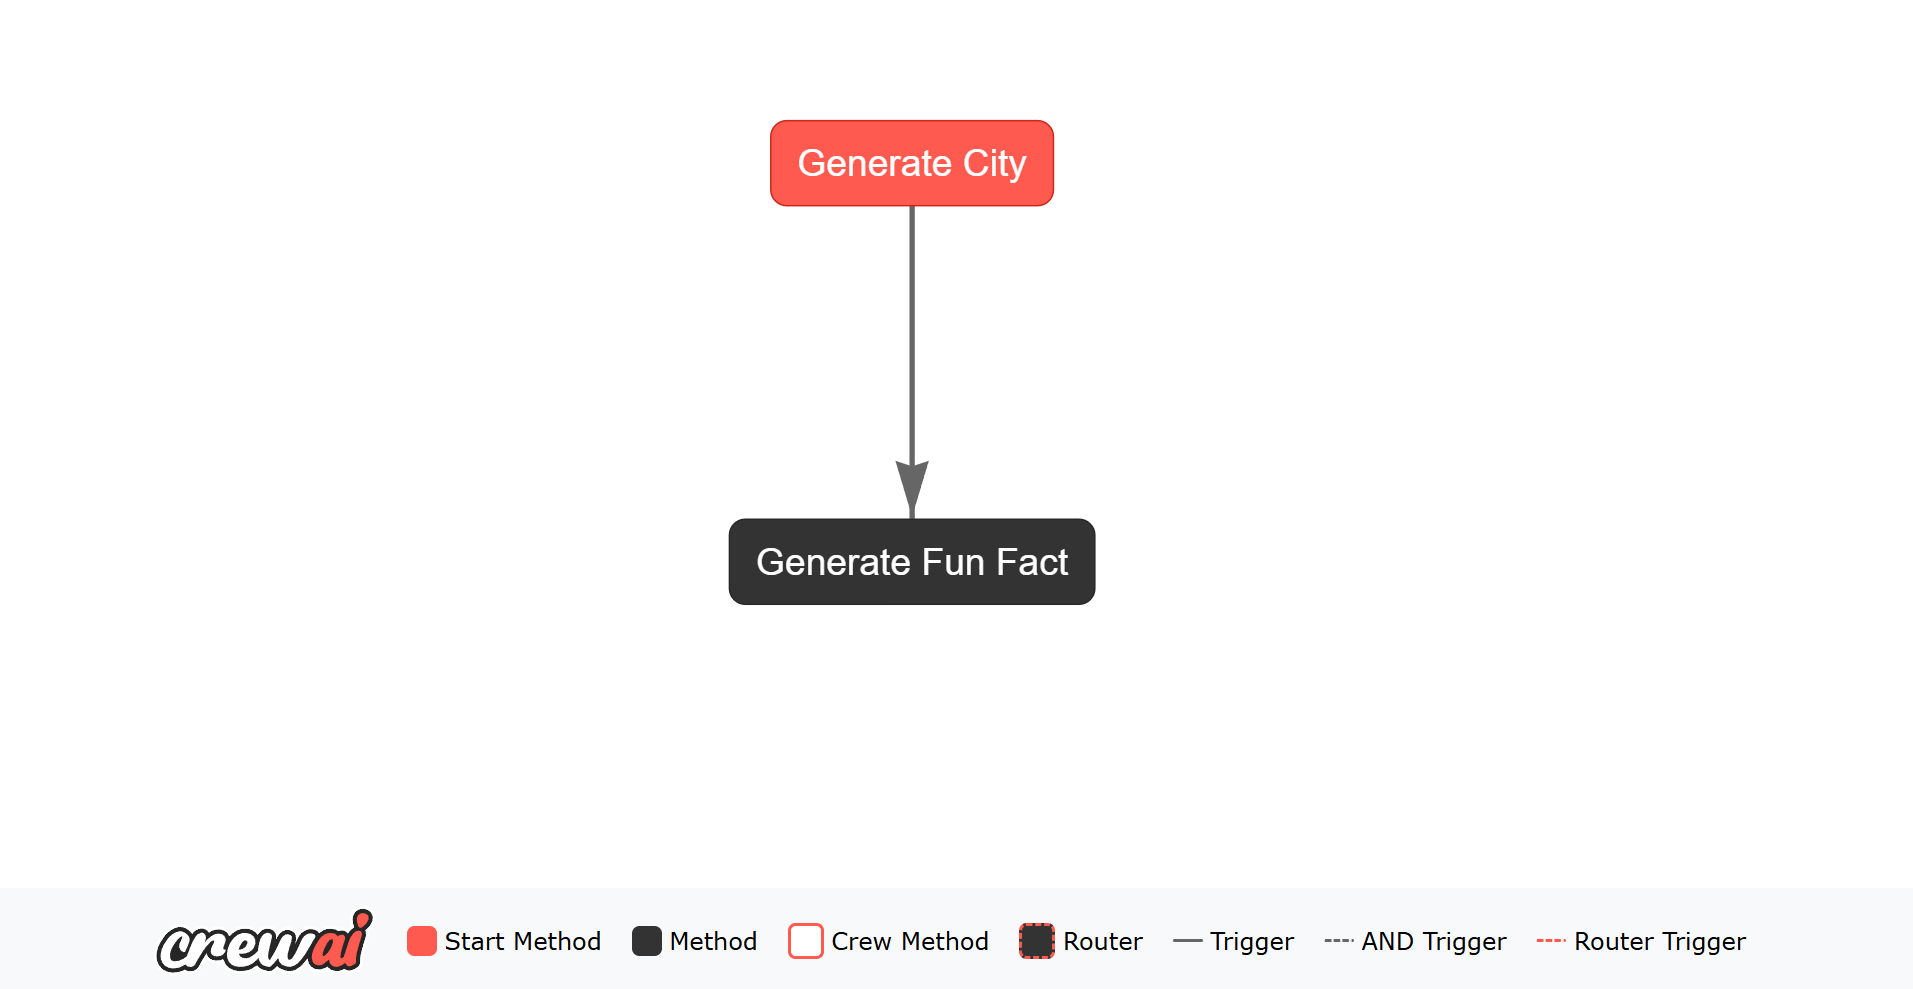
在上面的示例中,我们创建了一个简单的流程:它使用 OpenAI 生成一个随机城市,然后生成关于该城市的一条趣闻。该流程由两个任务组成:generate_city 和 generate_fun_fact。generate_city 任务是流程的起点,generate_fun_fact 任务监听 generate_city 任务的输出。
每个流程实例都会在其状态中自动接收一个唯一标识符(UUID),这有助于跟踪和管理流程执行。状态还可以存储会在整个流程执行期间持续存在的附加数据(例如生成的城市和趣闻)。
当你运行该流程时,它会:
- 为流程状态生成唯一 ID
- 生成一个随机城市并将其存储到状态中
- 生成关于该城市的一条趣闻并将其存储到状态中
- 将结果打印到控制台
状态的唯一 ID 和存储的数据可用于跟踪流程执行,并在任务之间维护上下文。
注意: 确保你已设置 .env 文件来存储 OPENAI_API_KEY。此密钥用于对 OpenAI API 的请求进行身份认证。
@start()
@start() 装饰器标记流程的入口点。你可以:
- 声明多个无条件启动点:
@start() - 根据先前的方法或路由标签为启动点设置条件:
@start("method_or_label") - 提供一个可调用条件来控制启动点应在何时触发
当流程开始或恢复时,所有满足条件的 @start() 方法都会执行(通常并行执行)。
@listen()
@listen() 装饰器用于将某个方法标记为流程中另一个任务输出的监听器。当指定任务发出输出时,使用 @listen() 装饰的方法将被执行。该方法可以将它正在监听的任务的输出作为参数进行访问。
用法
@listen() 装饰器可以通过几种方式使用:
按名称监听方法:你可以将要监听的方法的名称作为字符串传入。当该方法完成时,监听器方法将被触发。
python@listen("generate_city") def generate_fun_fact(self, random_city): # Implementation直接监听方法:你可以传入方法本身。当该方法完成时,监听器方法将被触发。
python@listen(generate_city) def generate_fun_fact(self, random_city): # Implementation
流程输出
访问和处理流程的输出对于将你的 AI 工作流集成到更大的应用程序或系统中至关重要。CrewAI 流程提供了直接的机制来检索最终输出、访问中间结果,并管理流程的整体状态。
检索最终输出
当你运行一个流程时,最终输出由最后完成的方法决定。kickoff() 方法会返回这个最终方法的输出。
以下是如何访问最终输出:
python
from crewai.flow.flow import Flow, listen, start

class OutputExampleFlow(Flow):
    @start()
    def first_method(self):
        return "Output from first_method"

    @listen(first_method)
    def second_method(self, first_output):
        return f"Second method received: {first_output}"

flow = OutputExampleFlow()
flow.plot("my_flow_plot")
final_output = flow.kickoff()

print("---- Final Output ----")
print(final_output)text
---- Final Output ----
Second method received: Output from first_method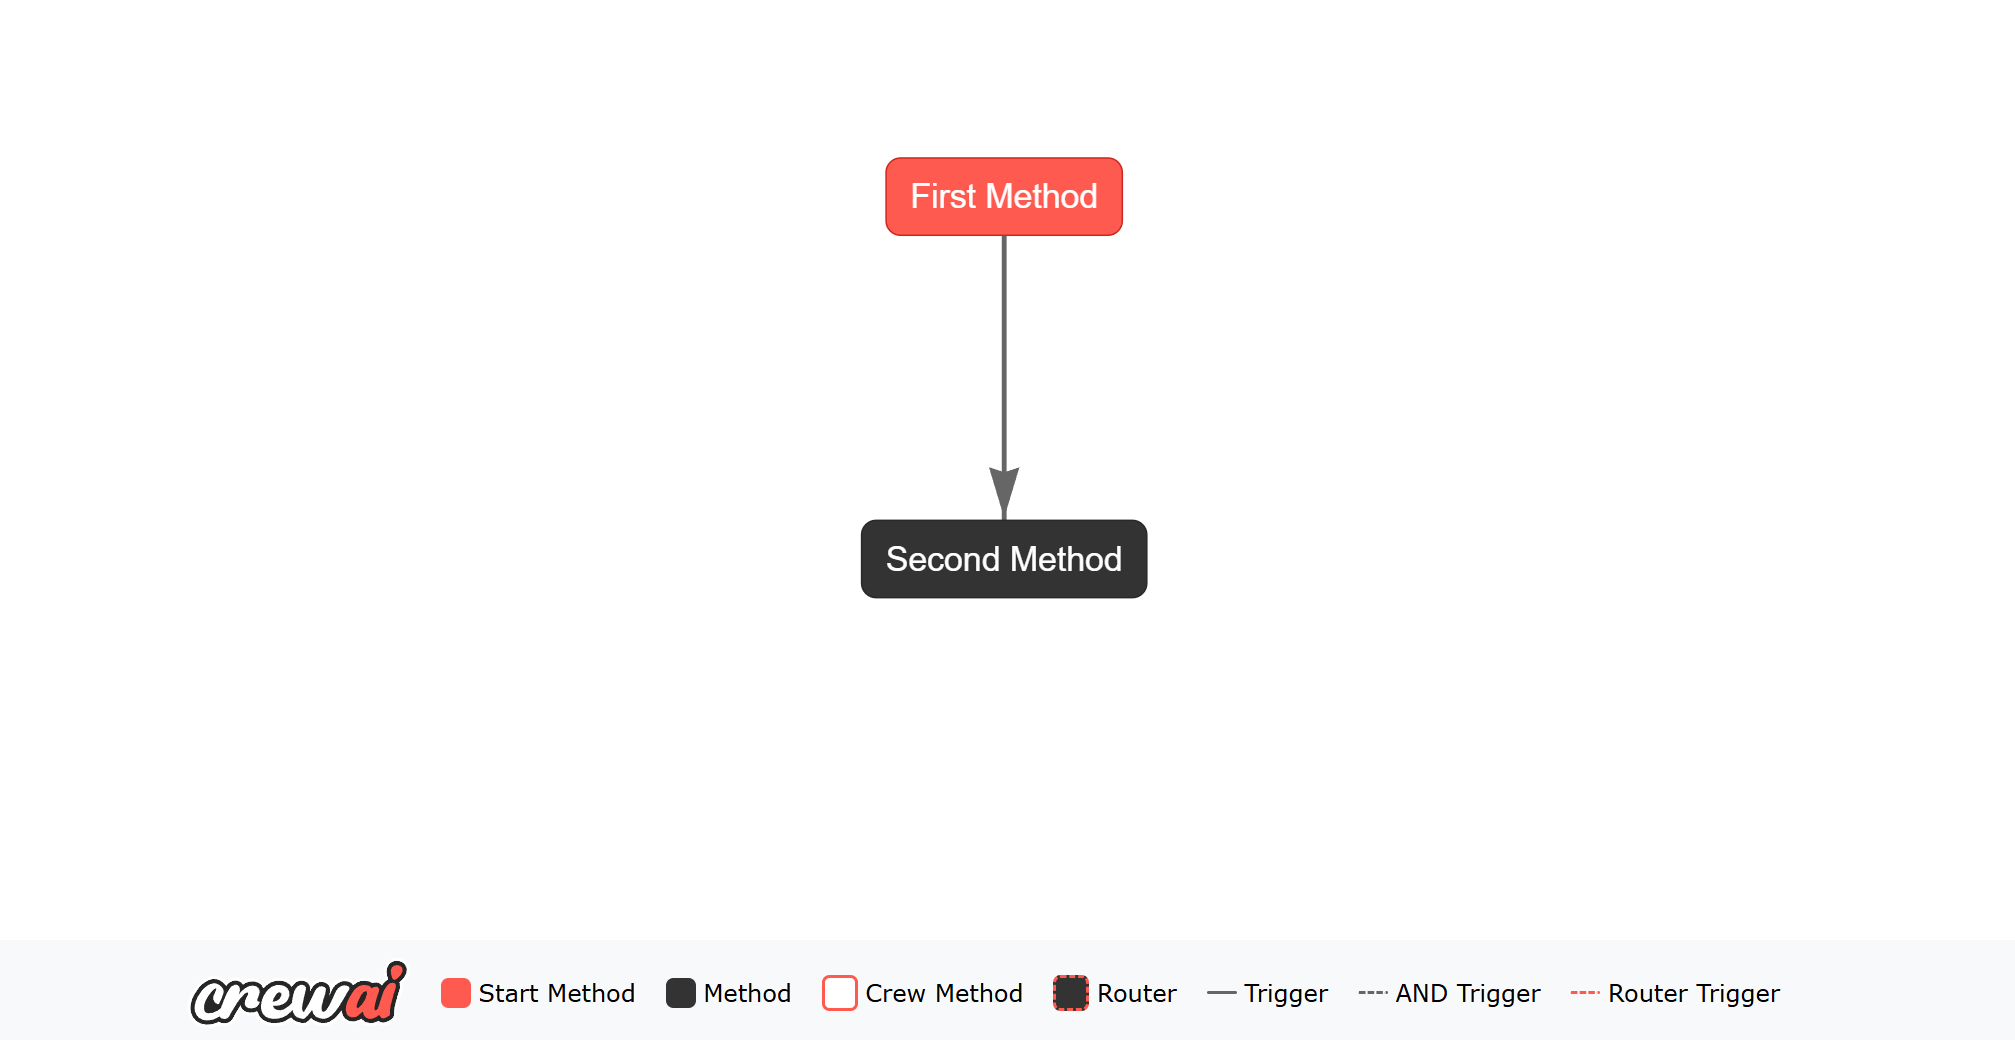
在这个示例中,second_method 是最后完成的方法,因此它的输出将成为流程的最终输出。 kickoff() 方法将返回最终输出,然后打印到控制台。plot() 方法将生成 HTML 文件,这有助于你理解流程。
访问和更新状态
除了检索最终输出之外,你还可以访问和更新流程中的状态。状态可用于在流程中的不同方法之间存储和共享数据。流程运行后,你可以访问状态以检索执行期间添加或更新的任何信息。
以下是如何更新和访问状态的示例:
python
from crewai.flow.flow import Flow, listen, start
from pydantic import BaseModel

class ExampleState(BaseModel):
    counter: int = 0
    message: str = ""

class StateExampleFlow(Flow[ExampleState]):

    @start()
    def first_method(self):
        self.state.message = "Hello from first_method"
        self.state.counter += 1

    @listen(first_method)
    def second_method(self):
        self.state.message += " - updated by second_method"
        self.state.counter += 1
        return self.state.message

flow = StateExampleFlow()
flow.plot("my_flow_plot")
final_output = flow.kickoff()
print(f"Final Output: {final_output}")
print("Final State:")
print(flow.state)text
Final Output: Hello from first_method - updated by second_method
Final State:
counter=2 message='Hello from first_method - updated by second_method'在这个示例中,状态由 first_method 和 second_method 共同更新。 流程运行后,你可以访问最终状态,以查看这些方法所做的更新。
通过确保返回最终方法的输出并提供对状态的访问,CrewAI 流程可以轻松地将你的 AI 工作流的结果集成到更大的应用程序或系统中, 同时在流程的整个执行过程中维护和访问状态。
流程使用指标
流程执行完成后,你可以访问 usage_metrics 属性,查看运行期间每次 LLM 调用的聚合 token 使用量——包括流程所编排的每个团队进行的调用、智能体工具内部的调用,以及来自流程方法的直接 LLM.call(...) 调用。这是 CrewAI 企业版 UI 中显示总计的 SDK 侧等价项。
python
from crewai import LLM
from crewai.flow.flow import Flow, listen, start

class UsageMetricsFlow(Flow):
    @start()
    def run_first_crew(self):
        self.state.first_result = FirstCrew().crew().kickoff()

    @listen(run_first_crew)
    def call_llm_directly(self):
        # Bare LLM call — still counted by flow.usage_metrics
        llm = LLM(model="openai/gpt-4o-mini")
        self.state.summary = llm.call("Summarize the key takeaways.")

    @listen(call_llm_directly)
    def run_second_crew(self):
        self.state.second_result = SecondCrew().crew().kickoff()

flow = UsageMetricsFlow()
flow.kickoff()

print(flow.usage_metrics)
# UsageMetrics(total_tokens=8579, prompt_tokens=6210, completion_tokens=2369,
#              cached_prompt_tokens=0, reasoning_tokens=0,
# cache_creation_tokens=0, successful_requests=5)NOTE
flow.usage_metrics 不等同于 flow.kickoff().token_usage。后者 返回 最后一个 @listen 方法的 CrewOutput.token_usage,该方法 返回了 CrewOutput,这意味着它只反映最终的团队,并 完全忽略先前的团队和直接 LLM.call(...) 调用。每当你需要流程的 完整 token 汇总时,请使用 flow.usage_metrics 获取流程 执行。
UsageMetrics 字段语义
返回的 UsageMetrics 对象使用与服务商无关的约定:
| 字段 | 含义 |
|---|---|
total_tokens | 计费总计:prompt_tokens + completion_tokens |
prompt_tokens | 为请求计费的完整输入/提示词 token |
completion_tokens | 为请求计费的输出/补全 token |
cached_prompt_tokens | 提示词 token 中缓存读取的子集(仅细分) |
cache_creation_tokens | 提示词 token 中缓存写入的子集(仅细分,Anthropic) |
reasoning_tokens | 服务商单独报告时的推理/思考子集(仅细分) |
successful_requests | 聚合的 LLM 调用次数 |
诸如 cached_prompt_tokens、cache_creation_tokens 和 reasoning_tokens 之类的细分字段不会额外加到 total_tokens 上——它们描述的是 已包含在 prompt_tokens 或 completion_tokens 中的部分。
对于 Anthropic,缓存读取和缓存写入计数器会并入 prompt_tokens,因此缓存工作负载会完全反映在 total_tokens 中。OpenAI 风格的服务商已将缓存输入包含在 prompt_tokens 内;CrewAI 会单独呈现缓存部分以便查看。
返回的 UsageMetrics 中的每个条目都是单次 flow.kickoff() 调用内所有 LLM 调用的总和。计数器会在下一次 kickoff() 调用时(或在 kickoff_for_each 的每次迭代时)重置,因此连续运行不会重复计数。该属性在 kickoff() 完成后的任意时刻都可以安全读取;在执行期间读取它会返回截至目前累计的部分总计。
流程状态管理
有效管理状态对于构建可靠且可维护的 AI 工作流至关重要。CrewAI 流程为结构化和非结构化状态管理提供了稳健的机制, 使开发者能够选择最适合其应用程序需求的方法。
非结构化状态管理
在非结构化状态管理中,所有状态都存储在 Flow 类的 state 属性中。 这种方法提供了灵活性,使开发者能够动态添加或修改状态属性,而无需定义严格的模式。 即使是非结构化状态,CrewAI 流程也会自动为每个状态实例生成并维护唯一标识符 (UUID)。
python
from crewai.flow.flow import Flow, listen, start

class UnstructuredExampleFlow(Flow):

    @start()
    def first_method(self):
        # The state automatically includes an 'id' field
        print(f"State ID: {self.state['id']}")
        self.state['counter'] = 0
        self.state['message'] = "Hello from structured flow"

    @listen(first_method)
    def second_method(self):
        self.state['counter'] += 1
        self.state['message'] += " - updated"

    @listen(second_method)
    def third_method(self):
        self.state['counter'] += 1
        self.state['message'] += " - updated again"

        print(f"State after third_method: {self.state}")

flow = UnstructuredExampleFlow()
flow.plot("my_flow_plot")
flow.kickoff()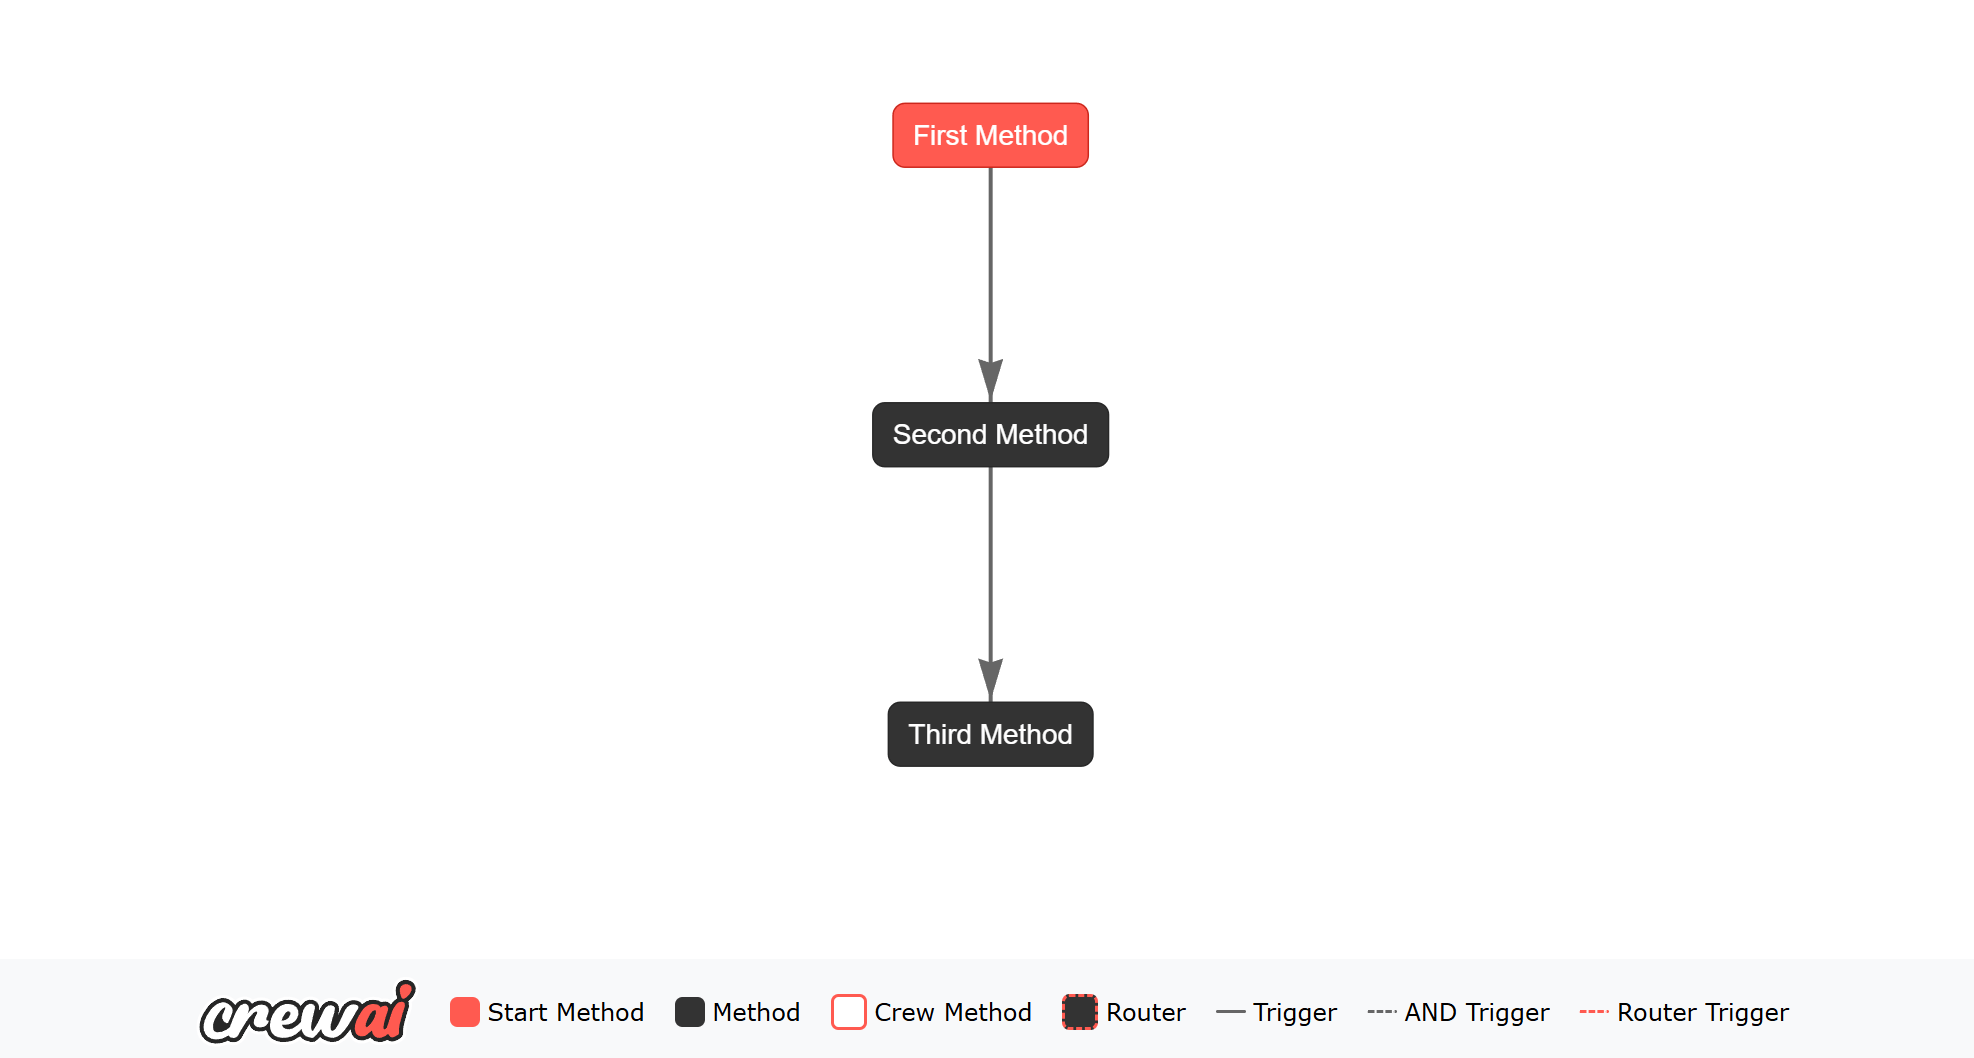
注意: id 字段会在流程执行期间自动生成并保留。你无需手动管理或设置它,即使使用新数据更新状态,它也会保持不变。
要点:
- 灵活性: 你可以在没有预定义约束的情况下动态向
self.state添加属性。 - 简单性: 非常适合状态结构极少或变化很大的简单工作流。
结构化状态管理
结构化状态管理利用预定义模式来确保整个工作流中的一致性和类型安全。 通过使用像 Pydantic 的 BaseModel 这样的模型,开发者可以定义状态的确切结构,从而在开发环境中实现更好的验证和自动补全。
CrewAI 流程中的每个状态都会自动获得一个唯一标识符 (UUID),以帮助跟踪和管理状态实例。此 ID 由 Flow 系统自动生成和管理。
python
from crewai.flow.flow import Flow, listen, start
from pydantic import BaseModel

class ExampleState(BaseModel):
    # Note: 'id' field is automatically added to all states
    counter: int = 0
    message: str = ""

class StructuredExampleFlow(Flow[ExampleState]):

    @start()
    def first_method(self):
        # Access the auto-generated ID if needed
        print(f"State ID: {self.state.id}")
        self.state.message = "Hello from structured flow"

    @listen(first_method)
    def second_method(self):
        self.state.counter += 1
        self.state.message += " - updated"

    @listen(second_method)
    def third_method(self):
        self.state.counter += 1
        self.state.message += " - updated again"

        print(f"State after third_method: {self.state}")

flow = StructuredExampleFlow()
flow.kickoff()要点:
- 定义的模式:
ExampleState清晰地概述了状态结构,增强了代码可读性和可维护性。 - 类型安全: 利用 Pydantic 确保状态属性遵循指定的类型,减少运行时错误。
- 自动补全: IDE 可以根据定义的状态模型提供更好的自动补全和错误检查。
在非结构化与结构化状态管理之间选择
在以下情况下使用非结构化状态管理:
- 工作流的状态简单或高度动态。
- 灵活性优先于严格的状态定义。
- 需要快速原型设计,且无需承担定义模式的开销。
在以下情况下使用结构化状态管理:
- 工作流需要明确定义且一致的状态结构。
- 类型安全和验证对于应用程序的可靠性很重要。
- 你希望利用 IDE 功能(如自动补全和类型检查)来获得更好的开发者体验。
通过同时提供非结构化和结构化状态管理选项,CrewAI 流程使开发者能够构建既灵活又健壮的 AI 工作流,满足广泛的应用程序需求。
流程持久化
@persist 装饰器可在 CrewAI 流程中实现自动状态持久化,使你能够在重启或不同的工作流执行之间保持流程状态。该装饰器既可以应用于类级别,也可以应用于方法级别,从而在管理状态持久化方式时提供灵活性。
类级别持久化
当应用于类级别时,@persist 装饰器会自动持久化所有流程方法的状态:
python
@persist  # Using SQLiteFlowPersistence by default
class MyFlow(Flow[MyState]):
    @start()
    def initialize_flow(self):
        # This method will automatically have its state persisted
        self.state.counter = 1
        print("Initialized flow. State ID:", self.state.id)

    @listen(initialize_flow)
    def next_step(self):
        # The state (including self.state.id) is automatically reloaded
        self.state.counter += 1
print("Flow state is persisted. Counter:", self.state.counter)方法级别持久化
为了获得更细粒度的控制,你可以将 @persist 应用于特定方法:
python
class AnotherFlow(Flow[dict]):
    @persist  # Persists only this method's state
    @start()
    def begin(self):
        if "runs" not in self.state:
            self.state["runs"] = 0
        self.state["runs"] += 1
print("Method-level persisted runs:", self.state["runs"])分叉已持久化状态
@persist 在 kickoff / kickoff_async 上支持两种不同的状态加载模式:
kickoff(inputs=""id": <uuid>")— 恢复:为提供的 UUID 加载最新快照,并在同一个flow_uuid下继续写入。历史记录会延续。kickoff(restore_from_state_id=<uuid>)— 分叉:为提供的 UUID 加载最新快照,据此为新运行的状态填充数据,并分配新的state.id(自动生成,或在固定时使用inputs["id"])。新运行的@persist写入会落在新的state.id下;源流程的历史记录会保留。
python
from crewai.flow.flow import Flow, start
from crewai.flow.persistence import persist
from pydantic import BaseModel

class CounterState(BaseModel):
    id: str = ""
    counter: int = 0

@persist
class CounterFlow(Flow[CounterState]):
    @start()
    def step(self):
        self.state.counter += 1
        print(f"[id={self.state.id}] counter={self.state.counter}")

# Run 1: fresh state, counter 0 -> 1, persisted under flow_1.state.id
flow_1 = CounterFlow()
flow_1.kickoff()

# Fork: hydrate from flow_1's latest snapshot, but use a NEW state.id
flow_2 = CounterFlow()
flow_2.kickoff(restore_from_state_id=flow_1.state.id)
# flow_2.state.counter starts at 1 (hydrated), then step() bumps it to 2.
# flow_2.state.id != flow_1.state.id; flow_1's history is unchanged.如果提供的 restore_from_state_id 不匹配任何已持久化状态,kickoff 会静默回退——与现有 inputs["id"] 恢复时未找到的行为相同。将 restore_from_state_id 与 from_checkpoint 组合使用会引发 ValueError;请选择一个加载来源。分叉时固定 inputs["id"] 会与另一个流程共享持久化键——通常你只需要 restore_from_state_id。
工作原理
唯一状态标识
- 每个流程状态都会自动获得一个唯一 UUID
- 该 ID 在状态更新和方法调用之间保持不变
- 同时支持结构化(Pydantic BaseModel)和非结构化(字典)状态
默认 SQLite 后端
- SQLiteFlowPersistence 是默认的存储后端
- 状态会自动保存到本地 SQLite 数据库
- 健壮的错误处理确保在数据库操作失败时给出清晰的消息
错误处理
- 针对数据库操作的详尽错误消息
- 保存和加载时自动进行状态校验
- 持久化操作遇到问题时给出清晰反馈
重要注意事项
- 状态类型:同时支持结构化(Pydantic BaseModel)和非结构化(字典)状态
- 自动 ID:如果
id字段不存在,会自动添加 - 状态恢复:失败或重启的流程可以自动重新加载先前的状态
- 自定义实现:你可以提供自己的 FlowPersistence 实现以满足专门的存储需求
技术优势
通过低层访问实现精确控制
- 为高级用例提供对持久化操作的直接访问
- 通过方法级持久化装饰器实现细粒度控制
- 内置状态检查与调试能力
- 完全可见的状态变更与持久化操作
更强的可靠性
- 系统故障或重启后自动恢复状态
- 基于事务的状态更新以保障数据完整性
- 全面的错误处理与清晰的错误消息
- 状态保存和加载过程中的健壮校验
可扩展的架构
- 通过 FlowPersistence 接口自定义持久化后端
- 支持 SQLite 之外的专门存储方案
- 兼容结构化(Pydantic)和非结构化(dict)状态
- 与现有的 CrewAI 流程模式无缝集成
持久化系统的架构强调技术精确性和自定义选项,让开发者在享受内置可靠性特性的同时,对状态管理保持完全的控制。
流程控制
条件逻辑:or
Flows 中的 or_ 函数允许你监听多个方法,并在任一指定方法发出输出时触发监听方法。
python
from crewai.flow.flow import Flow, listen, or_, start

class OrExampleFlow(Flow):

    @start()
    def start_method(self):
        return "Hello from the start method"

    @listen(start_method)
    def second_method(self):
        return "Hello from the second method"

    @listen(or_(start_method, second_method))
    def logger(self, result):
        print(f"Logger: {result}")

flow = OrExampleFlow()
flow.plot("my_flow_plot")
flow.kickoff()text
Logger: Hello from the start method
Logger: Hello from the second method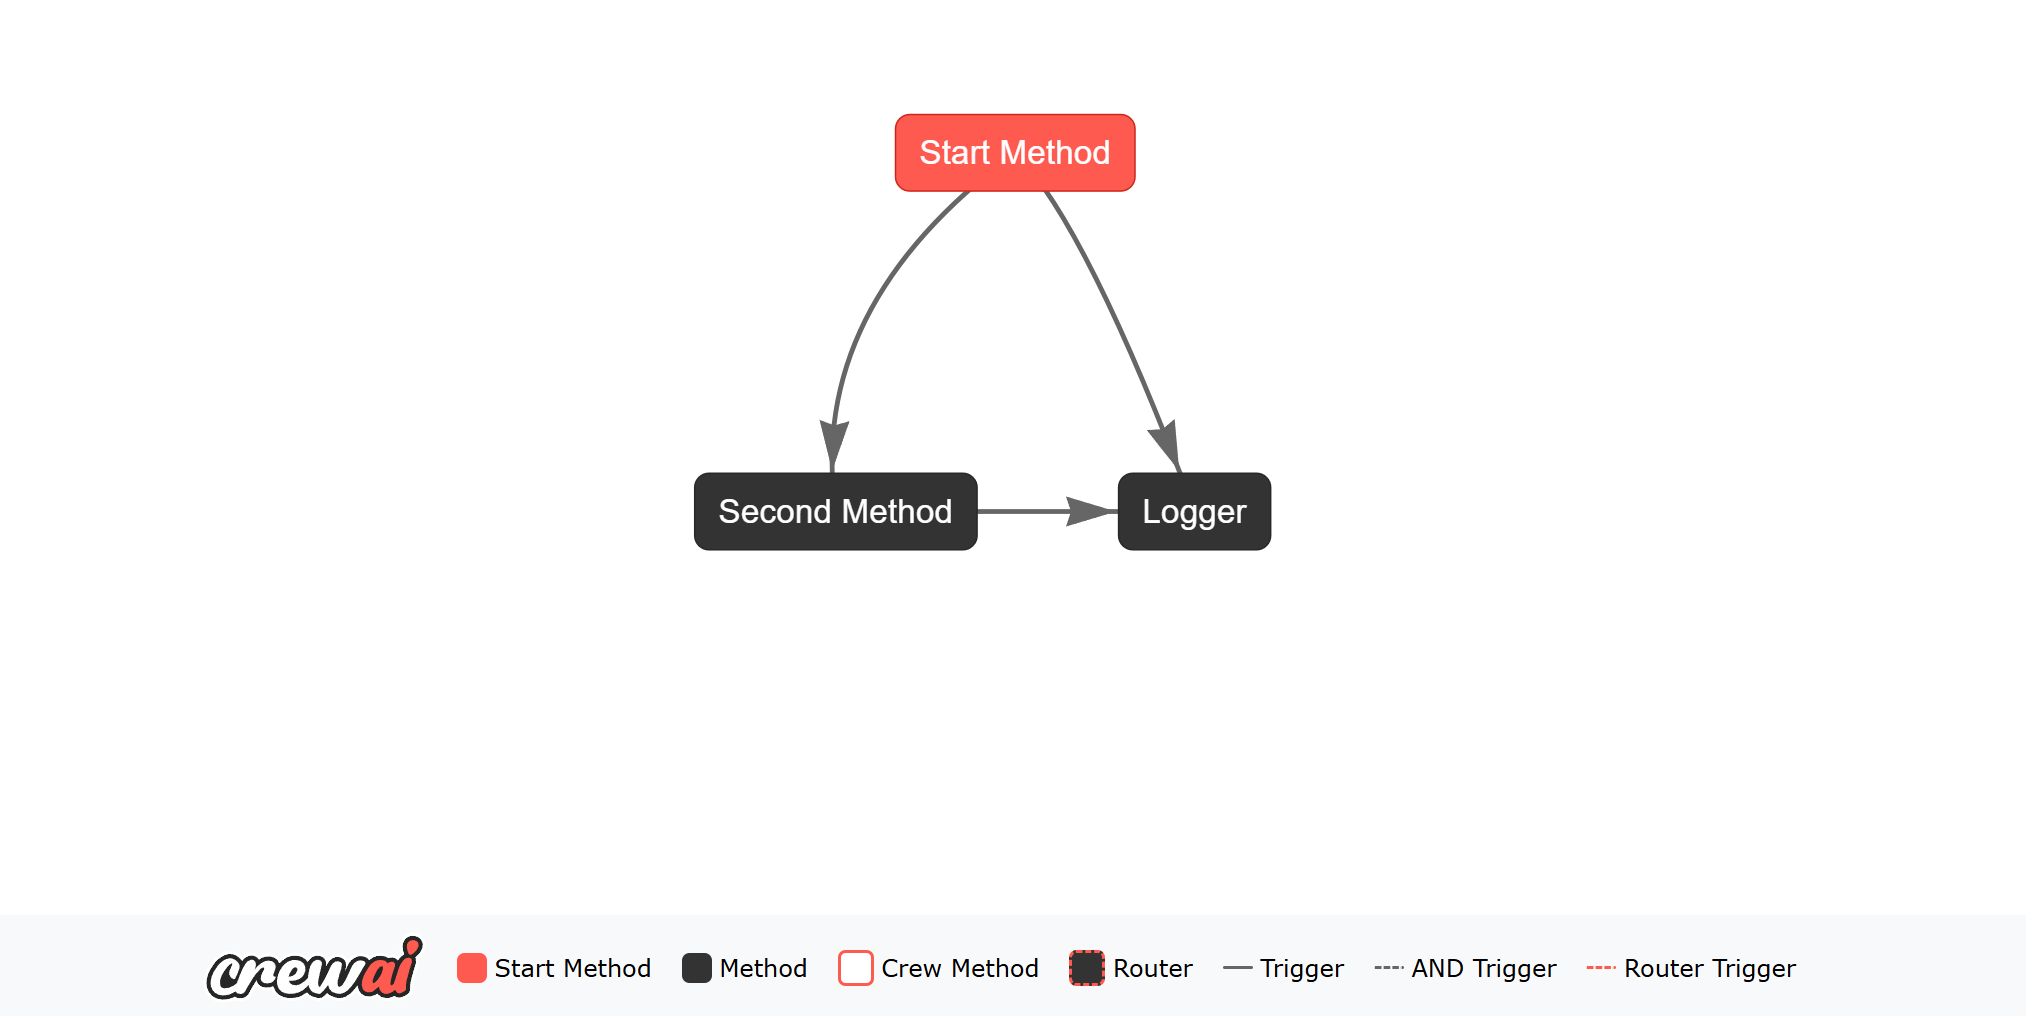
运行此流程时,logger 方法会被 start_method 或 second_method 的输出触发。 or_ 函数用于监听多个方法,并在任一指定方法发出输出时触发监听方法。
条件逻辑:and
Flows 中的 and_ 函数允许你监听多个方法,并仅在所有指定方法都发出输出时才触发监听方法。
python
from crewai.flow.flow import Flow, and_, listen, start

class AndExampleFlow(Flow):

    @start()
    def start_method(self):
        self.state["greeting"] = "Hello from the start method"

    @listen(start_method)
    def second_method(self):
        self.state["joke"] = "What do computers eat? Microchips."

    @listen(and_(start_method, second_method))
    def logger(self):
        print("---- Logger ----")
        print(self.state)

flow = AndExampleFlow()
flow.plot()
flow.kickoff()text
---- Logger ----
{'greeting': 'Hello from the start method', 'joke': 'What do computers eat? Microchips.'}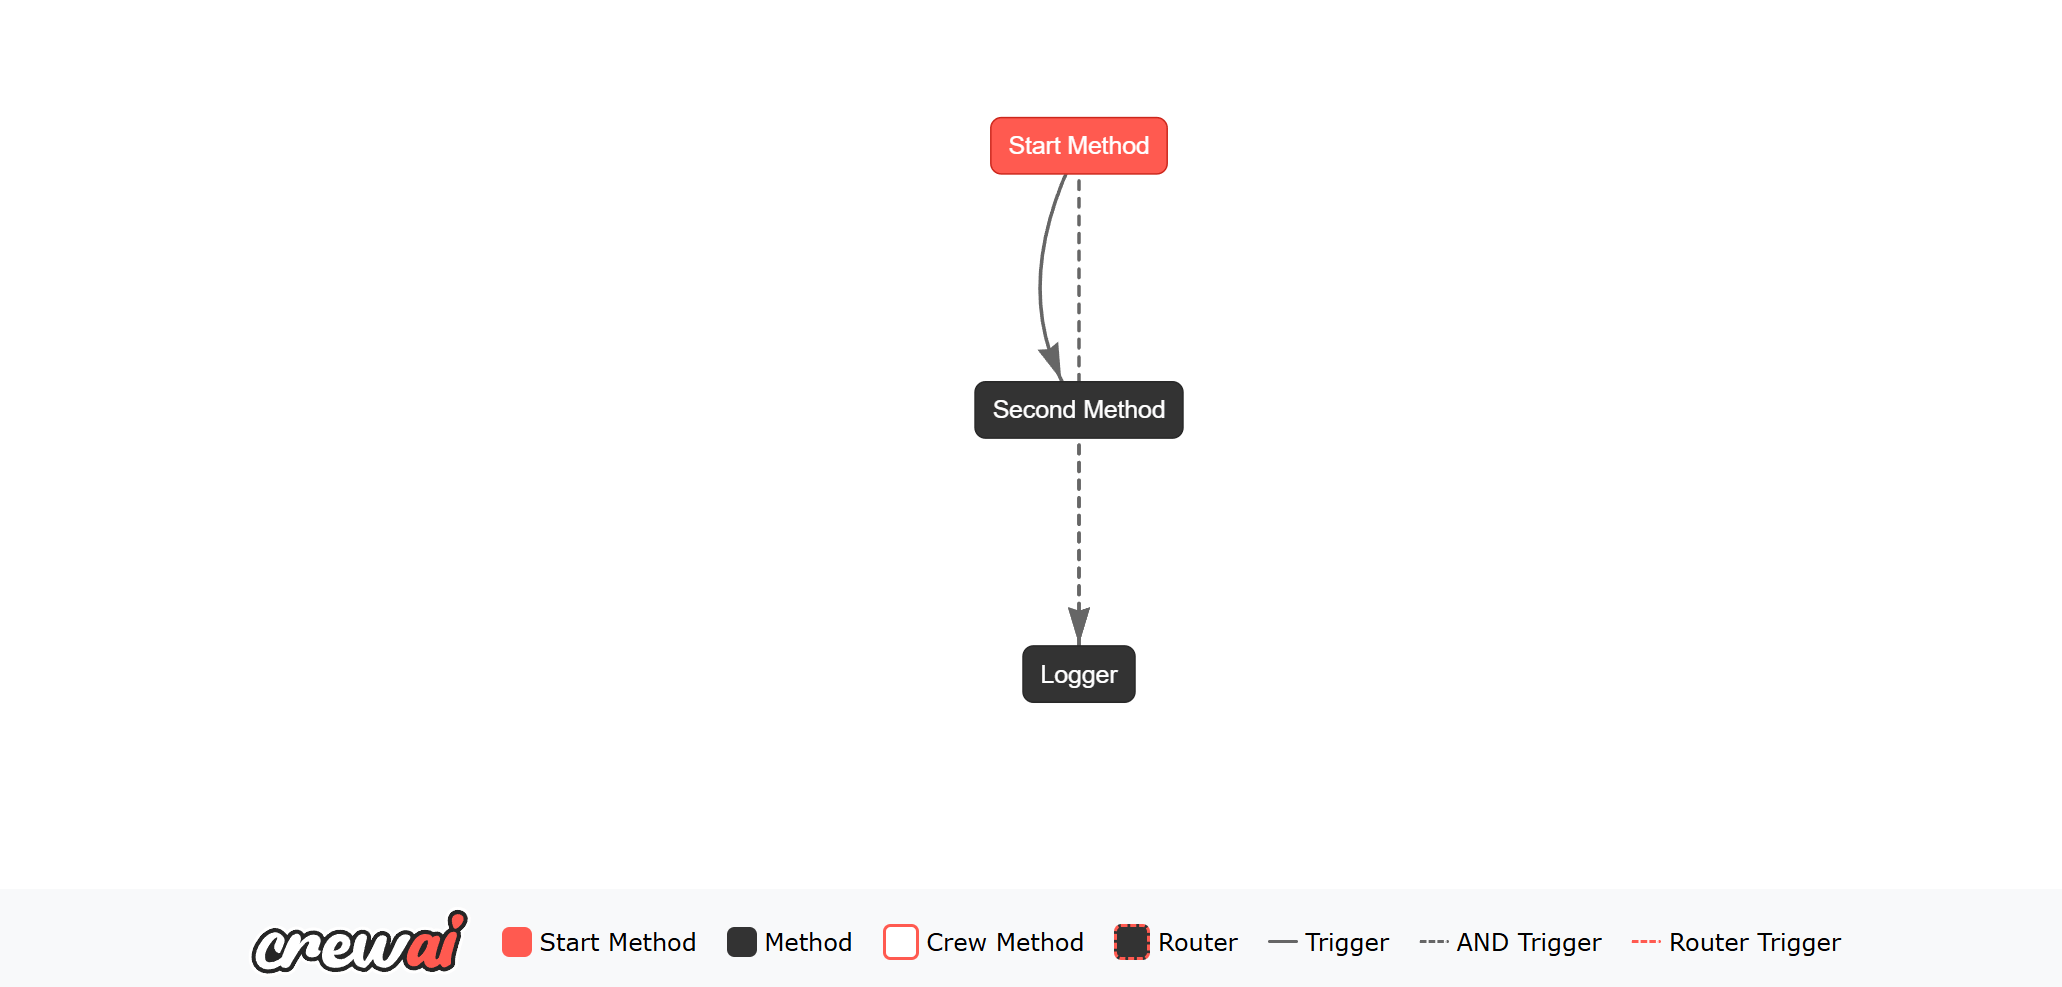
运行此流程时,只有当 start_method 和 second_method 都发出输出后,logger 方法才会被触发。 and_ 函数用于监听多个方法,并仅在所有指定方法都发出输出时才触发监听方法。
路由
Flows 中的 @router() 装饰器允许你基于某个方法的输出定义条件路由逻辑。 你可以根据方法的输出指定不同的路由,从而动态控制执行流程。
python
import random
from typing import Literal

from crewai.flow.flow import Flow, listen, router, start
from pydantic import BaseModel

class ExampleState(BaseModel):
    success_flag: bool = False

class RouterFlow(Flow[ExampleState]):

    @start()
    def start_method(self):
        print("Starting the structured flow")
        random_boolean = random.choice([True, False])
        self.state.success_flag = random_boolean

    @router(start_method)
    def second_method(self) -> Literal["success", "failed"]:
        if self.state.success_flag:
            return "success"
        else:
            return "failed"

    @listen("success")
    def third_method(self):
        print("Third method running")

    @listen("failed")
    def fourth_method(self):
        print("Fourth method running")

flow = RouterFlow()
flow.plot("my_flow_plot")
flow.kickoff()text
Starting the structured flow
Third method running
Fourth method running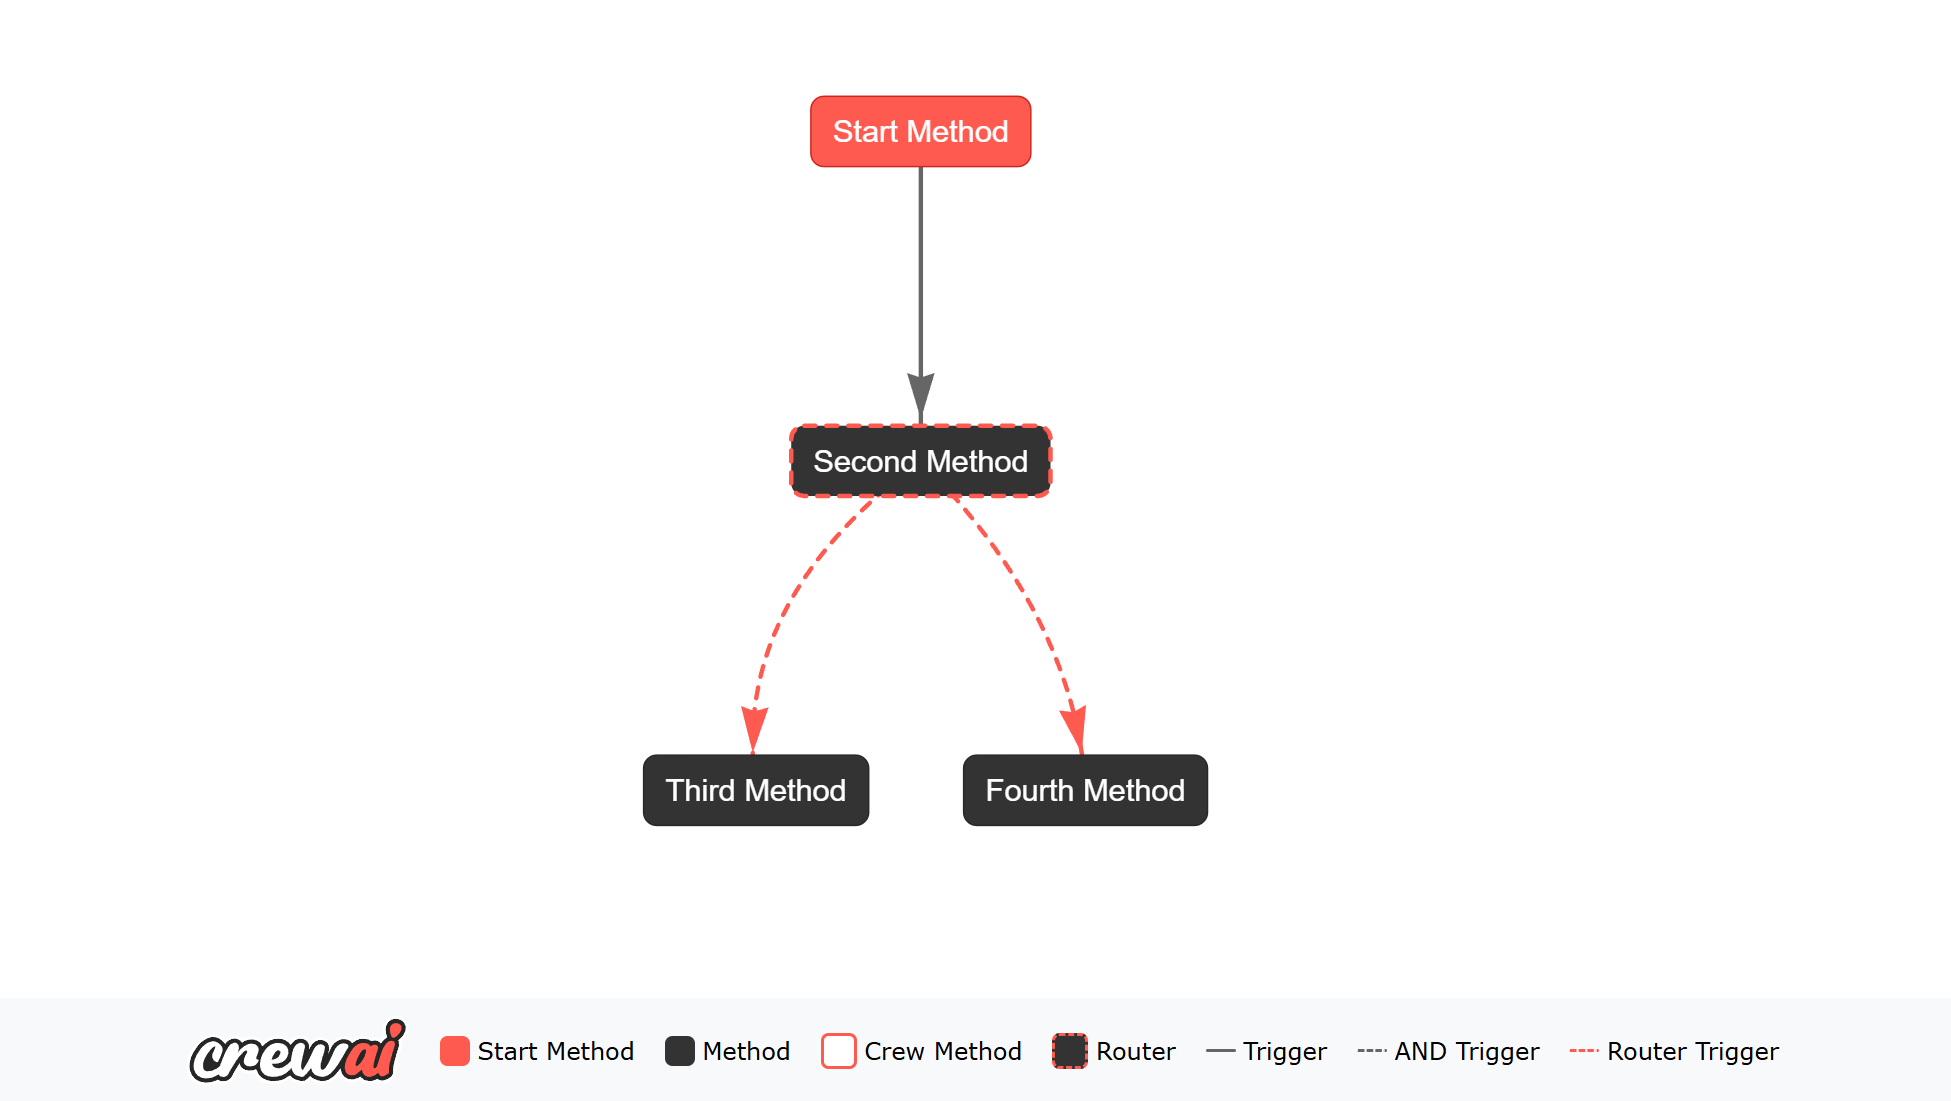
在上面的示例中,start_method 生成一个随机布尔值并将其设置到状态中。 second_method 使用 @router() 装饰器基于该布尔值定义条件路由逻辑。 如果布尔值为 True,该方法返回 "success";如果为 False,则返回 "failed"。 third_method 和 fourth_method 监听 second_method 的输出,并根据返回的值执行。
运行此流程时,输出会根据 start_method 生成的随机布尔值而变化。
声明路由的标签,以便工具能够看到其分支:像 second_method 那样用 Literal[...] 标注返回类型,或者通过 @router(start_method, emit=["success", "failed"]) 显式传入。flow.plot() 和 crewai flow plot 会从这里读取标签;若没有标签,图就无法绘制路由的分支。
人在回路(人工反馈)
NOTE
@human_feedback 装饰器需要 CrewAI 1.8.0 或更高版本。
@human_feedback 装饰器通过暂停流程执行来收集人类的反馈,从而实现人在回路工作流。这适用于审批关卡、质量评审以及需要人类判断的决策点。
python
from crewai.flow.flow import Flow, start, listen
from crewai.flow.human_feedback import human_feedback, HumanFeedbackResult

class ReviewFlow(Flow):
    @start()
    @human_feedback(
        message="Do you approve this content?",
        emit=["approved", "rejected", "needs_revision"],
        llm="gpt-4o-mini",
        default_outcome="needs_revision",
    )
    def generate_content(self):
        return "Content to be reviewed..."

    @listen("approved")
    def on_approval(self, result: HumanFeedbackResult):
        print(f"Approved! Feedback: {result.feedback}")

    @listen("rejected")
    def on_rejection(self, result: HumanFeedbackResult):
print(f"Rejected. Reason: {result.feedback}")指定 emit 时,人类的自由形式反馈会由 LLM 解读并归并到指定的某个结果中,进而触发对应的 @listen 装饰器。
你也可以在不用路由的情况下使用 @human_feedback,仅用于收集反馈:
python
@start()
@human_feedback(message="Any comments on this output?")
def my_method(self):
    return "Output for review"

@listen(my_method)
def next_step(self, result: HumanFeedbackResult):
    # Access feedback via result.feedback
    # Access original output via result.output
pass通过 self.last_human_feedback(最近一次)或 self.human_feedback_history(所有反馈组成的列表)访问流程中收集到的全部反馈。
有关流程中人工反馈的完整指南,包括使用自定义服务商(Slack、webhook 等)实现异步/非阻塞反馈,请参阅流程中的人工反馈。
将智能体添加到流程中
智能体可以无缝集成到你的流程中,当你需要更简单、聚焦的任务执行时,它提供了完整 Crews 的轻量替代方案。下面是一个在流程中使用智能体执行市场调研的示例:
python
import asyncio
from typing import Any, Dict, List

from crewai_tools import SerperDevTool
from pydantic import BaseModel, Field

from crewai.agent import Agent
from crewai.flow.flow import Flow, listen, start

# Define a structured output format
class MarketAnalysis(BaseModel):
    key_trends: List[str] = Field(description="List of identified market trends")
    market_size: str = Field(description="Estimated market size")
    competitors: List[str] = Field(description="Major competitors in the space")

# Define flow state
class MarketResearchState(BaseModel):
    product: str = ""
    analysis: MarketAnalysis | None = None

# Create a flow class
class MarketResearchFlow(Flow[MarketResearchState]):
    @start()
    def initialize_research(self) -> Dict[str, Any]:
        print(f"Starting market research for {self.state.product}")
        return {"product": self.state.product}

    @listen(initialize_research)
    async def analyze_market(self) -> Dict[str, Any]:
        # Create an Agent for market research
        analyst = Agent(
            role="Market Research Analyst",
            goal=f"Analyze the market for {self.state.product}",
            backstory="You are an experienced market analyst with expertise in "
            "identifying market trends and opportunities.",
            tools=[SerperDevTool()],
            verbose=True,
        )

        # Define the research query
        query = f"""
        Research the market for {self.state.product}. Include:
        1. Key market trends
        2. Market size
        3. Major competitors

        Format your response according to the specified structure.
        """

        # Execute the analysis with structured output format
        result = await analyst.kickoff_async(query, response_format=MarketAnalysis)
        if result.pydantic:
            print("result", result.pydantic)
        else:
            print("result", result)

        # Return the analysis to update the state
        return {"analysis": result.pydantic}

    @listen(analyze_market)
    def present_results(self, analysis) -> None:
        print("\nMarket Analysis Results")
        print("=====================")

        if isinstance(analysis, dict):
            # If we got a dict with 'analysis' key, extract the actual analysis object
            market_analysis = analysis.get("analysis")
        else:
            market_analysis = analysis

        if market_analysis and isinstance(market_analysis, MarketAnalysis):
            print("\nKey Market Trends:")
            for trend in market_analysis.key_trends:
                print(f"- {trend}")

            print(f"\nMarket Size: {market_analysis.market_size}")

            print("\nMajor Competitors:")
            for competitor in market_analysis.competitors:
                print(f"- {competitor}")
        else:
            print("No structured analysis data available.")
            print("Raw analysis:", analysis)

# Usage example
async def run_flow():
    flow = MarketResearchFlow()
    flow.plot("MarketResearchFlowPlot")
    result = await flow.kickoff_async(inputs={"product": "AI-powered chatbots"})
    return result

# Run the flow
if __name__ == "__main__":
    asyncio.run(run_flow())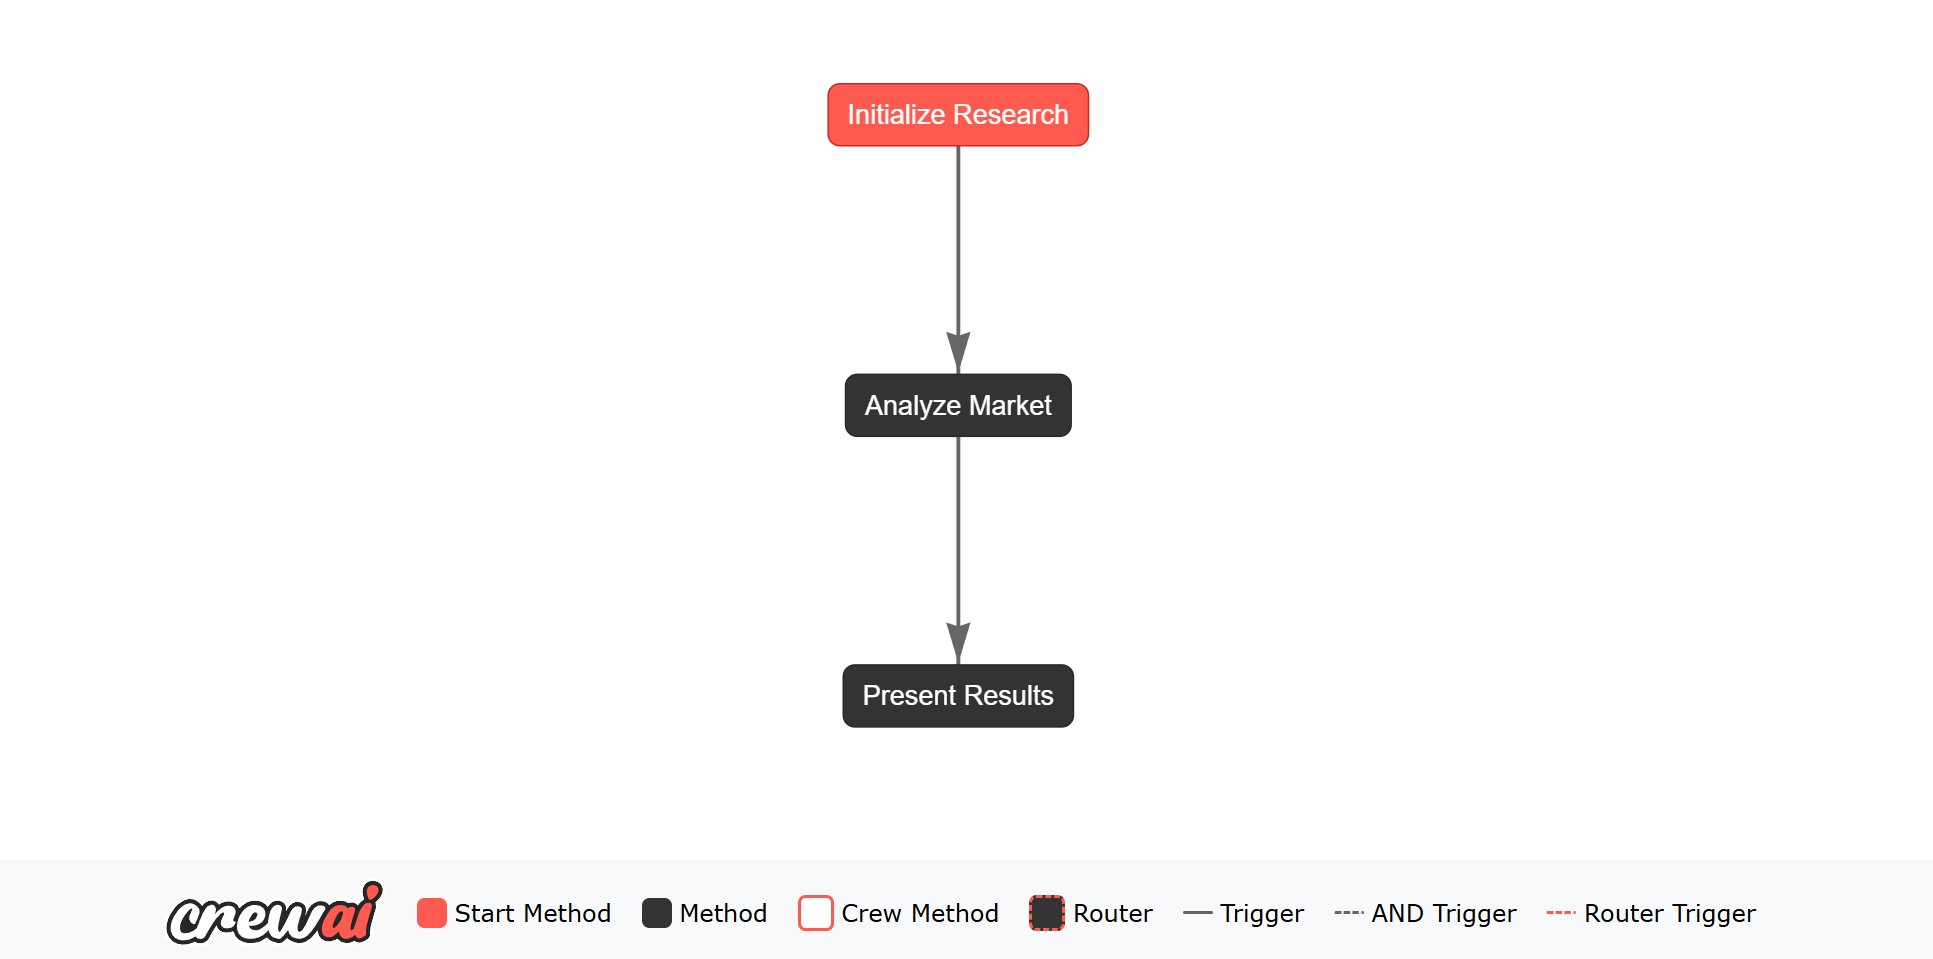
本示例演示了在流程中使用智能体的几个关键特性:
结构化输出:使用 Pydantic 模型定义预期的输出格式(
MarketAnalysis),确保整个流程中的类型安全和结构化数据。状态管理:流程状态(
MarketResearchState)在各步骤之间维护上下文,并同时存储输入和输出。工具集成:智能体可以使用工具(如
WebsiteSearchTool)来增强其能力。
将团队添加到流程中
在 CrewAI 中创建包含多个团队的流程非常简单。
你可以运行以下命令,生成一个新的 CrewAI 项目,其中包含创建多团队流程所需的全部脚手架:
bash
crewai create flow name_of_flow该命令将生成一个具有必要文件夹结构的新 CrewAI 项目。生成的项目包含一个名为 poem_crew 的预构建团队,且已可正常工作。起始的嵌入式团队使用经典的 Python/YAML 布局;使用 crewai create crew 创建的新独立团队则使用 JSON 优先的布局。
文件夹结构
运行 crewai create flow name_of_flow 命令后,你会看到类似下面的文件夹结构:
| 目录/文件 | 描述 |
|---|---|
name_of_flow/ | 流程的根目录。 |
├── crews/ | 包含各个具体团队的目录。 |
│ └── poem_crew/ | "poem_crew" 的目录,包含其配置和脚本。 |
│ ├── config/ | "poem_crew" 的配置文件目录。 |
│ │ ├── agents.yaml | 定义 "poem_crew" 智能体的 YAML 文件。 |
│ │ └── tasks.yaml | 定义 "poem_crew" 任务的 YAML 文件。 |
│ ├── poem_crew.py | "poem_crew" 功能的脚本。 |
├── tools/ | 流程中使用的额外工具的目录。 |
│ └── custom_tool.py | 自定义工具的实现。 |
├── main.py | 运行流程的主脚本。 |
├── README.md | 项目描述和使用说明。 |
├── pyproject.toml | 项目依赖和设置的配置文件。 |
└── .gitignore | 指定在版本控制中忽略的文件和目录。 |
构建你的团队
在 crews 文件夹中,你可以定义多个团队。生成的 poem_crew 使用经典的嵌入式团队结构:
config/agents.yaml:定义团队的智能体。config/tasks.yaml:定义团队的任务。poem_crew.py:包含团队定义,包括智能体、任务以及团队本身。
你可以复制、粘贴并编辑 poem_crew 来创建其他经典的嵌入式团队。
对于 JSON 优先的嵌入式团队,请改用包含 crew.jsonc 和 agents/*.jsonc 的文件夹:
text
crews/
└── research_crew/
    ├── agents/
    │   └── researcher.jsonc
└── crew.jsonc然后在流程的某个步骤中加载它:
python
from pathlib import Path
from crewai.project import load_crew

crew, default_inputs = load_crew(
    Path(__file__).parent / "crews" / "research_crew" / "crew.jsonc"
)
result = crew.kickoff(inputs={**default_inputs, "topic": "AI Agents"})在 main.py 中连接团队
main.py 文件是你创建流程并将各团队连接起来的地方。你可以使用 Flow 类以及 @start 和 @listen 装饰器来定义流程,指定执行流程。
下面是一个在 main.py 文件中连接 poem_crew 的示例:
python
#!/usr/bin/env python
from random import randint

from pydantic import BaseModel
from crewai.flow.flow import Flow, listen, start
from .crews.poem_crew.poem_crew import PoemCrew

class PoemState(BaseModel):
    sentence_count: int = 1
    poem: str = ""

class PoemFlow(Flow[PoemState]):

    @start()
    def generate_sentence_count(self):
        print("Generating sentence count")
        self.state.sentence_count = randint(1, 5)

    @listen(generate_sentence_count)
    def generate_poem(self):
        print("Generating poem")
        result = PoemCrew().crew().kickoff(inputs={"sentence_count": self.state.sentence_count})

        print("Poem generated", result.raw)
        self.state.poem = result.raw

    @listen(generate_poem)
    def save_poem(self):
        print("Saving poem")
        with open("poem.txt", "w") as f:
            f.write(self.state.poem)

def kickoff():
    poem_flow = PoemFlow()
    poem_flow.kickoff()

def plot():
    poem_flow = PoemFlow()
    poem_flow.plot("PoemFlowPlot")

if __name__ == "__main__":
    kickoff()
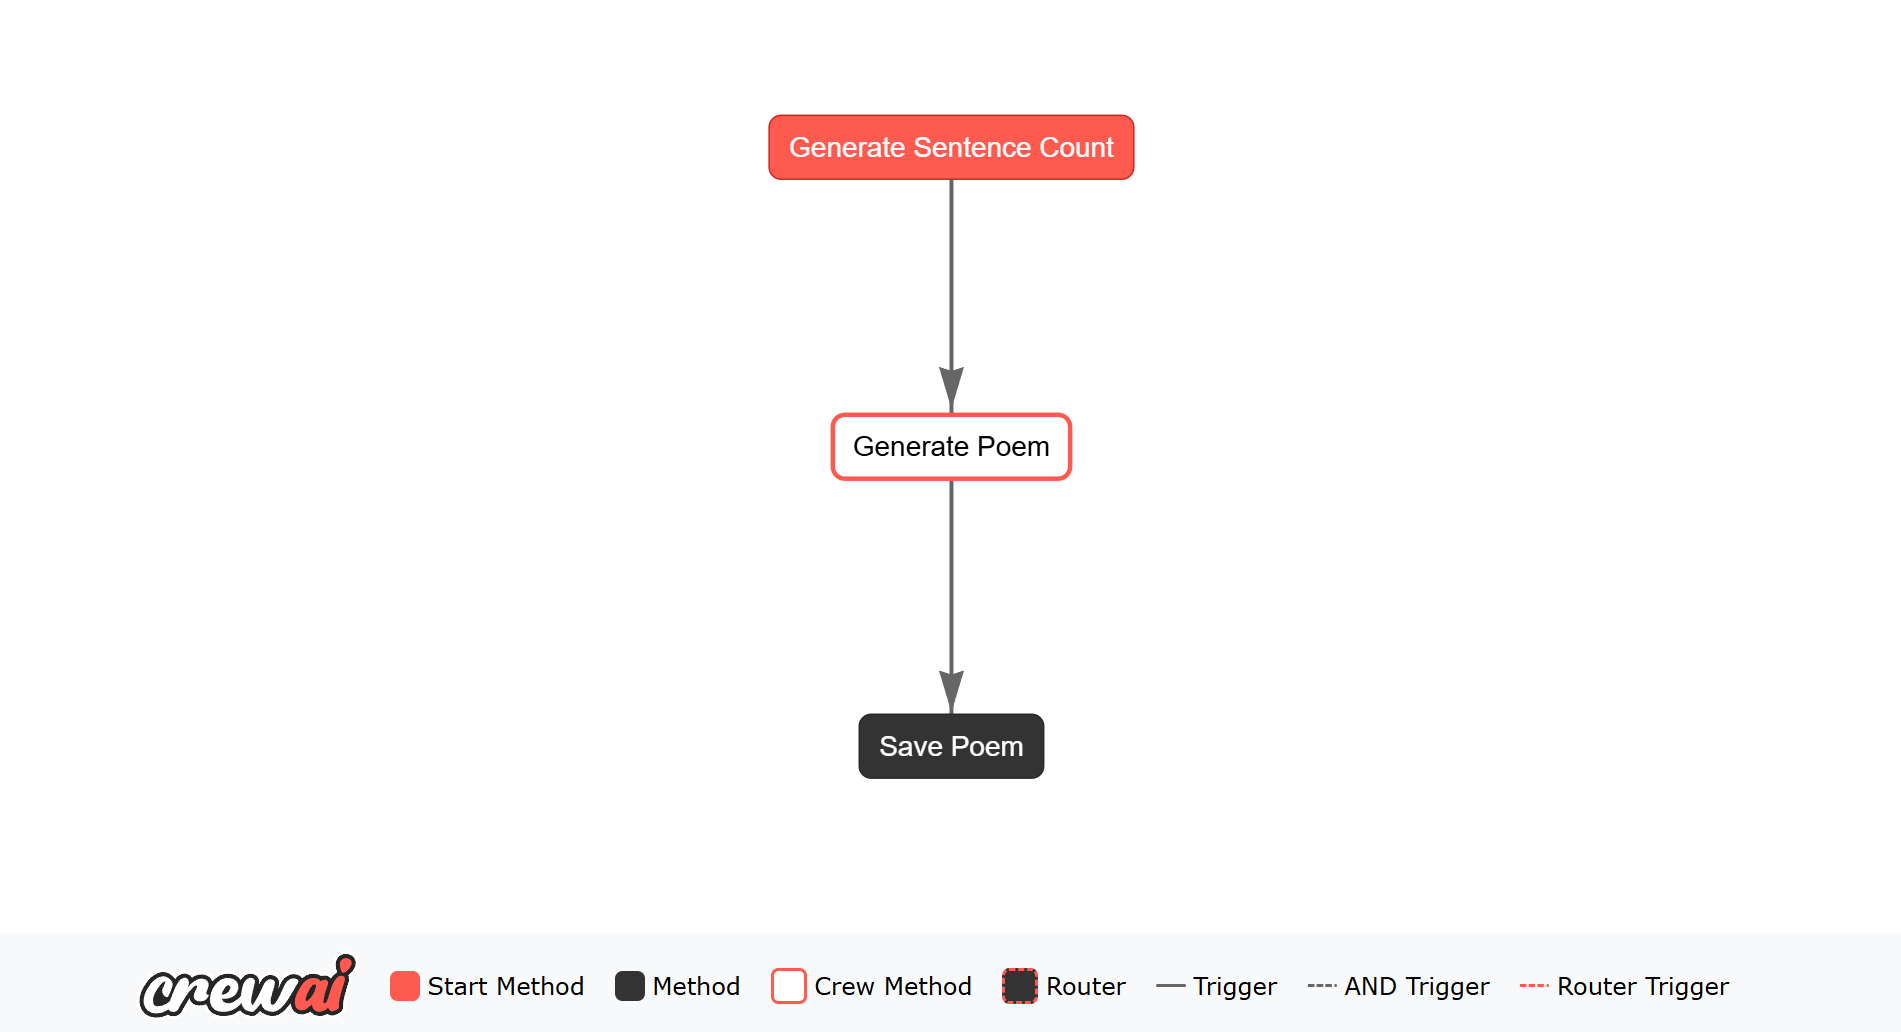
plot()在本示例中,PoemFlow 类定义了一个流程:生成句子数量、使用 PoemCrew 生成诗歌,然后将诗歌保存到文件。通过调用 kickoff() 方法启动流程。PoemFlowPlot 将由 plot() 方法生成。
运行流程
(可选)在运行流程之前,你可以通过运行以下命令安装依赖:
bash
crewai install安装完所有依赖后,你需要通过运行以下命令来激活虚拟环境:
bash
source .venv/bin/activate激活虚拟环境后,你可以使用 CrewAI CLI 运行流程:
bash
crewai run你也可以直接运行项目脚本:
bash
uv run kickoff流程将会执行,你应该会在控制台中看到输出。
绘制流程
将你的 AI 工作流可视化,可以为理解流程的结构与执行路径提供有价值的洞察。CrewAI 提供了一套强大的可视化工具,让你能够生成流程的交互式图表,从而更轻松地理解和优化你的 AI 工作流。
什么是图表?
CrewAI 中的图表是你的 AI 工作流的图形化呈现。它们展示各个任务、任务之间的连接以及数据在其中的流转。这种可视化有助于理解操作顺序、识别瓶颈,并确保工作流逻辑符合你的预期。
如何生成图表
CrewAI 提供两种便捷的方式来生成流程图表:
方式一:使用 plot() 方法
如果你直接操作流程实例,可以在流程对象上调用 plot() 方法来生成图表。该方法会创建一个包含流程交互式图表的 HTML 文件。
python
# Assuming you have a flow instance
flow.plot("my_flow_plot")这会在当前目录下生成一个名为 my_flow_plot.html 的文件。你可以在网页浏览器中打开该文件来查看交互式图表。
方式二:使用命令行
如果你在结构化的 CrewAI 项目中工作,可以使用命令行生成图表。当你想要可视化整个流程设置时,这种方式对较大的项目尤其有用。
bash
crewai flow plot该命令会生成一个包含流程图表的 HTML 文件,与 plot() 方法类似。该文件会保存到你的项目目录中,你可以在网页浏览器中打开它来探索流程。
理解图表
生成的图表会显示代表流程中各个任务的节点,并用有向边表示执行流程。图表是交互式的,你可以放大和缩小,并悬停在节点上查看额外详情。
通过可视化你的流程,你可以更清晰地理解工作流的结构,从而更轻松地调试、优化你的 AI 流程,并向他人传达这些流程。
结语
绘制流程图表是 CrewAI 的一项强大功能,能增强你设计和管理复杂 AI 工作流的能力。无论你选择使用 plot() 方法还是命令行,生成图表都能为你提供工作流的可视化呈现,助力开发与演示。
下一步
如果你有兴趣探索更多流程示例,我们的示例仓库中提供了多种推荐。以下是四个具体的流程示例,每个示例都展示了独特的用例,帮助你将当前的问题类型匹配到具体示例:
邮件自动回复流程:该示例演示了一个无限循环,其中后台任务持续运行以自动化邮件回复。对于需要重复执行且无需人工干预的任务来说,这是一个很好的用例。查看示例
线索评分流程:该流程展示了如何添加人在回路反馈,并使用路由处理不同的条件分支。这是如何将动态决策和人工监督融入工作流的优秀示例。查看示例
写一本书流程:该示例擅长将多个团队串联起来,其中一个团队的输出会被另一个团队使用。具体来说,一个团队负责规划整本书的大纲,另一个团队根据大纲生成各章节。最终,所有内容被连接起来,产出一本完整的书。该流程非常适合需要在不同任务之间协调的复杂多步骤流程。查看示例
会议助手流程:该流程演示了如何广播单个事件以触发多个后续操作。例如,会议结束后,该流程可以更新 Trello 看板、发送 Slack 消息并保存结果。这是处理单一事件产生多种结果的优秀示例,非常适合全面的任务管理和通知系统。查看示例
通过探索这些示例,你可以深入了解如何将 CrewAI Flows 用于各种用例,从自动化重复性任务,到通过动态决策和人工反馈管理复杂的多步骤流程。
此外,也欢迎观看我们下方关于如何在 CrewAI 中使用流程的 YouTube 视频!
运行流程
有两种方式可以运行流程:
使用 Flow API
你可以通过创建流程类的实例并调用 kickoff() 方法来以编程方式运行流程:
python
flow = ExampleFlow()
result = flow.kickoff()流式执行流程
为了实时查看流程执行情况,你可以启用流式传输,以便在输出生成时即时接收:
python
class StreamingFlow(Flow):
    stream = True  # Enable streaming

    @start()
    def research(self):
        # Your flow implementation
        pass

# Iterate over streaming output
flow = StreamingFlow()
streaming = flow.kickoff()
for chunk in streaming:
    print(chunk.content, end="", flush=True)

# Access final result
result = streaming.result在 流式执行流程 指南中了解更多关于流式传输的内容。
流程中的记忆
每个 Flow 都自动可以访问 CrewAI 统一的 记忆 系统。你可以使用三个内置便捷方法,在任何流程方法中直接存储、回忆和提取记忆。
内置方法
| 方法 | 描述 |
|---|---|
self.remember(content, **kwargs) | 将内容存储到记忆中。可选参数包括 scope、categories、metadata、importance。 |
self.recall(query, **kwargs) | 检索相关记忆。可选参数包括 scope、categories、limit、depth。 |
self.extract_memories(content) | 将原始文本拆分为离散的、自包含的记忆语句。 |
Flow 初始化时会自动创建一个默认的 Memory() 实例。你也可以传入自定义实例:
python
from crewai.flow.flow import Flow
from crewai import Memory

custom_memory = Memory(
    recency_weight=0.5,
    recency_half_life_days=7,
    embedder={"provider": "ollama", "config": {"model_name": "mxbai-embed-large"}},
)

flow = MyFlow(memory=custom_memory)示例:研究与分析流程
python
from crewai.flow.flow import Flow, listen, start

class ResearchAnalysisFlow(Flow):
    @start()
    def gather_data(self):
        # Simulate research findings
        findings = (
            "PostgreSQL handles 10k concurrent connections with connection pooling. "
            "MySQL caps at around 5k. MongoDB scales horizontally but adds complexity."
        )

        # Extract atomic facts and remember each one
        memories = self.extract_memories(findings)
        for mem in memories:
            self.remember(mem, scope="/research/databases")

        return findings

    @listen(gather_data)
    def analyze(self, raw_findings):
        # Recall relevant past research (from this run or previous runs)
        past = self.recall("database performance and scaling", limit=10, depth="shallow")

        context_lines = [f"- {m.record.content}" for m in past]
        context = "\n".join(context_lines) if context_lines else "No prior context."

        return {
            "new_findings": raw_findings,
            "prior_context": context,
            "total_memories": len(past),
        }

flow = ResearchAnalysisFlow()
result = flow.kickoff()
print(result)由于记忆会跨运行持久保留(由磁盘上的 LanceDB 支持),analyze 步骤也会回忆此前执行中发现的内容——这使流程能够随时间推移学习和积累知识。
有关作用域、切片、复合评分、嵌入器配置等详细信息,请参阅 记忆文档。
使用 CLI
从 0.103.0 版本开始,你可以使用 crewai run 命令运行流程:
shell
crewai run该命令会自动检测你的项目是否为流程(依据 pyproject.toml 中的 type = "flow" 设置),并相应地运行它。这是从命令行运行流程的推荐方式。
旧版的 crewai flow kickoff 命令已弃用。请对团队和流程统一使用 crewai run。