
主题
CrewAI 追踪
通过 CrewAI AMP 平台为 CrewAI 团队和流程提供内置追踪
CrewAI 内置追踪
CrewAI 提供内置追踪能力,使你能够实时监控和调试你的团队和流程。本指南演示如何使用 CrewAI 的集成可观测性平台为 团队 和 流程 启用追踪。
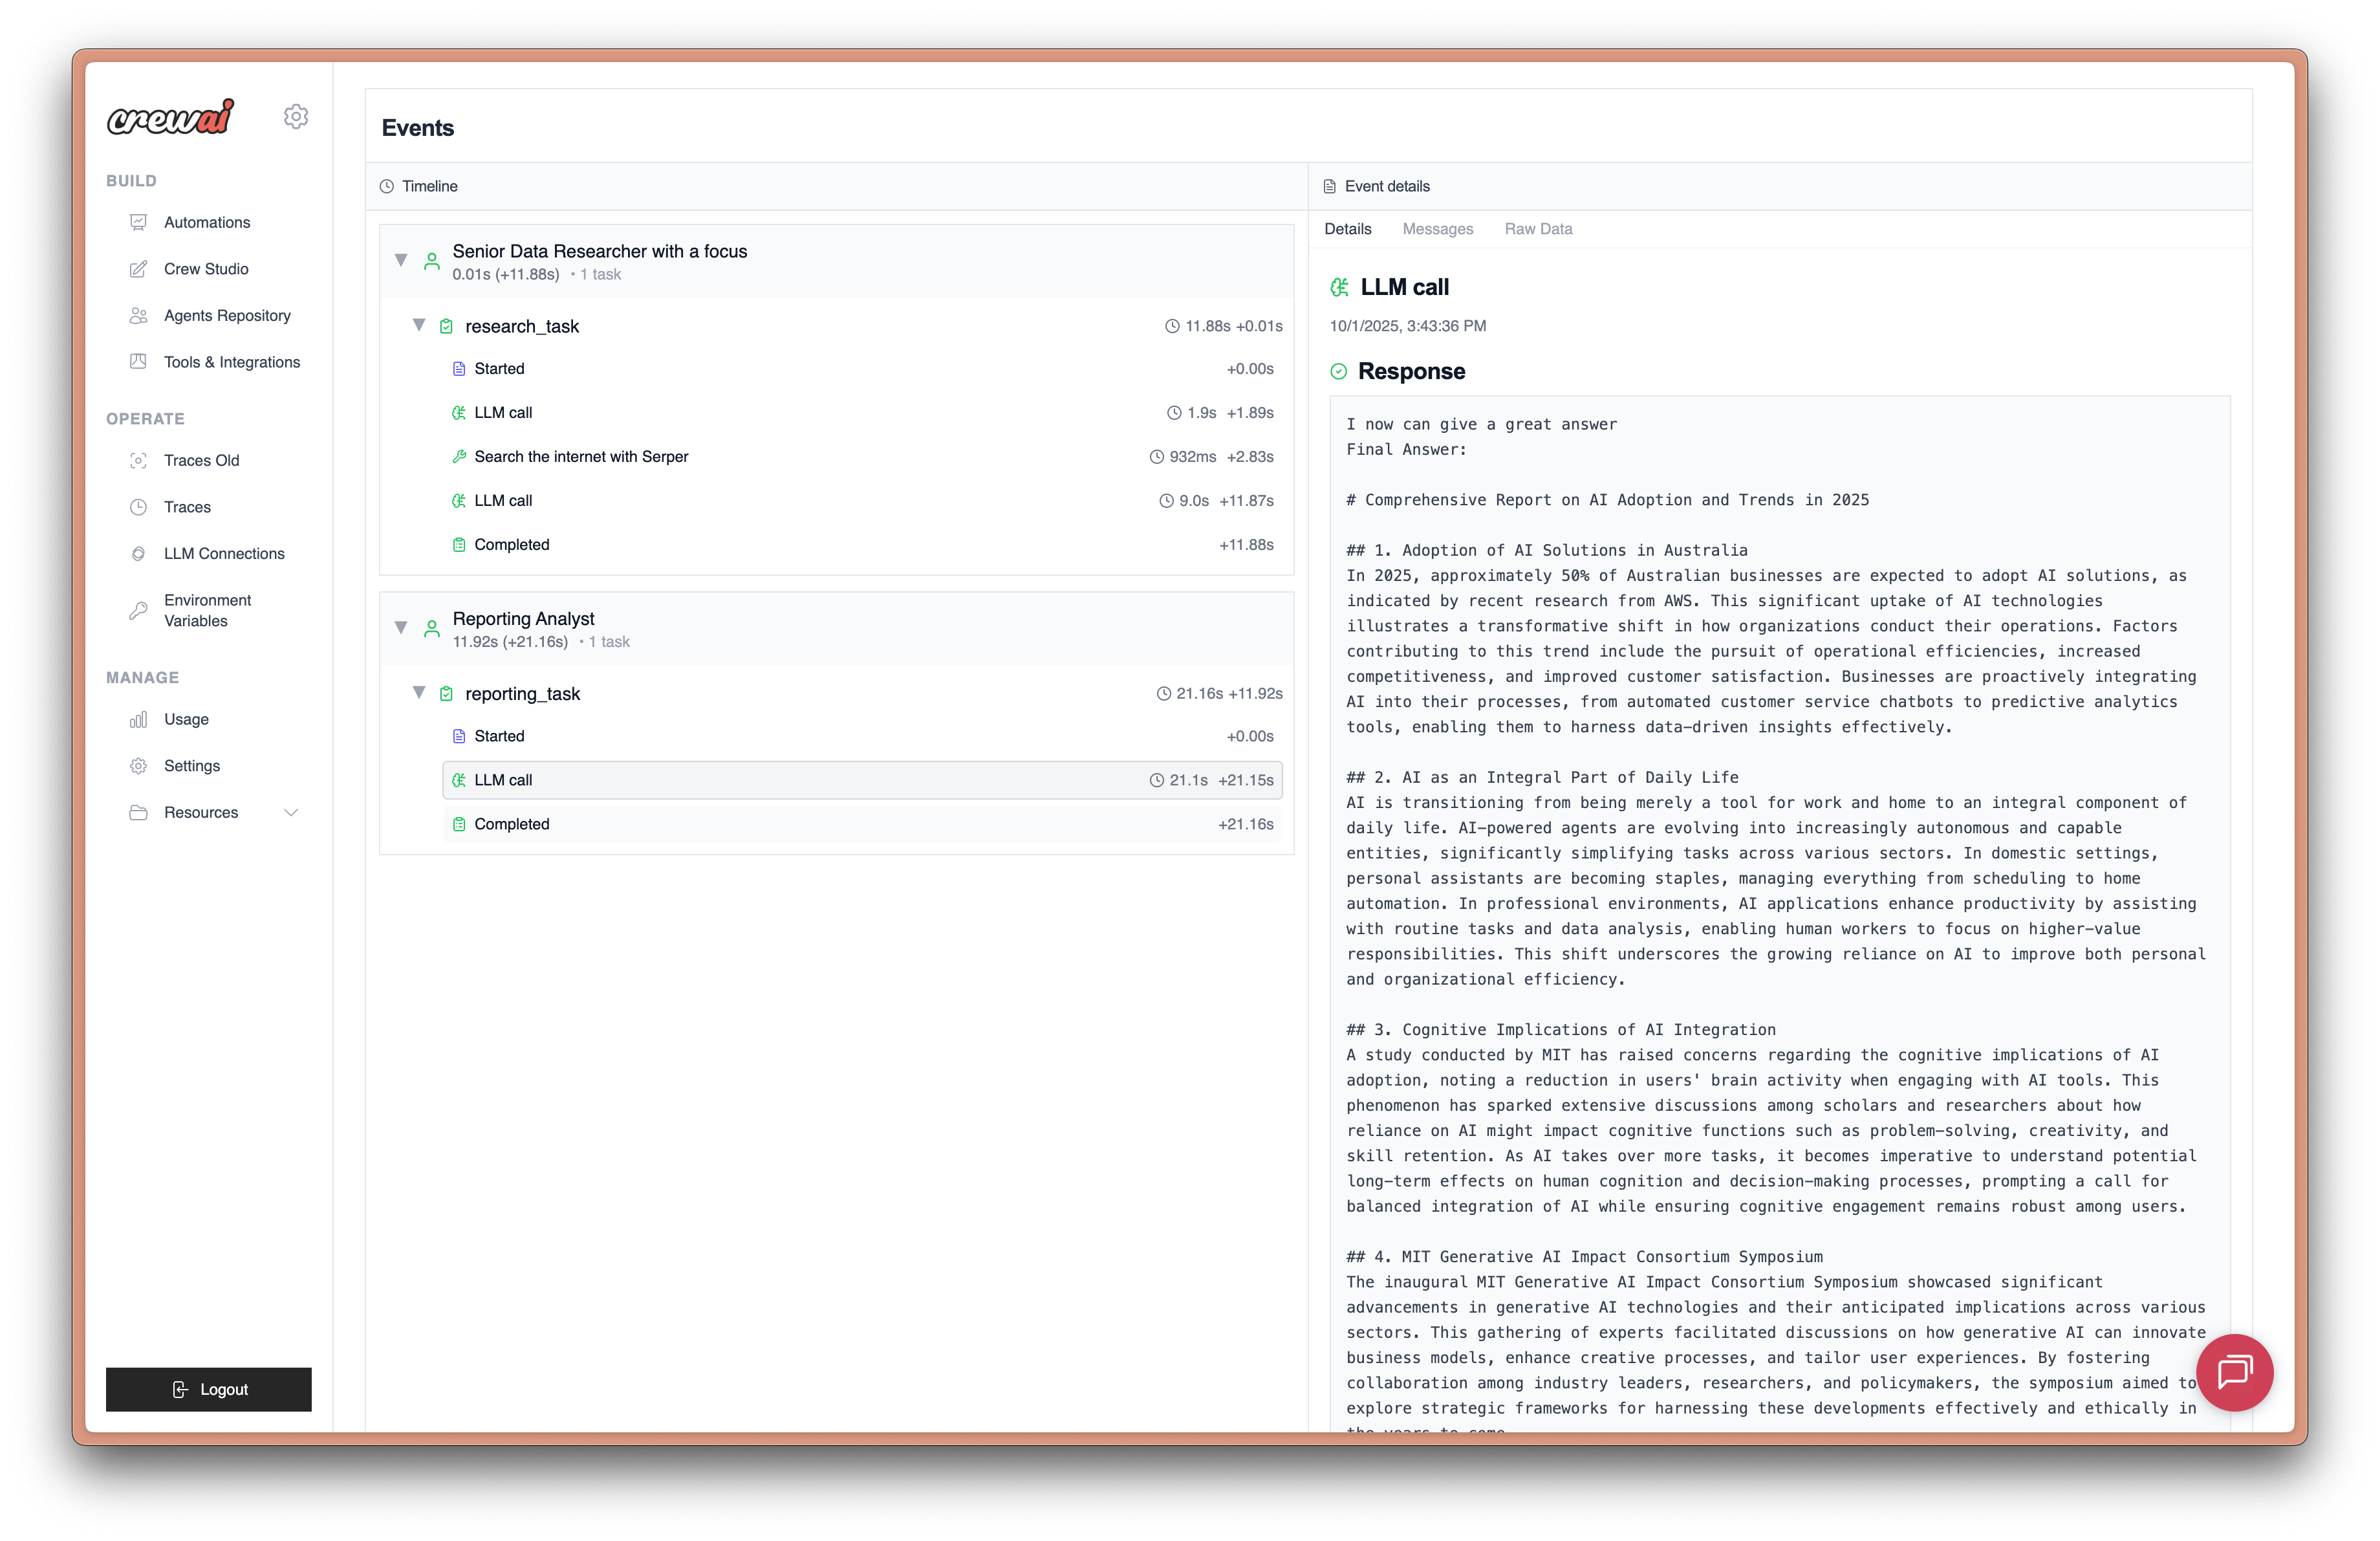
什么是 CrewAI 追踪? CrewAI 的内置追踪为你的 AI 智能体提供全面的可观测性,包括智能体决策、任务执行时间线、工具使用和 LLM 调用——所有这些都可通过 CrewAI AMP 平台访问。追踪的管理独立于遥测。
前置条件
在使用 CrewAI 追踪之前,你需要:
- CrewAI AMP 账户:在 app.crewai.com 注册免费账户
- CLI 身份认证:使用 CrewAI CLI 对本地环境进行身份认证
bash
crewai login设置说明
第 1 步:创建你的 CrewAI AMP 账户
访问 app.crewai.com 并创建免费账户。这将使你能够访问 CrewAI AMP 平台,在其中查看追踪、指标并管理你的团队。
第 2 步:安装 CrewAI CLI 并进行身份认证
如果你尚未安装,请使用 CLI 工具安装 CrewAI:
bash
uv add 'crewai[tools]'然后使用你的 CrewAI AMP 账户对 CLI 进行身份认证:
bash
crewai login此命令将:
- 打开浏览器进入身份认证页面
- 提示你输入设备代码
- 使用你的 CrewAI AMP 账户对本地环境进行身份认证
- 为你的本地开发启用追踪能力
第 3 步:在团队中启用追踪
你可以通过将 tracing 参数设置为 True 来为团队启用追踪:
python
from crewai import Agent, Crew, Process, Task
from crewai_tools import SerperDevTool

# Define your agents
researcher = Agent(
    role="Senior Research Analyst",
    goal="Uncover cutting-edge developments in AI and data science",
    backstory="""You work at a leading tech think tank.
    Your expertise lies in identifying emerging trends.
    You have a knack for dissecting complex data and presenting actionable insights.""",
    verbose=True,
    tools=[SerperDevTool()],
)

writer = Agent(
    role="Tech Content Strategist",
    goal="Craft compelling content on tech advancements",
    backstory="""You are a renowned Content Strategist, known for your insightful and engaging articles.
    You transform complex concepts into compelling narratives.""",
    verbose=True,
)

# Create tasks for your agents
research_task = Task(
    description="""Conduct a comprehensive analysis of the latest advancements in AI in 2024.
    Identify key trends, breakthrough technologies, and potential industry impacts.""",
    expected_output="Full analysis report in bullet points",
    agent=researcher,
)

writing_task = Task(
    description="""Using the insights provided, develop an engaging blog
    post that highlights the most significant AI advancements.
    Your post should be informative yet accessible, catering to a tech-savvy audience.""",
    expected_output="Full blog post of at least 4 paragraphs",
    agent=writer,
)

# Enable tracing in your crew
crew = Crew(
    agents=[researcher, writer],
    tasks=[research_task, writing_task],
    process=Process.sequential,
    tracing=True,  # Enable built-in tracing
    verbose=True
)

# Execute your crew
result = crew.kickoff()第 4 步:在流程中启用追踪
同样,你可以为 CrewAI 流程启用追踪:
python
from crewai.flow.flow import Flow, listen, start
from pydantic import BaseModel

class ExampleState(BaseModel):
    counter: int = 0
    message: str = ""

class ExampleFlow(Flow[ExampleState]):
    def __init__(self):
        super().__init__(tracing=True)  # Enable tracing for the flow

    @start()
    def first_method(self):
        print("Starting the flow")
        self.state.counter = 1
        self.state.message = "Flow started"
        return "continue"

    @listen("continue")
    def second_method(self):
        print("Continuing the flow")
        self.state.counter += 1
        self.state.message = "Flow continued"
        return "finish"

    @listen("finish")
    def final_method(self):
        print("Finishing the flow")
        self.state.counter += 1
        self.state.message = "Flow completed"

# Create and run the flow with tracing enabled
flow = ExampleFlow(tracing=True)
result = flow.kickoff()第 5 步:在 CrewAI AMP 仪表板中查看追踪
只有在身份认证导出成功或匿名上传被明确批准后,追踪才会被上传。本地缓冲区被丢弃的运行不会上传追踪。 对于与你的账户关联的追踪,请打开 CrewAI AMP 仪表板中的 Traces 标签页 以查看智能体交互、工具使用和 LLM 调用。

替代方案:环境变量配置
你还可以通过设置环境变量在全局启用追踪:
bash
export CREWAI_TRACING_ENABLED=true或将其添加到你的 .env 文件中:
env
CREWAI_TRACING_ENABLED=true设置此环境变量后,所有团队和流程都将自动启用追踪,即使没有显式设置 tracing=True。
首次运行后查看追踪
首次运行团队或流程时,交互式终端可能会询问:
text
Share this execution trace with CrewAI? [y/N]选择 yes 将缓冲的追踪上传到 CrewAI。追踪可能包含 提示词、输入和输出。拒绝、超时或在没有 交互式同意提示的情况下运行会丢弃缓冲区。你可以稍后更改追踪 使用 crewai traces enable 或 crewai traces disable,或通过设置 tracing 在团队或流程上。
本地缓冲与身份认证导出
首次运行的追踪收集会保留在进程内存中,直到你同意共享, 即使你已保存登录凭据。未身份认证的追踪使用相同的 同意流程。在同意之前,CrewAI 不请求上传授权,也不发送 执行跨度。
缓冲区最多保留 1,000 个跨度 和 8 MiB 的编码 OTLP 数据。 将 CREWAI_EPHEMERAL_TRACE_MAX_SPANS 和 CREWAI_EPHEMERAL_TRACE_MAX_BYTES 设置为正整数以调整这些限制。 溢出时会丢弃最旧的跨度;大于字节限制的跨度会被丢弃。 共享或丢弃缓冲区后,缓冲区会被清空。
当追踪已启用且凭据可用时,CrewAI 会将你的 CLI 登录、CREWAI_USER_PAT 或平台集成凭据与 AMP 交换为 一个特定于执行的授权。然后它会使用该授权将 OpenTelemetry 跨度直接导出到 Wharf。无效凭据不会回退到匿名上传。
托管执行会话
宿主可以使用来自 crewai.telemetry.tracing 的 telemetry_session 来包装执行。该会话使用 CrewAI 生命周期事件来创建 和结束跨度,保留其时间戳、父子关系和 HITL 暂停/恢复链接。传入一个现有提供程序(使用 providers=)以保留 宿主的 tracer 和日志集成。传入跨度处理器(使用 processors=) 以及宿主日志回调(使用 log_emitter=)。宿主负责这些集成中的任何 脱敏处理。 每个会话拥有自己的追踪生命周期,并使应用程序的全局 OpenTelemetry 提供程序保持不变。
查看你的追踪
访问 CrewAI AMP 仪表板
- 访问 app.crewai.com 并登录你的账户
- 导航到你的项目仪表板
- 点击 Traces 标签页以查看执行详情
你将在追踪中看到什么
CrewAI 追踪提供对以下内容的全面可见性:
- 智能体决策:查看智能体如何通过任务进行推理并做出决策
- 任务执行时间线:任务序列和依赖关系的可视化表示
- 工具使用:监控调用了哪些工具及其结果
- LLM 调用:跟踪所有语言模型交互,包括提示词和响应
- 性能指标:执行时间、token 用量和成本
- 错误跟踪:详细的错误信息和堆栈追踪
追踪功能
- 执行时间线:点击浏览不同执行阶段
- 详细日志:访问全面的日志以进行调试
- 性能分析:分析执行模式并优化性能
- 导出能力:下载追踪以进行进一步分析
身份认证问题
如果你遇到身份认证问题:
- 确保你已登录:
crewai login - 检查你的互联网连接
- 在 app.crewai.com 验证你的账户
追踪未显示
如果追踪未显示在仪表板中:
- 确认你的团队/流程中已设置
tracing=True - 如果使用环境变量,请检查
CREWAI_TRACING_ENABLED=true - 对于身份认证导出,请验证你的 CLI 登录、
CREWAI_USER_PAT或平台集成凭据。对于匿名共享,请明确批准同意提示;无需登录 - 验证你的团队/流程已执行且追踪导出成功。拒绝同意、超时或在没有交互式同意提示的情况下运行会丢弃本地缓冲区而不会上传