
主题
战略性 LLM 选择指南
为你的 CrewAI 智能体选择合适的 LLM,并编写有效的任务与智能体定义的战略框架
CrewAI 的 LLM 选择方法
我们并不推荐规定性的模型,而是倡导一种思考框架,帮助你根据具体用例、约束和要求做出明智的决策。LLM 领域发展迅速,新模型不断涌现,现有模型也频繁更新。最重要的是建立一套系统化的评估方法,无论当下有哪些具体模型可用,这套方法都依然适用。
NOTE
本指南侧重于战略思考,而非具体的模型 推荐,因为 LLM 领域发展迅速。
快速决策框架
Analyze Your Tasks
首先深入理解你的任务实际需要什么。考虑其中涉及的 认知复杂度、所需的推理深度、预期输出的格式,以及 模型需要处理的上下文规模。 这一基础分析将指引后续的每一个决策。
Map Model Capabilities
一旦你理解了自己的需求,就将它们映射到模型的强项上。 不同的模型家族擅长不同类型的工作;有些 针对推理和分析进行了优化,有些擅长创造力和内容 生成,还有一些则在速度与效率上更胜一筹。
Consider Constraints
将现实世界的运营约束纳入考量,包括预算 限制、延迟要求、数据隐私需求以及基础设施 能力。理论上最好的模型未必是 你当前处境下实际最优的选择。
Test and Iterate
从可靠、已被充分理解的模型入手,再根据在你的具体用例中的实际 表现进行优化。真实世界的结果往往与 理论基准不同,因此实证测试至关重要。
核心选择框架
a. 任务优先思维
LLM 选择中最关键的一步是理解你的任务实际需要什么。团队常常根据 总体口碑或基准分数来选择模型,而没有仔细分析自己的具体需求。这种做法 要么导致用昂贵、复杂的模型对简单任务过度设计,要么用能力不足的 模型去支撑复杂工作,导致性能不够。
简单任务 代表了日常 AI 工作的大部分,包括基础的指令遵循、直接的数据处理和简单的格式化操作。这类任务通常输入输出明确、歧义极小。认知负荷低,模型主要需要遵循明确的指令,而无需进行复杂的推理。
复杂任务 需要多步推理、策略性思考以及处理模糊或不完整信息的能力。这类任务可能涉及分析多个数据源、制定全面的策略,或解决需要拆解为更小组成部分的问题。模型需要在多个推理步骤之间保持上下文,并且常常必须做出未明确说明的推断。
创意任务 要求另一种类型的认知能力,聚焦于生成新颖、有吸引力且贴合语境的内容。这包括故事创作、营销文案撰写和创造性地解决问题。模型需要理解细微差别、语气和受众,同时产出真实而有吸引力、而非公式化的内容。
b. 模型能力映射
理解模型能力需要超越营销宣传和基准分数,深入理解不同模型架构与训练方法的根本优势与局限。
推理模型
推理模型代表一个专门的类别,专为复杂的多步思考任务而设计。当问题需要细致分析、策略性规划或系统性的问题拆解时,这类模型表现最佳。它们通常采用思维链推理或思维树处理等技术,逐步推演复杂问题。
推理模型的优势在于能够在长推理链中保持逻辑一致性,并将复杂问题拆解为可管理的组成部分。它们在策略规划、复杂分析以及推理质量比响应速度更重要的场景中尤为有价值。
不过,推理模型往往在速度和成本上有所取舍。对于创意任务或无需其复杂推理能力的简单操作,它们可能不太适用。当你的任务确实复杂、并能受益于系统化的逐步分析时,再考虑这些模型。
通用模型
通用模型在 LLM 选型中提供了最均衡的方案,在广泛的任务范围内都有稳健表现,且不在任何特定领域做极端特化。这些模型基于多样化的数据集训练,针对通用性而非特定领域的峰值性能进行优化。
通用模型的首要优势在于其在各类工作中的可靠性与可预测性。它们能胜任大多数标准业务任务,从研究与分析到内容创作和数据处理。这使它们成为需要在多种工作流中保持一致表现的团队的理想选择。
尽管通用模型在特定领域可能无法达到专用替代方案的峰值性能,但它们提供了运维上的简洁性和更低的模型管理复杂度。对于新项目而言,它们往往是最好的起点,让团队能够先理解自身的具体需求,再考虑用更专用的模型进行优化。
快速高效模型
快速高效模型优先考虑速度、成本效益和资源效率,而非复杂的推理能力。这些模型针对高吞吐场景进行了优化,在这些场景中,快速响应和低运营成本比细致入微的理解或复杂推理更重要。
这些模型在涉及例行操作、简单数据处理、函数调用以及认知要求相对直接的高量任务等场景中表现出色。对于需要快速处理大量请求或在紧张预算约束下运行的应用,它们尤其有价值。
使用高效模型的关键考量是确保其能力与你的任务需求相匹配。虽然它们能有效处理许多例行操作,但在需要细致理解、复杂推理或复杂内容生成的任务上可能力有不逮。它们最适合用于定义明确、例行性的操作,在这些场景中速度与成本比复杂精巧更重要。
创意模型
创意模型专门针对内容生成、写作质量和创造性思维任务进行了优化。这些模型通常擅长理解细微差别、语气和风格,同时产出自然真实、贴合语境且有吸引力的内容。
创意模型的优势在于能够针对不同受众调整写作风格、保持一致的语调和语气,并生成能有效吸引读者的内容。它们在故事创作、营销文案、品牌传播以及其他以创意和吸引力为首要目标的内容任务上往往表现更好。
选择创意模型时,不仅要考虑其生成文本的能力,还要考虑其对受众、语境和目的的理解。最好的创意模型能够调整其输出以匹配特定品牌调性、面向不同受众群体,并在长篇内容中保持一致。
开源模型
开源模型在成本控制、定制潜力、数据隐私和部署灵活性方面具有独特优势。这些模型可以在本地或私有基础设施上运行,从而对数据处理和模型行为拥有完全控制权。
开源模型的主要好处包括免除按 token 计费的成本、可针对特定用例进行微调、完整的数据隐私,以及不依赖外部 API 服务商。对于有严格数据隐私要求、预算约束或特定定制需求的组织,它们尤其有价值。
不过,开源模型需要更多技术专长才能有效部署和维护。团队需要考虑基础设施成本、模型管理复杂度,以及持续保持模型更新和优化所需的投入。把技术开销计算在内,总拥有成本可能高于基于云的替代方案。
战略性配置模式
a. 多模型方案
TIP
在同一个团队内针对不同用途使用不同的模型,以同时优化性能与成本。
最成熟的 CrewAI 实现往往会策略性地使用多个模型,根据各智能体的具体角色和需求为其分配不同的模型。这种方式让团队能够为每类工作选用最合适的模型,从而同时优化性能与成本。
规划智能体受益于能够处理复杂策略性思考和多步分析的推理模型。这些智能体常常充当整个运作的“大脑”,制定策略并协调其他智能体的工作。而内容智能体则最适合使用在写作质量和受众吸引力方面表现出色的创意模型。处理例行操作的处理型智能体可以使用优先考虑速度和成本效益的高效模型。
示例:研究与分析团队
python
from crewai import Agent, Task, Crew, LLM

# High-capability reasoning model for strategic planning
manager_llm = LLM(model="gemini/gemini-3.7-flash", temperature=0.1)

# Creative model for content generation
content_llm = LLM(model="claude-3-5-sonnet-20241022", temperature=0.7)

# Efficient model for data processing
processing_llm = LLM(model="gpt-4o-mini", temperature=0)

research_manager = Agent(
    role="Research Strategy Manager",
    goal="Develop comprehensive research strategies and coordinate team efforts",
    backstory="Expert research strategist with deep analytical capabilities",
    llm=manager_llm,  # High-capability model for complex reasoning
    verbose=True
)

content_writer = Agent(
    role="Research Content Writer",
    goal="Transform research findings into compelling, well-structured reports",
    backstory="Skilled writer who excels at making complex topics accessible",
    llm=content_llm,  # Creative model for engaging content
    verbose=True
)

data_processor = Agent(
    role="Data Analysis Specialist",
    goal="Extract and organize key data points from research sources",
    backstory="Detail-oriented analyst focused on accuracy and efficiency",
    llm=processing_llm,  # Fast, cost-effective model for routine tasks
    verbose=True
)

crew = Crew(
    agents=[research_manager, content_writer, data_processor],
    tasks=[...],  # Your specific tasks
    manager_llm=manager_llm,  # Manager uses the reasoning model
    verbose=True
)成功实施多模型方案的关键在于理解不同智能体之间如何交互,并确保模型能力与智能体职责相匹配。这需要周密的规划,但可以显著提升输出质量和运营效率。
b. 按组件选择
manager LLM 在层级式 CrewAI 流程中扮演关键角色,是多个智能体和任务的协调中枢。该模型需要擅长委派、任务优先级排序,以及在多个并发操作中维持上下文。
高效的 manager LLM 需要具备强大的推理能力以做出良好的委派决策,需要稳定的表现以确保可预测的协调,还需要出色的上下文管理能力以同时追踪多个智能体的状态。模型需要理解不同智能体的能力与局限,同时优化任务分配以兼顾效率与质量。
成本考量对 manager LLM 尤为重要,因为它们参与每一项操作。模型需要在提供足够能力以实现有效协调的同时,保持频繁使用下的成本效益。这通常意味着要找到既具备良好推理能力、又不必支付最复杂模型高昂价格的模型。
任务定义框架
a. 清晰优先于复杂
在决定 CrewAI 输出质量方面,有效的任务定义往往比模型选择更重要。定义良好的任务提供清晰的方向和上下文,使普通模型也能表现良好;而定义糟糕的任务则可能让再精密的模型也产出不尽人意的结果。
有效的任务描述
最好的任务描述在提供足够细节与保持清晰之间取得平衡。它们应清晰定义具体目标,使成功的样貌毫无歧义,同时足够详细地说明方法或流程,让智能体明白如何推进。
有效的任务描述包含相关上下文和约束,帮助智能体理解更广泛的目的以及必须遵守的限制。它们把复杂工作拆解为可系统性执行的聚焦步骤,而不是给出难以系统着手的、令人生畏的多面目标。
常见错误包括目标过于模糊、未能提供必要上下文、设定不清晰的成功标准,或把多个不相关的任务合并到单一描述中。目标是提供足够信息让智能体成功,同时保持对单一清晰目标的聚焦。
预期输出准则
预期输出准则充当任务定义与智能体之间的契约,明确说明交付物应当是什么样,以及将如何被评估。这些准则应描述所需的格式和结构,以及输出被视为完整所必须包含的关键要素。
最好的输出准则会提供质量指标的具体示例,并清晰定义完成标准,使智能体和人工审核者都能评估任务是否已成功完成。这减少了歧义,并有助于在多次任务执行中保持一致的结果。
应避免可套用于任何任务的笼统输出描述、缺失格式规范以致智能体对结构只能猜测、质量标准不清晰导致评估困难,或未能提供示例或模板以帮助智能体理解预期。
b. 任务排序策略
当任务建立在前序输出之上、信息从一项任务流向另一项任务,或质量取决于前置工作的完成时,顺序任务依赖至关重要。这种方式确保每项任务都能获得成功所需的信息和上下文。
要有效实现顺序依赖,需要使用 context 参数把相关任务串联起来,通过任务推进逐步提升复杂度,并确保每项任务产出的输出能作为后续任务的有意义输入。目标是在依赖任务之间保持逻辑流,同时避免不必要的瓶颈。
当任务之间存在清晰的逻辑推进,且一项任务的输出确实能提升后续任务的质量或可行性时,顺序依赖效果最佳。不过,如果管理不当,它也可能造成瓶颈,因此重要的是区分哪些依赖真正必要,哪些只是图方便。
为提升 LLM 性能优化智能体配置
a. 由角色驱动的 LLM 选择
WARNING
泛泛的智能体角色使选择正确的 LLM 变得不可能。具体的角色才能 实现有针对性的模型优化。
智能体角色的具体程度,直接决定哪些 LLM 能力对达到最佳性能最为关键。这创造了一个战略性机会:把模型的精确优势与智能体职责相匹配。
通用角色与具体角色对 LLM 选择的影响:
在定义角色时,思考哪些特定领域知识、工作风格和决策框架对智能体将要处理的任务最有价值。角色定义越具体、越贴合情境,模型就越能有效地扮演该角色。
python
# ✅ Specific role - clear LLM requirements
specific_agent = Agent(
    role="SaaS Revenue Operations Analyst",  # Clear domain expertise needed
    goal="Analyze recurring revenue metrics and identify growth opportunities",
    backstory="Specialist in SaaS business models with deep understanding of ARR, churn, and expansion revenue",
    llm=LLM(model="gpt-4o")  # Reasoning model justified for complex analysis
)角色到模型的映射策略:
- "研究分析师" → 推理模型(GPT-4o、Claude Sonnet),用于复杂分析
- "内容编辑" → 创意模型(Claude、GPT-4o),保障写作质量
- "数据处理员" → 高效模型(GPT-4o-mini、Gemini Flash),用于结构化任务
- "API 协调员" → 函数调用优化模型(GPT-4o、Claude),用于工具使用
b. 将背景故事作为模型上下文的放大器
INFO
有策略的背景故事能提供通用提示词无法实现的领域特定上下文,从而 成倍放大你所选 LLM 的效果。
精心撰写的背景故事能把你的 LLM 选择从通用能力转变为专业专长。这对成本优化尤为关键——一个拥有良好上下文的普通模型,可能胜过缺乏恰当上下文的高端模型。
上下文驱动的性能示例:
python
# Context amplifies model effectiveness
domain_expert = Agent(
    role="B2B SaaS Marketing Strategist",
    goal="Develop comprehensive go-to-market strategies for enterprise software",
    backstory="""
    You have 10+ years of experience scaling B2B SaaS companies from Series A to IPO.
    You understand the nuances of enterprise sales cycles, the importance of product-market
    fit in different verticals, and how to balance growth metrics with unit economics.
    You've worked with companies like Salesforce, HubSpot, and emerging unicorns, giving
    you perspective on both established and disruptive go-to-market strategies.
    """,
    llm=LLM(model="claude-3-5-sonnet", temperature=0.3)  # Balanced creativity with domain knowledge
)

# This context enables Claude to perform like a domain expert
# Without it, even it would produce generic marketing advice可提升 LLM 性能的背景故事要素:
- 领域经验:"10 年以上企业级 SaaS 销售经验"
- 特定专长:"专精于 B 轮及以后融资的技术尽职调查"
- 工作风格:"偏好数据驱动的决策,并留下清晰的文档记录"
- 质量标准:"坚持引用来源并展示分析过程"
c. 智能体与 LLM 的整体优化
最有效的智能体配置会在角色具体度、背景故事深度和 LLM 选择之间形成协同。每个要素都强化其他要素,从而最大化模型性能。
优化框架:
python
# Example: Technical Documentation Agent
tech_writer = Agent(
    role="API Documentation Specialist",  # Specific role for clear LLM requirements
    goal="Create comprehensive, developer-friendly API documentation",
    backstory="""
    You're a technical writer with 8+ years documenting REST APIs, GraphQL endpoints,
    and SDK integration guides. You've worked with developer tools companies and
    understand what developers need: clear examples, comprehensive error handling,
    and practical use cases. You prioritize accuracy and usability over marketing fluff.
    """,
    llm=LLM(
        model="claude-3-5-sonnet",  # Excellent for technical writing
        temperature=0.1  # Low temperature for accuracy
    ),
    tools=[code_analyzer_tool, api_scanner_tool],
    verbose=True
)对齐检查清单:
- ✅ 角色具体度:清晰的领域与职责
- ✅ LLM 匹配:模型优势与角色要求相符
- ✅ 背景故事深度:提供 LLM 可利用的领域上下文
- ✅ 工具集成:工具支撑智能体的专业化职能
- ✅ 参数调优:温度与各项设置针对角色需求优化
关键在于打造这样的智能体:每一项配置选择都强化你的 LLM 选择策略,在优化成本的同时最大化性能。
实践实施检查清单
与其重复战略框架,这里提供一份在 CrewAI 中落实 LLM 选择决策的战术清单:
Audit Your Current Setup
需要审查的内容:
- 所有智能体默认是否都使用同一个 LLM?
- 哪些智能体承担最复杂的推理任务?
- 哪些智能体主要从事数据处理或格式整理?
- 是否有智能体高度依赖工具?
行动:记录当前的智能体角色,并识别优化机会。
Implement Crew-Level Strategy
设定基线:
python
# Start with a reliable default for the crew
default_crew_llm = LLM(model="gpt-4o-mini")  # Cost-effective baseline

crew = Crew(
    agents=[...],
    tasks=[...],
    memory=True
)行动:在优化单个智能体之前,先确立团队的默认 LLM。
Optimize High-Impact Agents
识别并升级关键智能体:
python
# Manager or coordination agents
manager_agent = Agent(
    role="Project Manager",
    llm=LLM(model="gemini/gemini-3.7-flash"),  # Premium for coordination
    # ... rest of config
)

# Creative or customer-facing agents
content_agent = Agent(
    role="Content Creator",
    llm=LLM(model="claude-3-5-sonnet"),  # Best for writing
    # ... rest of config
)行动:升级承担 80% 复杂度的那 20% 智能体。
Validate with Enterprise Testing
一旦把智能体部署到生产环境:
- 使用 CrewAI AMP platform 对你的模型选择进行 A/B 测试
- 用真实输入运行多轮迭代,衡量一致性与性能
- 在优化后的配置下比较成本与性能
- 与团队共享结果,协同决策
行动:借助测试平台,用数据驱动的验证取代猜测。
何时使用不同的模型类型
当任务需要真正的多步逻辑思考、战略规划或能从系统化分析中获益的高层决策时,推理模型就变得不可或缺。当问题需要被拆解为多个组成部分并加以系统分析,而不是依靠模式匹配或简单的指令遵循来处理时,这类模型表现尤为出色。
在业务战略制定、需要从多个来源提炼洞察的复杂数据分析、每一步都依赖前一步分析的多步问题求解,以及需要考虑多个变量及其相互作用关系的战略规划任务中,都可以考虑使用推理模型。
不过,推理模型通常成本更高、响应更慢,因此最好将它们留给那些能真正发挥其高级能力的任务,而不是用于无需复杂推理的简单操作。
CrewAI 模型选择的常见陷阱
“一个模型包打天下”的陷阱
问题所在:在团队中为所有智能体使用同一个 LLM,而不考虑它们各自特定的角色和职责。这往往是默认做法,但很少是最优解。
真实示例:为战略规划经理和数据提取智能体都使用 GPT-4o。经理需要值得付出高额成本的推理能力,但数据提取器用 GPT-4o-mini 也能表现得同样出色,而价格只是前者的一小部分。
CrewAI 解决方案:利用针对单个智能体的 LLM 配置,让模型能力与智能体角色相匹配:
python
# Strategic agent gets premium model
manager = Agent(role="Strategy Manager", llm=LLM(model="gpt-4o"))

# Processing agent gets efficient model
processor = Agent(role="Data Processor", llm=LLM(model="gpt-4o-mini"))忽视团队级与智能体级 LLM 层级关系
问题所在:不了解 CrewAI 的 LLM 层级机制如何运作——团队 LLM、经理 LLM 和智能体 LLM 的设置可能会相互冲突或协调不当。
真实示例:将团队设置为使用 Claude,但智能体却配置为 GPT 模型,导致行为不一致以及不必要的模型切换开销。
CrewAI 解决方案:有策略地规划你的 LLM 层级:
python
crew = Crew(
    agents=[agent1, agent2],
    tasks=[task1, task2],
    manager_llm=LLM(model="gpt-4o"),  # For crew coordination
    process=Process.hierarchical  # When using manager_llm
)

# Agents inherit crew LLM unless specifically overridden
agent1 = Agent(llm=LLM(model="claude-3-5-sonnet")) # Override for specific needs函数调用模型不匹配
问题所在:仅依据通用能力选择模型,而忽视了工具使用密集的 CrewAI 工作流对函数调用性能的要求。
真实示例:为一个主要需要调用 API、搜索工具或处理结构化数据的智能体选择了偏重创意的模型。结果该智能体在工具参数提取和可靠的函数调用上表现吃力。
CrewAI 解决方案:对于工具使用密集的智能体,优先考虑函数调用能力:
python
# For agents that use many tools
tool_agent = Agent(
    role="API Integration Specialist",
    tools=[search_tool, api_tool, data_tool],
    llm=LLM(model="gpt-4o"),  # Excellent function calling
    # OR
    llm=LLM(model="claude-3-5-sonnet")  # Also strong with tools
)未经测试的过早优化
问题所在:仅凭理论性能就做出复杂的模型选择决策,而没有用实际的 CrewAI 工作流和任务进行验证。
真实示例:基于任务类型实现了精细的模型切换逻辑,却没有测试性能提升是否值得这样的运维复杂度。
CrewAI 解决方案:从简单开始,再基于真实性能数据进行优化:
python
# Start with this
crew = Crew(agents=[...], tasks=[...], llm=LLM(model="gpt-4o-mini"))

# Test performance, then optimize specific agents as needed
# Use Enterprise platform testing to validate improvements忽视上下文与记忆限制
问题所在:没有考虑模型上下文窗口与 CrewAI 的记忆机制以及智能体之间上下文共享之间的相互作用。
真实示例:为需要在多次任务迭代中保持对话历史的智能体使用短上下文模型,或者在智能体之间通信频繁的团队中使用这类模型。
CrewAI 解决方案:让上下文能力与团队通信模式相匹配。
测试与迭代策略
Start Simple
从广受理解、支持良好且可靠的通用模型开始。这为你在针对特定需求进行优化之前,提供了一个稳定的基础,用以理解自身具体的要求和性能预期。
Measure What Matters
制定与你的具体用例和业务需求相匹配的指标,而不是单纯依赖通用基准。重点关注衡量那些直接影响你成功与否的结果,而不是理论上的性能指标。
Iterate Based on Results
基于在你的具体场景中观察到的性能来调整模型,而不是依据理论考量或一般性建议。真实世界的性能往往与基准结果或普遍口碑存在显著差异。
Consider Total Cost
评估总拥有成本,包括模型成本、开发时间、维护开销和运维复杂度。综合考虑所有因素时,每 token 最便宜的模型未必是最具成本效益的选择。
TIP
先专注于理解你的需求,然后选择最契合这些需求的模型。最佳的 LLM 选择,是能够在你的运营约束内持续交付所需结果的那一个。
企业级模型验证
对于认真想要优化其 LLM 选型的团队,CrewAI AMP 平台提供了远超基础 CLI 测试的高级测试能力。该平台支持全面的模型评估,帮助你基于数据做出关于 LLM 策略的决策。
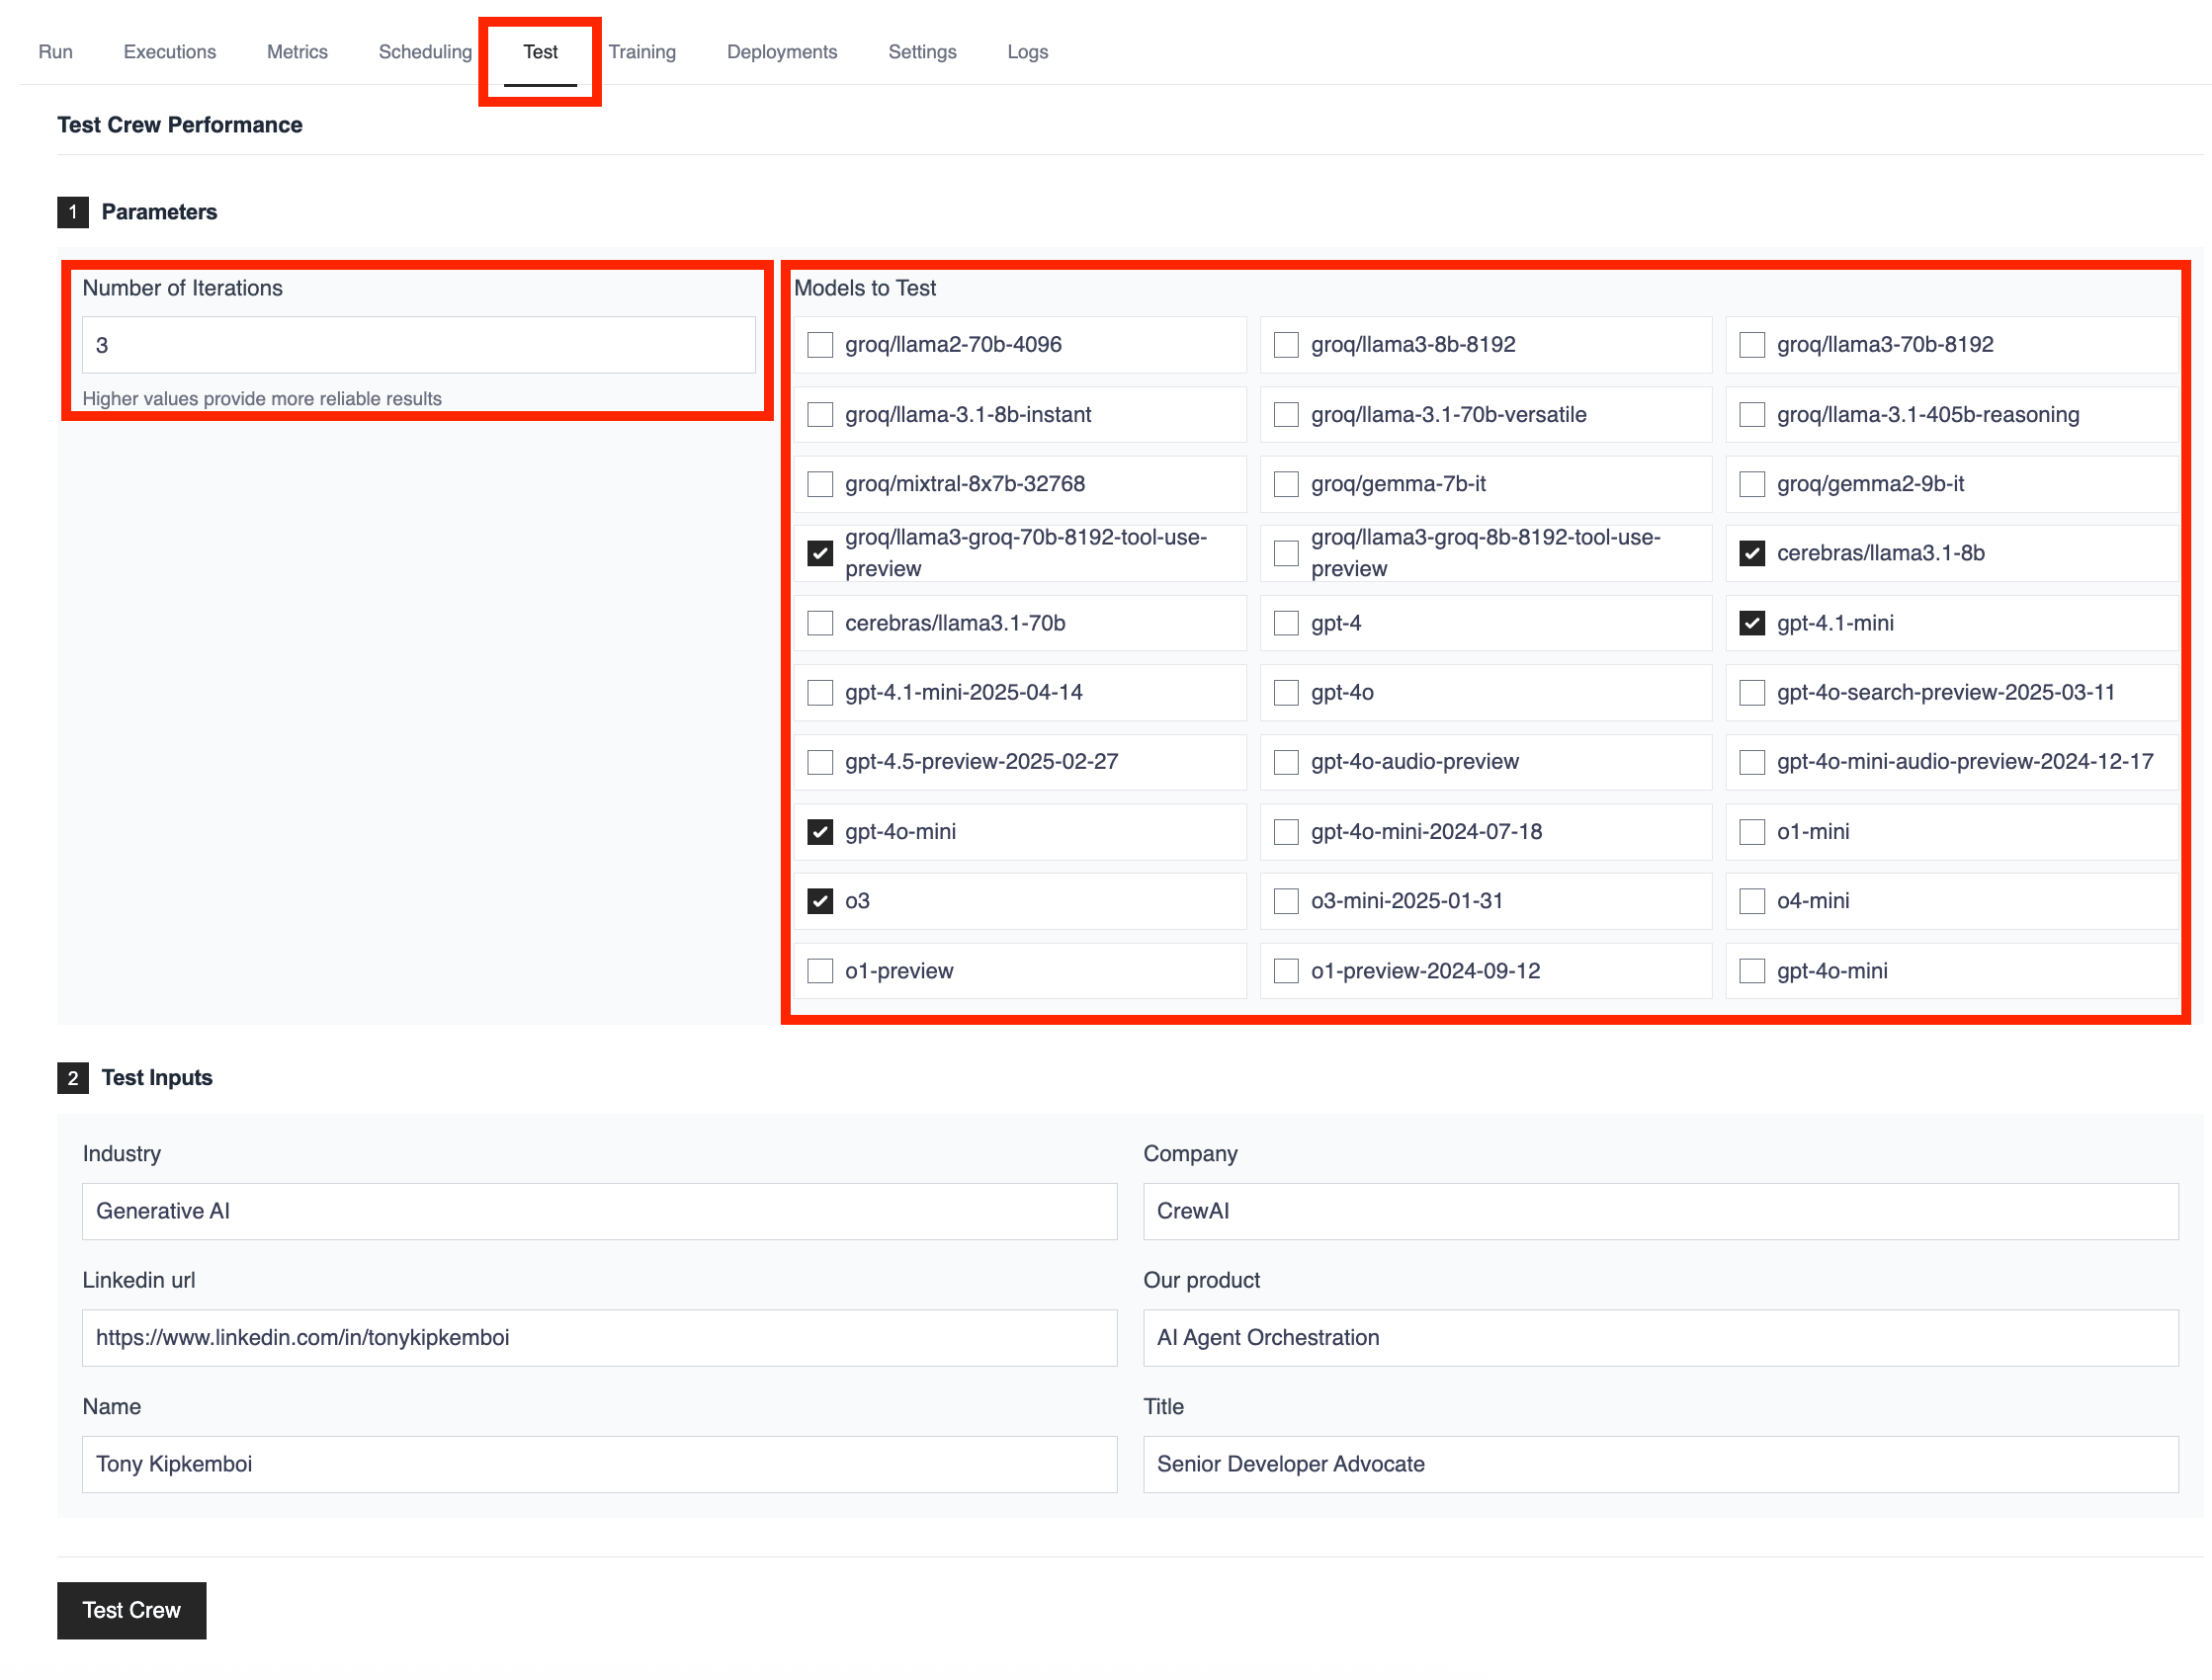
高级测试特性:
多模型对比:在相同的任务和输入上同时测试多个 LLM。并行比较 GPT-4o、Claude、Llama、Groq、Cerebras 及其他领先模型的表现,找出最契合你具体用例的选择。
统计严谨性:使用一致的输入配置多轮迭代,以衡量可靠性和性能波动。这有助于识别那些不仅表现良好、而且在多次运行中始终稳定的模型。
真实场景验证:使用你实际的团队输入和场景,而不是合成基准。该平台允许你用自己特定的行业背景、公司信息和真实用例进行测试,从而获得更准确的评估。
全面分析:获取所有被测模型的详细性能指标、执行时间和成本分析。这使你能够基于数据做出决策,而不是依赖模型的普遍口碑或理论能力。
团队协作:在团队内共享测试结果和模型性能数据,从而实现协作决策,并在各项目中保持一致的模型选择策略。
前往 app.crewai.com 开始使用!
INFO
企业版平台将模型选择从猜测转变为数据驱动的流程,使你能够用实际的用例和需求来验证本指南中的各项原则。
核心原则总结
Task-Driven Selection
根据任务实际所需来选择模型,而不是依据理论能力或普遍口碑。
Capability Matching
让模型优势与智能体的角色和职责相匹配,以获得最佳性能。
Strategic Consistency
在相关组件和工作流之间保持一致的模型选择策略。
Practical Testing
通过真实使用而非仅凭基准来验证选择。
Iterative Improvement
从简单开始,基于实际性能和需求进行优化。
Operational Balance
在性能要求与成本和复杂度约束之间取得平衡。
TIP
请记住:最佳的 LLM 选择,是能够在你的运营约束内持续交付所需结果的那一个。先专注于理解你的需求,然后选择最契合这些需求的模型。
当前模型格局(2025 年 6 月)
WARNING
时间快照:以下模型排名代表截至 2025 年 6 月的当前排行榜情况,汇总自 LMSys Arena、Artificial Analysis 及其他领先基准。LLM 的性能、可用性和定价变化迅速。请始终结合你自己的具体用例和数据开展评估。
各类别中的领先模型
下表展示了当前不同类别中表现顶尖模型的一个代表性样本,并就其是否适合 CrewAI 智能体给出了指导建议:
NOTE
这些表格/指标展示了各分类中精选的领先模型,并且 并非详尽无遗。此处列出的模型之外还存在许多优秀模型。目标是 说明应关注哪些类型的能力,而不是提供 完整目录。
最适合管理者 LLM 与复杂分析
| 模型 | 智能评分 | 成本 ($/M tokens) | 速度 | 在 CrewAI 中的最佳用途 |
|---|---|---|---|---|
| o3 | 70 | $17.50 | 快 | 用于复杂多智能体协调的管理者 LLM |
| Gemini 2.5 Pro | 69 | $3.44 | 快 | 战略规划智能体、研究协调 |
| DeepSeek R1 | 68 | $0.96 | 中等 | 面向预算敏感团队的高性价比推理 |
| Claude 4 Sonnet | 53 | $6.00 | 快 | 需要细致理解的分析智能体 |
| Qwen3 235B (Reasoning) | 62 | $2.63 | 中等 | 推理任务的开源替代方案 |
这些模型擅长多步推理,非常适合需要制定策略、协调其他智能体或分析复杂信息的智能体。
当前模型的选择框架
高性能团队
当性能是优先事项时:使用顶级模型,如 o3、Gemini 2.5 Pro 或 Claude 4 Sonnet,作为管理者 LLM 和关键智能体。这些模型擅长复杂推理与协调,但成本更高。
策略:实施多模型方案,让高级模型负责战略性思考,而高效模型负责日常操作。
成本敏感团队
当预算成为主要限制时:重点关注 DeepSeek R1、Llama 4 Scout 或 Gemini 2.0 Flash 等模型。它们以显著更低的成本提供强劲性能。
策略:对大多数智能体使用高性价比模型,仅将高级模型保留给最关键的决策角色。
专业工作流
针对特定领域专业知识:选择针对你的主要用例优化的模型。用于编程的 Claude 4 系列、用于研究的 Gemini 2.5 Pro、用于函数调用的 Llama 405B。
策略:根据团队的主要职能选择模型,确保核心能力与模型优势一致。
企业版与隐私
对于数据敏感型操作:考虑可本地部署且保持有竞争力性能的开源模型,如 Llama 4 系列、DeepSeek V3 或 Qwen3。
策略:在私有基础设施上部署开源模型,为数据控制接受潜在的性能取舍。
模型选择的关键考量
性能趋势:当前格局显示,以推理为重点的模型(o3、Gemini 2.5 Pro)与均衡模型(Claude 4、GPT-4.1)之间竞争激烈。像 DeepSeek R1 这样的专用模型提供出色的性价比。
速度与智能的取舍:像 Llama 4 Scout 这类模型优先考虑速度(2,600 tokens/s),同时保持合理的智能水平;而像 o3 这类模型则以速度和价格为代价来最大化推理能力。
开源可行性:开源模型与专有模型之间的差距持续缩小,像 Llama 4 Maverick 和 DeepSeek V3 这样的模型以有吸引力的价格提供有竞争力的性能。快速推理服务商与开源模型配合尤其出色,通常能提供比专有替代方案更好的速度成本比。
INFO
测试至关重要:排行榜排名提供一般性指导,但 你的具体用例、提示词风格和评估标准可能会产生 不同结果。在做出最终决定之前,始终用你的实际任务和 数据测试候选模型。
实践实施策略
Start with Proven Models
从 GPT-4.1、Claude 3.7 Sonnet 或 Gemini 2.0 Flash 等成熟模型开始,这些模型在多个维度上提供良好性能,并拥有广泛的真实世界验证。
Identify Specialized Needs
判断你的团队是否有特定需求(编程、推理、速度), 这些需求可能受益于专用模型,例如用于 开发的 Claude 4 Sonnet 或用于复杂分析的 o3。对于速度至关重要的应用, 在选型时考虑 Groq 等快速推理服务商。
Implement Multi-Model Strategy
根据角色为不同智能体使用不同模型。 高能力模型用于管理者和复杂任务,高效模型用于 日常操作。
Monitor and Optimize
跟踪与你的用例相关的性能指标,并准备好在新模型发布或定价变化时调整模型选择。