
主题
记忆概览
记忆是一个能够记住先前交互信息的系统。对 AI 智能体而言,记忆至关重要,因为它让智能体能够记住先前的交互、从反馈中学习,并适应用户偏好。随着智能体处理包含大量用户交互的越来越复杂的任务,这一能力对于效率和用户满意度都变得不可或缺。
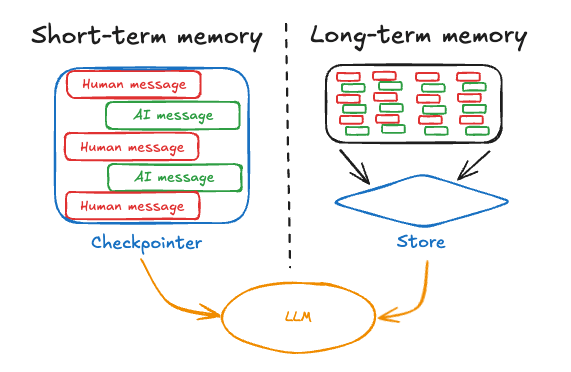
本概念指南根据回忆范围介绍两种类型的记忆:
- 短期记忆,或称线程作用域的记忆,通过在会话内维护消息历史来跟踪正在进行的对话。LangGraph 将短期记忆作为智能体状态的一部分来管理。状态通过检查点器持久化到数据库,因此线程可以在任何时候恢复。当图被调用或某个步骤完成时,短期记忆会更新,而状态会在每个步骤开始时被读取。
- 长期记忆跨会话存储用户专属或应用级别的数据,并在对话线程之间共享。它可以在任何时候、任何线程中被回忆。记忆的作用域可以是任何自定义命名空间,而不仅限于单个线程 ID。LangGraph 提供存储(参考文档),让你保存和回忆长期记忆。
短期记忆
短期记忆让应用能够记住单个线程或对话内的先前交互。线程在会话中组织多次交互,类似于电子邮件把消息归组到一个对话中的方式。
LangGraph 将短期记忆作为智能体状态的一部分进行管理,并通过线程作用域的检查点持久化。该状态通常可以包含对话历史以及其他有状态数据,例如上传的文件、检索到的文档或生成的产物。通过把这些内容存储在图的 state 中,机器人可以访问给定对话的完整上下文,同时保持不同线程之间的隔离。
管理短期记忆
对话历史是短期记忆最常见的形式,而长对话会给当今的 LLM 带来挑战。完整历史可能无法容纳进 LLM 的上下文窗口,从而导致不可恢复的错误。即使你的 LLM 支持完整的上下文长度,大多数 LLM 在长上下文上的表现依然很差。它们会被过时或跑题的内容"分散注意力",同时还伴随着更慢的响应时间和更高的成本。
聊天模型通过消息来接收上下文,这些消息包括开发者提供的指令(系统消息)和用户输入(人类消息)。在聊天应用中,消息在人类输入和模型响应之间交替出现,导致消息列表随时间变得越来越长。由于上下文窗口有限,而且 token 密集的消息列表成本高昂,许多应用都能从手动移除或遗忘过时信息的技术中获益。
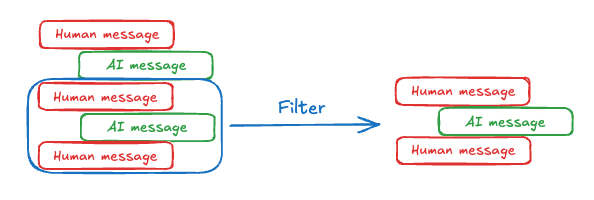
关于管理消息的常见技术的更多信息,请参阅添加与管理记忆指南。
长期记忆
LangGraph 中的长期记忆允许系统在不同对话或会话之间保留信息。与线程作用域的短期记忆不同,长期记忆保存在自定义的"命名空间"中。
长期记忆是一项复杂的挑战,没有放之四海而皆准的解决方案。不过,以下问题提供了一个框架,帮助你理清不同的技术路线:
- 记忆属于哪种类型?人类用记忆来记住事实(语义记忆)、经历(情景记忆)和规则(程序性记忆)。AI 智能体也可以以同样的方式使用记忆。例如,AI 智能体可以利用记忆记住关于某个用户的特定事实,以完成任务。
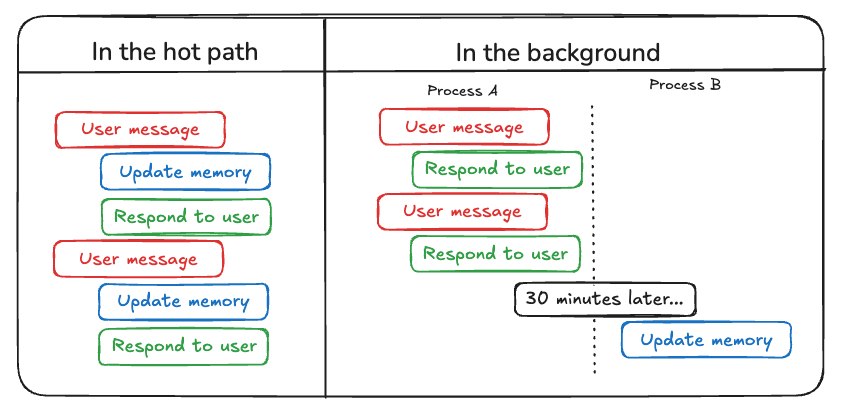
- 你希望何时更新记忆? 记忆可以作为智能体应用逻辑的一部分进行更新(例如"在热路径上")。在这种情况下,智能体通常会在回应用户之前先决定记住事实。或者,记忆也可以作为后台任务进行更新(在后台/异步运行并生成记忆的逻辑)。我们将在下面的小节中说明这些方法之间的权衡。
不同的应用需要不同类型的记忆。尽管这一类比并不完美,但考察人类记忆类型仍然能带来启发。一些研究(例如 CoALA 论文)甚至把这些人类记忆类型映射到了 AI 智能体所使用的记忆类型上。
| 记忆类型 | 存储内容 | 人类示例 | 智能体示例 |
|---|---|---|---|
| 语义 | 事实 | 我在学校学到的东西 | 关于某个用户的事实 |
| 情景 | 经历 | 我做过的那些事 | 智能体过去的动作 |
| 程序性 | 指令 | 本能或运动技能 | 智能体系统提示词 |
语义记忆
语义记忆在人类和 AI 智能体中,都涉及对特定事实和概念的保留。在人类中,它可以包括在学校学到的信息,以及对概念及其关系的理解。对于 AI 智能体,语义记忆通常用于通过记住过往交互中的事实或概念来个性化应用。
NOTE
语义记忆不同于 "semantic search"(语义搜索),后者是一种使用 "meaning"(含义,通常以嵌入表示)来查找相似内容的技术。语义记忆是心理学术语,指存储事实和知识;而语义搜索是一种基于含义而非精确匹配来检索信息的方法。
语义记忆可以通过不同方式管理:
档案
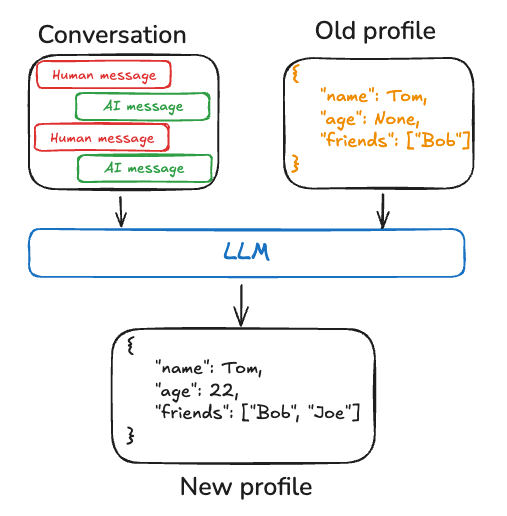
记忆可以是一份单一的、持续更新的 "档案",包含关于用户、组织或其他实体(包括智能体自身)的范围明确且具体的信息。档案通常只是一个 JSON 文档,其中包含你为表示自己的领域而选择的各种键值对。
在记忆一份档案时,你会希望确保每次都在更新该档案。因此,你会希望传入先前的档案,并让模型生成一份新档案(或生成一些要应用到旧档案的 JSON patch)。随着档案变大,这可能会变得容易出错,因此可以考虑将档案拆分为多个文档,或在生成文档时采用严格解码,以确保记忆模式保持有效。
集合
或者,记忆可以是一组随时间持续更新和扩展的文档集合。每条单独的记忆范围可以更窄,也更容易生成,这意味着你随时间推移丢失信息的可能性更低。对于 LLM 来说,为新信息生成新对象,比将新信息与现有档案进行调和更容易。因此,文档集合往往会带来下游更高的召回率。
然而,这会把一些复杂性转移到记忆更新上。模型现在必须删除或更新列表中的现有条目,这可能很棘手。此外,有些模型可能默认过度插入,而另一些可能默认过度更新。有关管理这一点的一种方法,请参阅 Trustcall 包,并考虑进行评估(例如使用 LangSmith 这类工具)来帮助你调整该行为。
使用文档集合还会把复杂性转移到对列表的记忆搜索上。Store 目前同时支持语义搜索和按内容过滤。
最后,使用记忆集合可能会使向模型提供全面的上下文变得困难。虽然单条记忆可能遵循特定的模式,但该结构可能无法捕获完整的上下文或记忆之间的关系。因此,在使用这些记忆生成响应时,模型可能会缺少在统一的档案方法中更容易获得的重要上下文信息。
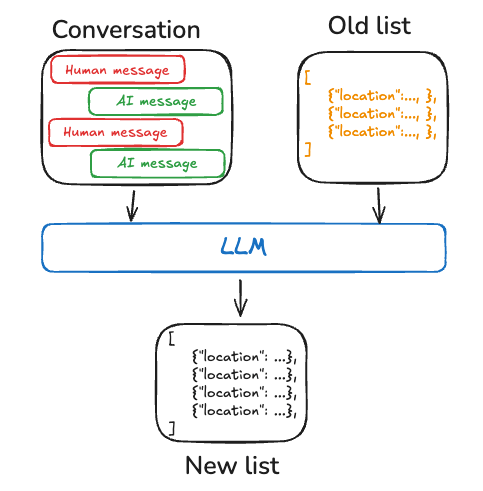
无论采用哪种记忆管理方法,核心要点是智能体会使用语义记忆来为其响应提供依据,这通常会带来更个性化、更相关的交互。
情景式记忆
情景记忆在人类和 AI 智能体中,都涉及回忆过去的事件或行为。CoALA 论文对此有很好的阐述:事实可以写入语义记忆,而经历可以写入情景记忆。对于 AI 智能体,情景记忆通常用于帮助智能体记住如何完成某项任务。
在实践中,情景记忆通常通过少样本示例提示来实现,智能体从中学习过往的序列以正确执行任务。有时 "show" 比 "tell" 更容易,而 LLM 从示例中学习效果很好。少样本学习让你可以通过用输入-输出示例更新提示词来"编程"你的 LLM,以说明期望的行为。虽然可以使用各种最佳实践来生成少样本示例,但挑战往往在于根据用户输入选择最相关的示例。
请注意,记忆 store 只是将数据存储为少样本示例的一种方式。如果你希望开发者参与更多,或让少样本与你的评估 harness 更紧密地结合,你也可以使用 LangSmith Dataset 来存储数据,并实现自己的检索逻辑,以根据用户输入选择最相关的示例。
请参阅这篇博客文章,其中展示了通过少样本提示来提升工具调用性能;以及这篇博客文章,其中使用少样本示例让 LLM 与人类偏好对齐。
程序性记忆
程序性记忆在人类和 AI 智能体中,都涉及记住用于执行任务的规则。在人类中,程序性记忆就像如何执行任务的内化知识,例如通过基本的运动技能和平衡来骑自行车。另一方面,情景记忆涉及回忆具体的经历,例如你第一次成功骑上没有辅助轮的自行车,或一次难忘的穿越风景优美路线的骑行。对于 AI 智能体,程序性记忆是模型权重、智能体代码和智能体提示词的组合,它们共同决定了智能体的功能。
在实践中,智能体修改自己的模型权重或重写自己的代码相当少见。然而,智能体修改自己的提示词则更为常见。
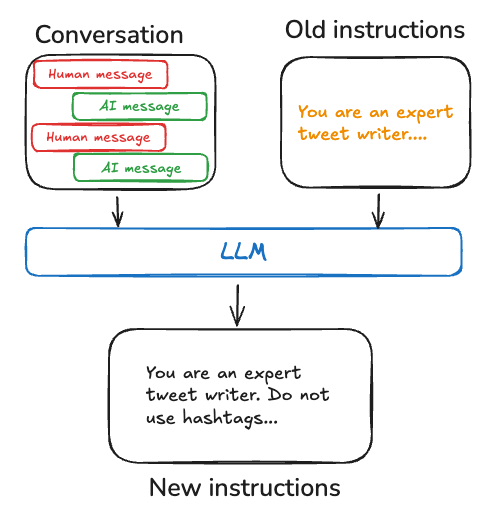
改进智能体指令的一种有效方法是通过"反思"或元提示。这涉及将智能体当前的指令(例如系统提示词)连同最近的对话或明确的用户反馈一起提示给智能体。然后智能体根据这些输入改进自己的指令。对于指令难以预先指定的任务,这种方法特别有用,因为它允许智能体从交互中学习和适应。
例如,我们构建了一个 Tweet 生成器,使用外部反馈和提示词重写来为 Twitter 生成高质量的论文摘要。在这种情况下,具体的摘要提示词难以先验指定,但用户可以相当容易地批评生成的 Tweet,并就如何改进摘要过程提供反馈。
下面的伪代码展示了如何使用 LangGraph 记忆 store 来实现这一点:使用该 store 保存提示词,使用 update_instructions 节点获取当前提示词(以及 state["messages"] 中捕获的用户对话反馈),更新提示词,并将新提示词保存回 store。然后,call_model 从 store 获取更新后的提示词,并用它来生成响应。
python
# Node that *uses* the instructions
def call_model(state: State, store: BaseStore):
    namespace = ("agent_instructions", )
    instructions = store.get(namespace, key="agent_a")[0]
    # Application logic
    prompt = prompt_template.format(instructions=instructions.value["instructions"])
    ...

# Node that updates instructions
def update_instructions(state: State, store: BaseStore):
    namespace = ("instructions",)
    instructions = store.search(namespace)[0]
    # Memory logic
    prompt = prompt_template.format(instructions=instructions.value["instructions"], conversation=state["messages"])
    output = llm.invoke(prompt)
    new_instructions = output['new_instructions']
    store.put(("agent_instructions",), "agent_a", {"instructions": new_instructions})
    ...
写入记忆
在热路径中
在运行时创建记忆既有优势也有挑战。从积极的一面看,这种方法允许实时更新,使新记忆立即可供后续交互使用。它还实现了透明度,因为可以在创建和存储记忆时通知用户。
然而,这种方法也带来了挑战。如果智能体需要一个新工具来决定将什么提交到记忆,这可能会增加复杂性。此外,思考要保存什么到记忆的过程可能会影响智能体的延迟。最后,智能体必须在记忆创建和其他职责之间多任务处理,这可能会影响所创建记忆的数量和质量。
举例来说,ChatGPT 使用一个 save_memories 工具来以内容字符串的形式 upsert 记忆,并针对每条用户消息决定是否以及如何使用该工具。请参阅我们的 memory-agent 模板作为参考实现。
在后台
将记忆创建作为单独的后台任务有几个优势。它消除了主应用中的延迟,将应用逻辑与记忆管理分离,并让智能体能够更专注地完成任务。这种方法还在记忆创建时机上提供了灵活性,以避免冗余工作。
然而,这种方法也有其自身的挑战。确定记忆写入的频率变得至关重要,因为不频繁的更新可能会让其他线程缺少新的上下文。决定何时触发记忆形成也很重要。常见的策略包括在设定的时间段之后调度(如果发生新事件则重新调度)、使用 cron 计划,或允许用户或应用逻辑手动触发。
请参阅我们的 memory-service 模板作为参考实现。
记忆存储
LangGraph 将长期记忆作为 JSON 文档存储在 store 中。每条记忆都组织在一个自定义的 namespace(类似于文件夹)和一个不同的 key(类似于文件名)之下。命名空间通常包含用户或组织 ID 或其他标签,以便于组织信息。这种结构支持记忆的层次化组织。随后通过内容过滤器支持跨命名空间搜索。
python
from langgraph.store.memory import InMemoryStore

def embed(texts: list[str]) -> list[list[float]]:
    # Replace with an actual embedding function or LangChain embeddings object
    return [[1.0, 2.0] * len(texts)]

# InMemoryStore saves data to an in-memory dictionary. Use a DB-backed store in production use.
store = InMemoryStore(index={"embed": embed, "dims": 2})
user_id = "my-user"
application_context = "chitchat"
namespace = (user_id, application_context)
store.put(
    namespace,
    "a-memory",
    {
        "rules": [
            "User likes short, direct language",
            "User only speaks English & python",
        ],
        "my-key": "my-value",
    },
)
# get the "memory" by ID
item = store.get(namespace, "a-memory")
# search for "memories" within this namespace, filtering on content equivalence, sorted by vector similarity
items = store.search(
    namespace, filter={"my-key": "my-value"}, query="language preferences"
)有关记忆存储的更多信息,请参阅持久化指南。