
主题
评估类型
本页涵盖 LangSmith 中评估的两个方面:
- 评估类型:何时以及为何评估。离线评估类型(基准测试、单元测试、回归测试)用于部署前测试,以及在线评估类型(监控、异常检测)用于生产。
- 评估器实现:如何评估。可用的评估器方法(LLM-as-judge、决策模型、代码、复合、汇总、成对)以及在何处配置它们(UI 或 SDK,离线或在线)。
理解这两个方面有助于你构建一个全面的评估策略,在部署前验证功能并在生产中监控质量。
离线评估类型
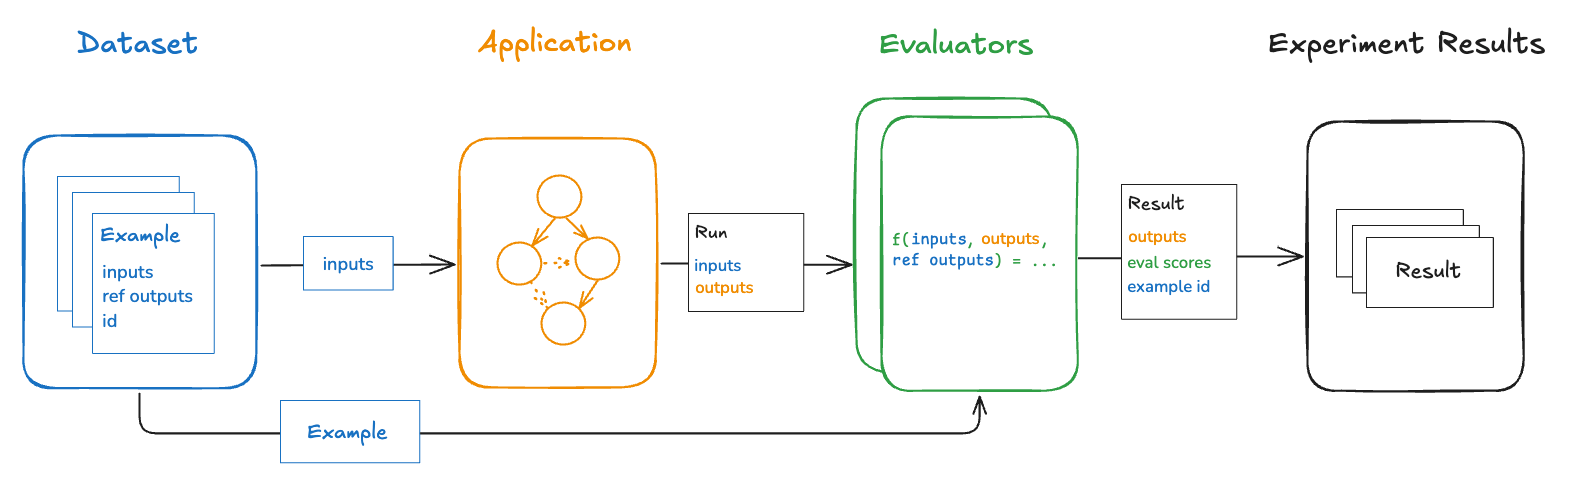
离线评估在部署前,在精选数据集上测试应用。通过在带参考输出的示例上运行评估,团队可以比较版本、验证功能,并在把变更暴露给用户之前建立信心。
使用 LangSmith SDK(Python 或 TypeScript)在客户端运行离线评估,或通过 Playground 在服务端运行,或通过把评估器绑定到数据集。
基准测试
基准测试在精选数据集上比较多个应用版本,以识别最佳表现者。这一过程包括创建一个有代表性输入的数据集、定义性能指标,并测试每个版本。
基准测试需要带有金标准参考输出的数据集精选,以及精心设计的比较指标。示例:
- RAG Q&A 机器人:问题和参考答案的数据集,配一个检查实际答案与参考答案之间语义等价的 LLM-as-judge 评估器。
- ReAct agent:用户请求和参考工具调用的数据集,配一个验证所有预期工具调用都已发起的启发式评估器。
单元测试
单元测试验证单个系统组件的正确性。在 LLM 语境中,单元测试通常是针对输入或输出的基于规则的断言(例如验证 LLM 生成的代码能编译、JSON 能成功加载),用来验证基本功能。
单元测试通常期望一致通过的结果,使它们适合 CI 流水线。在 CI 中运行时,配置缓存以尽量减少 LLM API 调用和相关成本。
更多详情,参阅 Pytest 和 Vitest/Jest 页面。
回归测试
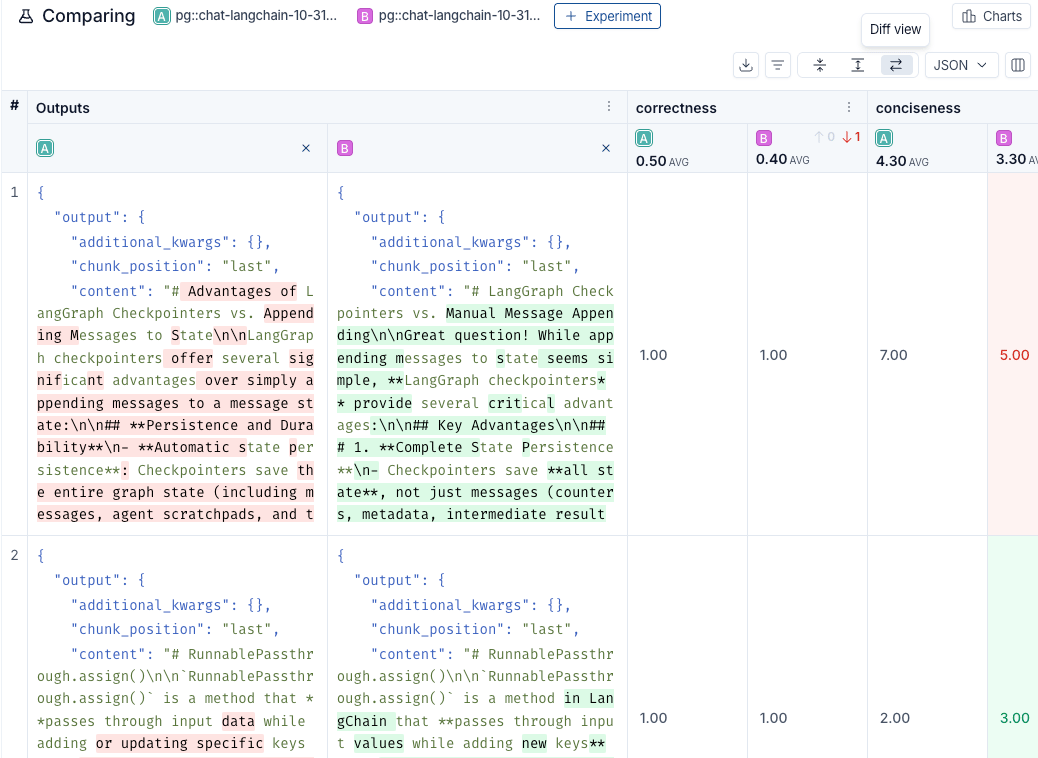
回归测试衡量应用各版本随时间推移的性能一致性。它们确保新版本不会在当前版本正确处理的情形上降低性能,并理想地展示相对基线的改进。这些测试通常在做出预期会影响用户体验的更新时运行(例如模型或架构变更)。
LangSmith 的比较视图突出显示相对基线的回归(红色)和改进(绿色),从而实现快速变更识别。
回测
回测针对历史生产数据评估新的应用版本。生产日志被转换为一个数据集,然后较新版本处理这些示例,以评估在过去真实的用户输入上的表现。
这一方法常用于评估新的模型发布。例如,当一个新的模型可用时,在最近的生产运行上测试它,并把结果与实际生产结果比较。
成对评估
成对评估通过确定相对质量来比较两个版本的输出,而非赋予绝对分数。对某些任务而言,确定"版本 A 优于 B"比独立地为每个版本打分更容易。
这一方法在对主观任务的 LLM-as-judge 评估上尤其有用。例如,在摘要中,确定"哪个摘要更清晰、更简洁?"往往比赋予清晰的数值分数更简单。
了解如何运行成对评估。
在线评估类型
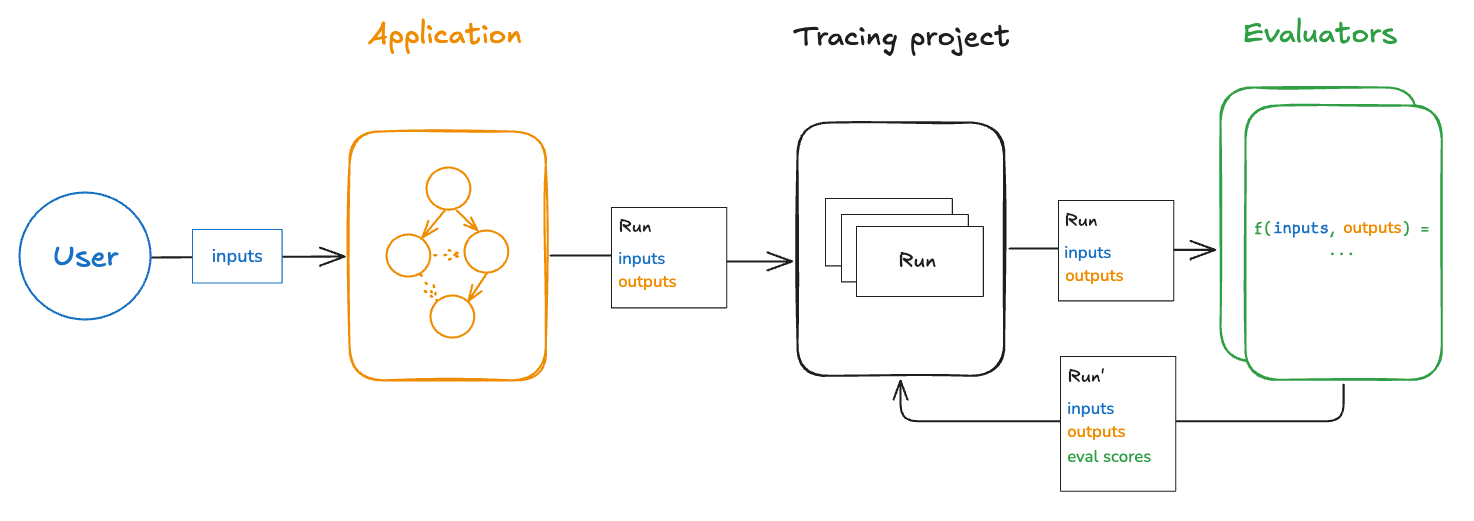
在线评估在近实时地评估生产应用的输出。没有参考输出,这些评估聚焦于检测问题、监控质量趋势,以及识别为未来离线测试提供信息的边缘情形。
在线评估器通常在服务端运行。LangSmith 支持自定义 LLM-as-judge 评估器和代码评估器。LangChain Tuned Evaluators 提供由 LangChain 管理的专门评判者。
实时监控
在用户与系统交互时持续监控应用质量。在线评估在生产流量上自动运行,为每次交互提供即时反馈。这让你在质量下降影响大量用户群之前,检测到质量下降、异常模式或意外行为。
异常检测
识别偏离预期模式的离群值和边缘情形。在线评估器可以标记具有异常特征的运行——极长或极短的响应、意外的错误率,或未通过安全检查的输出——以供人工审查和可能地加入离线数据集。
生产反馈回路
用来自生产的洞察改进离线评估。在线评估会浮现精选数据集中可能不会出现的真实世界问题和使用模式。失败的生产运行成为数据集示例的候选,形成一个生产经验持续精炼测试覆盖的迭代循环。
实现评估器
上面的评估类型描述了何时评估。LangSmith 提供了多种如何实现评估器的方法,适用于这些各评估类型。
LLM-as-a-judge
用一个 LLM 基于提示中定义的标准给输出打分。这一方法适用于语气、清晰度或语义正确性等难以用确定性规则捕捉的主观品质。
常见用例包括针对参考输出评估事实准确性(离线),或检查生产响应中的毒性(在线)。例如,对一个 RAG 系统做基准测试可能用一个 LLM-as-judge 评估器来检查生成答案与参考答案之间的语义等价。
为以下情形配置 LLM-as-a-judge 评估器:
决策模型评估器
用一个决策模型(例如 SemIf 或 Jev)回答关于输出的带类型问题。每个问题返回一个概率、一个所选选项或一个分数,并成为它自己的反馈键,因此你无需编写提示或输出 schema。
为以下情形配置决策模型评估器:
SDK 尚不支持决策模型评估器。
代码评估器
编写确定性的、基于规则的函数来检查特定条件。这些评估器执行自定义逻辑以验证结构、检查模式或应用业务规则。
代码评估器对单元测试尤其有用——验证生成的代码能编译、JSON 能正确解析,或必需字段存在。在回归测试中,它们能跟踪结构化输出的一致性。对于在线监控,它们实时捕捉格式违规。
为以下情形定义代码评估器:
复合评估器
用加权平均或求和把多个评估器分数组合成一个指标。这会创建能同时反映多个评估标准的聚合质量分数。
对于基准测试,复合分数有助于在多个维度上比较版本(例如 70% 准确性 + 20% 清晰度 + 10% 简洁性)。在在线监控中,它们为仪表板和告警提供单一指标。例如,把助手的有用性、正确性和语气分数的加权组合跟踪为一个整体的聊天机器人质量。
为以下情形设置复合评估器:
汇总评估器
跨整个实验而非单个示例计算指标。这些评估器接收来自数据集的所有输出,并计算诸如精确率、召回率、F1 分数或分布分析的聚合统计。
当你需要数据集级指标——比较整体跨版本性能而非逐示例分数——时,汇总评估器对基准测试至关重要。它们只与离线评估配合使用,因为它们需要处理完整数据集。
为以下情形实现汇总评估器:
- 离线评估的自定义聚合函数:用 SDK
成对评估器
比较两个版本的输出以确定相对质量。这一方法在前面成对评估中已介绍,当绝对打分困难但确定"哪个更好"很直接时有帮助。
为以下情形运行成对评估:
- 比较现有实验:用 SDK