
主题
评估聊天机器人
在本指南中,我们将为一个聊天机器人搭建评估。这些评估让你能够衡量你的应用在一组数据上的表现有多好。能够快速可靠地获得这种洞察,会让你能够有信心地进行迭代。
从宏观上看,在本教程中我们将:
- 创建一个初始的黄金数据集以衡量性能
- 定义用于衡量性能的指标
- 在几个不同的提示或模型上运行评估
- 手动比较结果
- 随时间跟踪结果
- 设置在 CI/CD 中运行的自动化测试
有关 LangSmith 所支持评估工作流的更多信息,查看操作指南,或参阅 evaluate 及其异步的 aevaluate 对应物的参考文档。
要讲的内容很多,我们开始吧!
设置
首先安装本教程所需的依赖。我们恰好用到了 OpenAI,但 LangSmith 可与任何模型一起使用:
bash
pip install -U langsmith openaibash
uv add langsmith openai并设置环境变量以启用 LangSmith 追踪:
bash
export LANGSMITH_TRACING="true"
export LANGSMITH_API_KEY="<Your LangSmith API key>"
export OPENAI_API_KEY="<Your OpenAI API key>"创建数据集
在为测试和评估你的应用做准备时,第一步是定义你想要评估的数据点。这里有几方面需要考虑:
- 每个数据点的 schema 应当是什么?
- 我应该收集多少个数据点?
- 我应该如何收集这些数据点?
Schema: 每个数据点至少应当包括应用的输入。如果你能做到,定义预期输出也很有帮助——它们代表一个正常运作的应用所应当输出的内容。很多时候你无法定义完美的输出——这没关系!评估是一个迭代过程。有时你可能还想为每个示例定义更多信息——例如在 RAG 中应获取的预期文档,或作为 agent 应采取的预期步骤。LangSmith 数据集非常灵活,允许你定义任意 schema。
多少个: 对于应当收集多少个数据点没有硬性规定。主要的是确保你对可能要防范的边界情况有恰当的覆盖。哪怕 10-50 个示例也能提供大量价值!一开始不必担心数量要大——你随时可以(也应当)逐步添加!
如何获取: 这也许是最棘手的一部分。一旦你确定想收集一个数据集……你究竟该怎么做?对于大多数在启动新项目,我们通常见到他们先手动收集最初的 10-20 个数据点。从这些数据点起步后,这些数据集通常是活的构造,会随时间增长。它们通常在看到真实用户如何使用你的应用、看到存在的痛点之后增长,然后把其中一些数据点移入此集合。也有像合成生成数据这样的方法,可用于扩充你的数据集。起步时,我们建议先不理会这些,只对 ~10-20 个示例做手工标注。
一旦你有了数据集,就有几种不同的方式将它们上传到 LangSmith。在本教程中,我们将使用 client,但你也可以通过 UI 上传(甚至可以在 UI 中创建它们)。
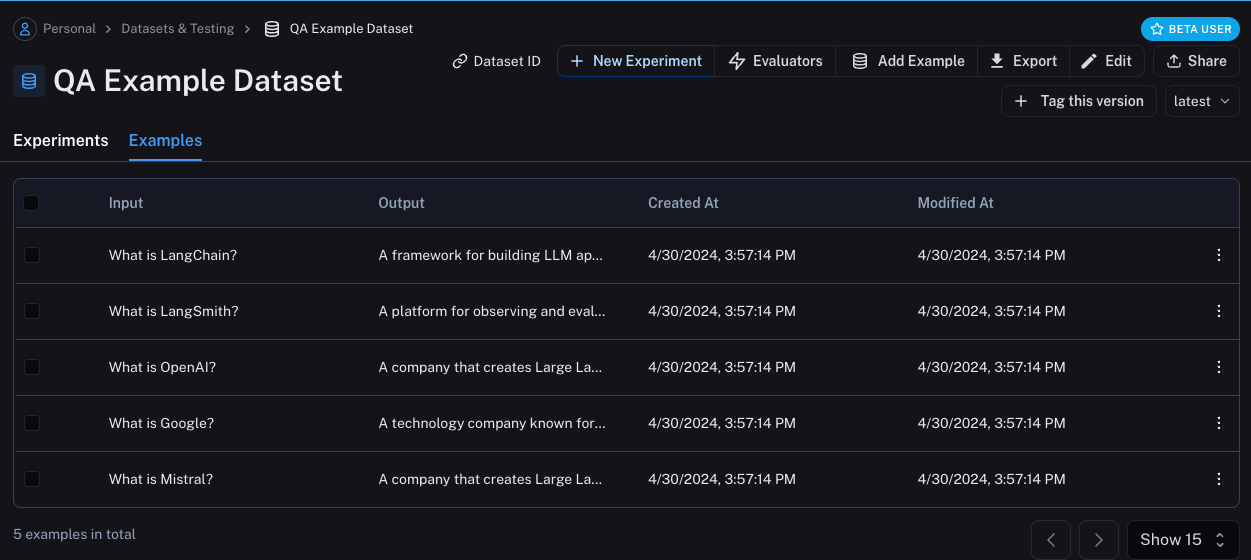
在本教程中,我们将创建 5 个数据点用于评估。我们将评估一个问答应用。输入将是一个问题,输出将是一个答案。由于这是一个问答应用,我们可以定义预期答案。让我们来展示如何创建并将这个数据集上传到 LangSmith!
python
from langsmith import Client

client = Client()

# Define dataset: these are your test cases
dataset_name = "QA Example Dataset"
dataset = client.create_dataset(dataset_name)

client.create_examples(
    dataset_id=dataset.id,
    examples=[
        {
            "inputs": {"question": "What is LangChain?"},
            "outputs": {"answer": "A framework for building LLM applications"},
        },
        {
            "inputs": {"question": "What is LangSmith?"},
            "outputs": {"answer": "A platform for observing and evaluating LLM applications"},
        },
        {
            "inputs": {"question": "What is OpenAI?"},
            "outputs": {"answer": "A company that creates Large Language Models"},
        },
        {
            "inputs": {"question": "What is Google?"},
            "outputs": {"answer": "A technology company known for search"},
        },
        {
            "inputs": {"question": "What is Mistral?"},
            "outputs": {"answer": "A company that creates Large Language Models"},
        }
    ]
)现在,如果我们去 LangSmith UI 并在 Datasets & Testing 页面查找 QA Example Dataset,当我们点进去时,应当会看到我们有五个新示例。
定义指标
在创建我们的数据集之后,我们现在可以定义一些指标来评估我们的响应。由于我们有一个预期答案,我们可以在评估中与之比较。不过,我们并不期望我们的应用输出那些完全相同的答案,而是某种与之相似的东西。这让我们的评估稍微棘手一些。
除了评估正确性,我们还要确保答案是简短而精炼的。这一项会容易一些——我们可以定义一个简单的 Python 函数来衡量响应的长度。
让我们继续定义这两个指标。
对于第一个,我们将用一个 LLM 来评判输出是否正确(相对于预期输出)。对于那种太复杂、无法用简单函数衡量的情况,这种 LLM-as-a-judge(LLM 作为评判者)相对常见。我们可以在这里定义我们自己的、用于评估的提示和 LLM:
python
import openai
from langsmith import wrappers

openai_client = wrappers.wrap_openai(openai.OpenAI())

eval_instructions = "You are an expert professor specialized in grading students' answers to questions."

def correctness(inputs: dict, outputs: dict, reference_outputs: dict) -> bool:
    user_content = f"""You are grading the following question:
{inputs['question']}
Here is the real answer:
{reference_outputs['answer']}
You are grading the following predicted answer:
{outputs['response']}
Respond with CORRECT or INCORRECT:
Grade:"""
    response = openai_client.chat.completions.create(
        model="gpt-5.4-mini",
        temperature=0,
        messages=[
            {"role": "system", "content": eval_instructions},
            {"role": "user", "content": user_content},
        ],
    ).choices[0].message.content
return response == "CORRECT"对于评估响应的长度,这要容易得多!我们可以只定义一个简单的函数,检查实际输出是否小于预期结果长度的 2 倍。
python
def concision(outputs: dict, reference_outputs: dict) -> bool:
return int(len(outputs["response"]) < 2 * len(reference_outputs["answer"]))运行评估
很好!那我们要如何运行评估?现在我们有了数据集和评估器,所缺的只是我们的应用!我们将构建一个简单的应用,它只有一条关于如何响应的指令作为系统消息,然后把它传给 LLM。我们将直接用 OpenAI SDK 构建它:
python
default_instructions = "Respond to the users question in a short, concise manner (one short sentence)."

def my_app(question: str, model: str = "gpt-5.4-mini", instructions: str = default_instructions) -> str:
    return openai_client.chat.completions.create(
        model=model,
        temperature=0,
        messages=[
            {"role": "system", "content": instructions},
            {"role": "user", "content": question},
        ],
).choices[0].message.content在通过 LangSmith 评估运行它之前,我们需要定义一个简单的 wrapper,它把数据集的输入键映射到我们要调用的函数,然后把函数的输出映射到我们期望的输出键。
python
def ls_target(inputs: str) -> dict:
return {"response": my_app(inputs["question"])}很好!现在我们准备好运行一次评估了。让我们开始!
python
experiment_results = client.evaluate(
    ls_target, # Your AI system
    data=dataset_name, # The data to predict and grade over
    evaluators=[concision, correctness], # The evaluators to score the results
    experiment_prefix="openai-4o-mini", # A prefix for your experiment names to easily identify them
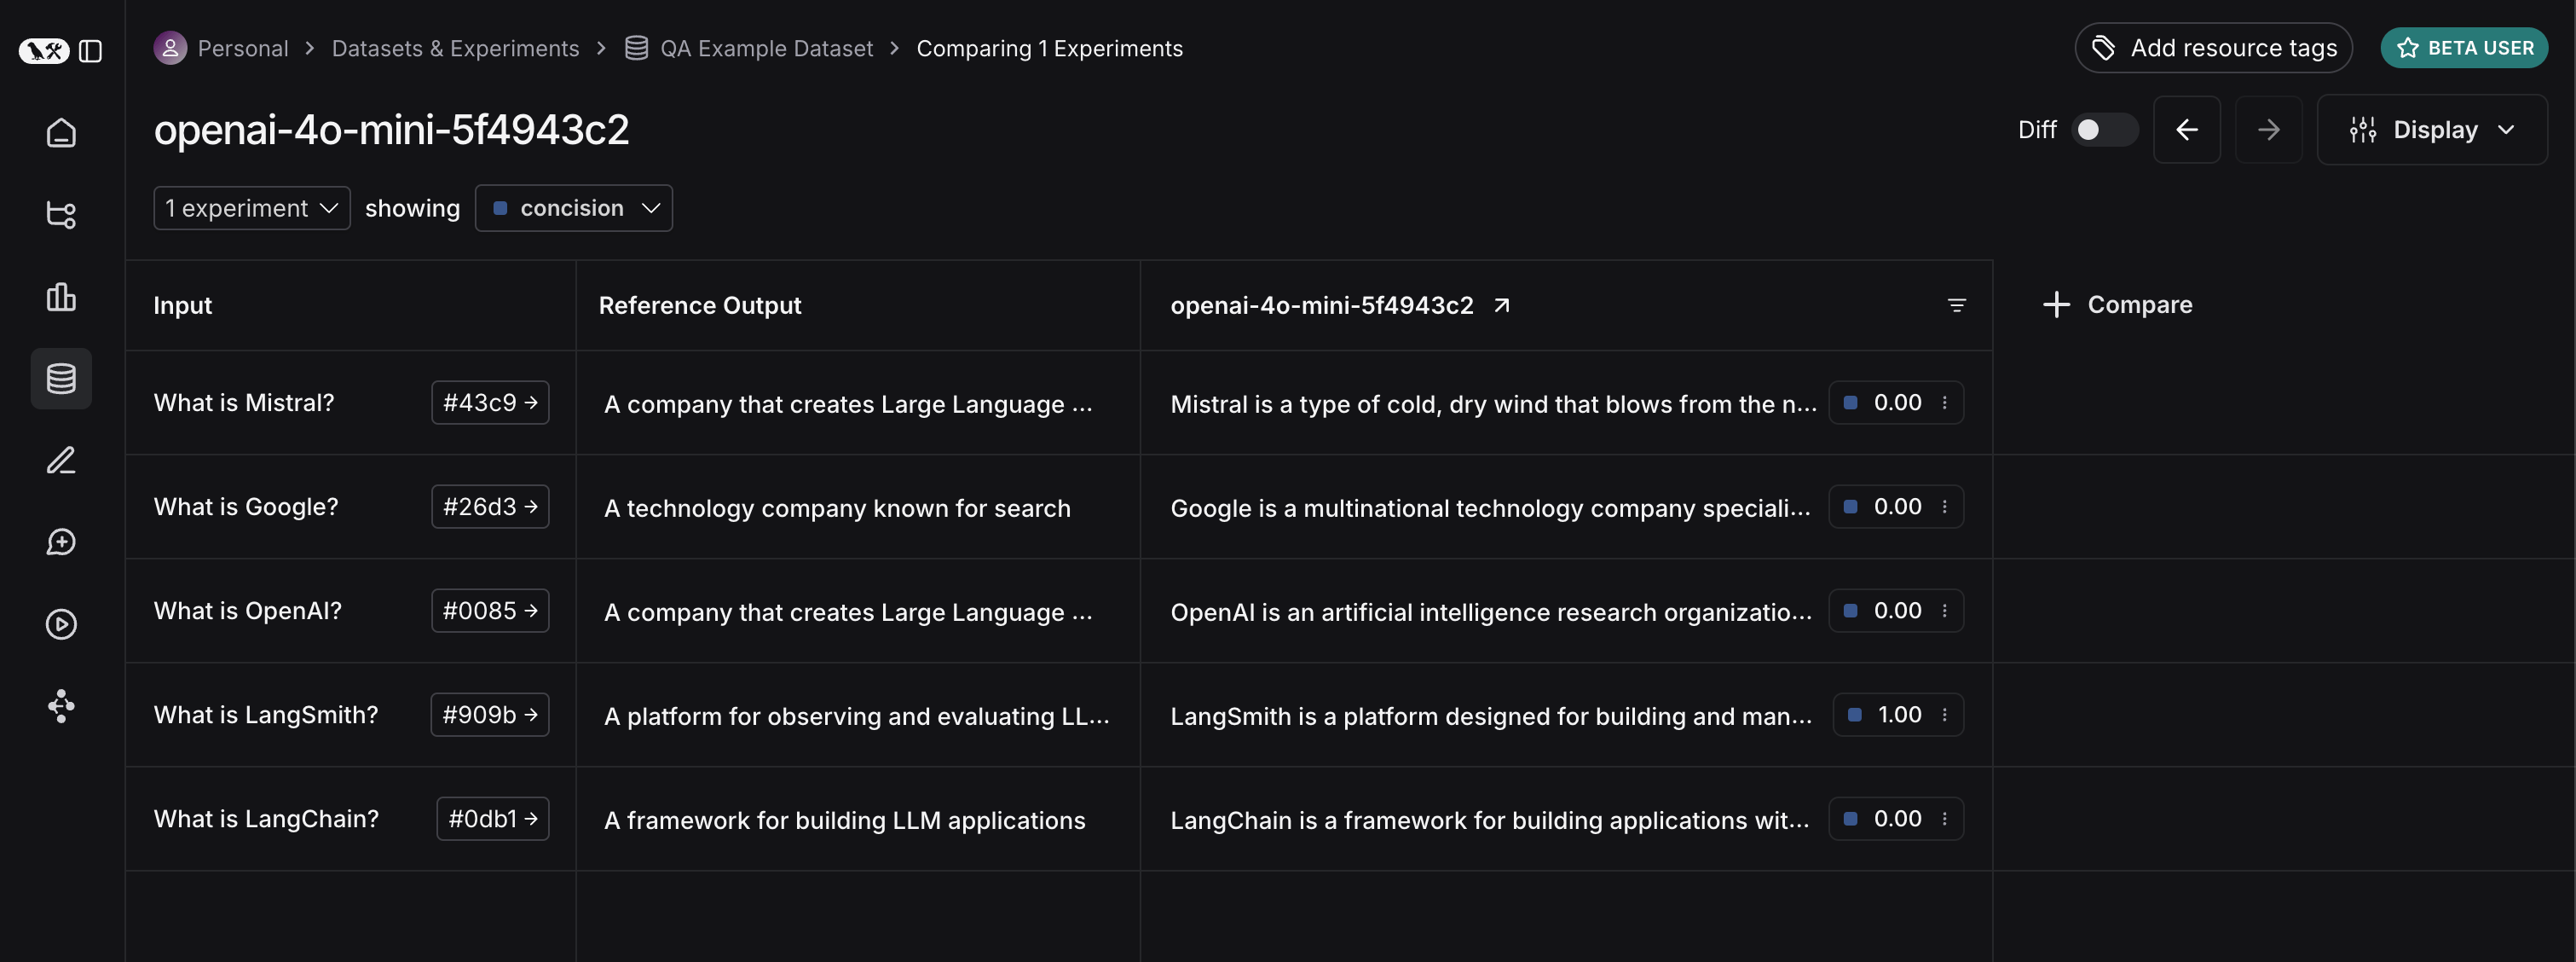
)这会输出一个 URL。如果我们点击它,应当会看到我们评估的结果!
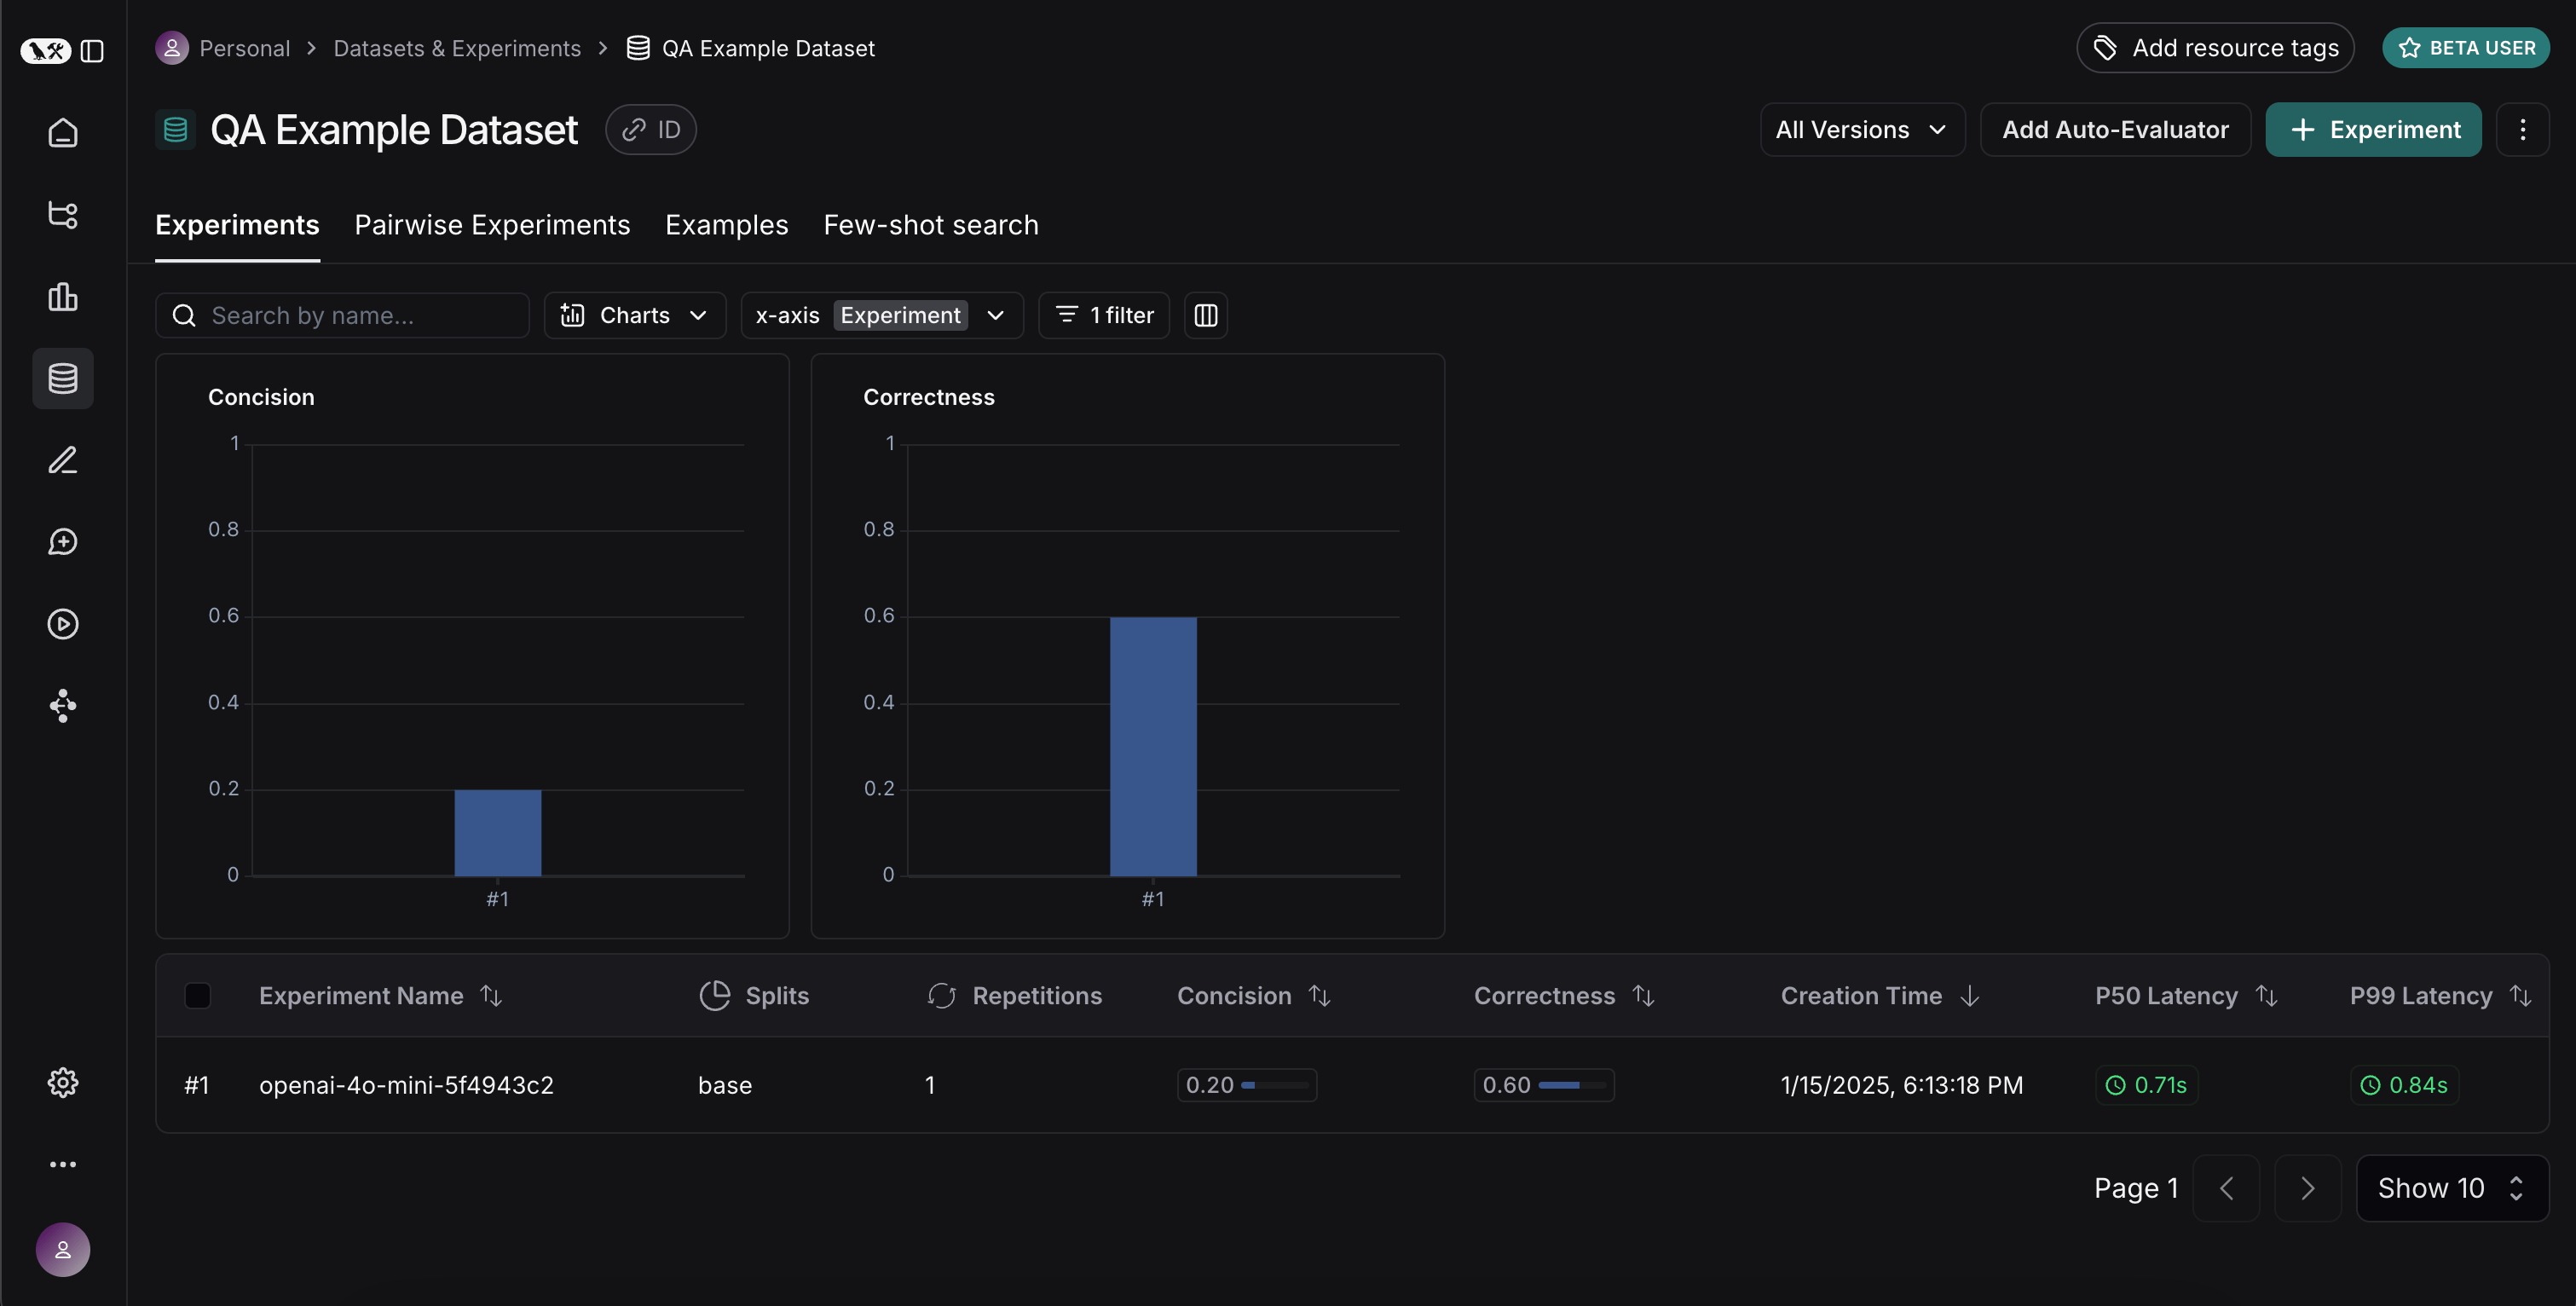
如果我们回到数据集页面并选择 Experiments 标签,我们现在可以看到我们这一次运行的摘要!
现在让我们换用不同的模型试试!让我们试试 gpt-4-turbo
python
def ls_target_v2(inputs: str) -> dict:
    return {"response": my_app(inputs["question"], model="gpt-4-turbo")}

experiment_results = client.evaluate(
    ls_target_v2,
    data=dataset_name,
    evaluators=[concision, correctness],
    experiment_prefix="openai-4-turbo",
)现在让我们使用 GPT-4,同时也更新提示,要求答案更严格地简短。
python
instructions_v3 = "Respond to the users question in a short, concise manner (one short sentence). Do NOT use more than ten words."

def ls_target_v3(inputs: str) -> dict:
    response = my_app(
        inputs["question"],
        model="gpt-4-turbo",
        instructions=instructions_v3
    )
    return {"response": response}

experiment_results = client.evaluate(
    ls_target_v3,
    data=dataset_name,
    evaluators=[concision, correctness],
    experiment_prefix="strict-openai-4-turbo",
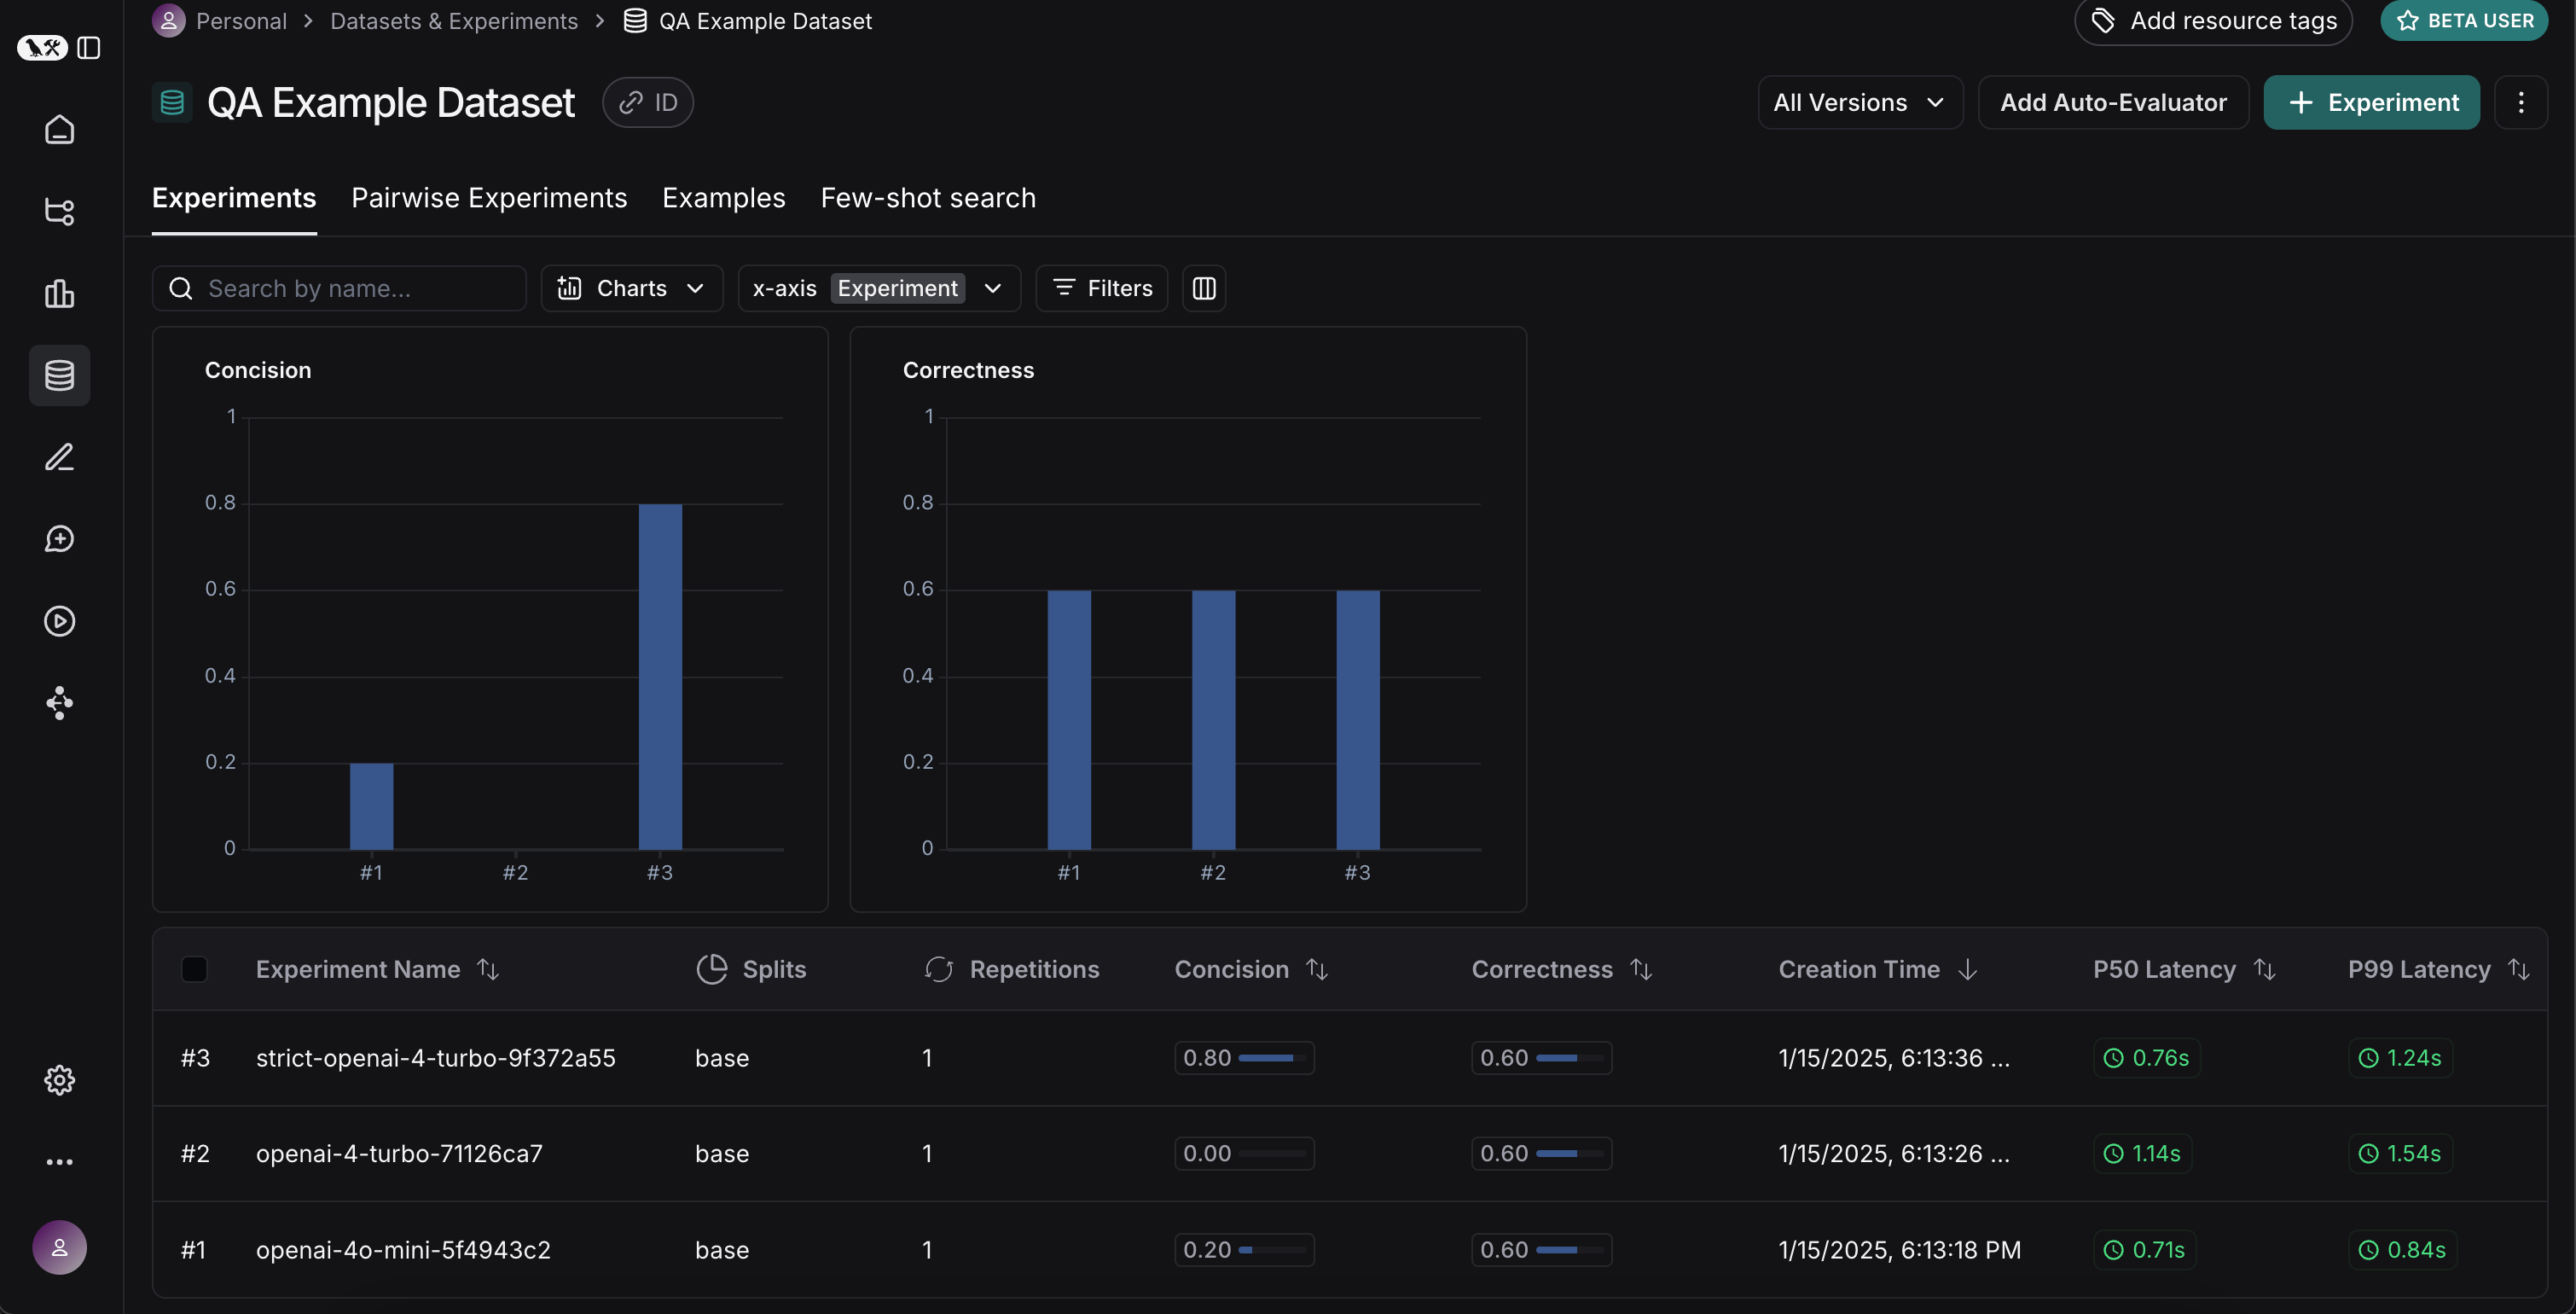
)如果我们回到数据集页面的 Experiments 标签,我们应该会看到三次运行现在都出现了!
比较结果
太好了,我们评估了三个不同的运行。但我们能如何比较结果呢?第一种方式就是查看 Experiments 标签中的各个运行。如果我们这么做,可以看到每个运行指标的高层视图:
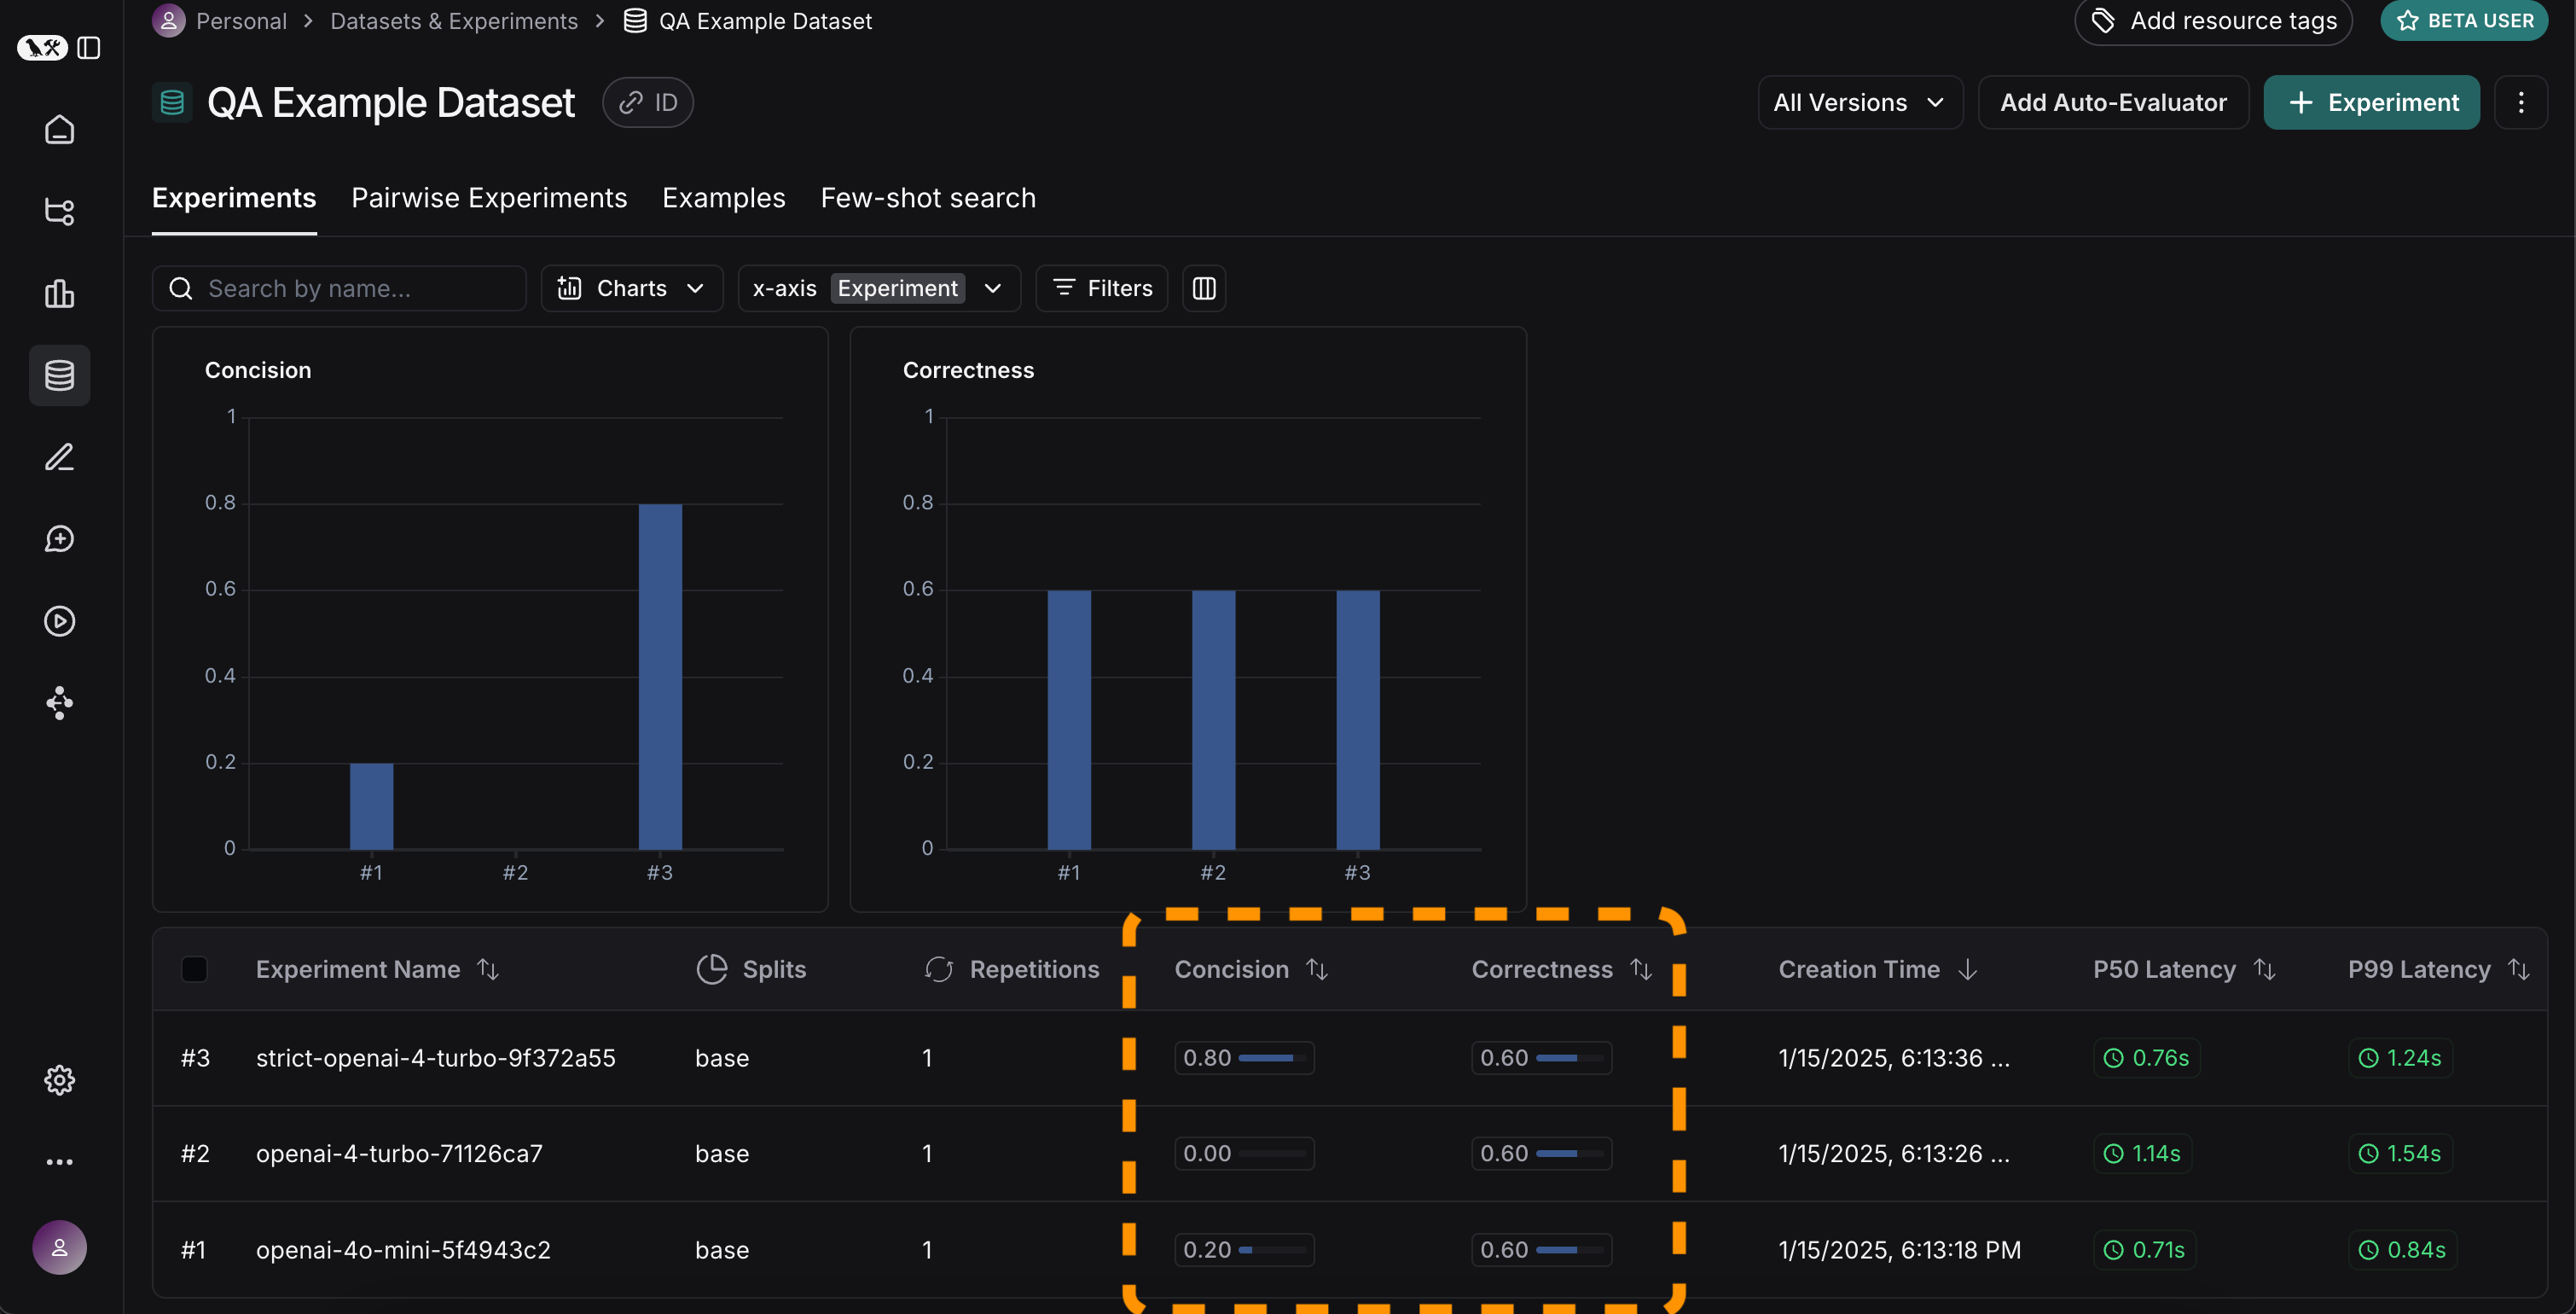
我们可以看出,在识别公司方面 GPT-4 优于 GPT-3.5,并且严格的提示对缩短长度帮助很大。但如果我们想更详细地探索呢?
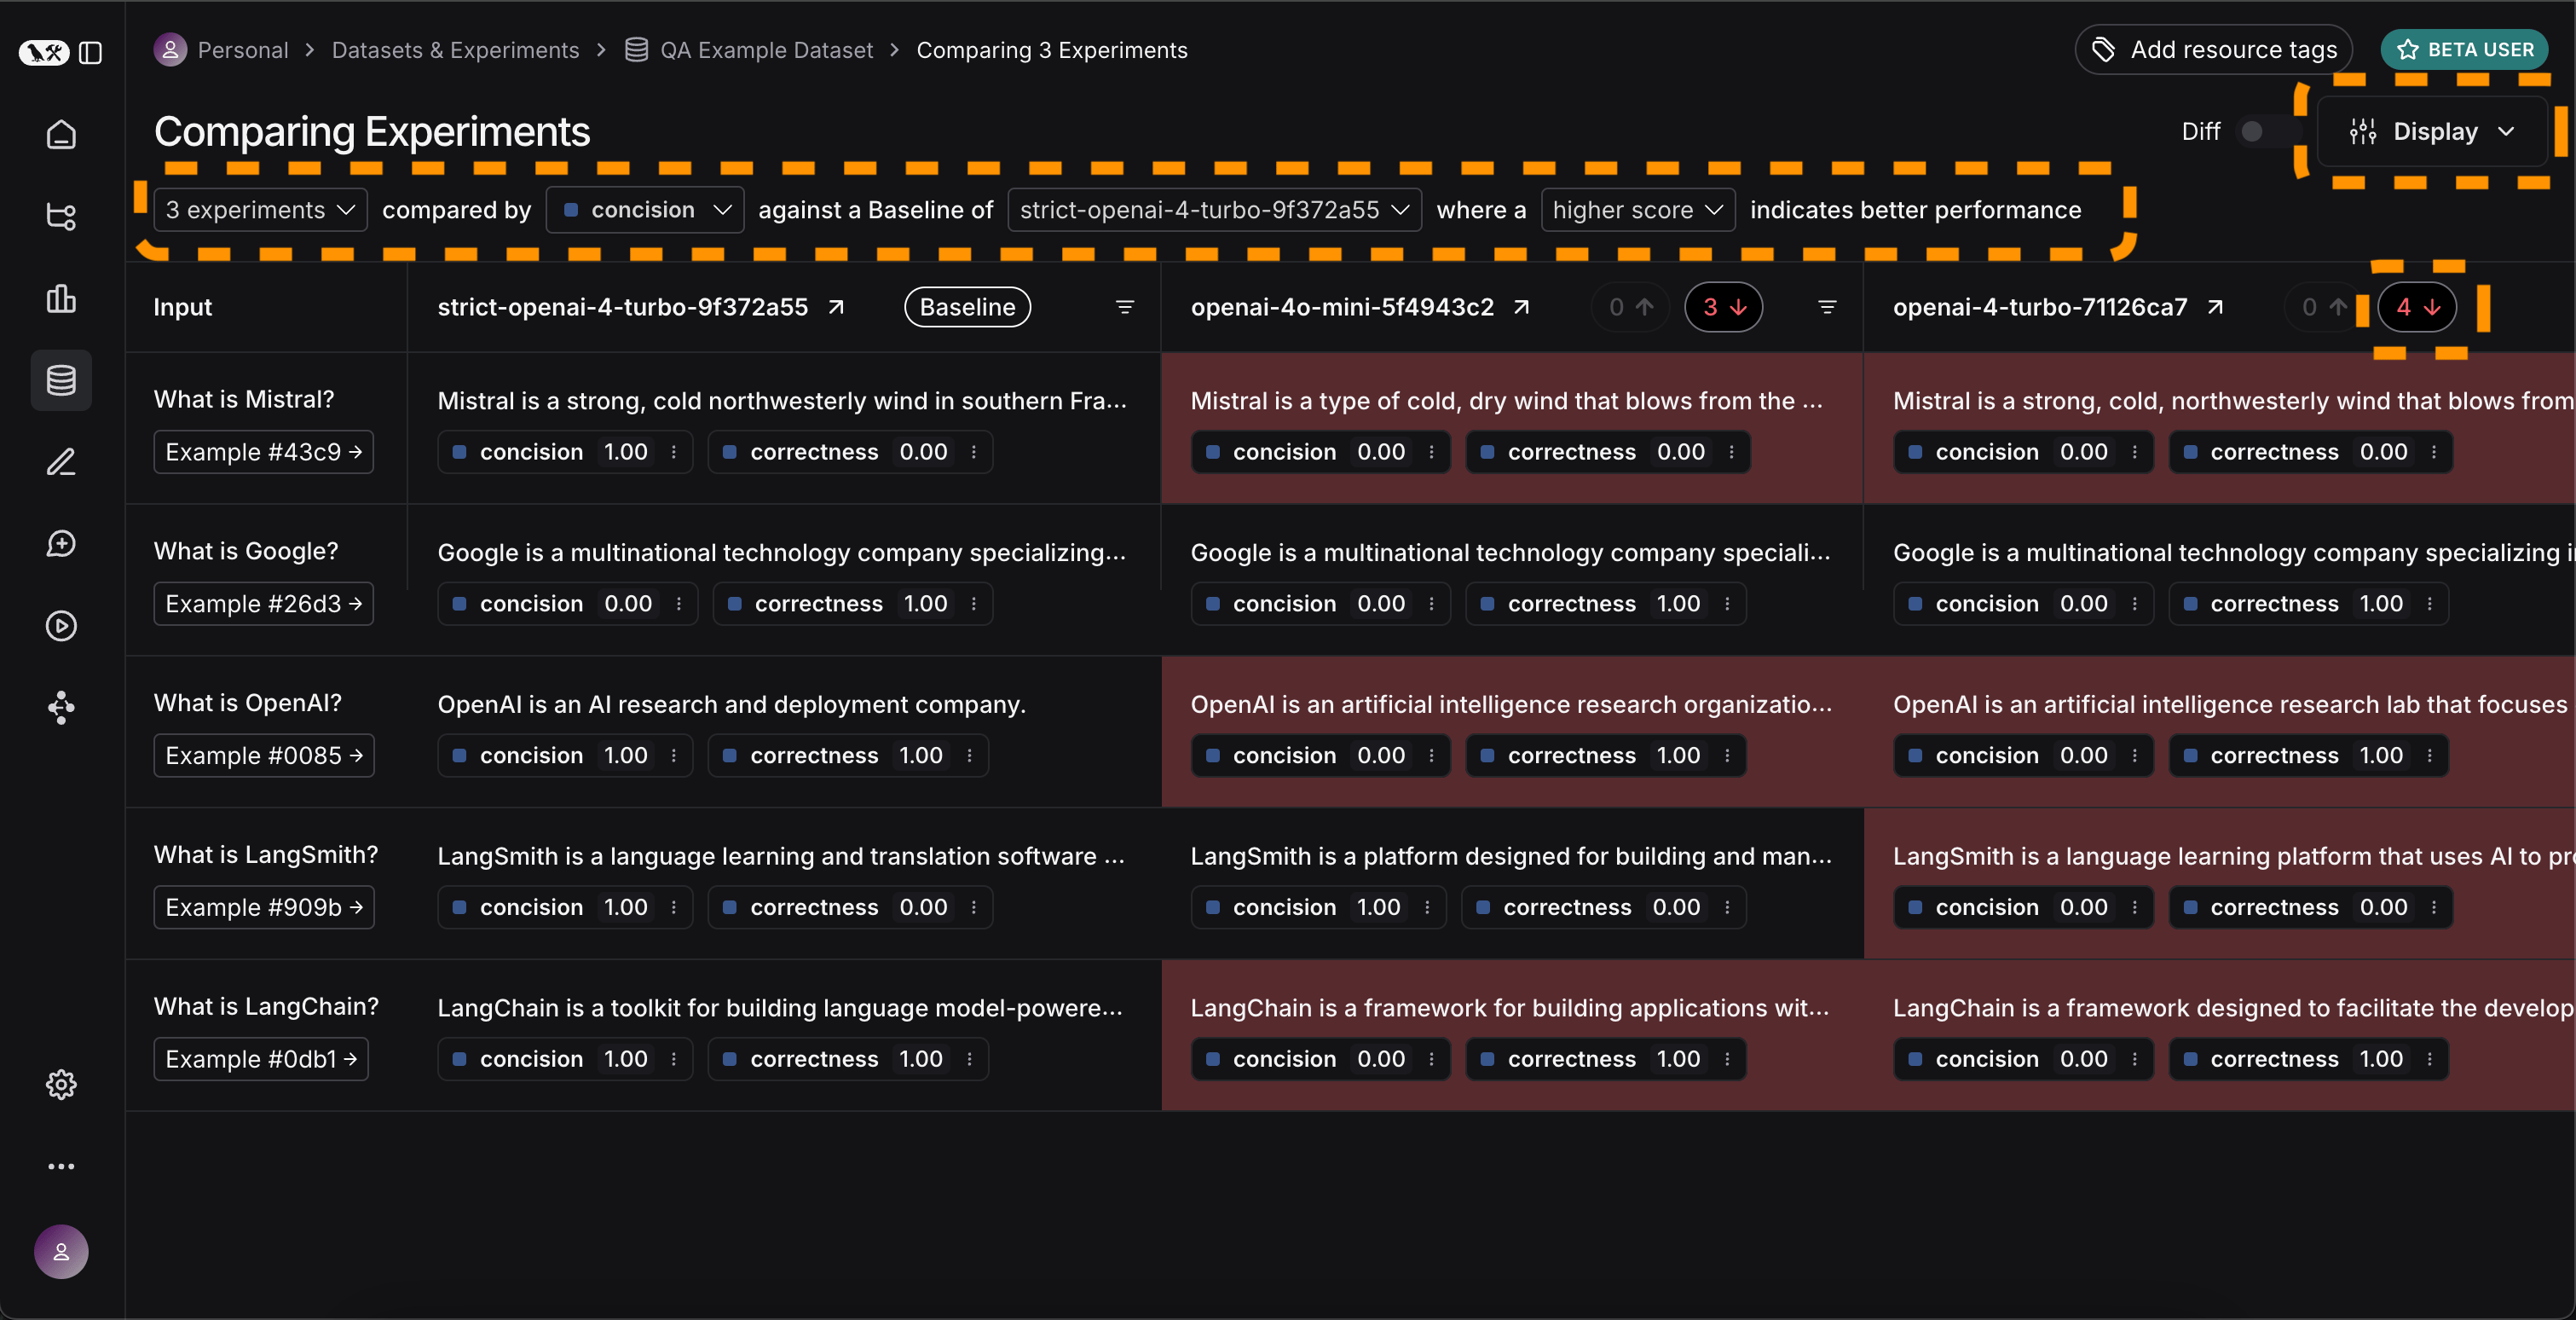
为此,我们可以选择我们要比较的所有运行(在本例中是全部三个),并在一个比较视图中打开它们。我们立刻看到所有三个测试并排呈现。有些单元格用颜色编码——这显示的是某个指标相对于某个基线的回退。我们会为基线和指标自动选择默认值,但你可以自行更改。你也可以使用 Display 控件来选择你看到哪些列和哪些指标。你还可以点击顶部的图标,自动过滤为只显示有改进/回退的运行。
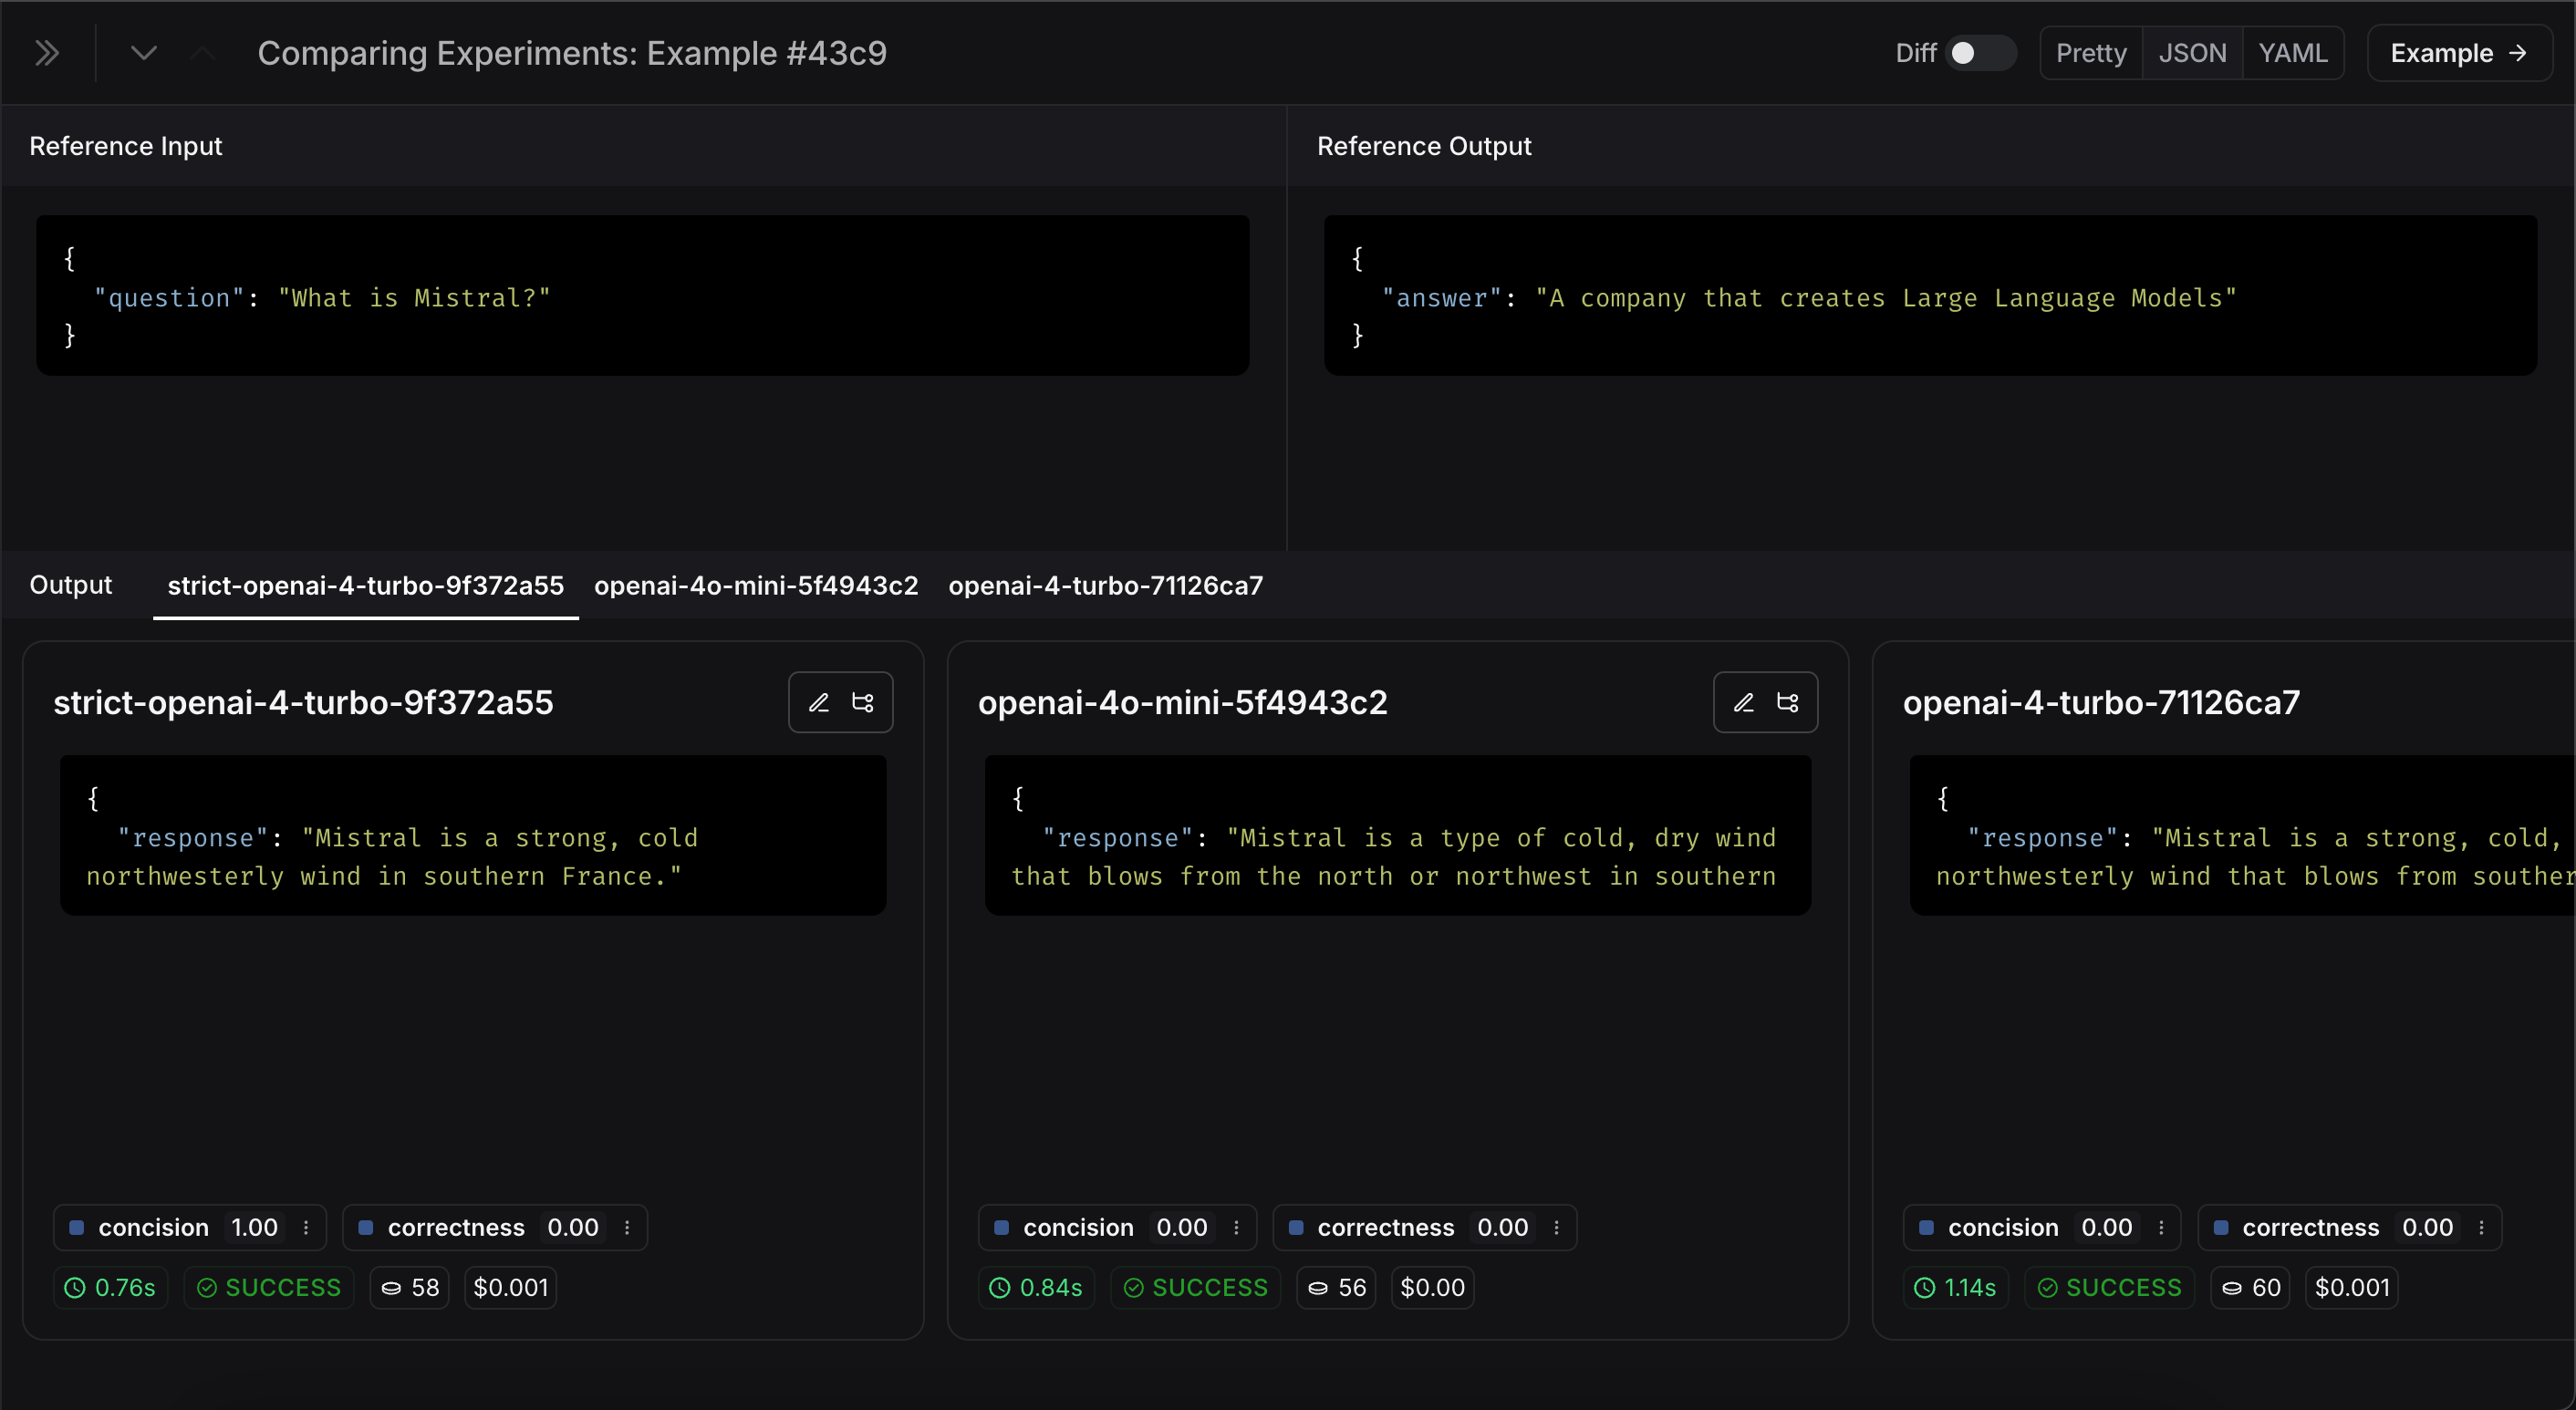
如果我们想看更多信息,还可以在悬停到某行时选择出现的 Expand 按钮,以打开一个包含更详细信息的侧面板:
设置在 CI/CD 中运行的自动化测试
既然我们已经以一次性方式运行了它,我们可以设置它以自动化的方式运行。我们可以很容易地做到这一点,只需把它作为一个在 CI/CD 中运行的 pytest 文件纳入。作为其中的一部分,我们既可以仅记录结果,也可以设置一些标准来判断它是否通过。例如,如果我想确保我们始终至少有 80% 生成的响应通过 length 检查,我们可以用一个像这样的测试来设置:
python
def test_length_score() -> None:
    """Test that the length score is at least 80%."""
    experiment_results = evaluate(
        ls_target, # Your AI system
        data=dataset_name, # The data to predict and grade over
        evaluators=[concision, correctness], # The evaluators to score the results
    )
    # This will be cleaned up in the next release:
    feedback = client.list_feedback(
        run_ids=[r.id for r in client.list_runs(project_name=experiment_results.experiment_name)],
        feedback_key="concision"
    )
    scores = [f.score for f in feedback]
assert sum(scores) / len(scores) >= 0.8, "Aggregate score should be at least .8"随时间跟踪结果
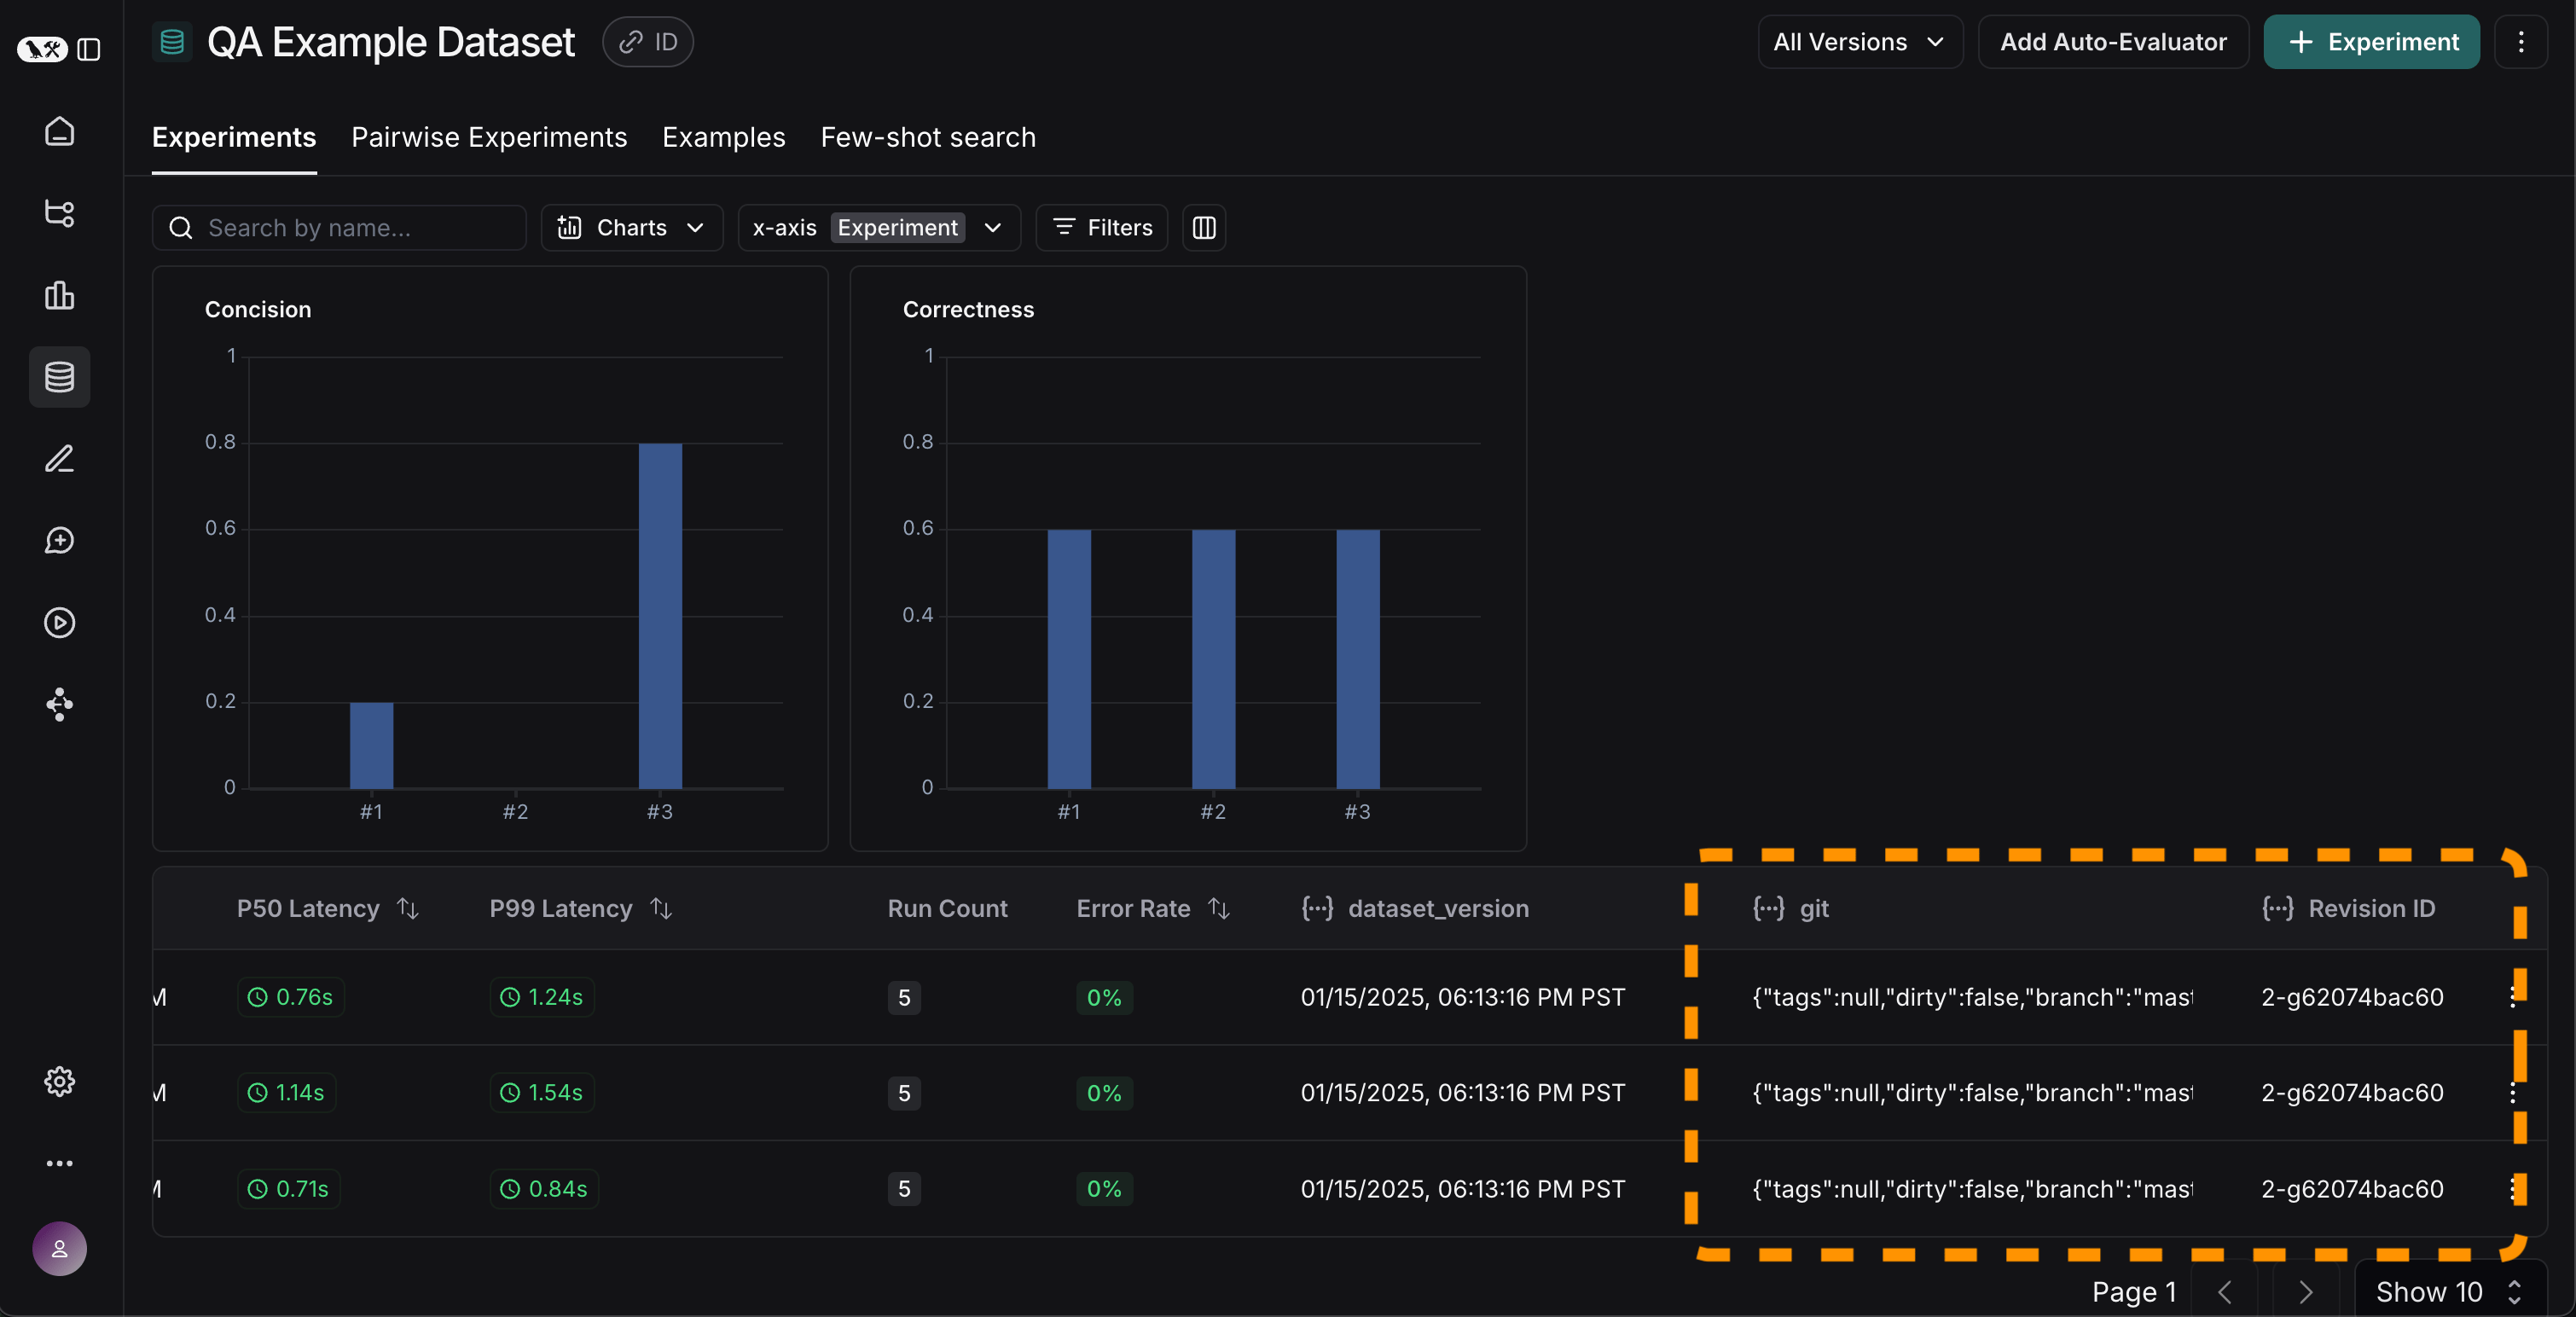
现在我们以自动化方式运行这些实验了,我们想随时间跟踪这些结果。我们可以从数据集页面总体的 Experiments 标签来做这件事。默认情况下,我们显示随时间的评估指标(以红色高亮)。我们还自动跟踪 git 指标,以便轻松地把它与你的代码分支关联(以黄色高亮)。
结论
本教程到此结束!
我们已经介绍了如何创建一个初始测试集、定义一些评估指标、运行实验、手动比较它们、设置 CI/CD,以及随时间跟踪结果。这能帮助你有信心地迭代。
这只是开始。如前所述,评估是一个持续的过程。例如——你想要评估的数据点很可能会持续随时间变化。有许多类型的评估器你可能想去探索。有关这方面的信息,查看操作指南。
此外,除了这种“离线”方式之外,评估数据还有其他方法(例如你可以评估生产数据)。有关在线评估的更多信息,查看设置 LLM-as-a-judge 在线评估器。
参考代码
点击查看合并的代码片段
python
import openai
from langsmith import Client, wrappers

# Application code
openai_client = wrappers.wrap_openai(openai.OpenAI())

default_instructions = "Respond to the users question in a short, concise manner (one short sentence)."

def my_app(question: str, model: str = "gpt-5.4-mini", instructions: str = default_instructions) -> str:
    return openai_client.chat.completions.create(
        model=model,
        temperature=0,
        messages=[
            {"role": "system", "content": instructions},
            {"role": "user", "content": question},
        ],
    ).choices[0].message.content

client = Client()

# Define dataset: these are your test cases
dataset_name = "QA Example Dataset"
dataset = client.create_dataset(dataset_name)

client.create_examples(
    dataset_id=dataset.id,
    examples=[
        {
            "inputs": {"question": "What is LangChain?"},
            "outputs": {"answer": "A framework for building LLM applications"},
        },
        {
            "inputs": {"question": "What is LangSmith?"},
            "outputs": {"answer": "A platform for observing and evaluating LLM applications"},
        },
        {
            "inputs": {"question": "What is OpenAI?"},
            "outputs": {"answer": "A company that creates Large Language Models"},
        },
        {
            "inputs": {"question": "What is Google?"},
            "outputs": {"answer": "A technology company known for search"},
        },
        {
            "inputs": {"question": "What is Mistral?"},
            "outputs": {"answer": "A company that creates Large Language Models"},
        }
    ]
)

# Define evaluators
eval_instructions = "You are an expert professor specialized in grading students' answers to questions."

def correctness(inputs: dict, outputs: dict, reference_outputs: dict) -> bool:
    user_content = f"""You are grading the following question:
{inputs['question']}
Here is the real answer:
{reference_outputs['answer']}
You are grading the following predicted answer:
{outputs['response']}
Respond with CORRECT or INCORRECT:
Grade:"""
    response = openai_client.chat.completions.create(
        model="gpt-5.4-mini",
        temperature=0,
        messages=[
            {"role": "system", "content": eval_instructions},
            {"role": "user", "content": user_content},
        ],
    ).choices[0].message.content
    return response == "CORRECT"

def concision(outputs: dict, reference_outputs: dict) -> bool:
    return int(len(outputs["response"]) < 2 * len(reference_outputs["answer"]))

# Run evaluations
def ls_target(inputs: str) -> dict:
    return {"response": my_app(inputs["question"])}

experiment_results_v1 = client.evaluate(
    ls_target, # Your AI system
    data=dataset_name, # The data to predict and grade over
    evaluators=[concision, correctness], # The evaluators to score the results
    experiment_prefix="openai-4o-mini", # A prefix for your experiment names to easily identify them
)

def ls_target_v2(inputs: str) -> dict:
    return {"response": my_app(inputs["question"], model="gpt-4-turbo")}

experiment_results_v2 = client.evaluate(
    ls_target_v2,
    data=dataset_name,
    evaluators=[concision, correctness],
    experiment_prefix="openai-4-turbo",
)

instructions_v3 = "Respond to the users question in a short, concise manner (one short sentence). Do NOT use more than ten words."

def ls_target_v3(inputs: str) -> dict:
    response = my_app(
        inputs["question"],
        model="gpt-4-turbo",
        instructions=instructions_v3
    )
    return {"response": response}

experiment_results_v3 = client.evaluate(
    ls_target_v3,
    data=dataset_name,
    evaluators=[concision, correctness],
    experiment_prefix="strict-openai-4-turbo",
)