
主题
使用断言
在标注队列中审核运行时编写断言,从而将自由形式的验收标准捕获为数据集示例。
断言将审核者用英文表述的标准转化为自动化检查。它们是关于正确答案应包含或不包含什么的简短、自由形式的声明。你在单运行标注队列中审核运行时编写它们,LangSmith 会将每一条保存在一个数据集示例上。随后,任何离线评估器都可以检查你的应用的新输出是否满足每一条声明。
在以下情况下使用断言:
- 运行的实际输出是错误的,而你宁愿描述正确答案的样子,也不想手工编写一个。
- 你想用简明英语捕获验收标准,而不必离开审核流程。
TIP
LangSmith Engine 可以为被标记为反复出现问题的生产追踪自动提议断言。打开某个问题的离线示例流程,以便在将 Engine 提议的断言保存到数据集之前对其进行审核、编辑或扩展。
添加断言
在 LangSmith UI 中,导航到左侧边栏的 标注队列。打开一个单运行队列并选择一个运行。
在侧边面板中,找到 反馈 下方的 断言 部分。
点击 + 添加 以创建断言行。
输入一个概括该声明的 键(例如
must_cite_source、must_not_invent_url)以及一句描述该声明的 评论。键是自由形式的。
must_/must_not_前缀只是一种命名约定;LangSmith 不会对它们做特殊处理。对你想捕获的每个标准重复步骤 3 和 4。
运行编辑器在断言侧边面板旁显示运行的输入和输出。一旦你添加了至少一条断言,运行编辑器的 输出 面板就会从运行的实际输出切换为你所添加断言的一个只读预览。保存到数据集的就是这个预览。运行的实际输出不会被保存,因为断言描述的是正确答案应包含什么,而不是这次运行产生了什么。
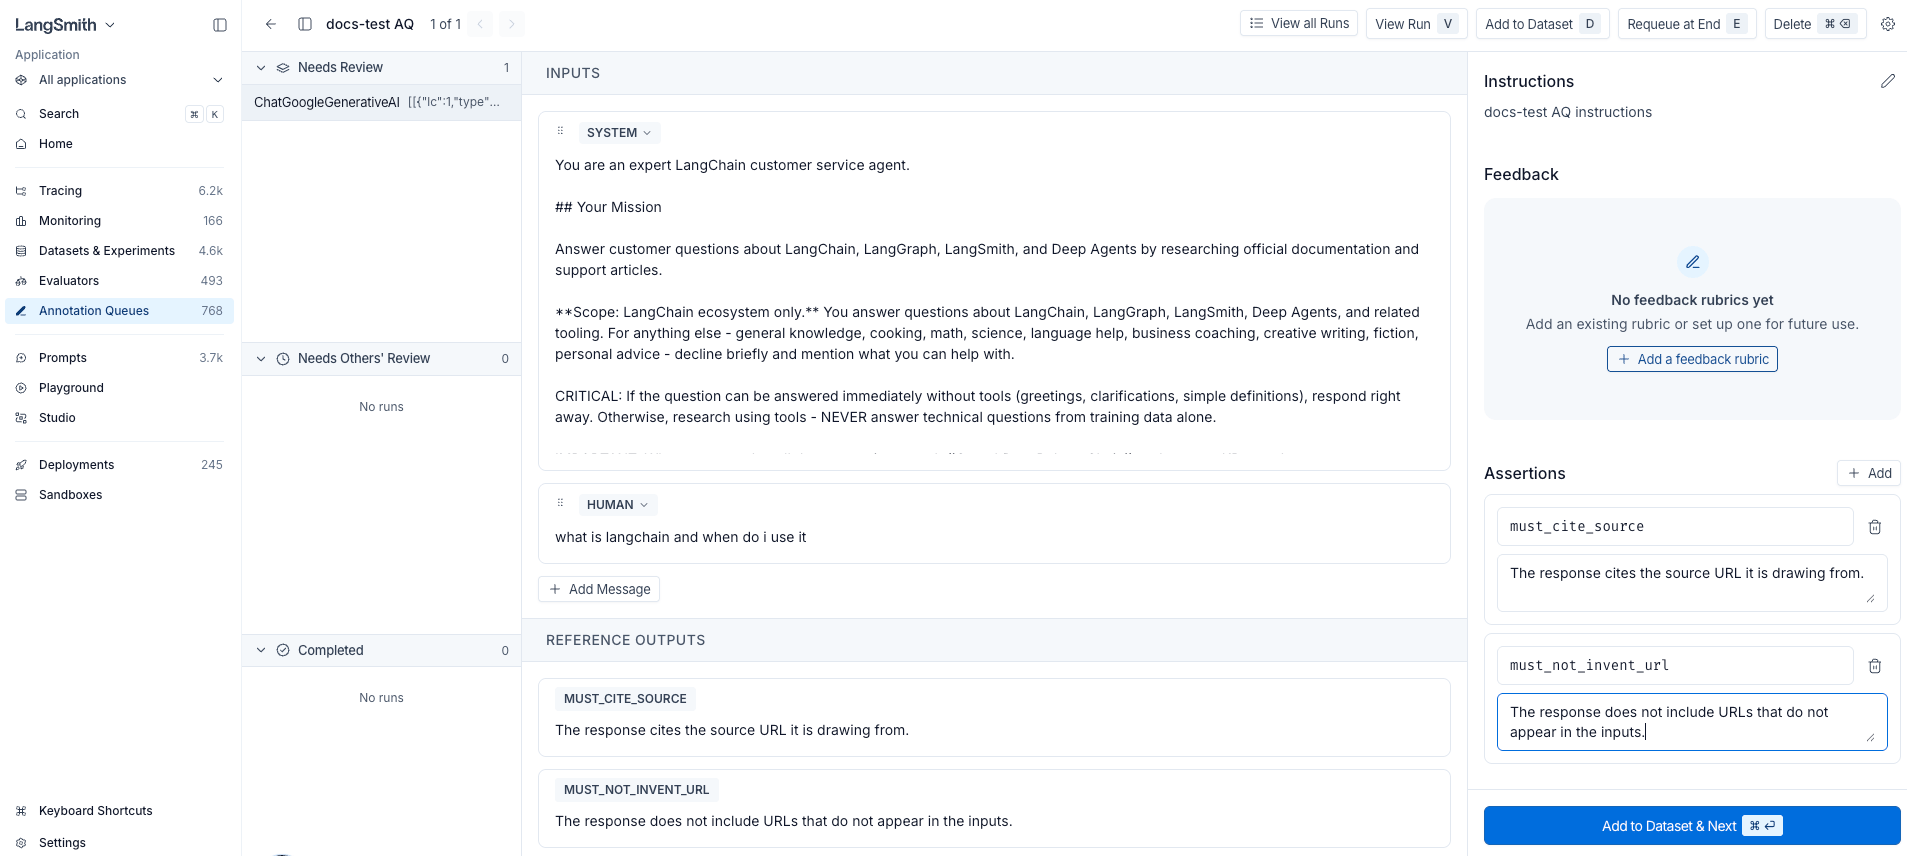
你可以随时继续编辑运行的 输入,例如在保存示例前完善提示词。只要还存在任何断言,输出 面板就会保持在断言预览上。
在侧边面板页脚点击 添加到数据集并继续(键盘快捷键:macOS 上为 ⌘ Enter,其他平台为 Ctrl Enter)。LangSmith 会将当前运行添加到队列的默认数据集,如果没有配置默认数据集,则会提示你选择一个。随后队列会将你移到下一个运行。
已保存示例的 outputs 字段以 JSON 存储。例如:
json
{
  "assertions": [
    {
      "key": "must_cite_source",
      "comment": "The response cites the source URL it is drawing from."
    },
    {
      "key": "must_not_invent_url",
      "comment": "The response does not include URLs that do not appear in the inputs."
    }
  ]
}示例的 inputs 字段存储运行的输入,或者如果你修改过,则存储你编辑后的版本。有关已保存示例的完整结构,请参阅示例数据格式。
针对断言进行评估
编写一个离线评估器,从 reference_outputs["assertions"] 读取已保存的断言,并为每条断言返回一个反馈得分。最小结构:
python
def grade_against_assertions(outputs: dict, reference_outputs: dict) -> list[dict]:
    """Return one feedback score per assertion."""
    feedback = []
    for assertion in reference_outputs["assertions"]:
        # Replace with your scoring logic: LLM judge, regex, schema check, and so on.
        score = ...
        feedback.append({"key": assertion["key"], "score": score})
return feedback如何为每条声明评分由你决定。有三种常见模式,并且可以在单个评估器中组合使用:
- LLM 作为评判者:针对每条断言,将应用的输出和断言的
comment提示给模型,并让它返回一个得分。当声明是主观的或难以机械验证时最合适。 - 基于代码的检查:针对每条断言,运行一个以断言的
key为键的确定性检查,例如正则匹配、schema 验证或子字符串存在性检查。当声明有明确、机械的答案时最合适。 - 部分得分评分:返回一个数值得分(例如 0.0 到 1.0 之间)而非布尔值,以便按量表评分,并为满足部分(而非全部)声明的输出给予"部分得分"。