
主题
模型回退
当主模型触发速率限制、错误或返回其他配置的状态码时,自动针对备份模型重试请求。
NOTE
LLM Gateway 处于 beta 阶段。
当主模型返回配置的错误(例如速率限制或提供程序中断)时,模型回退会针对一个或多个备份模型重试请求。在 LangSmith 中定义一次回退顺序,然后在应用中继续使用标准 LLM Gateway 端点和模型 ID。
工作原理
回退链包含:
- 主模型:在请求失败时触发链的提供程序和模型。
- 一到五个回退:直接提供程序模型或已保存模型配置的有序列表。
- 触发器:将请求移至下一个模型的上游 HTTP 状态码。例如,使用
429表示速率限制,或使用500、502、503和504表示提供程序错误。
对于每个请求,网关会:
- 调用由请求的提供程序前缀模型 ID 选择的主模型。
- 如果请求因配置的触发状态或传输错误而失败,则加载匹配的回退链。
- 按顺序调用每个回退,直到其中一个成功、返回不触发另一个回退的状态,或链已耗尽。
- 以客户端使用的 API 格式返回最终响应。
回退可以使用与主模型不同的提供程序和 API 格式。网关会在支持的 API 格式之间转换请求和响应,因此 Anthropic 主模型可以回退到 OpenAI 模型,而无需更改客户端。
每次尝试都会单独追踪并计入支出策略。使用两个回退的请求会记录三次模型调用:主尝试和两次回退尝试。
创建回退链
WARNING
创建和管理回退链需要 organization:manage 权限。有关完整的权限细分,请参阅访问控制。
要创建回退链:
- 转到 LLM Gateway 并选择 Model Fallbacks 选项卡。
- 点击 Create fallback chain。
- 选择链适用的 Workspace。
- 选择主提供程序和模型。对此提供程序前缀模型 ID 的请求会在主尝试失败时使用该链。
- 在 Fallbacks 下,按网关应尝试的顺序添加一到五个备份模型。直接选择提供程序和模型、选择现有模型配置,或创建自定义模型配置。
- 在 Configure fallback triggers (advanced) 下,查看应触发下一个回退的 HTTP 状态码。根据需要添加或删除状态码。
- 点击 Create chain。
一个提供程序和模型在每个工作区中可以有一个回退链。要更改其行为,请编辑现有链。
发起调用
使用主提供程序前缀模型 ID 调用标准 LLM Gateway 端点。你不需要特定于路由的 URL 或额外的请求字段:
bash
curl https://gateway.smith.langchain.com/v1/chat/completions \
    -H "Authorization: Bearer $LANGSMITH_API_KEY" \
    -H "Content-Type: application/json" \
-d '{"model":"anthropic/claude-opus-5","messages":[{"role":"user","content":"Hello!"}]}'bash
curl https://<data_plane_host>/gateway/v1/chat/completions \
    -H "Authorization: Bearer $LANGSMITH_API_KEY" \
    -H "Content-Type: application/json" \
-d '{"model":"anthropic/claude-opus-5","messages":[{"role":"user","content":"Hello!"}]}'网关会应用 API 密钥所在工作区中为 anthropic/claude-opus-5 配置的回退链。如果没有匹配的链,网关会返回主模型的响应,而不尝试回退。
为提示设置回退
要让提示拥有自己的回退链,请通过已保存的模型配置进行路由。提示按名称引用配置,而网关管理其回退链。
创建配置需要工作区管理员权限。创建回退链需要 organization:manage 权限。
要为提示配置回退:
创建模型配置,指向你希望提示使用的提供程序和模型。
在同一工作区中创建回退链。选择已保存的配置作为主模型,而不是直接选择其底层提供程序和模型。添加备份模型、配置触发器并保存链。
在 Playground 中创建提示。打开 Model Configuration,选择 LangSmith Gateway 作为 Provider,并在 Model 字段中输入
custom/<my_config_name>。将<my_config_name>替换为已保存配置的名称,不带尖括号。即使未列出该值,你也可以输入它。点击 Apply。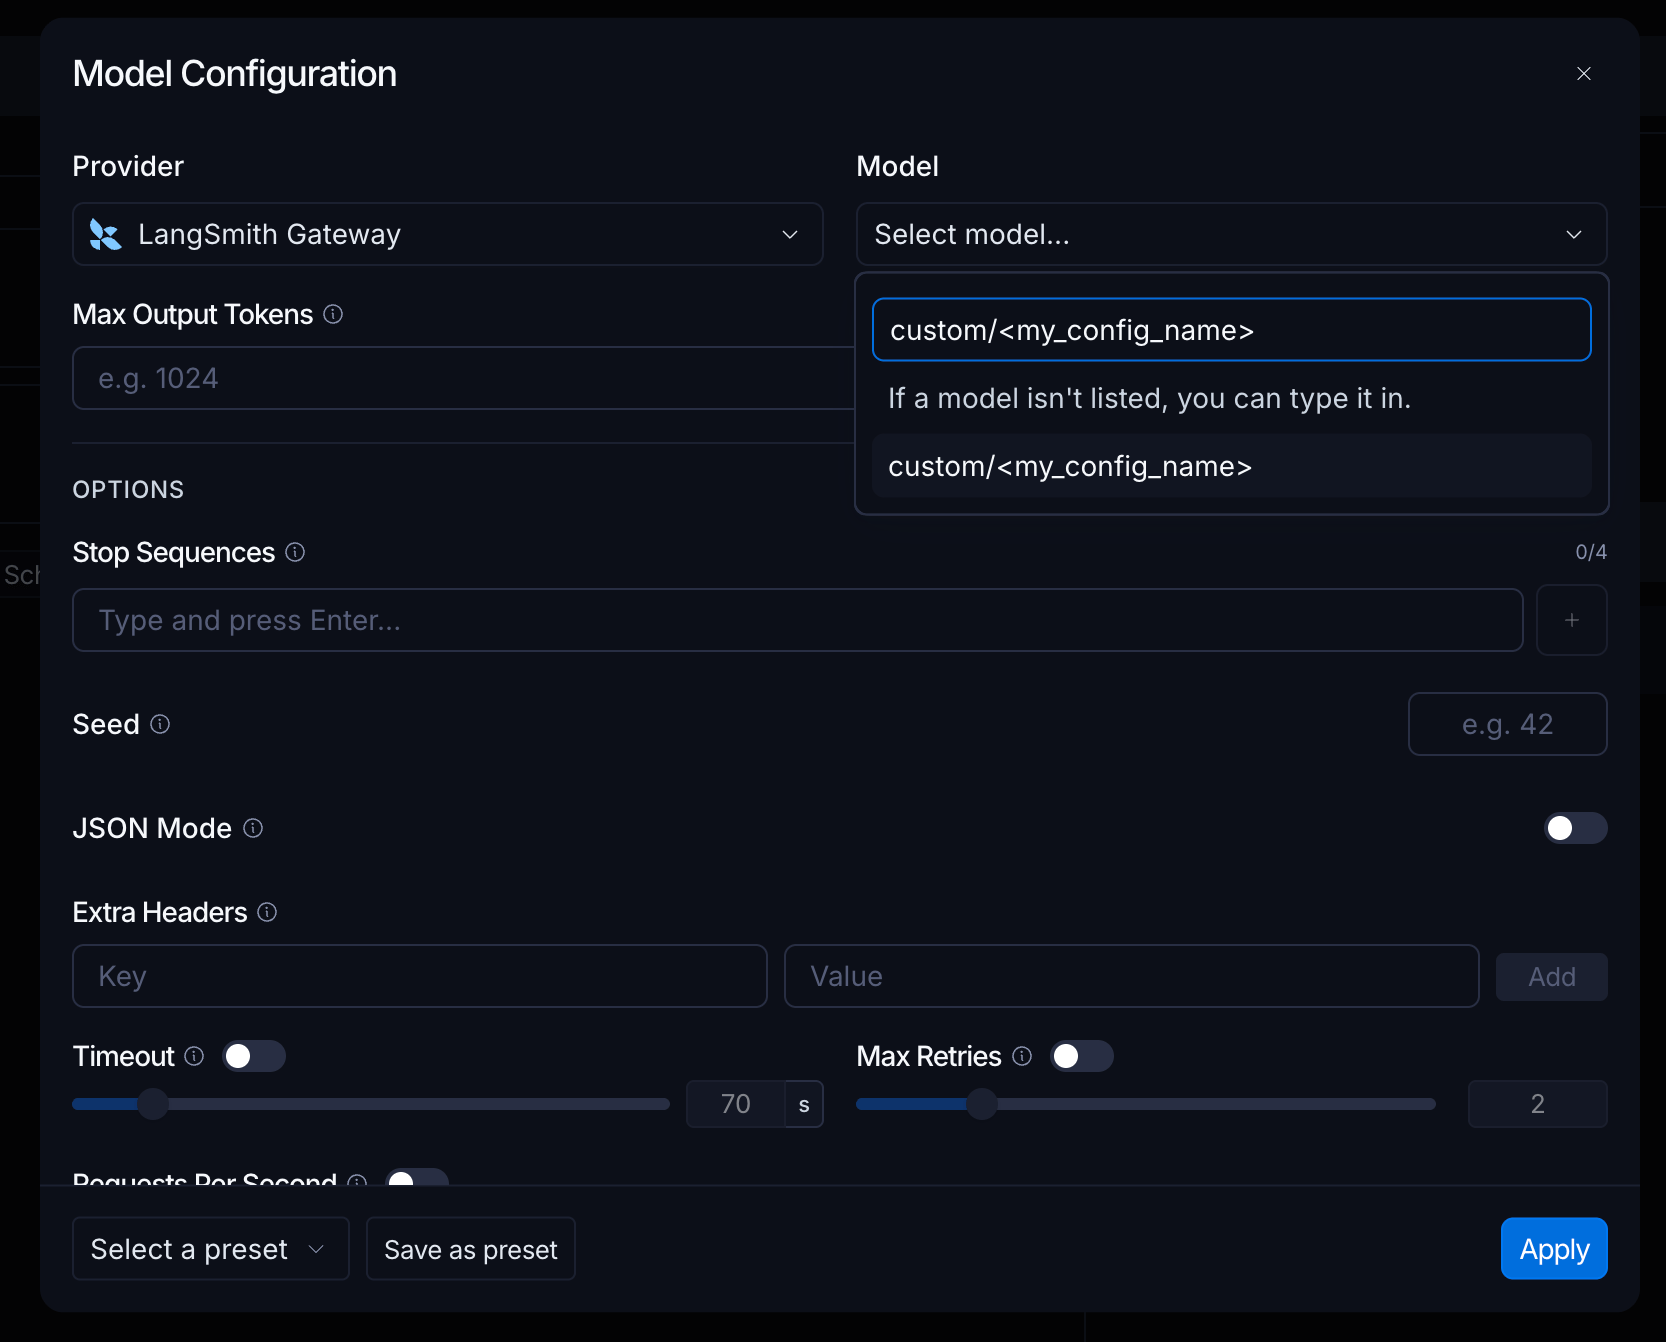 entered in the Model field." width="1666" height="1342" srcset="https://mintcdn.com/langchain-5e9cc07a/fF0qKKSfCv3bTXzB/images/llm-gateway-prompt-model-configuration.png?w=280&fit=max&auto=format&n=fF0qKKSfCv3bTXzB&q=85&s=79a50cf221f5eb09fe191d57b8e44b6e 280w, https://mintcdn.com/langchain-5e9cc07a/fF0qKKSfCv3bTXzB/images/llm-gateway-prompt-model-configuration.png?w=560&fit=max&auto=format&n=fF0qKKSfCv3bTXzB&q=85&s=b4facd8d11976a0e16491f504621a1e6 560w, https://mintcdn.com/langchain-5e9cc07a/fF0qKKSfCv3bTXzB/images/llm-gateway-prompt-model-configuration.png?w=840&fit=max&auto=format&n=fF0qKKSfCv3bTXzB&q=85&s=50976e2d807a4197cb20caef32b359ab 840w, https://mintcdn.com/langchain-5e9cc07a/fF0qKKSfCv3bTXzB/images/llm-gateway-prompt-model-configuration.png?w=1100&fit=max&auto=format&n=fF0qKKSfCv3bTXzB&q=85&s=d73ba952cfc1c72775a054cac1596370 1100w, https://mintcdn.com/langchain-5e9cc07a/fF0qKKSfCv3bTXzB/images/llm-gateway-prompt-model-configuration.png?w=1650&fit=max&auto=format&n=fF0qKKSfCv3bTXzB&q=85&s=15789b603483839b77f12171d3e2854b 1650w, https://mintcdn.com/langchain-5e9cc07a/fF0qKKSfCv3bTXzB/images/llm-gateway-prompt-model-configuration.png?w=2500&fit=max&auto=format&n=fF0qKKSfCv3bTXzB&q=85&s=7090e50a3520f0a0ad7c5fcbfbe22fcf 2500w" />
保存提示,然后连同其模型一起拉取。在 Python 中,调用
client.pull_prompt时设置include_model=True,以便包含已保存的 Gateway 模型配置。
使用其已保存模型调用拉取的提示,以通过网关发送请求并应用配置的回退链。仅拉取提示模板不会包含模型配置。
回退链属于模型配置,而不是提示本身。引用同一配置的提示会共享其回退。为每个需要不同回退行为的提示使用单独的配置。
选择回退候选
你可以添加两类回退候选:
- 直接提供程序模型:选择受支持的网关提供程序和模型。此选项使用工作区中该提供程序的密钥,或对符合条件的托管模型使用 Gateway Credits。
- 模型配置:选择已保存的工作区模型配置。此选项用于自定义 OpenAI 兼容或 Anthropic 端点、自定义模型名称或配置特定参数。
模型配置是工作区作用域的。回退链只能使用其所选工作区中的配置。
例如,将 anthropic/claude-opus-5 配置为主模型,openai/gpt-5.4-mini 配置为第一个回退,并将已保存的 OpenAI 兼容模型配置配置为第二个回退。应用继续请求 anthropic/claude-opus-5;网关会在需要时选择并转换回退调用。