
主题
用 Insights 发现错误与使用模式
用 LangSmith Insights 自动分析追踪、检测使用模式、识别常见的 agent 行为,并在无需人工审阅追踪的情况下浮现失败模式。
Insights 自动分析你的追踪以检测使用模式、常见 agent 行为和失败模式,因此你无需手动审阅成千上万条追踪。
Insights 用层级分类来理解你的数据并突出可行动的趋势。
NOTE
Insights 适用于 LangSmith Plus 和 Enterprise 方案。
前置条件
- 在你的工作区中为 Insights 设置好的模型配置。
- 在 LangSmith 中创建规则的权限(生成新的 Insights Report 所必需)。
- 查看 LangSmith 中追踪项目的权限(查看现有 Insights Report 所必需)。
生成你的第一个 Insights 报告
NOTE
用 OpenAI 模型对 1,000 个线程生成洞察通常花费 $1.00-$2.00,用当前 Anthropic 模型花费 $3.00-$4.00。成本随采样线程数及每个线程的大小而缩放。
理解结果
一旦你的作业完成,你可以导航到 Insights 标签,那里会看到一个 Insights Report 表格。每个报告都包含在追踪项目一组特定追踪样本上生成的洞察。
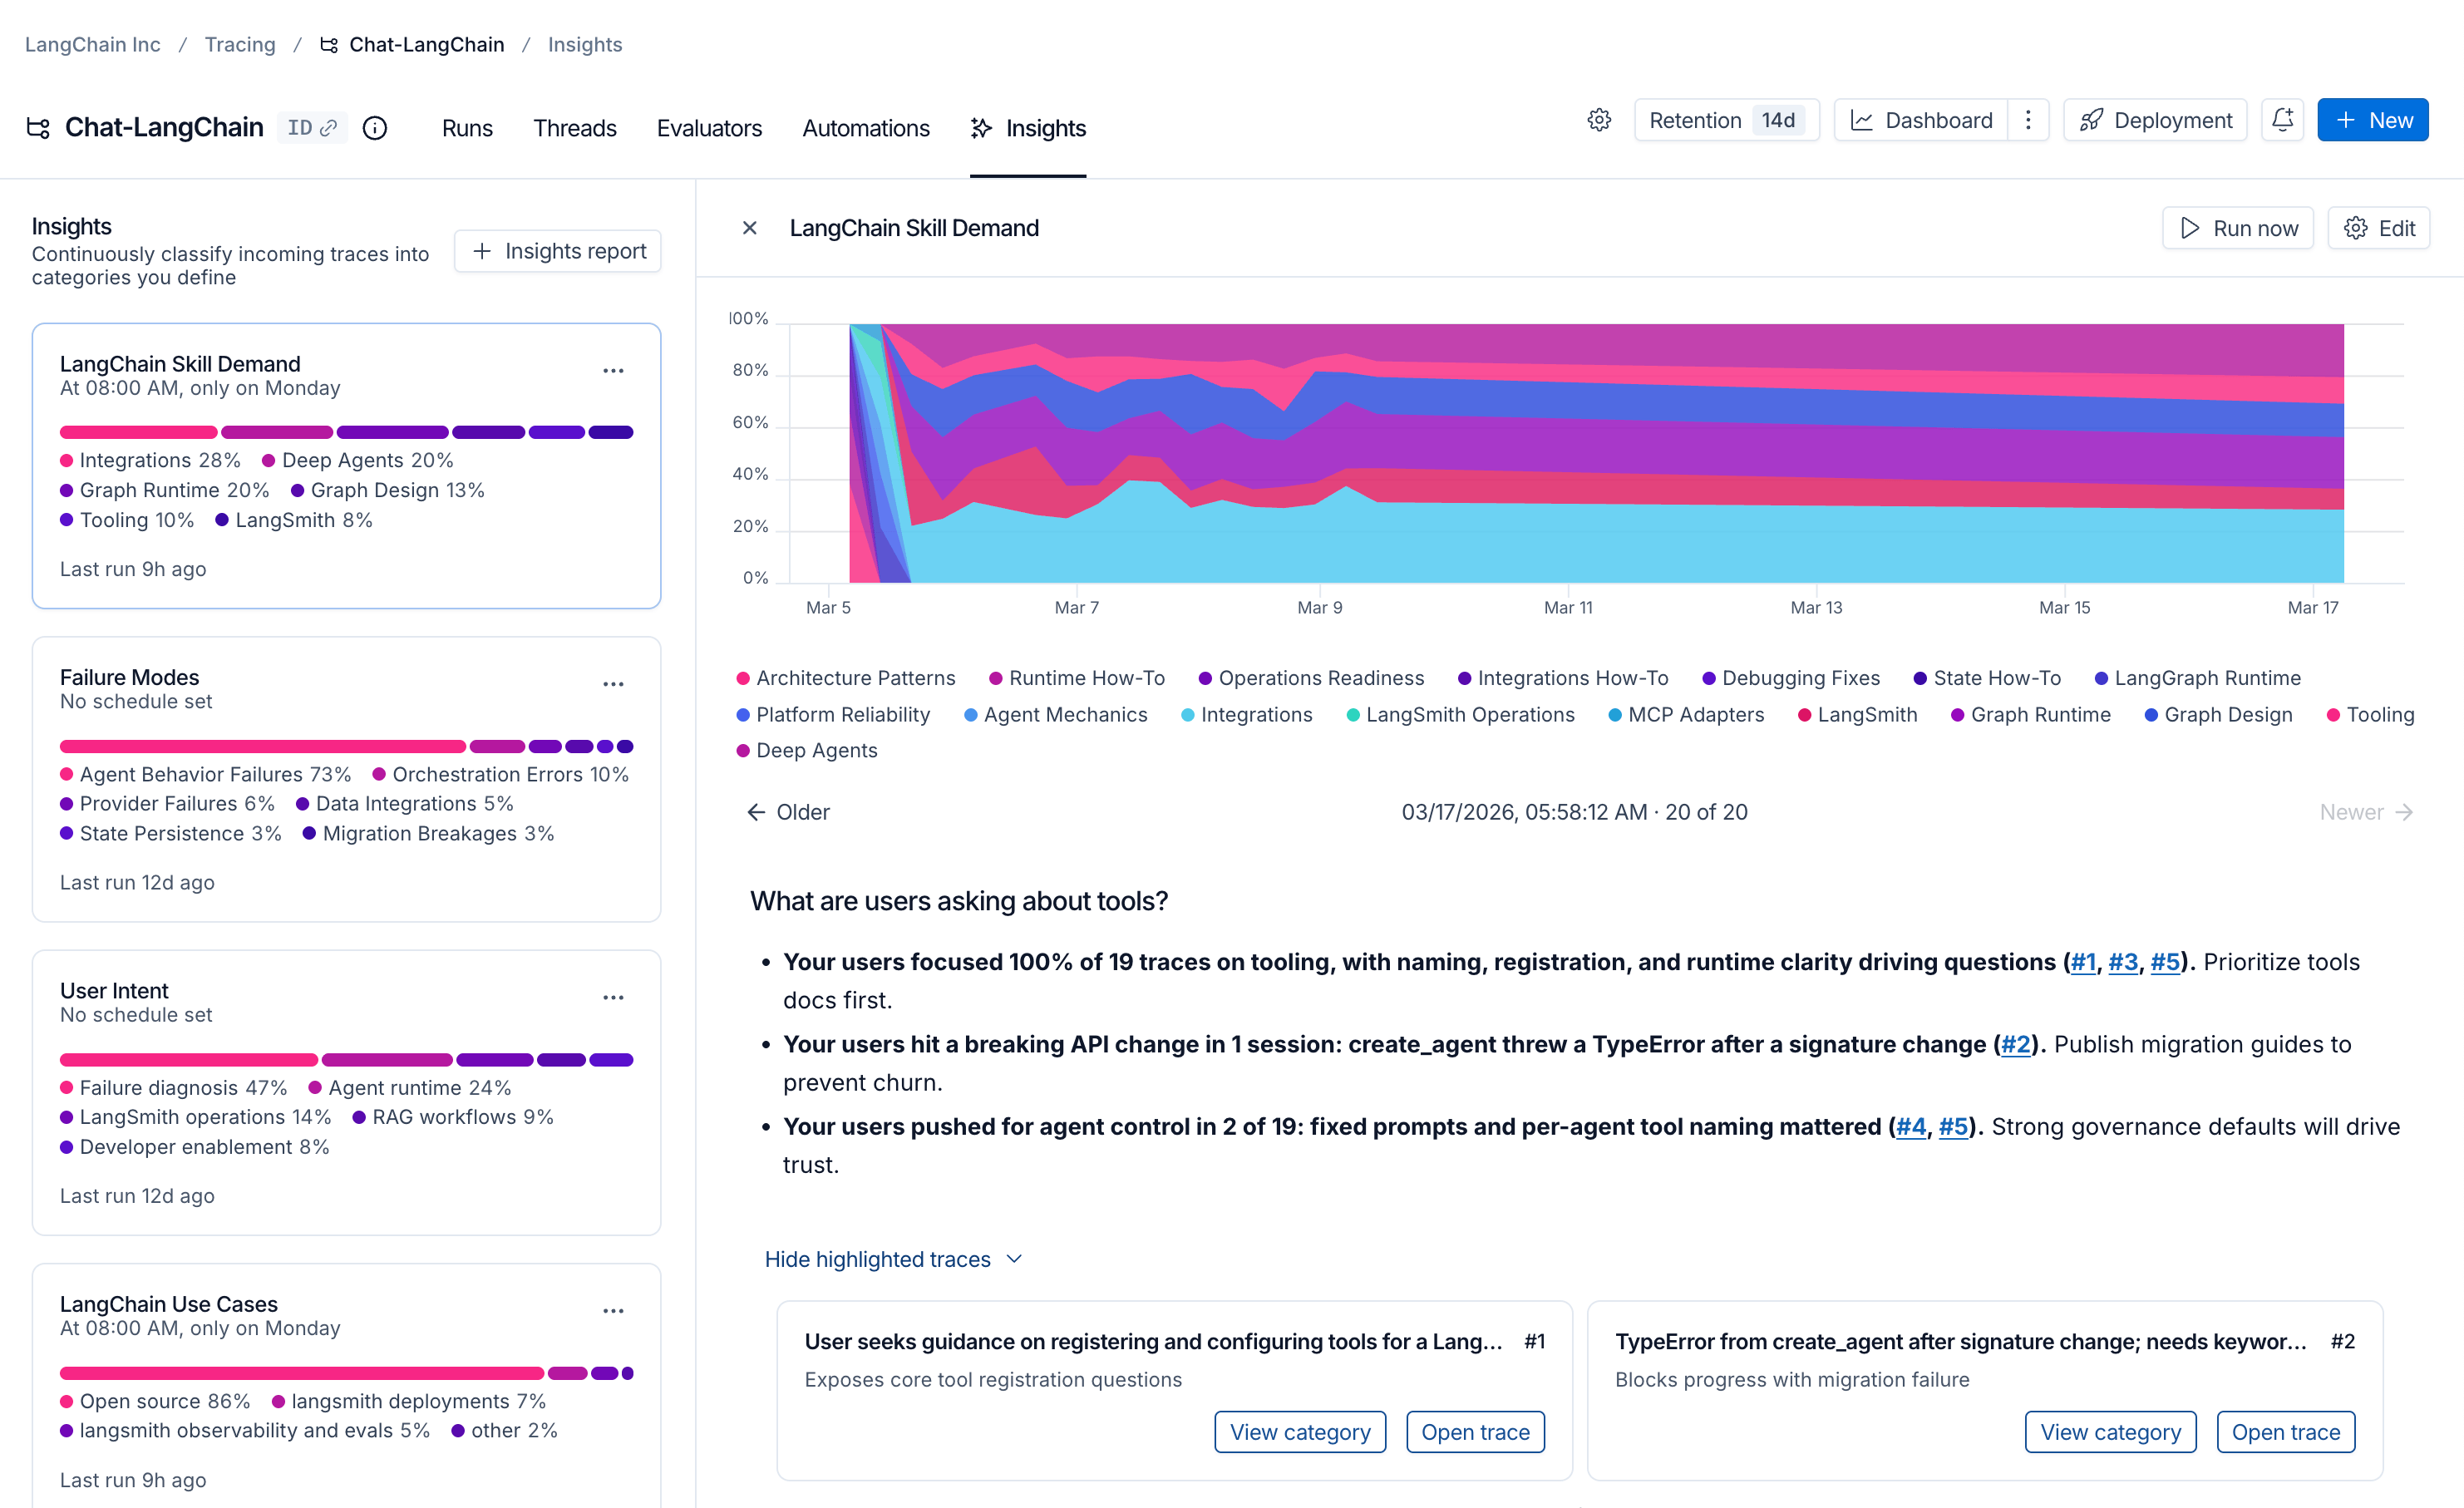
点入你的作业,查看被组织成一组自动生成类别的追踪。
你可以透过类别和子类别钻取,以查看底层追踪、反馈和运行统计。
执行摘要
在每个报告的顶部,你会找到一份执行摘要,它浮现你追踪中发现的最重要模式。这包括:
- 带百分比的关键发现,显示每个模式出现的频率。
- 指向 agent 认定与你问题特别相关之追踪的可点击引用(例如 #1、#2、#3)。
顶层类别
你的追踪被自动分组到代表你数据中最广泛模式的顶层类别。
分布条显示每个模式发生的频率,便于发现那些发生得比预期多或少的行为。
每个类别都有一个简短描述,并在其包含的追踪上展示聚合指标,包括:
- 典型追踪统计(如错误率、延迟、成本)
- 来自你评估器的反馈分数
- 作为作业一部分提取的属性
子类别
点击任何类别都会展示到子类别的细分,让你对那类追踪中的交互模式有更细粒度的理解。
在 Chat Langchain 示例中,在 Data & Retrieval 下有 Vector Stores 和 Data Ingestion 等子类别。
单条追踪
你可以通过点入查看追踪表格,来查看被分配到每个类别或子类别的追踪。从那里,你可以点入任何追踪查看完整的对话详情。
配置一个作业
你可以用自动生成流或手动配置来创建一个 Insights Report。
自动生成一个配置
- 打开 New Insights 并确保 Auto 切换处于激活状态。
- 回答关于你 agent 用途、你想学到什么、以及追踪如何结构的自然语言问题。Insights 会把你的答案转化为一个草稿配置(作业名、摘要提示、属性和采样默认值)。
- 选择一个提供商,然后点击 Generate config 预览,或 Run job 立即启动。
提供有用的上下文
为获得最佳结果,为每个提示写一两句话,给 Insights 它所需的上下文——你想学到什么、哪些信号或字段最重要,以及你已经知道不具用的任何东西。你对你的 agent 做什么及其追踪如何结构说得越清楚,Insights 就能越把示例以具体、可行动、与你思考数据的方式对齐来分组。
描述你的追踪
解释你的数据如何组织:这些是单次运行还是多轮对话?哪些输入和输出包含关键信息?这帮助 Insights 生成聚焦于关键内容的摘要提示和属性。如有需要,你也可以直接指定摘要提示一节中的变量。
选择模型
Insights 使用两个模型:
- 思考模型:执行聚类步骤(更有能力,成本更高)。
- 摘要模型:生成逐追踪摘要(更快,成本更低)。
两个模型都从你在工作中配置的提供商中选取。当具体模型已在你的模型配置中为 Insights 启用时,你可以单独选择它们。若未配置单独的模型,你选择一个提供商(OpenAI 或 Anthropic),Insights 为该提供商使用默认模型。
为获得最佳结果,两个角色都使用同一提供商的模型。
手动配置
手动配置给你更多控制——例如,预定义你想把数据分组进的那些类别,或针对匹配特定反馈分数和过滤器的追踪。
选择追踪
- 采样大小:要分析的最大追踪数(1,000 上限)。
- 时间范围:追踪从该时间范围采样。
- 过滤器:额外的追踪过滤器。当你调整过滤器时,你会看到多少追踪匹配你的条件。
类别
默认情况下,顶层类别从底层追踪自下而上自动生成。
在某些情形中,你预先就知道你感兴趣的具体类别,并希望作业把追踪分入那些预定义类别。
配置的 Categories 部分通过枚举你想使用的顶层类别的名称和描述来让你做到这一点。
子类别仍由算法在预定义顶层类别内自动生成。
当一个作业完成时,发现到的顶层类别会自动保存回配置——但仅当配置之前未定义类别时。这意味着后续调度运行会复用那些类别以保持一致。
摘要提示
作业的第一步是为每条追踪创建一个简短摘要。这些摘要随后被分类。
在摘要中提取正确的信息,对获得有用的类别至关重要。
你可以编辑用于生成这些摘要的提示。编辑提示时要考虑的两件事是:
- 摘要指令:任何不在追踪摘要中的信息都不会影响所生成的类别,因此确保提供清晰指令,说明要从每条追踪提取哪些重要信息。
- 追踪内容:用 mustache 格式指定每条追踪的哪些部分被传给摘要器。带大量输入和输出的大追踪可能既昂贵又嘈杂。把提示缩减为只包含追踪中最相关的部分可以改善你的结果。
你必须使用至少以下模板变量之一指定把每条追踪的哪些部分传给摘要器:
| 变量 | 描述 | 示例 |
|---|---|---|
run.inputs | 最近一次根运行的输入 | {run.inputs} |
run.outputs | 最近一次根运行的输出 | {run.outputs} |
run.error | 若运行失败的错误字符串 | {run.error} |
run.feedback | 作为一个 JSON 块的所有反馈分数 | {run.feedback} |
run.feedback.<key> | 按键的特定反馈分数 | {run.feedback.correctness} |
all_thread_messages | 线程的完整消息历史(仅对有线程的项目可用) | {all_thread_messages} |
你可以用点符号访问嵌套字段。例如,{run.inputs.foo.bar} 只包含最后一次运行输入中 foo 内的 bar 字段。
NOTE
对有线程的项目,Insights 分析完整对话。run.* 变量只用每个线程中最近一次的根运行。用 all_thread_messages 访问完整的对话历史。
属性
除摘要外,你还可以定义额外的字符串、数值和布尔属性,从每条追踪中提取。 这些属性会影响聚类步骤——具有相似属性值的追踪倾向于被分在一起。 你还可以看到每个类别下这些属性的聚合。
作为一个例子,你可能想从每条追踪提取属性 user_satisfied: boolean,以将算法导向拆分正面与负面用户体验的类别,并查看每个类别的平均用户满意度。
过滤属性
你可以在布尔属性上用 filter_by 参数,在生成洞察之前预过滤追踪。启用时,只有该属性求值为 true 的追踪被纳入分析。
当你想把 Insights Report 聚焦于追踪的一个特定子集时,这很有用。例如,只分析错误、只查看英语对话,或只包含满足某些质量标准的追踪。
工作原理:
- 在为 Insights 创建配置时,向任何布尔属性添加
"filter_by": true。 - 在摘要期间,LLM 根据属性描述评估每条追踪。
- 在生成洞察之前,属性为
false或缺失的追踪被排除。
调度 Insights 报告
调度 Insights 报告以定期自动运行。在创建或编辑配置时,用 Schedule 部分选择:
- 每日:每天 8:00 UTC 运行。
- 每周一:每周一 8:00 UTC 运行。
- 自定义:输入你自己的 cron 表达式(UTC)。
每次调度运行都用你保存的配置生成一个新报告。时间范围动态计算。例如,“最近 24 小时”总分析执行时最近的 24 小时窗口。
保存你的配置
你可以选择用 Save as 按钮保存配置以供日后复用。 如果你想随时间比较 Insights Report 以识别用户和 agent 行为的变化,这尤其有用。
在创建新 Insights Report 时,从面板左上角的下拉菜单中选择先前保存的配置。