
主题
模型服务商
Playground 支持广泛的模型提供商。你能选择一个提供商、配置你偏好的设置,并保存这些配置以跨多个提示复用。
用本页获取可用提供商及其配置选项的清单:

<img src="/langsmith-img/33f05ec60a74.svg" width="65" height="65" />

<span class="font-semibold">Amazon Bedrock</span>

<img src="/langsmith-img/dd3a9d4f357e.svg" width="65" height="65" />

<span class="font-semibold">Anthropic</span>

<img src="/langsmith-img/b8ff77be3fbc.svg" width="65" height="65" />

<span class="font-semibold">Azure OpenAI</span>

<img src="/langsmith-img/f8f37324c14c.svg" width="65" height="65" />

<span class="font-semibold">DeepSeek</span>

<img src="/langsmith-img/d1667d049778.svg" width="65" height="65" />

<span class="font-semibold">Fireworks</span>

<img src="/langsmith-img/2a5bc66b8828.svg" width="65" height="65" />

<span class="font-semibold">Google Gemini</span>
<img src="/langsmith-img/2a5bc66b8828.svg" width="65" height="65" />

<span class="font-semibold">Gemini Enterprise Agent Platform</span>

<img src="/langsmith-img/6b6eefe6b018.svg" width="65" height="65" />

<span class="font-semibold">Groq</span>

<img src="/langsmith-img/b6dbd6317fe4.svg" width="65" height="65" />

<span class="font-semibold">Mistral AI</span>

<img src="/langsmith-img/509caa1c58b1.svg" width="65" height="67" />

<span class="font-semibold">OpenAI</span>
<span class="font-semibold">OpenAI compatible endpoint</span>

<img src="/langsmith-img/aec07ee7b866.svg" width="65" height="65" />

<span class="font-semibold">XAI</span>
关于创建和管理模型配置的详情,参阅配置提示设置页。
Amazon Bedrock
在使用此模型之前,确保你有 AWS 凭据、一个 IAM 角色,或一个 Amazon Bedrock API 密钥。
认证
Amazon Bedrock 支持三种身份验证方法。IAM 可信实体是推荐的做法,因为它避免与 LangSmith 共享长命 AWS 访问密钥。
IAM 可信实体(推荐)
NOTE
不适用于自托管 LangSmith 或 BYOC。 请改用访问密钥或 Bedrock API 密钥。
用 IAM 可信实体身份验证,你在你的 AWS 账户中创建一个 IAM 角色并允许 LangSmith 承担它。LangSmith 中不存访问密钥。取而代之,LangSmith 用 AWS STS 在每个请求上承担该角色。
要设置这一点:
- 在你的 AWS 账户中创建一个 IAM 角色,带调用 Bedrock 模型的权限(例如
bedrock:InvokeModel)。 - 添加一个信任策略,允许 LangSmith 的 AWS 账户(
808407022534)承担该角色,并用你的 LangSmith 工作区 ID 作为外部 ID:
json
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Effect": "Allow",
      "Principal": {
        "AWS": "arn:aws:iam::808407022534:root"
      },
      "Action": "sts:AssumeRole",
      "Condition": {
        "StringEquals": {
          "sts:ExternalId": "<your-langsmith-workspace-id>"
        }
      }
    }
  ]
}TIP
你能在 LangSmith 工作区设置 中找到你的工作区 ID。
在 LangSmith Playground 中,点击 Key 图标打开 Bedrock 提供商的机密配置(IAM Trusted Entity 选项在模型配置下拉菜单本身中不可用)。然后展开 IAM Trusted Entity 一节并输入你创建的那个角色的 ARN。
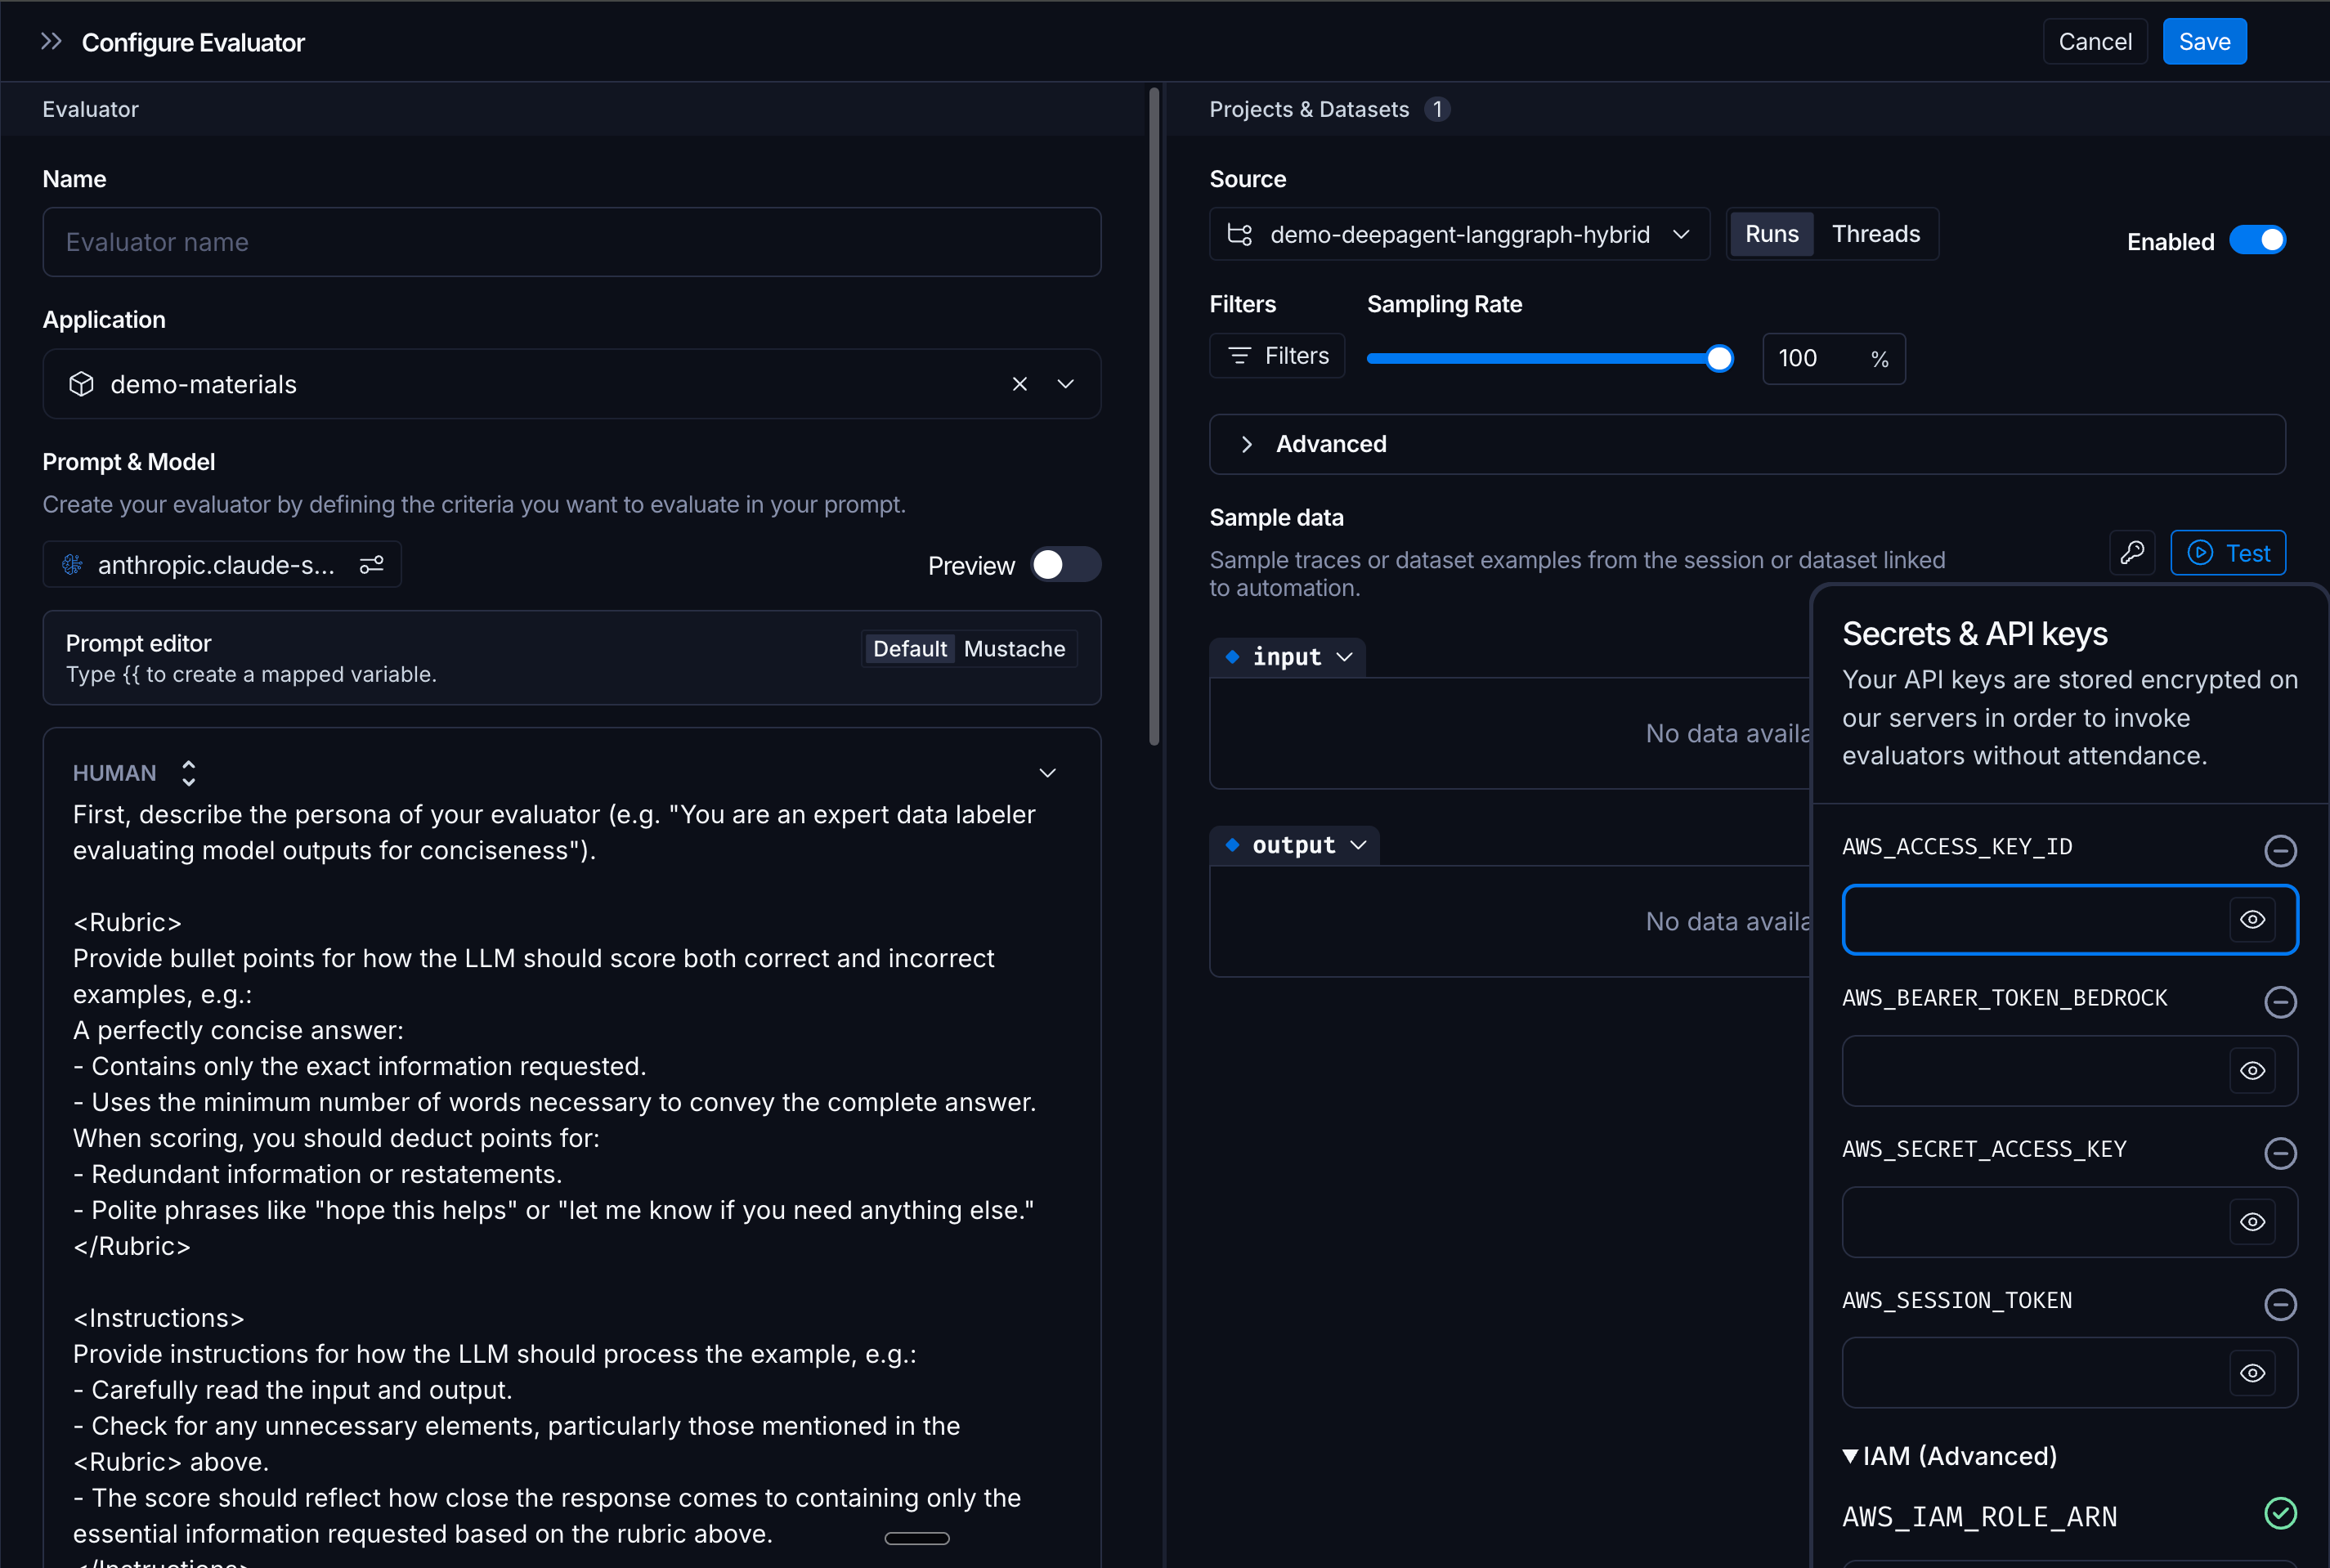
关于信任策略的更多细节,见 AWS 文档。
访问密钥
或者,你能用 AWS 访问密钥(AWS_ACCESS_KEY_ID 和 AWS_SECRET_ACCESS_KEY)身份验证。在 Playground 的 Bedrock 提供商配置中输入这些。这种方法设置更简单但更不安全,因为它需要存储长命凭据。
Bedrock API 密钥
Bedrock API 密钥用一个 bearer 令牌而非 AWS 凭据对请求身份验证。要配置一个 Bedrock API 密钥:
- 在 Amazon Bedrock 控制台生成一个 API 密钥。
- 在 LangSmith 中,前往 Settings > Provider Secrets,添加一个新机密,并选择 Amazon Bedrock 作为提供商。
- 在 Authentication 下选择 Bearer token。
- 把 API 密钥作为
AWS_BEARER_TOKEN_BEDROCK输入。 - (可选)设
AWS_BEDROCK_REGION。默认为us-east-1。 - 选择 Save。
可用模型
AWS Bedrock 提供对来自多个提供商的基础模型的访问:
- Anthropic: Claude 模型。
- Amazon: Titan 模型。
- Cohere: Command 模型。
- Meta: Llama 模型。
- 其他: 依据区域可用的额外提供商。
当前可用模型的清单,参阅 AWS Bedrock 文档。
配置参数
参数取决于底层模型提供商:
对于 Anthropic 模型
使用 Anthropic 配置(见下方 Anthropic 一节)。
对于 Amazon Titan
| 参数 | 范围 | 描述 |
|---|---|---|
| Temperature | 0.0 - 1.0 | 响应随机性 |
| Max Tokens | 1+ | 最大响应长度 |
| Top P | 0.0 - 1.0 | 核采样 |
AWS 专属设置
- Region: 模型部署的 AWS 区域。
工具调用
取决于底层模型:
- Anthropic 模型:
auto、any。 - Cohere 模型:
auto。
Anthropic
在使用此模型之前,确保你有一个 Anthropic API 密钥。
可用模型
Anthropic 在其各代 Claude 中提供三档模型:
- Opus: 最高的智能与能力。
- Sonnet: 平衡的性能与成本。
- Haiku: 快速且具成本效益。
较新的 Claude 模型支持扩展思考能力,用于展示推理过程。
当前可用模型的清单,参阅 Anthropic 文档。
配置参数
| 参数 | 范围 | 默认 | 描述 |
|---|---|---|---|
| Temperature | 0.0 - 1.0 | 可选 | 随机性控制(取消勾选以用模型默认) |
| Max Output Tokens | 1+ | 1024 | 最大响应长度 |
| Top P | 0.0 - 1.0 | 可选 | 核采样(取消勾选以用模型默认) |
| Top K | 1+ | 可选 | 限制到前 K 个 token(取消勾选以用模型默认) |
NOTE
Temperature、Top P 和 Top K 是可选的。取消勾选时,Claude 用它内部的默认值。
扩展思考
在受支持的 Claude 模型上可用。让模型在响应之前展示推理,类似于 OpenAI 的 o 系列。
| 参数 | 范围 | 描述 |
|---|---|---|
| Enable Extended Thinking | 切换 | 显示/隐藏思考过程 |
| Budget Tokens | 1+ | 思考的最大 token(默认:1024) |
启用时,响应包含:
- 一个带模型推理的 "thinking" 段。
- 最终响应。
高级选项
- Base URL: 为自定义部署覆盖 API 端点。
工具调用
- Supported Tool Choices:
auto、any(至少需要一个工具)。 - Parallel Execution: 否(仅顺序)。
Azure OpenAI
在使用此模型之前,创建一个 Azure OpenAI 资源和模型部署。
认证
API 密钥
在 Azure OpenAI 提供商配置中,输入你的端点、部署名、API 版本和 API 密钥。
自托管 LangSmith 的 workload identity
NOTE
Azure OpenAI workload identity 需要在 Azure Kubernetes Service(AKS)上的自托管 LangSmith 0.16.58 或更高。
用 AKS workload identity 在不存 API 密钥的情况下身份验证:
- 在你的 AKS 集群上启用 OIDC 发行者和 workload identity。
- 创建或选择一个用户分配的托管身份。
- 向该托管身份添加一个联合身份凭据。用 AKS OIDC 发行者和受众
api://AzureADTokenExchange。把它的 subject 设为system:serviceaccount:<namespace>:<playground-service-account-name>。 - 给该托管身份指派最小权限的
Cognitive Services OpenAI User角色。把角色作用域到 Azure OpenAI 资源。见 Azure OpenAI 基于角色的访问控制。 - 把以下值添加到你的 LangSmith Helm 配置:
yaml
playground:
  serviceAccount:
    annotations:
      azure.workload.identity/client-id: "<managed-identity-client-id>"
  deployment:
    labels:
azure.workload.identity/use: "true"在 Azure OpenAI 提供商配置中,输入端点、部署名和 API 版本。API 密钥留空。
当未提供显式的 API 密钥或令牌提供商时,LangSmith 会自动使用 Playground 的 workload identity。它为 Playground 调用和评估器批量调用获取短生命令牌。显式凭据优先于 workload identity。
Workload identity 令牌被限制到端口 443 上 HTTPS 的 Azure AI 和 Azure OpenAI 端点。每个配置必须用一个受支持的 Azure 云:公共、美国政府或中国。LangSmith 会拒绝无效的端点以及混合 Azure 云的配置。
更广泛的 AKS 部署指导,见在 Azure 上自托管 LangSmith。
可用模型
Azure OpenAI 提供与 OpenAI 相同的模型系列:
- GPT 系列: 通用聊天模型。
- o 系列: 聚焦推理的模型。
- 遗留模型: GPT-3.5 和 GPT-4 变体。
模型可用性因 Azure 区域而异,使用前需要先部署。
当前可用模型的清单,参阅 Azure OpenAI 文档。
配置参数
Azure OpenAI 支持与 OpenAI 相同的参数:
标准参数
| 参数 | 范围 | 描述 |
|---|---|---|
| Temperature | 0.0 - 2.0 | 控制随机性。越低越聚焦,越高越有创造性。 |
| Max Output Tokens | 1+ | 响应的最大长度 |
| Top P | 0.0 - 1.0 | 核采样阈值。temperature 的替代。 |
| Presence Penalty | -2.0 - 2.0 | 惩罚新话题(正)或鼓励它们(负) |
| Frequency Penalty | -2.0 - 2.0 | 惩罚重复(正)或允许它(负) |
| Seed | 整数 | 用于可复现的输出 |
高级参数
Reasoning Effort: 在推理优化模型(o 系列和较新 GPT 模型)上可用。
Service Tier: 在较新模型上可用。
其他参数:
- JSON Mode: 强制有效的 JSON 响应。
- Parallel Tool Calls: 并发执行多个工具。
Azure 专属功能
- Deployment Management: 模型必须先部署才能用。
- Regional Availability: 为数据驻留选 Azure 区域。
- Content Filtering: 内置内容审核与安全功能。
- Managed Identity: Azure AD 身份验证支持。
- Private Endpoints: 用于安全访问的 VNet 集成。
工具调用
- Supported Tool Choices:
auto、required、none,或特定工具名。 - Parallel Execution: 是。
DeepSeek
在使用此模型之前,确保你有一个 DeepSeek API 密钥。
可用模型
DeepSeek 提供通用模型、推理优化模型(R 系列)和编码专精模型。
当前可用模型的清单,参阅 DeepSeek 文档。
配置参数
| 参数 | 范围 | 描述 |
|---|---|---|
| Temperature | 0.0 - 2.0 | 响应随机性 |
| Max Tokens | 1+ | 最大响应长度 |
| Top P | 0.0 - 1.0 | 核采样 |
| Presence Penalty | -2.0 - 2.0 | |
| Frequency Penalty | -2.0 - 2.0 |
Fireworks
在使用此模型之前,确保你有一个 Fireworks API 密钥。
可用模型
Fireworks 为流行的开源模型和微调变体提供高速推理,包括:
- Llama: Meta 的各种规模的 Llama 模型。
- Mixtral: Mistral 的专家混合模型。
- Qwen: 阿里巴巴的多语言模型。
- DeepSeek: DeepSeek 模型。
- 其他开放模型: Gemma、Phi 等。
当前可用模型的清单,参阅 Fireworks 模型文档。
配置参数
| 参数 | 范围 | 描述 |
|---|---|---|
| Temperature | 0.0 - 2.0 | 响应随机性 |
| Max Tokens | 1+ | 最大响应长度 |
| Top P | 0.0 - 1.0 | 核采样 |
工具调用
- Supported Tool Choices:
auto、required、none。 - Parallel Execution: 是。
Google Gemini
在使用此模型之前,确保你有一个 Google AI API 密钥。
可用模型
Google 提供多档(Ultra、Pro、Flash)针对用例优化的 Gemini 模型。
当前可用模型的清单,参阅 Google 的 Gemini 文档。
配置参数
| 参数 | 范围 | 描述 |
|---|---|---|
| Temperature | 0.0 - 2.0 | 响应随机性 |
| Max Output Tokens | 1+ | 最大响应长度 |
| Top P | 0.0 - 1.0 | 核采样 |
| Top K | 1+ | 前 k 采样 |
工具调用
- Supported Tool Choices:
auto、any、none。 - Parallel Execution: 否。
Gemini Enterprise Agent Platform
在使用此模型之前,确保你有一个 Google Cloud 项目,并启用了 Gemini Enterprise Agent Platform API。
认证
Gemini Enterprise Agent Platform 在 LangSmith Playground 中用一个 服务账户 JSON 密钥做身份验证。这是你从 Google Cloud Console 下载的一个含一个有 Gemini Enterprise Agent Platform 访问权的服务账户凭据的 JSON 文件。
步骤 1:创建一个服务账户
- 前往 Google Cloud Console > IAM & Admin > Service Accounts。
- 选择你的项目并点击 Create Service Account。
- 给它一个名字(例如
langsmith-vertex-ai)并点击 Create and Continue。 - 指派 Vertex AI User(
roles/aiplatform.user)角色并点击 Done。
步骤 2:下载 JSON 密钥
- 点击你刚创建的那个服务账户。
- 前往 Keys 标签并点击 Add Key > Create new key。
- 选择 JSON 并点击 Create。一个
.json文件会下载到你的机器。
下载的文件看起来像这样:
json
{
  "type": "service_account",
  "project_id": "your-project-id",
  "private_key_id": "key-id",
  "private_key": "-----BEGIN RSA PRIVATE KEY-----\n...\n-----END RSA PRIVATE KEY-----\n",
  "client_email": "langsmith-vertex-ai@your-project-id.iam.gserviceaccount.com",
  "client_id": "...",
  "auth_uri": "https://accounts.google.com/o/oauth2/auth",
  "token_uri": "https://oauth2.googleapis.com/token"
}步骤 3:在 LangSmith Playground 中配置
在 LangSmith Playground 中,打开 Gemini Enterprise Agent Platform 提供商配置,并把下载的 JSON 密钥文件的完整内容粘贴进 Service Account JSON 字段。
WARNING
把你的服务账户 JSON 密钥当作密码对待。不要分享它或提交到源码控制。如果某个密钥被泄露,立即从 Google Cloud Console 撤销它并创建一个新的。
可用模型
Google 提供多档(Ultra、Pro、Flash)针对不同用例优化的 Gemini 模型,以及通过 Gemini Enterprise Agent Platform 可用的其他模型。
当前可用模型的清单,参阅 Gemini Enterprise Agent Platform 文档。
配置参数
| 参数 | 范围 | 描述 |
|---|---|---|
| Temperature | 0.0 - 2.0 | 响应随机性 |
| Max Output Tokens | 1+ | 最大响应长度 |
| Top P | 0.0 - 1.0 | 核采样 |
| Top K | 1+ | 前 k 采样 |
高级选项
- Region Selection: 在特定 Google Cloud 区域部署。
- Safety Settings: 配置内容过滤阈值。
工具调用
- Supported Tool Choices:
auto、any、none。 - Parallel Execution: 否。
Groq
在使用此模型之前,确保你有一个 Groq API 密钥。
可用模型
Groq 为流行的开源模型(包括 Llama、Mixtral 和 Gemma 变体)提供高速推理。
当前可用模型的清单,参阅 Groq 模型文档。
配置参数
| 参数 | 范围 | 描述 |
|---|---|---|
| Temperature | 0.0 - 2.0 | 响应随机性 |
| Max Tokens | 1+ | 最大响应长度 |
工具调用
- Supported Tool Choices:
auto、required、none。 - Parallel Execution: 是。
Mistral AI
在使用此模型之前,确保你有一个 Mistral AI API 密钥。
可用模型
Mistral 提供多档(Large、Medium、Small)针对不同性能和成本要求优化的模型。
当前可用模型的清单,参阅 Mistral 文档。
配置参数
| 参数 | 范围 | 描述 |
|---|---|---|
| Temperature | 0.0 - 1.0 | 响应随机性 |
| Max Tokens | 1+ | 最大响应长度 |
| Top P | 0.0 - 1.0 | 核采样 |
工具调用
- Supported Tool Choices:
auto、any、none。 - Parallel Execution: 否。
OpenAI
在使用此模型之前,确保你有一个 OpenAI API 密钥 或 Azure OpenAI 凭据。
可用模型
OpenAI 提供若干带不同能力和价位的模型系列:
- GPT 系列: 带各种规模/能力档的通用聊天模型。
- o 系列: 为复杂问题解决优化的聚焦推理模型。
- 遗留模型: 较旧的 GPT-3.5 和 GPT-4 变体。
当前可用模型的清单,参阅 OpenAI 文档。
配置参数
标准:
| 参数 | 范围 | 描述 |
|---|---|---|
| Temperature | 0.0 - 2.0 | 控制随机性。越低越聚焦,越高越有创造性。 |
| Max Output Tokens | 1+ | 响应的最大长度 |
| Top P | 0.0 - 1.0 | 核采样阈值。temperature 的替代。 |
| Presence Penalty | -2.0 - 2.0 | 惩罚新话题(正)或鼓励它们(负) |
| Frequency Penalty | -2.0 - 2.0 | 惩罚重复(正)或允许它(负) |
| Seed | 整数 | 用于可复现的输出 |
高级:
Reasoning Effort:在推理优化模型(o 系列和较新 GPT 模型)上可用。
控制在响应之前的推理深度。越高的 effort = 复杂任务上更好的质量、更长的延迟。
| 值 | 描述 |
|---|---|
none | 禁用推理(标准聊天行为) |
minimal | 最少的推理 |
low | 轻度推理 |
medium | 中等推理(默认) |
high | 深度推理 |
xhigh | 额外深度推理(若模型支持) |
NOTE
当 reasoning_effort 处于活动状态(非 none)时,temperature、top_p 和 penalties 会被自动禁用。
Service Tier:在较新模型上可用。
控制请求优先级和处理分配。
| 值 | 描述 |
|---|---|
auto | 系统依据负载决定(默认) |
default | 标准处理队列 |
flex | 更低成本、可变延迟(若模型支持) |
priority | 高优先级队列、更低延迟、更高成本 |
其他参数:
- JSON Mode: 强制有效的 JSON 响应。
- Responses API: 改进的流式(默认:启用)。
- Parallel Tool Calls: 并发执行多个工具。
工具调用
- Supported Tool Choices:
auto、required、none,或特定工具名 - Parallel Execution: 是
OpenAI 兼容端点
身份验证因端点而异。常见选项:
- API 密钥:存为一个工作区机密,并以
Authorization: Bearer <key>转发。 - 无:用于未身份验证的本地端点(例如
localhost上的 Ollama)。 - OAuth2
client_credentials:存在模型配置上。LangSmith 在请求时铸造一个短生命 bearer 并在过期前刷新它。见 OAuth 客户端凭据。
配置
必需:
- Base URL: 你的端点 URL(例如
https://your-endpoint.com/v1)。 - Model Name: 你的模型标识符。
可与任何实现了 OpenAI 兼容 API 格式的框架或服务配合,包括:
- 自托管的开源推理服务器
- 模型路由代理
- 自定义模型端点
配置参数
所有 OpenAI 兼容参数:
| 参数 | 范围 | 描述 |
|---|---|---|
| Temperature | 0.0 - 2.0 | 响应随机性 |
| Max Tokens | 1+ | 最大响应长度 |
| Top P | 0.0 - 1.0 | 核采样 |
| Frequency Penalty | -2.0 - 2.0 | 减少重复 |
| Presence Penalty | -2.0 - 2.0 | 鼓励新话题 |
高级:
- JSON Mode: 若端点支持。
- Streaming: 若端点支持。
- Function Calling: 若端点实现了 OpenAI 格式。
工具调用
- Supported Tool Choices:
auto、required、none(若端点支持)。 - Parallel Execution: 是(若端点支持)。
示例端点
本地 Ollama:
Base URL: http://localhost:11434/v1
Model: llama3.1vLLM 服务器:
Base URL: https://your-server.com/v1
Model: mistral-7b-instructLiteLLM 代理:
Base URL: https://litellm.example.com
Model: gpt-4 (routes to configured backend)XAI
在使用此模型之前,确保你有一个 xAI API 密钥。
可用模型
xAI 提供多种尺寸的 Grok 模型用于不同用例。
当前可用模型的清单,参阅 xAI 文档。
配置参数
标准 OpenAI 兼容参数:
| 参数 | 范围 | 描述 |
|---|---|---|
| Temperature | 0.0 - 2.0 | 响应随机性 |
| Max Tokens | 1+ | 最大响应长度 |
| Top P | 0.0 - 1.0 | 核采样 |
| Presence Penalty | 0 - 2.0 | 在推理模型上隐藏 |
| Frequency Penalty | 0 - 2.0 | 在推理模型上隐藏 |
工具调用
- Supported Tool Choices: OpenAI 兼容。
- Parallel Execution: 是(若支持)。
跨所有提供商的通用配置
额外参数
所有提供商都支持一个 用于 UI 中未暴露的额外参数的 JSON 编辑器:
json
{
  "logprobs": true,
  "top_logprobs": 5,
  "custom_parameter": "value"
}用例:
- 提供商专属的 beta 功能
- 尚未进入 UI 的高级参数
- 用于跟踪的自定义元数据
限制: 无法覆盖 UI 中已有的参数(例如,若上面已设 temperature,就无法在这里设它)
速率限制
每秒请求数(RPS) - 在数据集上运行时对所有提供商可用:
- 范围: 0 - 500 RPS
- 目的: 遵守 API 速率限制、控制成本
- 默认: 因提供商而异
在运行实验或评估时设置它,以避免触及速率限制。