
主题
评估概念
LLM 输出是非确定的,这让响应质量难以评估。评估(eval)是一种把"好"长什么样拆解出来并加以衡量的方式。LangSmith Evaluation 提供一个在整个应用生命周期度量的框架,从部署前测试到生产监控。
评估什么
在构建评估之前,先确定对你的应用什么才重要。把你的系统拆成它的关键组件——LLM 调用、检索步骤、工具调用、输出格式化——并为每一个确定质量标准。
从手动策划的示例开始。 为每个关键组件创建 5-10 个"好"长什么样的示例。这些示例充当你的真实依据,并决定用哪些评估方法。例如:
- RAG 系统:好检索(相关文档)和好答案(准确、完整)的示例。
- Agent:正确工具选择和恰当参数格式、或 agent 所走轨迹的示例。
- 聊天机器人:有用、符合品牌、回应了用户意图的答案示例。
一旦你通过示例定义了“好”,你就能度量你的系统多频繁地产出类似质量的输出。
离线与在线评估
LangSmith 支持两类在你的开发工作流中服务于不同目的的评估:
离线评估
- 基准测试:比较多个版本以找到最佳表现者。
- 回归测试:确保新版本不降低质量。
- 单元测试:验证各个组件的正确性。
- 回测:用历史数据测试新版本。
离线评估针对示例——来自数据集——:定义了“好”长什么样、带参考输出的精选测试用例。
在线评估
- 实时监控:在实时流量上持续跟踪质量。
- 异常检测:标记不寻常的模式或边缘情形。
- 生产反馈:识别要加入离线数据集的问题。
在线评估针对运行和线程——来自追踪:没有参考输出的真实生产追踪。
这种目标上的差异决定了你能评估什么:离线评估能对照预期答案检查正确性,而在线评估聚焦于质量模式、安全性和真实世界行为。
评估生命周期
在你开发和部署应用时,你的评估策略从部署前测试演进到生产监控。在开发和测试期间,离线评估针对精选数据集验证功能。部署之后,在线评估在实时流量上监控生产行为。随着应用成熟,两种评估类型在一个迭代反馈回路中协同工作,持续改进质量。
graph LR
    A[Development] --> B[Testing]
    B --> C[Deployment]
    C --> D[Monitoring]
    D --> E[Iteration]

    A -.-> F[Offline]
    B -.-> F
    C -.-> G[Online]
    D -.-> G
    E -.-> H[Both]

    classDef process fill:#E5F4FF,stroke:#006DDD,stroke-width:2px,color:#030710

    class A,B,C,D,E process

    style F fill:#EBD0F0,stroke:#885270,color:#441E33
    style G fill:#EBD0F0,stroke:#885270,color:#441E33
    style H fill:#EBD0F0,stroke:#885270,color:#441E33
1. 用离线评估开发
在生产部署之前,用离线评估验证功能、对方法做基准测试并建立信心。
遵循快速开始运行你的第一次离线评估。
2. 用在线评估初始部署
部署之后,用在线评估监控生产质量、检测意外问题并收集真实世界数据。
了解如何配置在线评估以做生产监控。
3. 持续改进
在一个迭代反馈回路中协同使用两种评估类型。在线评估浮现出问题并成为离线测试用例,离线评估验证修复,在线评估确认生产改进。
核心评估目标
评估依据其是离线还是在线,运行在不同的目标上。
离线评估的目标
离线评估运行在数据集和示例上。参考输出的存在使得能比较预期与实际结果。
数据集
数据集是用于评估一个应用的示例集合。一个示例是一个测试输入-参考输出对。
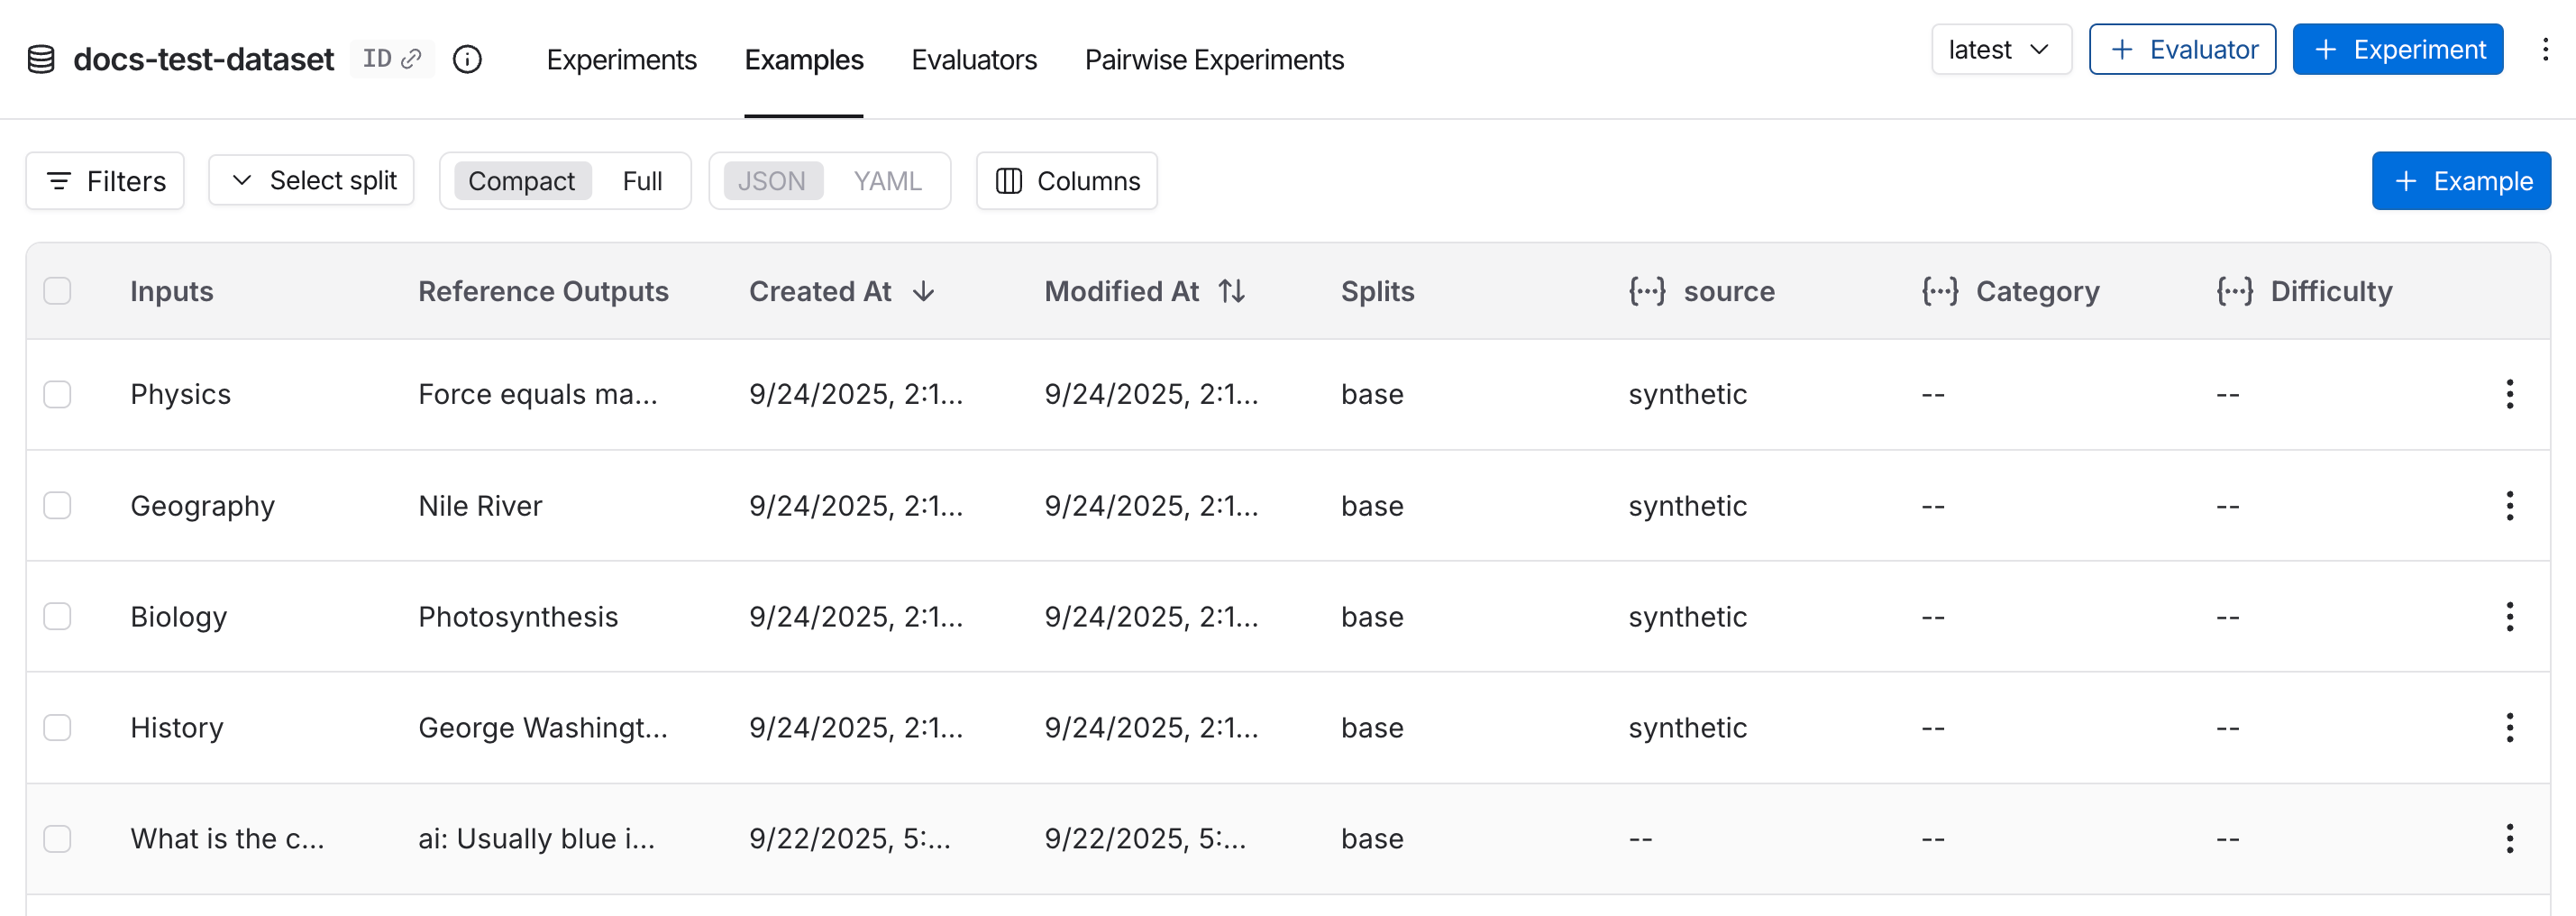
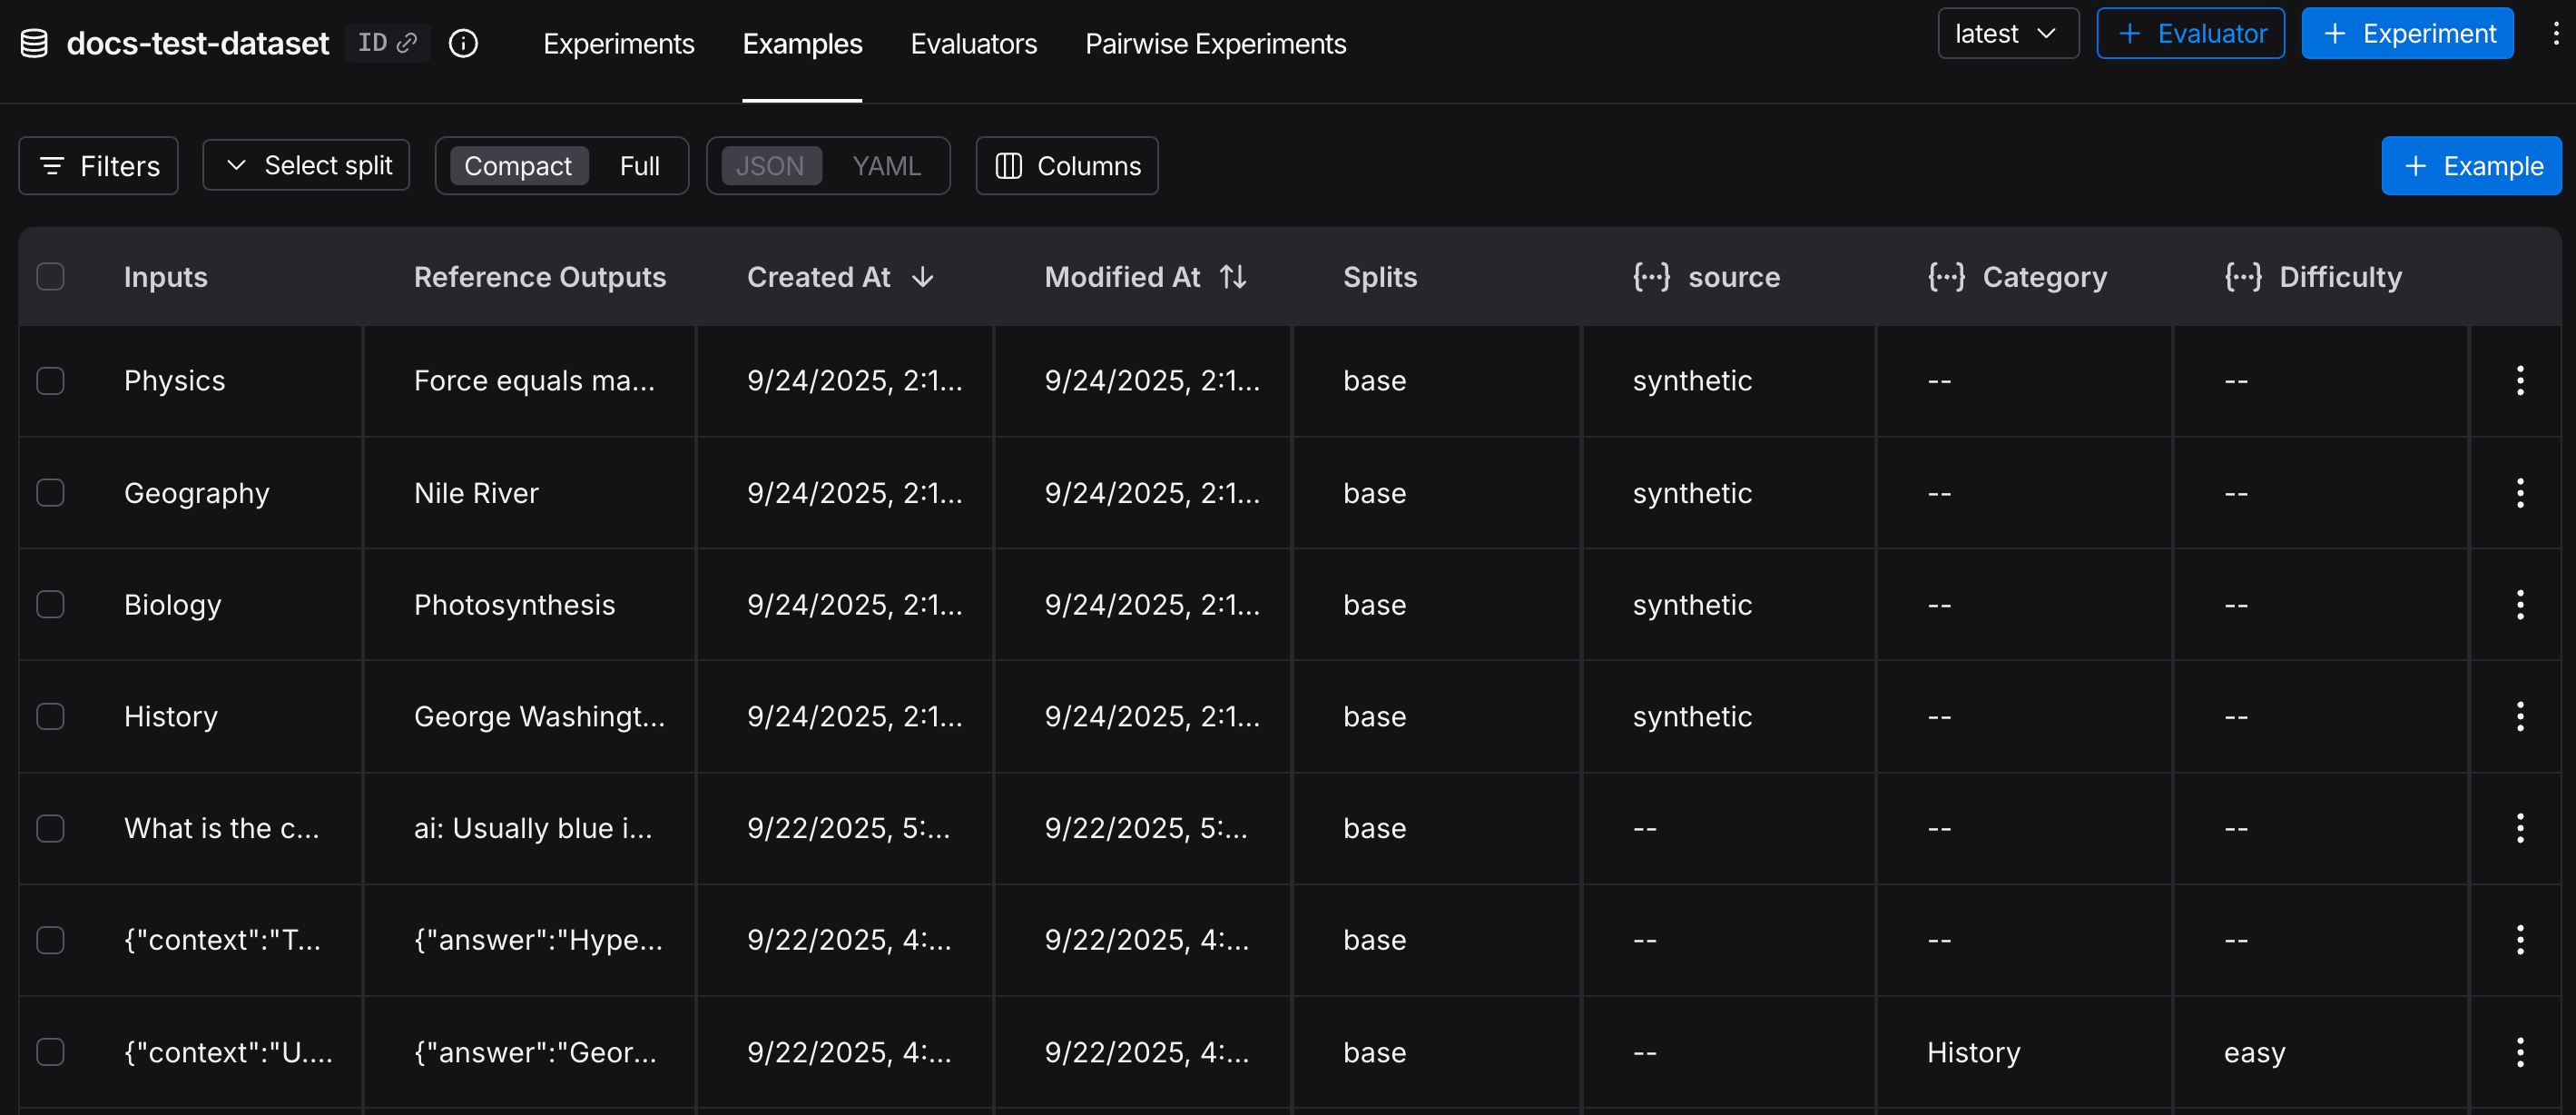
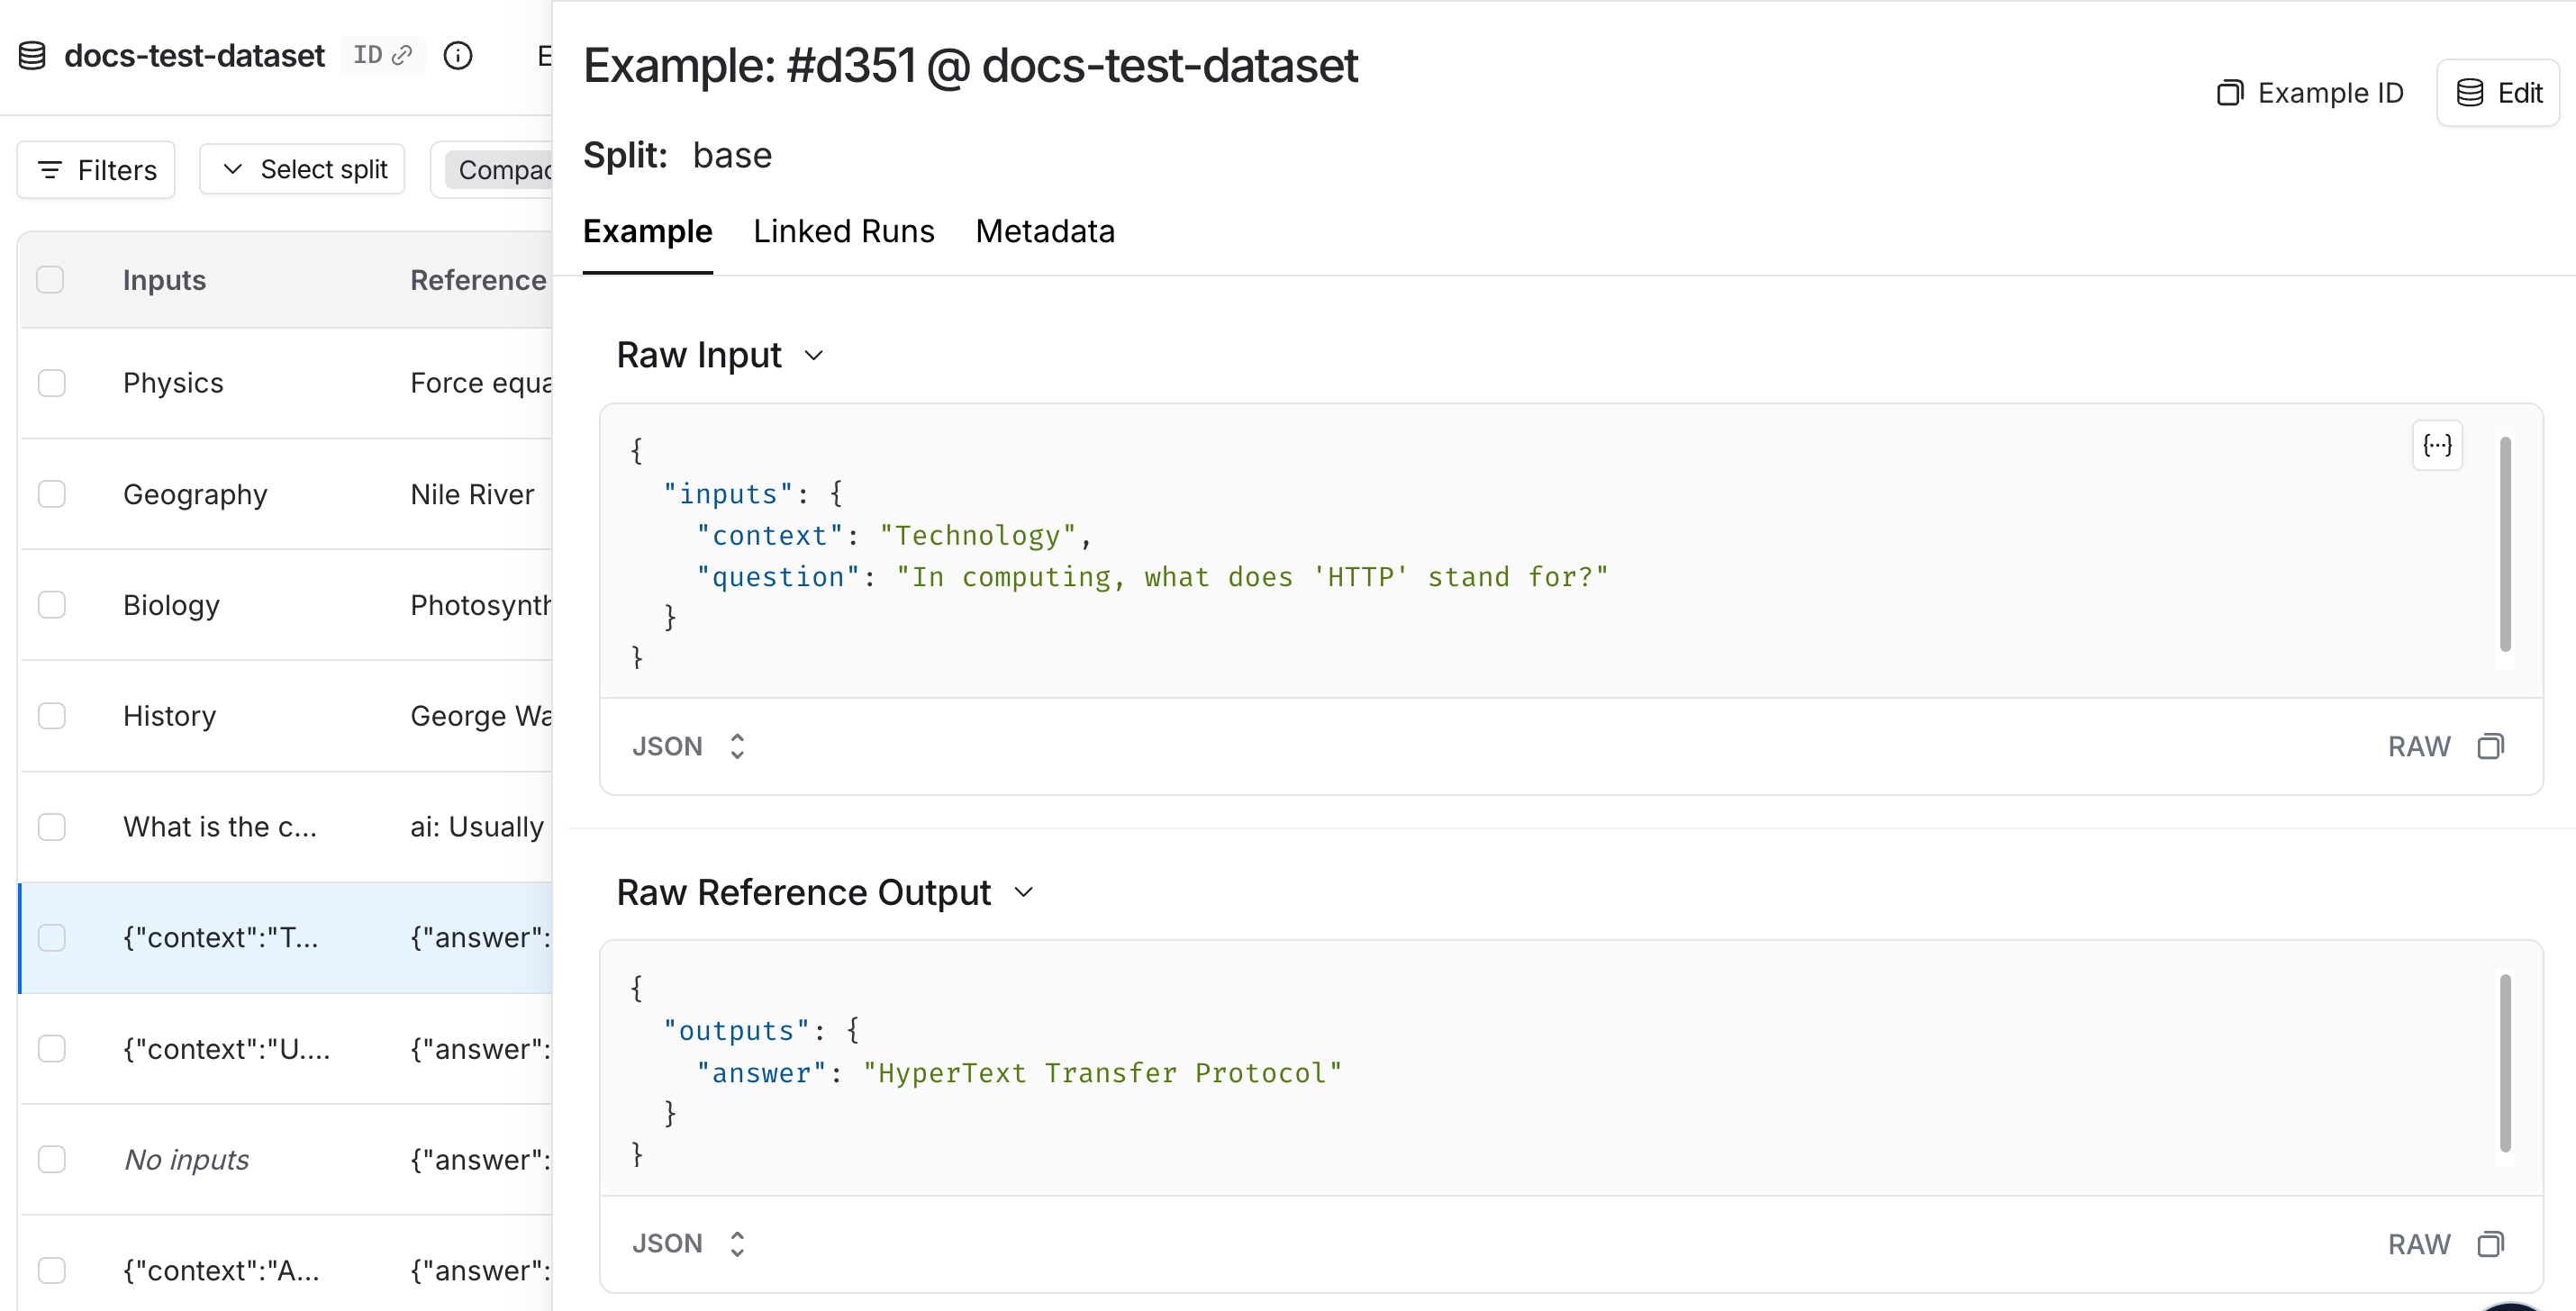
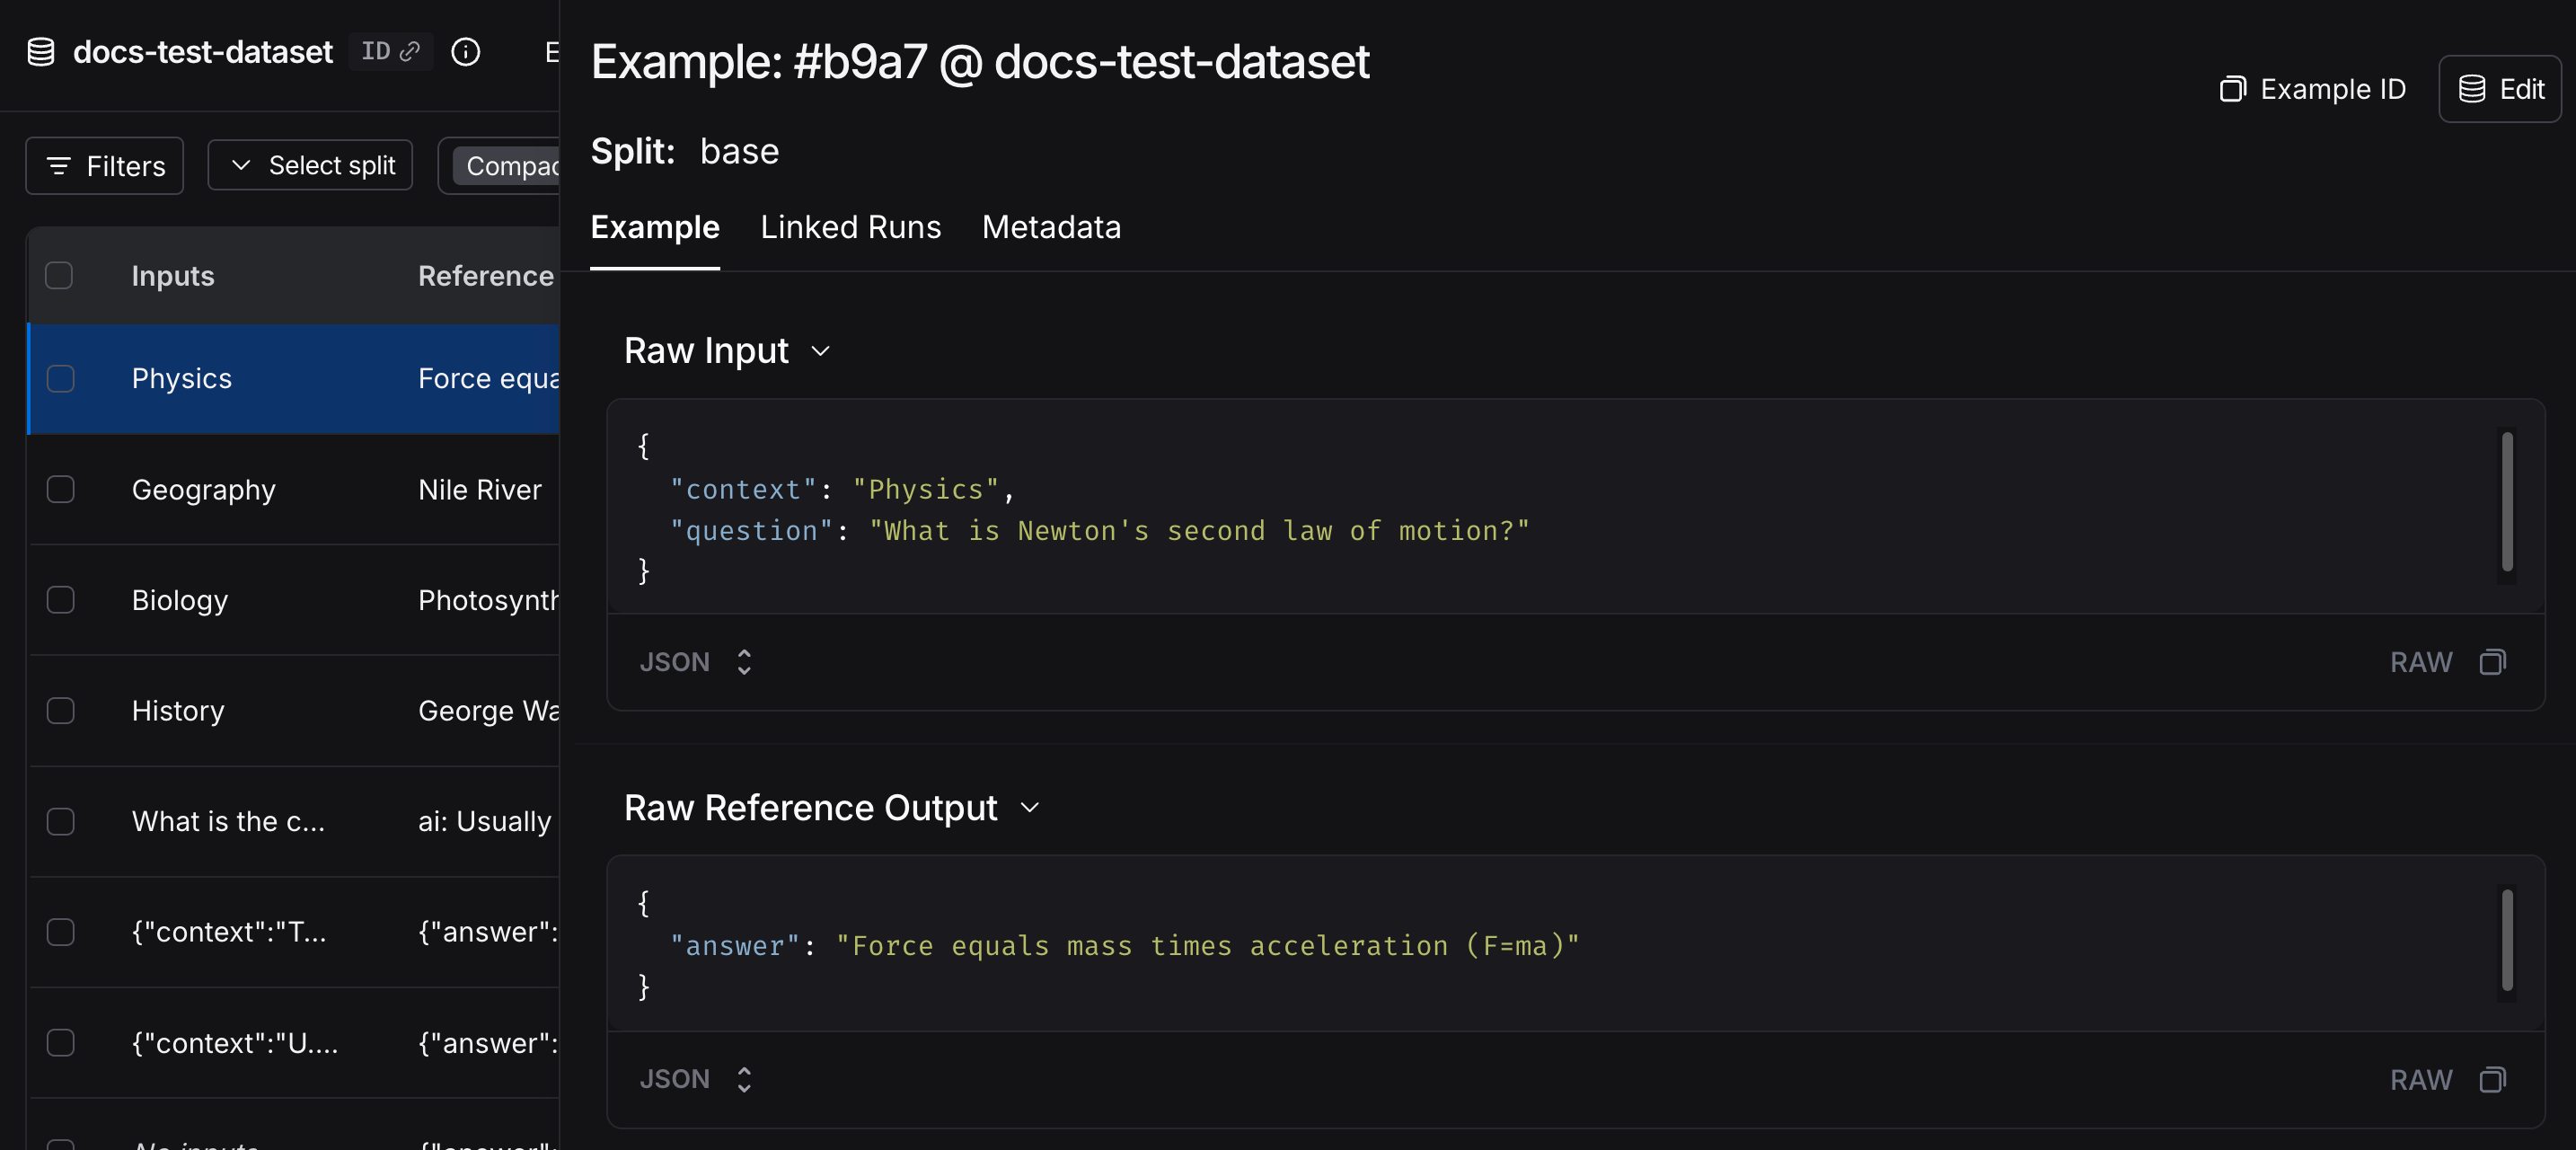
示例
每个示例由以下组成:
- 输入:要传给应用的输入变量字典。
- 参考输出(可选):一个参考输出字典。这些不会传给应用,只在评估器中使用。
- 元数据(可选):一个附加信息字典,可用于创建数据集的过滤视图。
进一步了解管理数据集。
实验
一个实验代表在一个数据集上评估某个特定应用版本的结果。每个实验都为数据集中的每个示例捕获输出、评估器分数和执行追踪。
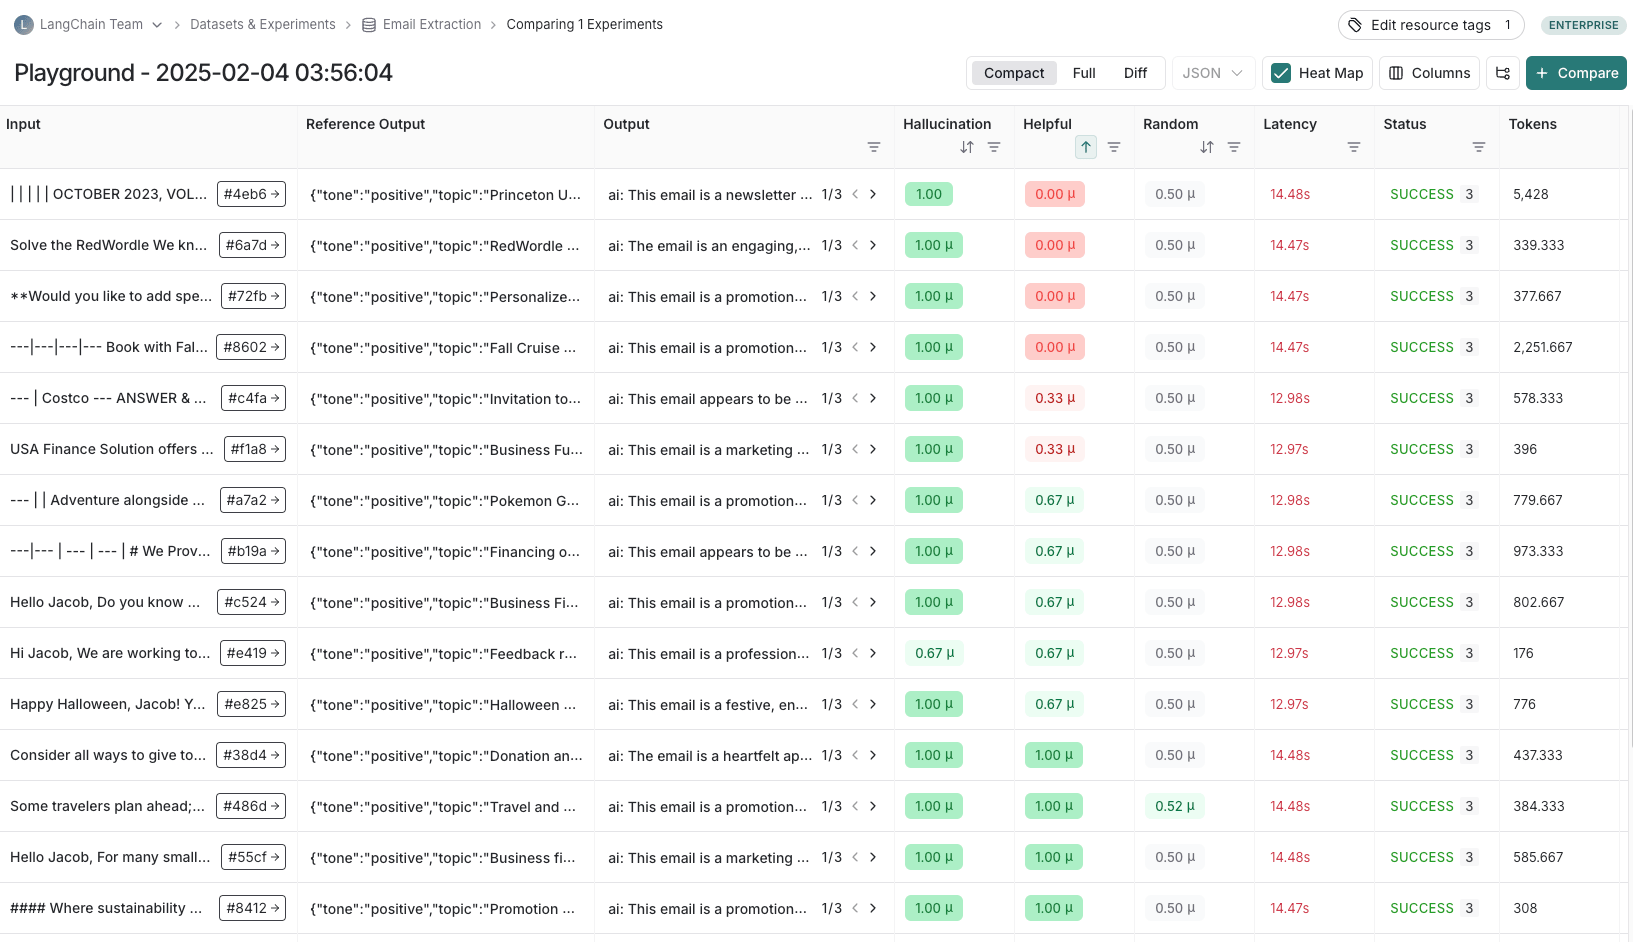
通常在给定数据集上运行多个实验以测试不同的应用配置(例如不同的提示或 LLM)。LangSmith 展示与一个数据集关联的所有实验,并支持比较多个实验并排进行。
了解如何分析实验结果。
在线评估的目标
在线评估运行在生产流量的运行和线程上。没有参考输出,评估器聚焦于实时检测问题、异常和质量下降。
运行
一次运行是来自你已部署应用的一条单执行追踪。每次运行含:
- 输入:你的应用实际收到的用户输入。
- 输出:你的应用实际返回的内容。
- 中间步骤:所有子运行(工具调用、LLM 调用等)。
- 元数据:标签、用户反馈、延迟指标等。
与数据集里的示例不同,运行不含参考输出。在线评估器必须在不知道“正确答案”该是什么的情况下来评估质量,转而依赖质量启发式、安全检查和无参考评估技术。
进一步了解运行与追踪,见可观测性概念。
线程
线程是代表多轮对话的相关运行的集合。在线评估器能在线程级别运行,以评估整个对话而非单个回合。这使你能评估会话级的属性,如跨回合的连贯性、话题维持,以及一次交互全程的用户满意度。
评估器
评估器是为应用性能打分的工作区级资源。它们为离线和在线评估都提供度量层,并依据可用数据调整其输入。因为评估器限定于工作区,你能把一个评估器附到多个追踪项目和数据集而无需每次都重建它。
用以下任一方式运行评估器:
- 评估器页面,把它们附到追踪项目或数据集
- Playground
- LangSmith SDK(Python 和 TypeScript)
- 规则,在追踪项目或数据集上自动运行它们
把评估器附到一个追踪项目或数据集
单个评估器能附到许多追踪项目和数据集。像采样率、过滤器和支出限制这样的配置是按每个被附的项目或数据集设置的,而非按评估器。在其 Projects & Datasets 标签下查看一个评估器被附的项目和数据集。
评估器输入
评估器输入因评估类型而异:
离线评估器接收:
在线评估器接收:
- 运行:含输入、输出和中间步骤的生产追踪(没有可用的参考输出)。
评估器输出
评估器返回反馈,即评估所得的分数。反馈是一个字典或字典列表。每个字典含:
key:指标名。score|value:指标值(数值指标用score,分类指标用value)。comment(可选):对该分数的额外推理或解释。
评估技术
LangSmith 支持若干评估方法:
人工
人工评估涉及对应用输出和执行追踪的人工复核。这种方法常是评估的一个有效起点。LangSmith 提供工具来复核应用输出和追踪(所有中间步骤)。
标注队列
标注队列简化对运行的结构化人工反馈收集。它们通过提供带规定评分标准、团队协作功能和进度跟踪的有序工作流,来补充内联标注。
LangSmith 支持两种队列类型:
- 单运行队列:一次针对自定义评分项复核一个运行。对分诊问题或从生产追踪构建数据集很有用。单运行队列也支持断言,即一个离线评估器可对未来运行打分的自由格式验收标准。
- 成对队列:并排比较两个运行以判断哪个更好。为实验之间的快速 A/B 比较而设计。
关键功能包括为每个运行配置多个复核者、启用预留以防冲突,以及把已标注运行直接导出到数据集以便未来评估。
代码
代码评估器是确定性的、基于规则的函数。它们很适合诸如验证聊天机器人响应的结构非空、生成的代码能编译,或一个分类精确匹配这样的检查。
LLM 评审
LLM-as-judge 评估器用 LLM 为应用输出打分。打分规则和标准通常编码在 LLM 提示里。这些评估器可以是:
- 无参考:检查输出是否含冒犯性内容或是否遵守特定标准。
- 有参考:把输出与一个参考比较(例如检查相对于参考的事实准确性)。
LLM-as-judge 评估器需要仔细复核分数并调优提示。少样本评估器——在打分器提示里包含输入、输出和预期分数的示例——常能提升表现。
决策模型
决策模型评估器用一个决策模型(例如 SemIf 或 Jev)作为评审。与其用一个提示和一个输出 schema,你定义带类型的问题:一个陈述为真的概率、从固定列表中选一个,或沿有序等级的一个分数。每个问题的回答成为它自己的一条反馈。
成对
成对评估器用启发式(例如哪个响应更长)、LLM(配成对提示)或人工复核者来比较两个应用版本的输出。
当直接给一个输出打分很难、而比较两个输出很直接时,成对评估很有效。例如在摘要任务中,从两个摘要里选出信息量更大的那个,往往比对单个摘要赋予一个绝对分数更容易。
了解如何运行成对评估。
无参考对对有参考评估器
理解一个评估器是否需要参考输出,对判断它何时可用至关重要。
无参考评估器在与预期输出比较之外评估质量。这些对离线和在线评估都适用:
- 安全检查:毒性检测、PII 检测、内容政策违规
- 格式验证:JSON 结构、必填字段、schema 合规
- 质量启发式:响应长度、延迟、特定关键词
- 无参考 LLM 评审:清晰度、连贯性、有用性、语气
有参考评估器需要参考输出且只对离线评估有效:
- 正确性:与参考答案的语义相似度
- 事实准确性:对照真实依据做事实核查
- 精确匹配:带已知标签的分类任务
- 有参考 LLM 评审:把输出质量与一个参考比较
在设计评估策略时,无参考评估器在离线测试和在线监控之间提供一致性,而有参考评估器在开发期间实现更精确的正确性检查。
评估类型
LangSmith 为开发和部署的不同阶段支持多种评估方法。理解何时用每种类型有助于构建一个全面的评估策略。
离线和在线评估服务于不同目的:
- 离线评估类型在带参考输出的精选数据集上测试部署前表现
- 在线评估类型在实时流量上无参考输出地监控生产行为
进一步了解评估类型及何时各用其一。
最佳实践
构建数据集
有多种构建数据集的策略:
手动策划的示例
这是推荐的起点。创建 10–20 个覆盖常见场景和边缘情形的高质量示例。这些示例定义了你的应用里“好”长什么样。
历史追踪
一旦进入生产,就把真实追踪转换为示例。对高流量应用:
- 用户反馈:把收到负面反馈的运行加入测试对象。
- 启发式:识别有趣的运行(例如长延迟、错误)。
- LLM 反馈:用 LLM 检测值得关注的会话。
合成数据
从现有示例生成额外示例。从若干高质量手工示例作为模板开始时效果最好。
数据集组织
划分
划分是数据集的命名子集,用来把示例分段到独立的组。常见模式包括:
- ML 风格的划分:把示例分成训练、验证和测试集以避免过拟合——模型在训练数据上表现好、在未见过数据上却差。
- 基于类别的划分:当数据集跨越多个任务类别时,分别评估不同输入类型。
- 分阶段推出:把探索性示例隔离,直到你准备好把它们纳入主评估集。
划分不同于元数据:用划分做评估的高层组织分组,用元数据做逐示例的信息(如标签和来源)。
在机器学习中,最佳实践是每个示例恰好属于一个划分。LangSmith 允许示例属于多个划分,这在一个示例符合多个评估类别时很有用。
了解如何创建和管理数据集划分。
版本
当示例改变时,LangSmith 会自动创建数据集版本。给版本打标签以标记重要里程碑。在 CI 流水线中锁定特定版本,确保数据集更新不会破坏工作流。
人工反馈收集
人工反馈常提供最有价值的评估,尤其对主观质量维度。
标注队列
标注队列实现结构化的人工反馈收集。标记特定运行以待复核,在一个精简的界面里收集标注,并把已标注运行转移到数据集以便未来评估。
标注队列通过提供额外能力——分组运行、指定标准、配置复核者权限——来补充内联标注。
评估对测试
测试和评估相似但不同的概念。
评估按度量衡量性能。 度量可以模糊或主观,且以相对方式更有用。它们通常把系统彼此比较。
测试断言正确性。 一个系统只有在通过所有测试时才能部署。
评估度量可被转换为测试。例如,回归测试能断言新版本必须在相关度量上胜过基线版本。当系统运行昂贵时,把测试和评估放在一起运行以提高效率。
评估能用像 pytest 或 Vitest/Jest 这样的标准测试工具来编写。
快速参考:离线对在线评估
下表总结离线和在线评估之间的关键差异:
| 离线评估 | 在线评估 | |
|---|---|---|
| 运行于 | 数据集(示例) | 追踪项目(运行/线程) |
| 数据访问 | 输入、输出、参考输出 | 仅输入、输出 |
| 何时使用 | 部署前、开发期间 | 生产、部署后 |
| 主要用例 | 基准测试、单元测试、回归测试、回测 | 实时监控、生产反馈、异常检测 |
| 评估时机 | 在精选测试集上批处理 | 在实时流量上实时或近实时 |
| 设置位置 | Evaluation 标签(SDK、UI、Playground) | Observability 标签(自动化规则) |
| 数据要求 | 需要数据集策划 | 无需数据集,评估实时追踪 |