
主题
投入生产
借助持久记忆、沙箱、弹性 middleware 和部署选项,将你的深度智能体投入生产
本指南涵盖将深度智能体从本地原型推进到生产部署的注意事项。它逐一讲解界定记忆范围、配置执行环境、添加护栏以及连接前端。
概述
智能体使用来自记忆和执行环境的信息来完成任务。 在生产环境中,有几个原语决定信息如何被共享和访问:
- 线程:单次对话。消息历史和临时文件默认限定在线程范围内,不会延续到其他线程。
- 用户:与你的智能体交互的人。记忆和文件可以对某个用户私密,也可以跨用户共享。身份和授权来自你的认证层。
- 助手:一个已配置的智能体实例。记忆和文件可以绑定到某一个助手,也可以在所有助手之间共享。
本页涵盖:
- LangSmith 部署:带认证、webhook 和定时任务的管理型基础设施
- 生产注意事项:调用、多租户、身份认证、凭据、异步和持久性
- 记忆:跨对话持久化信息
- 执行环境:文件存储和代码执行
- 护栏:权限和数据隐私
- 前端:将你的 UI 连接到已部署的智能体
LangSmith 部署
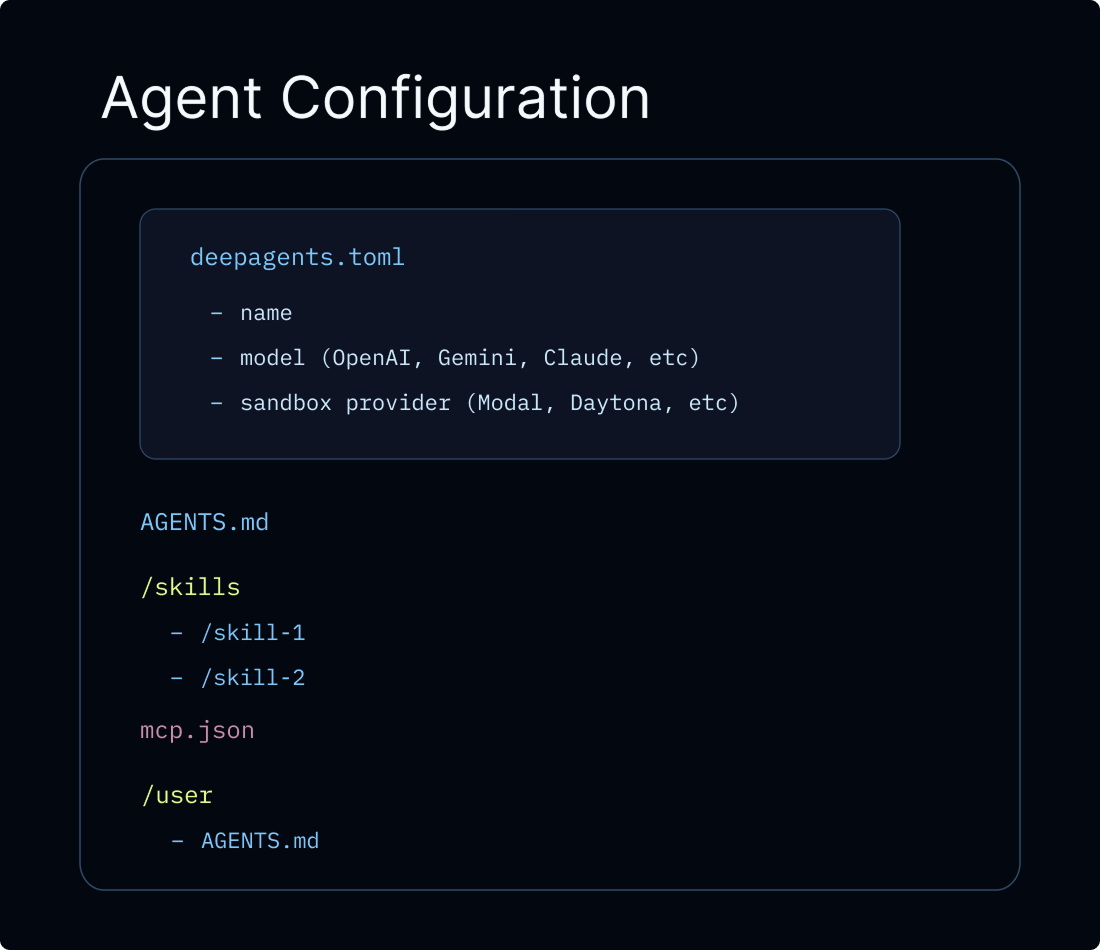
将 Deep Agent 投入生产的推荐路径是 Managed Deep Agents,这是一个 CLI 优先的托管运行时,用于在 LangSmith 中创建、运行和操作深度智能体。Managed Deep Agents 正处于 LangSmith Cloud 上的公开 beta 阶段。它运行相同的 Deep Agents harness,但你以文件项目的形式编写智能体,并将其声明给托管运行时,而无需自己编译。请参阅与 Deep Agents 的关系。
对于需要自定义应用代码、自定义路由、高级认证的团队,你可以直接配置 LangSmith 部署。两种路径都会预置你的智能体所需的基础设施:线程、运行、一个 store 和一个检查点器,因此你不必自己设置这些。传统的 LangSmith 部署还开箱即用地为你提供身份认证、webhook、定时任务和可观测性,并可通过 MCP 或 A2A 暴露你的智能体。
TIP
LangSmith Cloud 部署会自动将追踪发送到以你的部署命名的项目。打开 LangSmith 来调试运行并监控用量。对于混合或自托管部署,请参阅 LangSmith tracing。我们还建议你设置 LangSmith Engine,它会监控你的追踪、检测问题并提出修复建议。
除非另有说明,本页所有代码片段都使用以下 langgraph.json:
json
{
  "dependencies": ["."],
  "graphs": {
    "agent": "./agent.py:agent"
  },
  "env": ".env"
}langgraph.json 是告知 LangGraph 平台如何构建和运行你的应用程序的配置文件。它位于你的项目根目录,是本地开发(使用 langgraph dev)和生产部署都必需的。关键字段包括:
| 字段 | 描述 |
|---|---|
dependencies | 要安装的包。["."] 将当前目录作为包安装(从 requirements.txt、pyproject.toml 或 package.json 读取)。 |
graphs | 将图 ID 映射到它们的代码位置。每个条目为 "<id>": "./<file>:<variable>",其中 <id> 是你通过 API 调用图时使用的名称,<variable> 是从 <file> 导出的编译后的图或构造函数。 |
env | 指向包含环境变量(API 密钥、机密)的 .env 文件的路径。这些在构建时设置,并在运行时可用。 |
有关完整的配置选项集(自定义 Docker 步骤、store 索引、认证处理器等),请参阅应用结构。
生产注意事项
调用智能体
在生产环境中,每次调用都应携带两个运行级参数:
thread_id(通过config={"configurable": {"thread_id": ...}}传入):对话的稳定标识符。检查点器 用它来持久化和恢复消息历史,因此后续轮次会继续同一段对话。生成新的thread_id可开始一段全新的对话。context:每次运行的数据,你的工具和 middleware 在调用时读取,例如user_id、API 密钥、功能标志或会话元数据。用context_schema定义其结构,并通过runtime.context访问。请参阅运行时上下文。
这两者相互独立,且几乎总是一起传入:
python
from dataclasses import dataclass

from deepagents import create_deep_agent
from langchain_core.utils.uuid import uuid7

@dataclass
class Context:
    user_id: str

agent = create_deep_agent(
    model="google_genai:gemini-3.6-flash",
    context_schema=Context,
)

# Start a conversation
config = {"configurable": {"thread_id": str(uuid7())}}
agent.invoke(
    {"messages": [{"role": "user", "content": "Plan a 3-day trip to Tokyo"}]},
    config=config,
    context=Context(user_id="user-123"),
)

# Follow-up on the same conversation: reuse the same thread_id
agent.invoke(
    {"messages": [{"role": "user", "content": "Make it 5 days instead"}]},
    config=config,
    context=Context(user_id="user-123"),
)python
from dataclasses import dataclass

from deepagents import create_deep_agent
from langchain_core.utils.uuid import uuid7

@dataclass
class Context:
    user_id: str

agent = create_deep_agent(
    model="openai:gpt-5.5",
    context_schema=Context,
)

# Start a conversation
config = {"configurable": {"thread_id": str(uuid7())}}
agent.invoke(
    {"messages": [{"role": "user", "content": "Plan a 3-day trip to Tokyo"}]},
    config=config,
    context=Context(user_id="user-123"),
)

# Follow-up on the same conversation: reuse the same thread_id
agent.invoke(
    {"messages": [{"role": "user", "content": "Make it 5 days instead"}]},
    config=config,
    context=Context(user_id="user-123"),
)python
from dataclasses import dataclass

from deepagents import create_deep_agent
from langchain_core.utils.uuid import uuid7

@dataclass
class Context:
    user_id: str

agent = create_deep_agent(
    model="anthropic:claude-sonnet-5",
    context_schema=Context,
)

# Start a conversation
config = {"configurable": {"thread_id": str(uuid7())}}
agent.invoke(
    {"messages": [{"role": "user", "content": "Plan a 3-day trip to Tokyo"}]},
    config=config,
    context=Context(user_id="user-123"),
)

# Follow-up on the same conversation: reuse the same thread_id
agent.invoke(
    {"messages": [{"role": "user", "content": "Make it 5 days instead"}]},
    config=config,
    context=Context(user_id="user-123"),
)python
from dataclasses import dataclass

from deepagents import create_deep_agent
from langchain_core.utils.uuid import uuid7

@dataclass
class Context:
    user_id: str

agent = create_deep_agent(
    model="openrouter:z-ai/glm-5.2",
    context_schema=Context,
)

# Start a conversation
config = {"configurable": {"thread_id": str(uuid7())}}
agent.invoke(
    {"messages": [{"role": "user", "content": "Plan a 3-day trip to Tokyo"}]},
    config=config,
    context=Context(user_id="user-123"),
)

# Follow-up on the same conversation: reuse the same thread_id
agent.invoke(
    {"messages": [{"role": "user", "content": "Make it 5 days instead"}]},
    config=config,
    context=Context(user_id="user-123"),
)python
from dataclasses import dataclass

from deepagents import create_deep_agent
from langchain_core.utils.uuid import uuid7

@dataclass
class Context:
    user_id: str

agent = create_deep_agent(
    model="fireworks:accounts/fireworks/models/glm-5p2",
    context_schema=Context,
)

# Start a conversation
config = {"configurable": {"thread_id": str(uuid7())}}
agent.invoke(
    {"messages": [{"role": "user", "content": "Plan a 3-day trip to Tokyo"}]},
    config=config,
    context=Context(user_id="user-123"),
)

# Follow-up on the same conversation: reuse the same thread_id
agent.invoke(
    {"messages": [{"role": "user", "content": "Make it 5 days instead"}]},
    config=config,
    context=Context(user_id="user-123"),
)python
from dataclasses import dataclass

from deepagents import create_deep_agent
from langchain_core.utils.uuid import uuid7

@dataclass
class Context:
    user_id: str

agent = create_deep_agent(
    model="baseten:zai-org/GLM-5.2",
    context_schema=Context,
)

# Start a conversation
config = {"configurable": {"thread_id": str(uuid7())}}
agent.invoke(
    {"messages": [{"role": "user", "content": "Plan a 3-day trip to Tokyo"}]},
    config=config,
    context=Context(user_id="user-123"),
)

# Follow-up on the same conversation: reuse the same thread_id
agent.invoke(
    {"messages": [{"role": "user", "content": "Make it 5 days instead"}]},
    config=config,
    context=Context(user_id="user-123"),
)python
from dataclasses import dataclass

from deepagents import create_deep_agent
from langchain_core.utils.uuid import uuid7

@dataclass
class Context:
    user_id: str

agent = create_deep_agent(
    model="ollama:north-mini-code-1.0",
    context_schema=Context,
)

# Start a conversation
config = {"configurable": {"thread_id": str(uuid7())}}
agent.invoke(
    {"messages": [{"role": "user", "content": "Plan a 3-day trip to Tokyo"}]},
    config=config,
    context=Context(user_id="user-123"),
)

# Follow-up on the same conversation: reuse the same thread_id
agent.invoke(
    {"messages": [{"role": "user", "content": "Make it 5 days instead"}]},
    config=config,
    context=Context(user_id="user-123"),
)View example trace
打开本示例的一个公开 LangSmith 运行记录。
使用 LangGraph SDK 部署时,SDK 会为你管理线程,你将返回的 thread_id 传给每次运行:
python
from langgraph_sdk import get_client

client = get_client(url="<DEPLOYMENT_URL>", api_key="<LANGSMITH_API_KEY>")

thread = await client.threads.create()
async for chunk in client.runs.stream(
    thread["thread_id"],
    "agent",
    input={"messages": [{"role": "user", "content": "Plan a 3-day trip to Tokyo"}]},
    context={"user_id": "user-123"},
    stream_mode="updates",
):
print(chunk.data)TIP
thread_id 界定对话的范围(消息历史、检查点)。context 携带你的工具和 middleware 读取的每次运行数据。它们相互独立:改变一个不会影响另一个,你可以传入其中之一或两者都传。
多租户
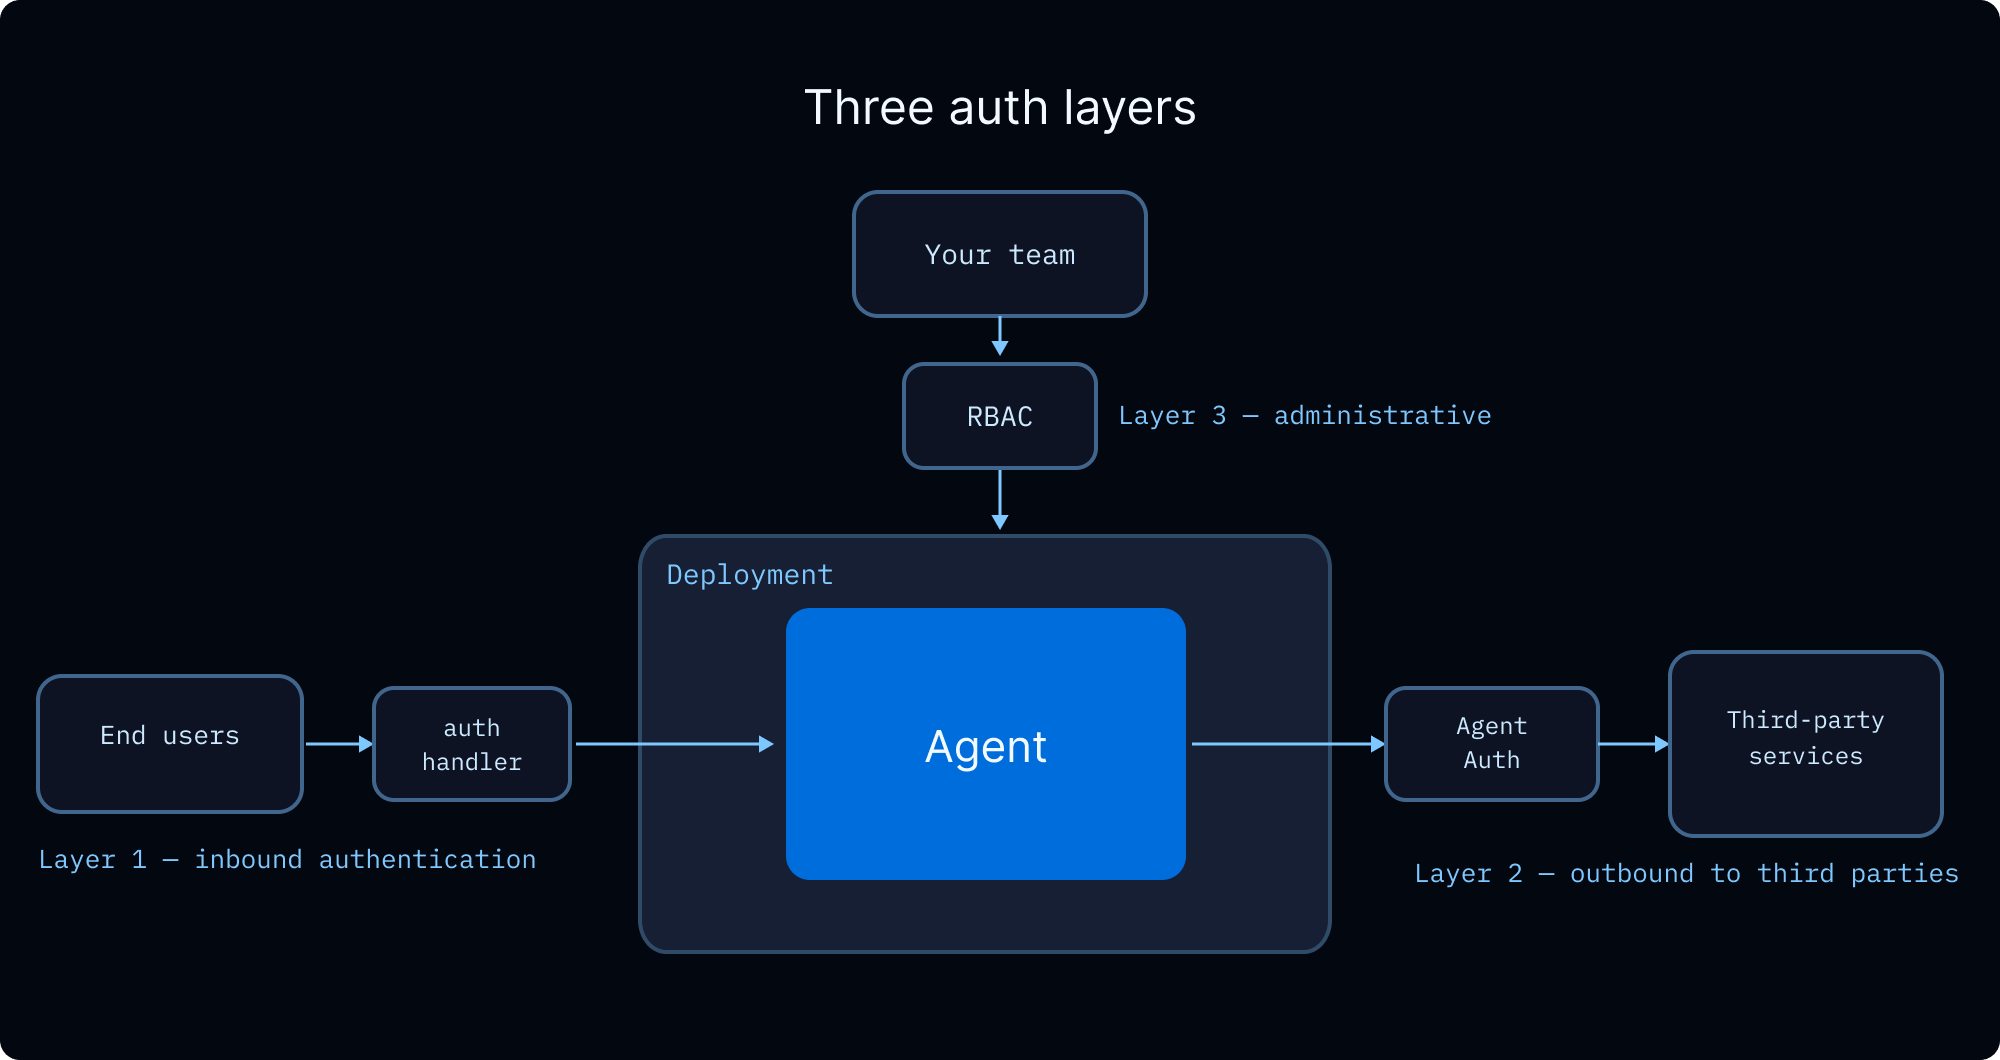
当你的智能体服务多个用户时,你需要处理三件事:验证每个用户是谁、控制他们可以访问什么,以及管理智能体代表他们行事所使用的凭据。
用户身份与访问控制
LangSmith 部署支持自定义认证来建立用户身份,并支持授权处理器来控制对线程、助手和 store 命名空间等资源的访问。授权处理器在认证成功后运行,并且可以:
- 为资源打上所有权元数据标签(例如
owner: user_id) - 返回过滤器,使用户只能看到自己的资源
- 对未授权的操作以 HTTP 403 拒绝访问
如需分步教程,请参阅让对话保持私密。如需完整演示,请观看自定义认证视频。
你如何界定记忆范围和执行环境决定了用户之间共享哪些数据。详情请参阅下文各节。
团队访问控制(RBAC)
LangSmith 的基于角色的访问控制管理你团队中谁可以部署、配置和监控智能体。这与上文的终端用户授权是分开的。
| 角色 | 访问权限 |
|---|---|
| Workspace Admin | 完整权限,包括设置和成员管理 |
| Workspace Editor | 创建和修改资源,但不能删除运行或管理成员 |
| Workspace Viewer | 只读访问 |
具有细粒度权限的自定义角色在 Enterprise 套餐中可用。完整权限模型请参阅 RBAC 参考。
终端用户凭据
当你的智能体需要代表用户调用外部 API(例如读取他们的 GitHub 仓库、发送 Slack 消息、查询他们的数据仓库)时,你需要一种方式将用户的凭据传递给智能体,而无需硬编码它们。
通过 Agent Auth 实现 OAuth。 Agent Auth 提供托管的 OAuth 2.0 流程。配置一个 OAuth 服务商,智能体就可以请求限定到每个用户范围的 token。首次使用时,智能体中断执行并呈现一个 OAuth 同意 URL。用户认证后,智能体携带有效 token 恢复执行。token 会被存储并自动刷新。
python
from langchain_auth import Client
from langchain.tools import tool, ToolRuntime

auth_client = Client()

# Inside your agent's tool:
@tool
async def github_action(runtime: ToolRuntime):
    """Perform an action on behalf of the user via GitHub."""
    auth_result = await auth_client.authenticate(
        provider="github",
        scopes=["repo", "read:org"],
        user_id=runtime.server_info.user.identity,
    )
# Use auth_result.token for GitHub API calls on the user's behalf沙箱的凭据注入。 如果你的智能体在沙箱内运行调用外部 API 的代码,沙箱认证代理可以自动将凭据注入到出站请求中,因此沙箱代码永远不会收到原始 API 密钥。设置详情请参阅管理机密。
工作区机密。 对于在所有用户之间共享的 API 密钥(例如你所在组织的 LLM 服务商密钥、搜索 API 密钥),将它们存储为 LangSmith 中的工作区机密。详情请参阅管理机密。
异步
基于 LLM 的应用高度受 I/O 限制:调用语言模型、数据库和外部服务。异步编程让这些操作并发运行而不是阻塞,从而提升吞吐量和响应速度。
NOTE
LangChain 遵循在异步方法名前加 a 前缀的约定(例如 ainvoke、abefore_agent、astream)。同步和异步变体位于同一个类或命名空间中。
为生产环境构建时:
- 创建异步工具。 LangChain 在单独的线程中运行同步工具以避免阻塞,但原生异步完全避免了线程开销。
- 使用异步 middleware 方法。 自定义 middleware 应实现异步钩子(例如用
abefore_agent而非before_agent)。 - 对外部资源生命周期使用异步。 创建沙箱或连接到 MCP 服务器涉及网络调用,应当被 await。这就是预置这些资源的图工厂是异步的原因。
持久性
Deep Agents 运行在 LangGraph 上,后者开箱即用地提供持久化执行。持久化层在每一步对状态进行检查点,因此因故障、超时或人在回路暂停而中断的运行会从最后记录的状态恢复,而无需重新处理之前的步骤。对于会生成许多子智能体的长时间运行的深度智能体,这意味着运行中途的故障不会丢失已完成的工作。
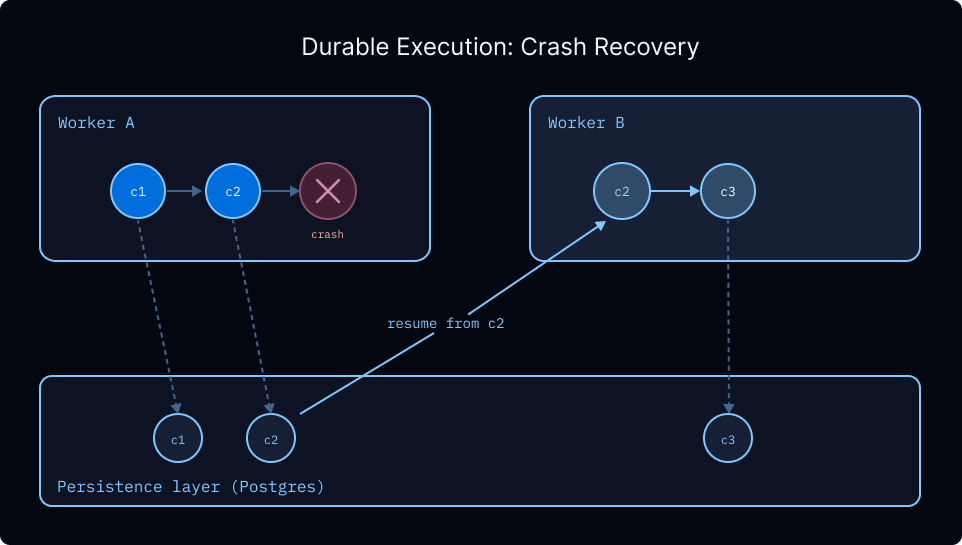
检查点还支持:
- 可无限期中断。 人在回路工作流可以暂停几分钟甚至几天,并精确地从离开的位置恢复。
- 时间旅行。 每个已检查点的步骤都是一个可以回退到的快照,让你在出现问题时从更早的状态重放。
- 安全处理敏感操作。 对于涉及支付或其他不可逆操作的工作流,检查点提供审计追踪和一个恢复点,用于检查导致某个操作的确切状态。
TIP
LangSmith 部署会自动配置一个持久化检查点器。如果你在自托管,请参阅持久化了解设置说明。
记忆
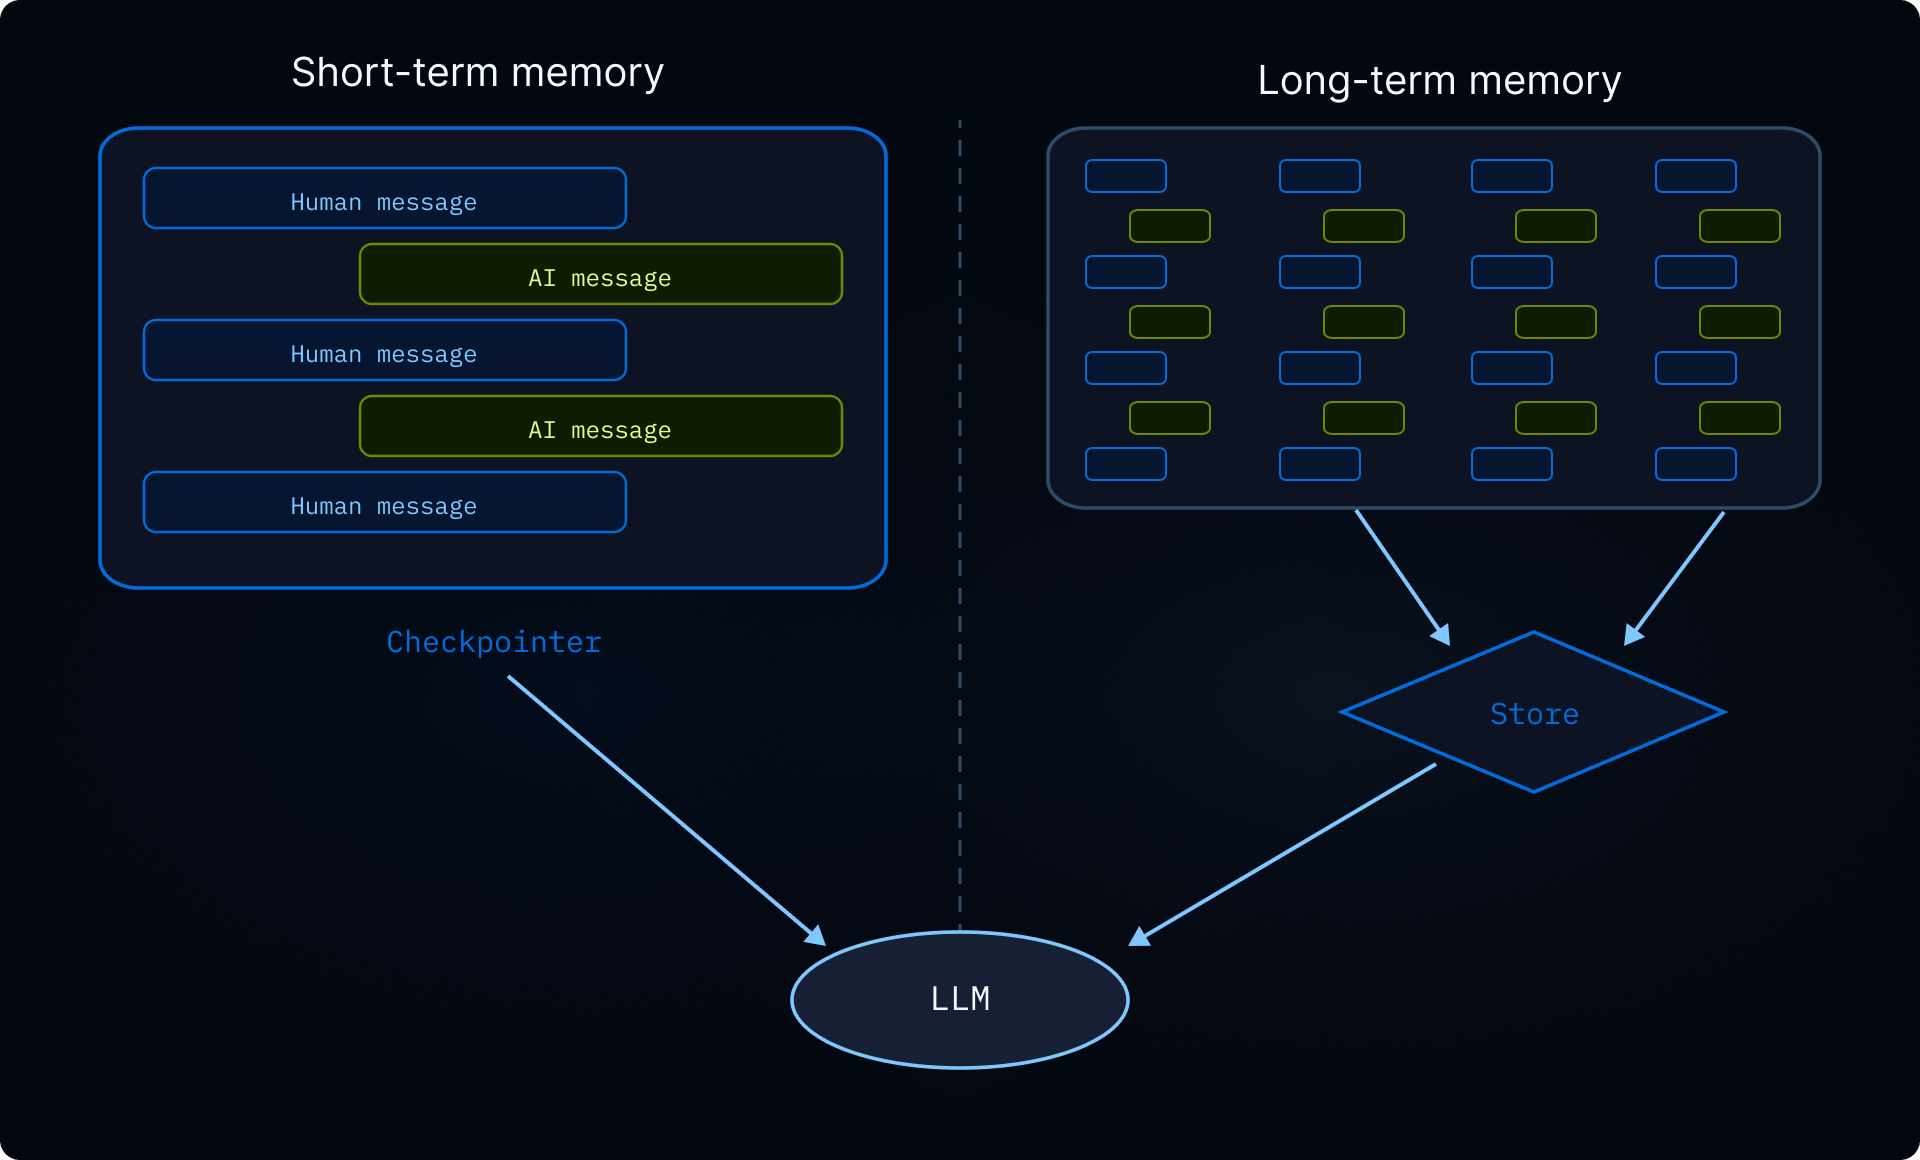
没有记忆,每段对话都从零开始。记忆让你的智能体跨对话保留信息(用户偏好、学到的指令、过往经验),从而能够随着时间推移个性化其行为。有关记忆类型的概述,请参阅记忆概念指南。
界定范围
记忆始终跨对话持久化。主要问题是它如何在用户和助手边界之间界定范围。正确的范围取决于谁应该查看和修改这些数据:
| 范围 | 命名空间 | 用例 | 示例 |
|---|---|---|---|
| 用户(推荐的默认值) | (user_id) | 每用户的偏好和上下文 | “我偏好简洁的回复” |
| 助手 | (assistant_id) | 某个助手的共享指令 | “帖子最多 280 个字符” |
| 全局 | (org_id) | 对所有用户和助手的只读策略 | “绝不披露内部定价” |
WARNING
共享记忆(助手、用户或组织范围)是提示词注入的一个途径。如果某个用户可以写入另一个用户对话所读取的记忆,恶意用户就可能向该共享状态注入指令。在适当的地方强制只读访问。例如,让组织范围的策略只能通过应用代码写入,而不能由智能体本身写入。使用权限以声明方式拒绝对共享路径的写入,或使用后端策略钩子实现自定义校验逻辑。
配置
在 Deep Agents 中,记忆以文件形式存储在虚拟文件系统中。默认情况下,文件限定在单个线程(对话)范围内,不跨线程共享。 否则,要跨线程共享记忆,可将 /memories/ 这样的路径路由到写入 LangGraph Store 的 StoreBackend。使用 CompositeBackend 为智能体同时提供线程范围的临时空间和跨线程的长期记忆。
NOTE
下面展示的 rt.server_info 和 rt.execution_info 命名空间模式需要 deepagents>=0.5.0。
按 user_id 划分命名空间。每个用户都拥有自己的私有记忆。这是推荐的默认值,因为大多数应用只部署单个助手。
python
from deepagents import create_deep_agent
from deepagents.backends import CompositeBackend, StateBackend, StoreBackend

agent = create_deep_agent(
    model="google_genai:gemini-3.6-flash",
    backend=CompositeBackend(
        default=StateBackend(),
        routes={
            "/memories/": StoreBackend(
                namespace=lambda rt: (
                    rt.server_info.assistant_id,
                    rt.server_info.user.identity,
                ),
            ),
        },
    ),
    system_prompt="""You have persistent memory at /memories/.

    Read /memories/instructions.txt at the start of each conversation for
    accumulated knowledge and preferences. When you learn something that
    should persist, update that file.""",
)你也可以使用 Store API 从应用代码读写 store。示例请参阅高级用法。
完整的命名空间工厂 API 请参阅命名空间工厂。自改进指令和知识库等记忆模式请参阅长期记忆。
执行环境
在本地,智能体可以直接在磁盘上读写文件并运行 shell 命令。在生产环境中,你需要考虑隔离和持久化。合适的设置取决于你的智能体是否需要执行代码:
- 文件系统后端就足够了,如果你的智能体只读写文件。选择一个符合你持久化需求的后端:线程范围的临时空间、跨线程存储,或两者的混合。
- 沙箱添加一个隔离容器,带有用于运行 shell 命令的
execute工具。如果你的智能体需要运行代码、安装包或做文件 I/O 之外的任何事情,请使用沙箱。
文件系统
根据什么需要持久化来选择后端:
StateBackend(默认):线程范围的临时空间。文件通过你的检查点器在线程内的各轮次之间持久保留,但不跨线程共享。每一步都进行检查点,因此避免写入大文件。
StoreBackend:跨线程存储,可在对话之间持续存在。使用命名空间工厂界定范围。
CompositeBackend:两者混合。默认使用线程范围的临时空间,并为
/memories/等特定路径提供跨线程路由。ContextHubBackend:位于 LangSmith Hub 仓库(owner/name或name)中的持久化文件。当你想要 LangSmith 原生的持久化而无需预置单独的 LangGraph store 时,使用它。
完整的后端列表以及如何构建自定义后端,请参阅后端。
WARNING
FilesystemBackend 和 LocalShellBackend 会直接访问宿主机。不要在已部署的智能体中使用它们。
沙箱
如果你的智能体需要运行代码(而不仅仅是读写文件),请使用沙箱。沙箱同时提供文件系统和用于运行 shell 命令的 execute 工具,全部位于隔离容器内。这种隔离也保护你的宿主机:如果智能体的代码耗尽内存或崩溃,只有沙箱会受到影响。你的服务器会继续运行。
生命周期
关键决策是沙箱的存活时长。每段对话都获得一个全新的沙箱,还是各段对话共享一个持久环境?
| 范围 | 沙箱 ID 存储于 | 生命周期 | 示例用例 |
|---|---|---|---|
| 线程范围 | 线程元数据 | 每段对话全新,TTL 到期时清理 | 一个数据分析机器人,每段对话都干净地开始 |
| 助手范围 | 助手配置 | 在所有对话之间共享 | 一个编码助手,跨对话维护一个克隆的仓库 |
NOTE
下面的示例使用异步图工厂而非静态图,因为沙箱需要 thread_id 或 assistant_id 来查找或创建正确的沙箱。图工厂不会收到完整的 Runtime(没有 server_info 或 execution_info);相反,它们接受一个 RunnableConfig,并从 config["configurable"] 读取 thread_id 和 assistant_id。工厂是异步的,因为沙箱创建是一项受 I/O 限制的操作,需要仅在调用时才可获得的每次运行信息。
每段对话都获得自己的沙箱。图工厂从运行配置中读取 thread_id,因此每个线程都会自动获得自己隔离的环境。命名沙箱查找处理跨运行的去重。当沙箱 TTL 到期时被清理。
python
from deepagents import create_deep_agent
from deepagents.backends.langsmith import LangSmithSandbox
from langchain_core.runnables import RunnableConfig
from langsmith.sandbox import SandboxClient

client = SandboxClient()

async def agent(config: RunnableConfig):
    thread_id = config["configurable"]["thread_id"]
    sandbox_name = f"thread-{thread_id}"
    existing = [
        sb
        for sb in client.list_sandboxes()
        if getattr(sb, "name", None) == sandbox_name
    ]
    if existing:
        ls_sandbox = existing[0]
    else:
        ls_sandbox = client.create_sandbox(
            name=sandbox_name,
            idle_ttl_seconds=3600,  # TTL: clean up when idle
        )
    return create_deep_agent(
        model="google_genai:gemini-3.6-flash",
        backend=LangSmithSandbox(sandbox=ls_sandbox),
)由于 agent 变量是一个异步函数(而非编译后的图),服务器会将其视为图工厂,并在每次运行时调用它,注入配置。工厂按名称查找或创建沙箱,并返回一个连接到该沙箱的全新智能体图。
使用 langgraph deploy 部署后,可通过 SDK 从你的应用代码调用智能体。无论范围如何,客户端代码都相同。范围界定完全在上面的智能体工厂中处理,但行为有所不同:
每个线程都获得自己的沙箱。同一线程内的后续消息复用同一个沙箱,但新线程总是干净地开始,不会残留前几段对话的文件或已安装的包。
python
from langgraph_sdk import get_client

client = get_client(url="<DEPLOYMENT_URL>", api_key="<LANGSMITH_API_KEY>")

# Conversation 1: install pandas and analyze data
thread_1 = await client.threads.create()
async for chunk in client.runs.stream(
    thread_1["thread_id"],
    "agent",
    input={"messages": [{"role": "human", "content": "Install pandas and analyze sales_data.csv"}]},
    stream_mode="updates",
):
    print(chunk.data)

# Follow-up in the same conversation — pandas is still installed
async for chunk in client.runs.stream(
    thread_1["thread_id"],
    "agent",
    input={"messages": [{"role": "human", "content": "Now plot the results"}]},
    stream_mode="updates",
):
    print(chunk.data)

# Conversation 2: fresh sandbox — pandas is NOT installed, no files from conversation 1
thread_2 = await client.threads.create()
async for chunk in client.runs.stream(
    thread_2["thread_id"],
    "agent",
    input={"messages": [{"role": "human", "content": "What packages are installed?"}]},
    stream_mode="updates",
):
print(chunk.data)文件传输
沙箱是隔离容器,因此你的应用代码无法直接访问其中的文件。使用 upload_files() 和 download_files() 跨沙箱边界移动数据:
- 在智能体运行前为沙箱播种:上传用户文件、技能脚本、配置或持久记忆,让智能体从一开始就拥有所需内容
- 在智能体完成后检索结果:下载生成的产物(报告、图表、导出文件),并将更新后的记忆同步回来以供未来的对话使用
特定服务商的文件传输示例请参阅使用文件。服务商设置、安全和生命周期模式请参阅完整的沙箱指南。
示例:使用自定义 middleware 同步技能和记忆
技能脚本是智能体需要执行的,必须在智能体运行前上传到沙箱中。你可能还希望同步记忆,以便智能体能在容器内读取和更新它们。使用带有 before_agent 和 after_agent 钩子的自定义 middleware来跨沙箱边界移动文件:
python
from deepagents import create_deep_agent
from deepagents.backends import CompositeBackend, StoreBackend
from deepagents.backends.langsmith import LangSmithSandbox
from langchain.agents.middleware import AgentMiddleware, AgentState
from langgraph.runtime import Runtime
from langsmith.sandbox import SandboxClient

def _safe_filename(key: str) -> str:
    """Reject keys that contain path traversal or glob characters."""
    name = key.split("/")[-1]
    if ".." in name or any(c in name for c in ("*", "?")):
        raise ValueError(f"Invalid key: {key}")
    return name

class SandboxSyncMiddleware(AgentMiddleware):
    """Sync skills and memories between the store and the sandbox."""

    def __init__(self, backend: CompositeBackend):
        super().__init__()
        self.backend = backend

    async def abefore_agent(self, state: AgentState, runtime: Runtime) -> None:
        """Upload skill scripts and memories into the sandbox."""
        user_id = runtime.server_info.user.identity
        store = runtime.store
        files = []
        for item in await store.asearch(("skills", user_id)):
            name = _safe_filename(item.key)
            files.append((f"/skills/{name}", item.value["content"].encode()))
        for item in await store.asearch(("memories", user_id)):
            name = _safe_filename(item.key)
            files.append((f"/memories/{name}", item.value["content"].encode()))
        if files:
            await self.backend.upload_files(files)

    async def aafter_agent(self, state: AgentState, runtime: Runtime) -> None:
        """Sync updated memories back to the store."""
        user_id = runtime.server_info.user.identity
        store = runtime.store
        items = await store.asearch(("memories", user_id))
        results = await self.backend.download_files(
            [f"/memories/{item.key}" for item in items]
        )
        for result in results:
            if result.content is not None:
                await store.aput(
                    ("memories", user_id),
                    result.path.split("/")[-1],
                    {"content": result.content.decode()},
                )

client = SandboxClient()
ls_sandbox = client.create_sandbox()

backend = CompositeBackend(
    default=LangSmithSandbox(sandbox=ls_sandbox),
    routes={
        "/skills/": StoreBackend(
            rt,
            namespace=lambda rt: ("skills", rt.server_info.user.identity),
        ),
        "/memories/": StoreBackend(
            rt,
            namespace=lambda rt: ("memories", rt.server_info.user.identity),
        ),
    },
)

agent = create_deep_agent(
    model="google_genai:gemini-3.6-flash",
    backend=backend,
    middleware=[SandboxSyncMiddleware(backend)],
)管理机密
沙箱是隔离容器,因此宿主机的环境变量在沙箱内不可用。有两种方式向沙箱代码提供 API 密钥和其他机密:
认证代理(推荐)。 沙箱认证代理拦截来自沙箱的出站请求并自动注入认证头。沙箱代码正常调用外部 API,代理会根据目标主机添加正确的凭据。这意味着 API 密钥永远不会出现在沙箱代码、环境变量或日志中。
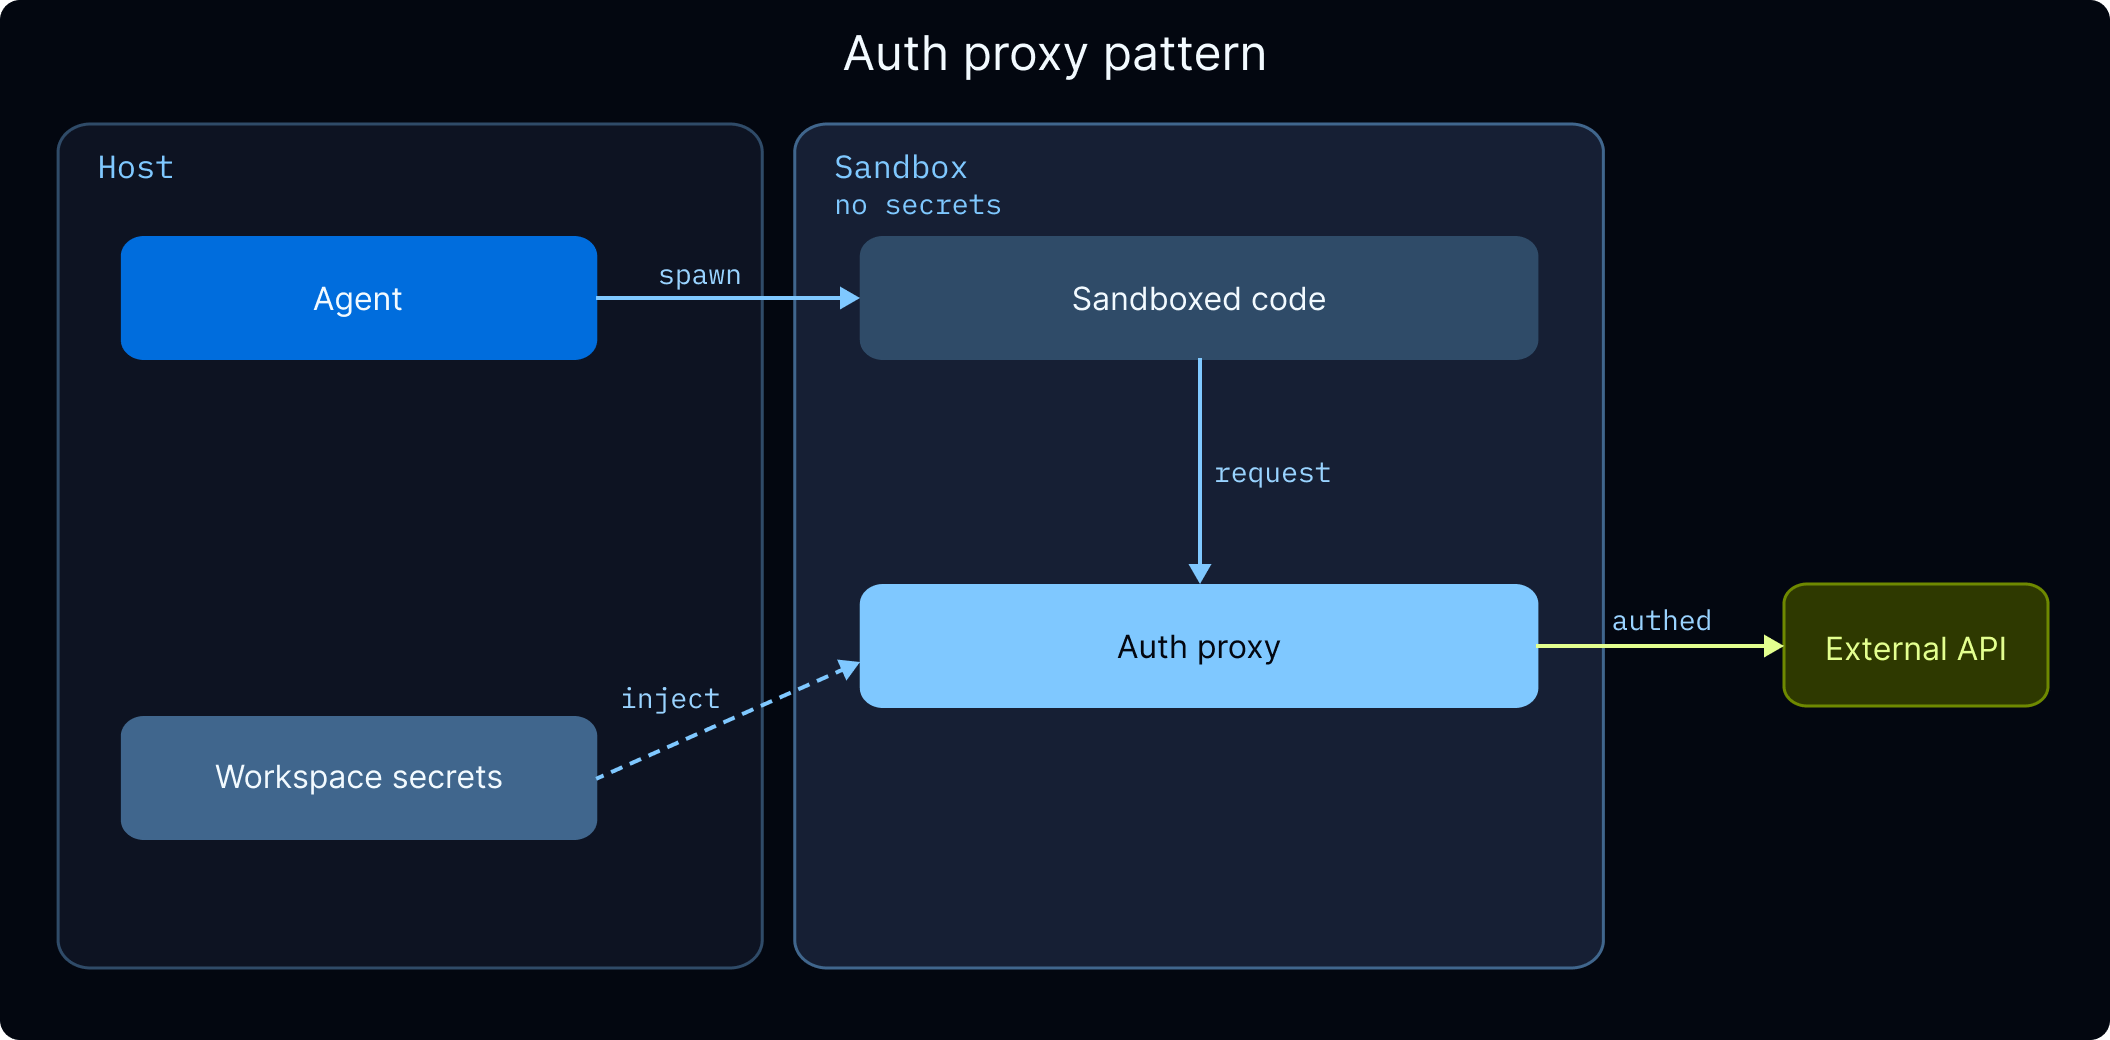
json
{
  "proxy_config": {
    "rules": [
      {
        "name": "openai-api",
        "match_hosts": ["api.openai.com"],
        "inject_headers": {
          "Authorization": "Bearer ${OPENAI_API_KEY}"
        }
      },
      {
        "name": "anthropic-api",
        "match_hosts": ["api.anthropic.com"],
        "inject_headers": {
          "x-api-key": "${ANTHROPIC_API_KEY}"
        }
      }
    ]
  }
}${SECRET_KEY} 引用会针对存储在 LangSmith 工作区设置中的机密进行解析。在创建引用它们的模板之前,先在那里配置机密。
工作区机密。 对于不需要基于代理注入的 API 密钥(例如智能体服务器本身而非沙箱代码使用的密钥),将它们存储为 LangSmith 中的工作区机密。这些在运行时作为环境变量对所有工作区中的智能体可用。
WARNING
避免通过环境变量或文件上传将机密传入沙箱。智能体可以读取沙箱内任何可访问的文件或环境变量,包括凭据。认证代理让机密完全远离沙箱。
护栏
生产环境中的智能体自主运行,这意味着它们可能无限循环、触达速率限制,或处理包含敏感信息的用户数据。Deep Agents 提供两层保护:
权限
权限是声明式的允许/拒绝规则,控制智能体可以读取或写入哪些文件和目录。使用权限将智能体隔离到某个工作目录、保护敏感文件,或强制只读记忆。规则按声明顺序求值,第一个匹配的规则生效。
容错
有关速率限制、重试、回退和错误处理,请参阅容错。
数据隐私
如果你的智能体处理的用户输入可能包含电子邮件、信用卡号或其他 PII,你可以在它到达模型或被存储到日志之前检测并处理它:
python
from deepagents import create_deep_agent
from langchain.agents.middleware import PIIMiddleware

agent = create_deep_agent(
    model="google_genai:gemini-3.6-flash",
    middleware=[
        PIIMiddleware("email", strategy="redact", apply_to_input=True),
        PIIMiddleware("credit_card", strategy="mask", apply_to_input=True),
    ],
)策略包括 redact(替换为 [REDACTED_EMAIL])、mask(像 ****-****-****-1234 这样的部分遮蔽)、hash(确定性哈希)和 block(抛出错误)。你也可以为特定领域的模式编写自定义检测器。 完整配置请参阅 PIIMiddleware。
默认的 Deep Agents middleware 栈请参阅定制。其他 LangChain 预构建 middleware(重试、回退、PII 检测等)请参阅预构建 middleware。
前端
Deep Agents 使用 useStream 将你的 UI 连接到智能体后端。useStream 是一个前端钩子(可用于 React、Vue、Svelte 和 Angular),它实时流式输出智能体中的消息、子智能体进度和自定义状态。
在本地,useStream 指向 http://localhost:2024。在生产环境中,将其指向你的 LangSmith 部署并配置重连,以便用户在连接中断时不会丢失进度。
tsx
import { useStream } from "@langchain/react";

function App() {
  const stream = useStream<typeof agent>({
    apiUrl: "https://your-deployment.langsmith.dev",
    assistantId: "agent",
  });
}对于会生成许多子智能体的深度智能体工作流,提交时设置较高的 recursionLimit,以避免截断长时间运行的执行:
tsx
stream.submit(
  { messages: [{ type: "human", content: text }] },
  {
    streamSubgraphs: true,
    config: { recursionLimit: 10000 },
  },
);深度智能体专属的 UI 模式(例如子智能体卡片、待办列表和自定义状态渲染),请参阅前端指南。