
主题
检查点器
LangGraph 检查点器在每一步将图状态保存为检查点,从而实现持久化、人在回路和容错执行。
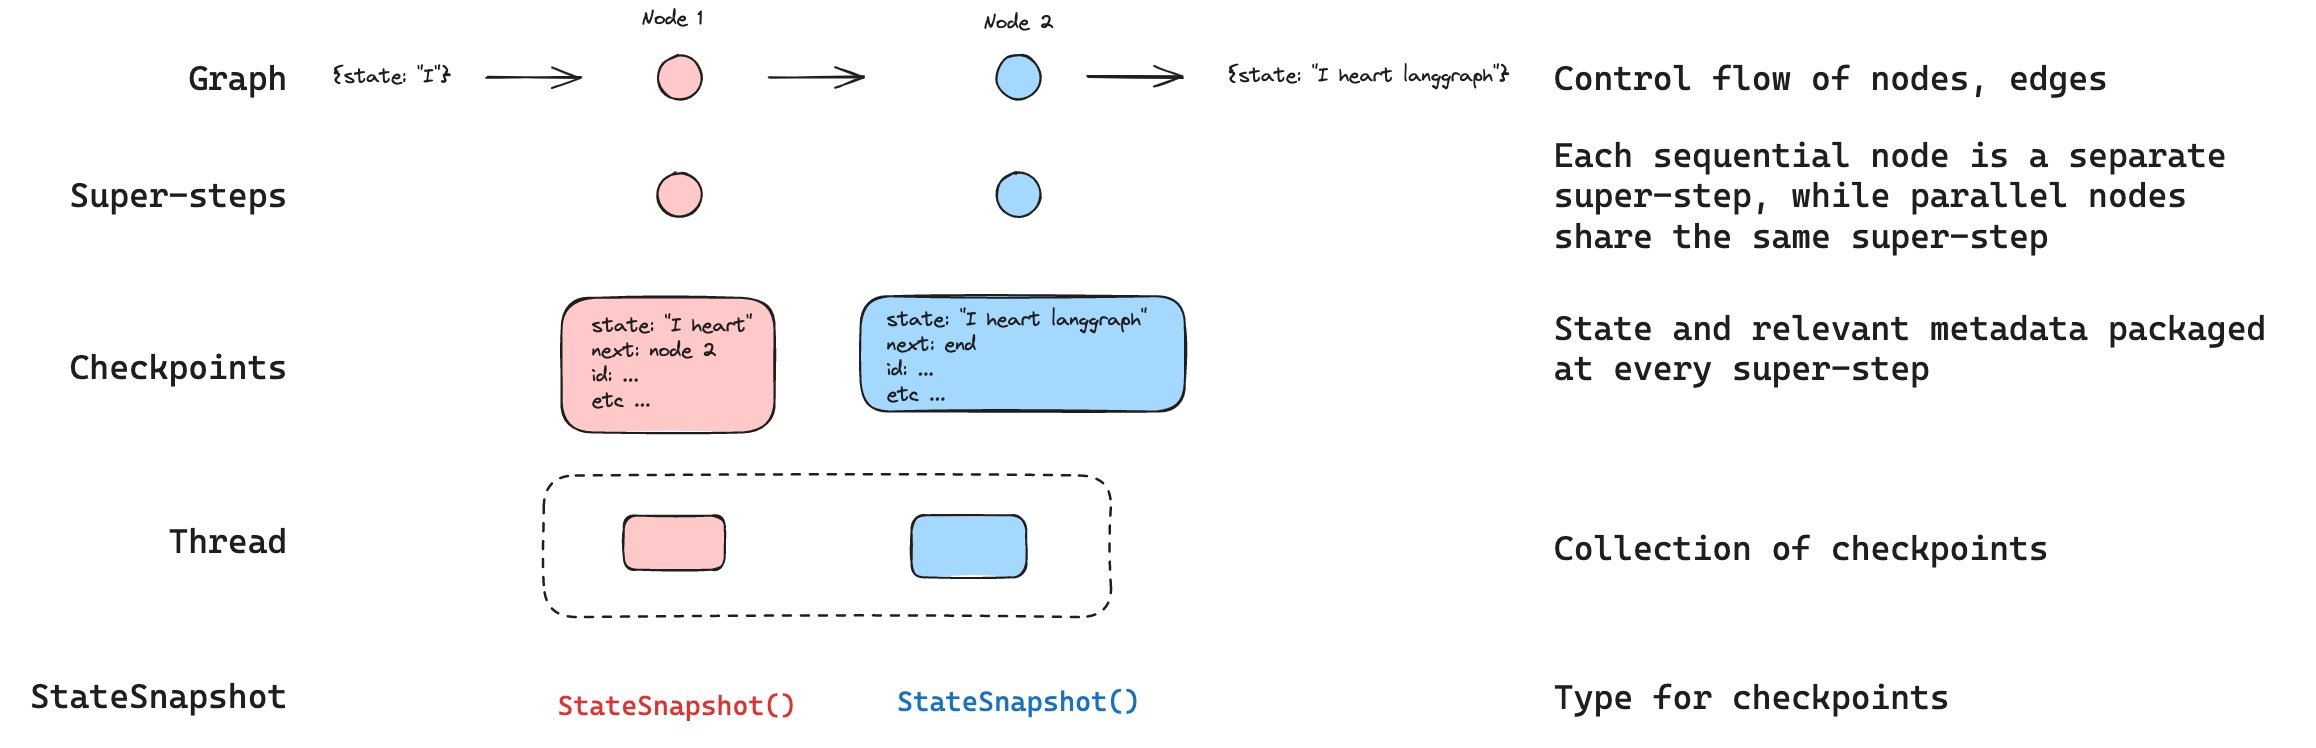
检查点器在每个 super-step 保存图状态的快照,并按线程组织。使用检查点器编译图,即可启用人在回路工作流、时间旅行调试、容错执行和对话记忆。
INFO
Agent Server 会自动处理检查点化 使用 Agent Server 时,你无需手动实现或配置检查点器。服务器会在幕后为你处理所有持久化基础设施。
为什么要使用检查点器
以下功能需要检查点器:
- 人在回路:检查点器通过允许人类检查、中断和批准图的各个步骤,来支持人在回路工作流。这些工作流需要检查点器,因为人员必须能够随时查看图的状态,而且图必须能够在人员对状态做出任何更新后恢复执行。示例请参阅中断。
- 记忆:检查点器支持交互之间的“记忆”。在重复的人际交互(如对话)中,任何后续消息都可以发送到该线程,而该线程会保留对先前消息的记忆。有关如何使用检查点器添加和管理对话记忆的信息,请参阅添加记忆。
- 时间旅行:检查点器支持“时间旅行”,允许用户重放先前的图执行,以查看和/或调试特定的图步骤。此外,检查点器还使在任意检查点处分叉图状态以探索替代轨迹成为可能。
- 容错:检查点化提供容错和错误恢复:如果一个或多个节点在给定的 superstep 失败,你可以从上一个成功的步骤重新启动图。
- 待处理写入:当图节点在给定的 super-step 执行途中失败时,LangGraph 会存储在该 super-step 中已成功完成的其他任何节点的待处理检查点写入。当你从该 super-step 恢复图执行时,不会重新运行那些成功的节点。
核心概念
线程
线程是分配给检查点器保存的每个检查点的唯一 ID 或线程标识符。它包含一系列运行所累积的状态。当一个运行被执行时,助手底层图的状态会被持久化到该线程。
当使用检查点器调用图时,你必须在配置的 configurable 部分中指定一个 thread_id:
python
{"configurable": {"thread_id": "1"}}可以检索线程的当前状态和历史状态。要持久化状态,必须在执行运行之前创建线程。LangSmith API 提供了若干端点来创建和管理线程及线程状态。更多细节请参阅 API 参考。
检查点器使用 thread_id 作为存储和检索检查点的主键。没有它,检查点器就无法保存状态,也无法在中断后恢复执行,因为检查点器使用 thread_id 来加载已保存的状态。
检查点
线程在某一特定时间点的状态称为检查点。检查点是在每个 super-step 保存的图状态快照,由一个 StateSnapshot 对象表示(完整字段参考请参阅 StateSnapshot 字段)。
Super-step
LangGraph 在每个 super-step 边界创建一个检查点。super-step 是图的一次“滴答”,其中所有为该步骤调度的节点都会执行(可能并行执行)。对于像 START -> A -> B -> END 这样的顺序图,输入、节点 A 和节点 B 分别有各自的 super-step —— 每者之后都会产生一个检查点。理解 super-step 边界对于时间旅行很重要,因为你只能从检查点(即 super-step 边界)恢复执行。
除了 super-step 检查点之外,LangGraph 还会在节点(任务)级别持久化写入。当 super-step 中的每个节点完成时,其输出会作为任务条目写入检查点器的 checkpoint_writes 表,并链接到进行中的检查点。正是这些按任务的写入实现了待处理写入恢复:如果同一个 super-step 中的另一个节点失败,那么成功节点的写入已经是持久化的,恢复时无需重新运行。super-step 完成后,完整的状态快照才会被提交。
LangGraph 还会持久化 super-step 内各个节点执行的写入。这些写入作为任务存储,并用于容错:如果同一个 super-step 中的另一个节点失败,成功节点的写入在恢复时无需重新计算。这些任务写入不是完整的 StateSnapshot 检查点,因此时间旅行会从 super-step 边界的完整检查点恢复。
检查点会被持久化,并可用于在稍后恢复线程的状态。
让我们看看当一个简单的图按如下方式被调用时,会保存哪些检查点:
python
from langgraph.graph import StateGraph, START, END
from langgraph.checkpoint.memory import InMemorySaver
from langchain_core.runnables import RunnableConfig
from typing import Annotated
from typing_extensions import TypedDict
from operator import add

class State(TypedDict):
    foo: str
    bar: Annotated[list[str], add]

def node_a(state: State):
    return {"foo": "a", "bar": ["a"]}

def node_b(state: State):
    return {"foo": "b", "bar": ["b"]}

workflow = StateGraph(State)
workflow.add_node(node_a)
workflow.add_node(node_b)
workflow.add_edge(START, "node_a")
workflow.add_edge("node_a", "node_b")
workflow.add_edge("node_b", END)

checkpointer = InMemorySaver()
graph = workflow.compile(checkpointer=checkpointer)

config: RunnableConfig = {"configurable": {"thread_id": "1"}}
graph.invoke({"foo": "", "bar":[]}, config)运行该图后,将恰好有 4 个检查点:
- 空检查点,以下一个要执行的节点为
START - 带有用户输入
{'foo': '', 'bar': []}的检查点,以下一个要执行的节点为node_a - 带有
node_a的输出{'foo': 'a', 'bar': ['a']}的检查点,以下一个要执行的节点为node_b - 带有
node_b的输出{'foo': 'b', 'bar': ['a', 'b']}的检查点,没有下一个要执行的节点
请注意,bar 通道的值包含来自两个节点的输出,因为此示例为 bar 通道设置了归约器。
检查点命名空间
每个检查点都有一个 checkpoint_ns(检查点命名空间)字段,用于标识它属于哪个图或子图:
""(空字符串):该检查点属于父(根)图。"node_name:uuid":该检查点属于作为给定节点被调用的子图。对于嵌套子图,命名空间用|分隔符连接(例如"outer_node:uuid|inner_node:uuid")。
你可以通过配置从节点内部访问检查点命名空间:
python
from langchain_core.runnables import RunnableConfig

def my_node(state: State, config: RunnableConfig):
    checkpoint_ns = config["configurable"]["checkpoint_ns"]
# "" for the parent graph, "node_name:uuid" for a subgraph有关处理子图状态和检查点的更多细节,请参阅子图。
获取和更新状态
获取状态
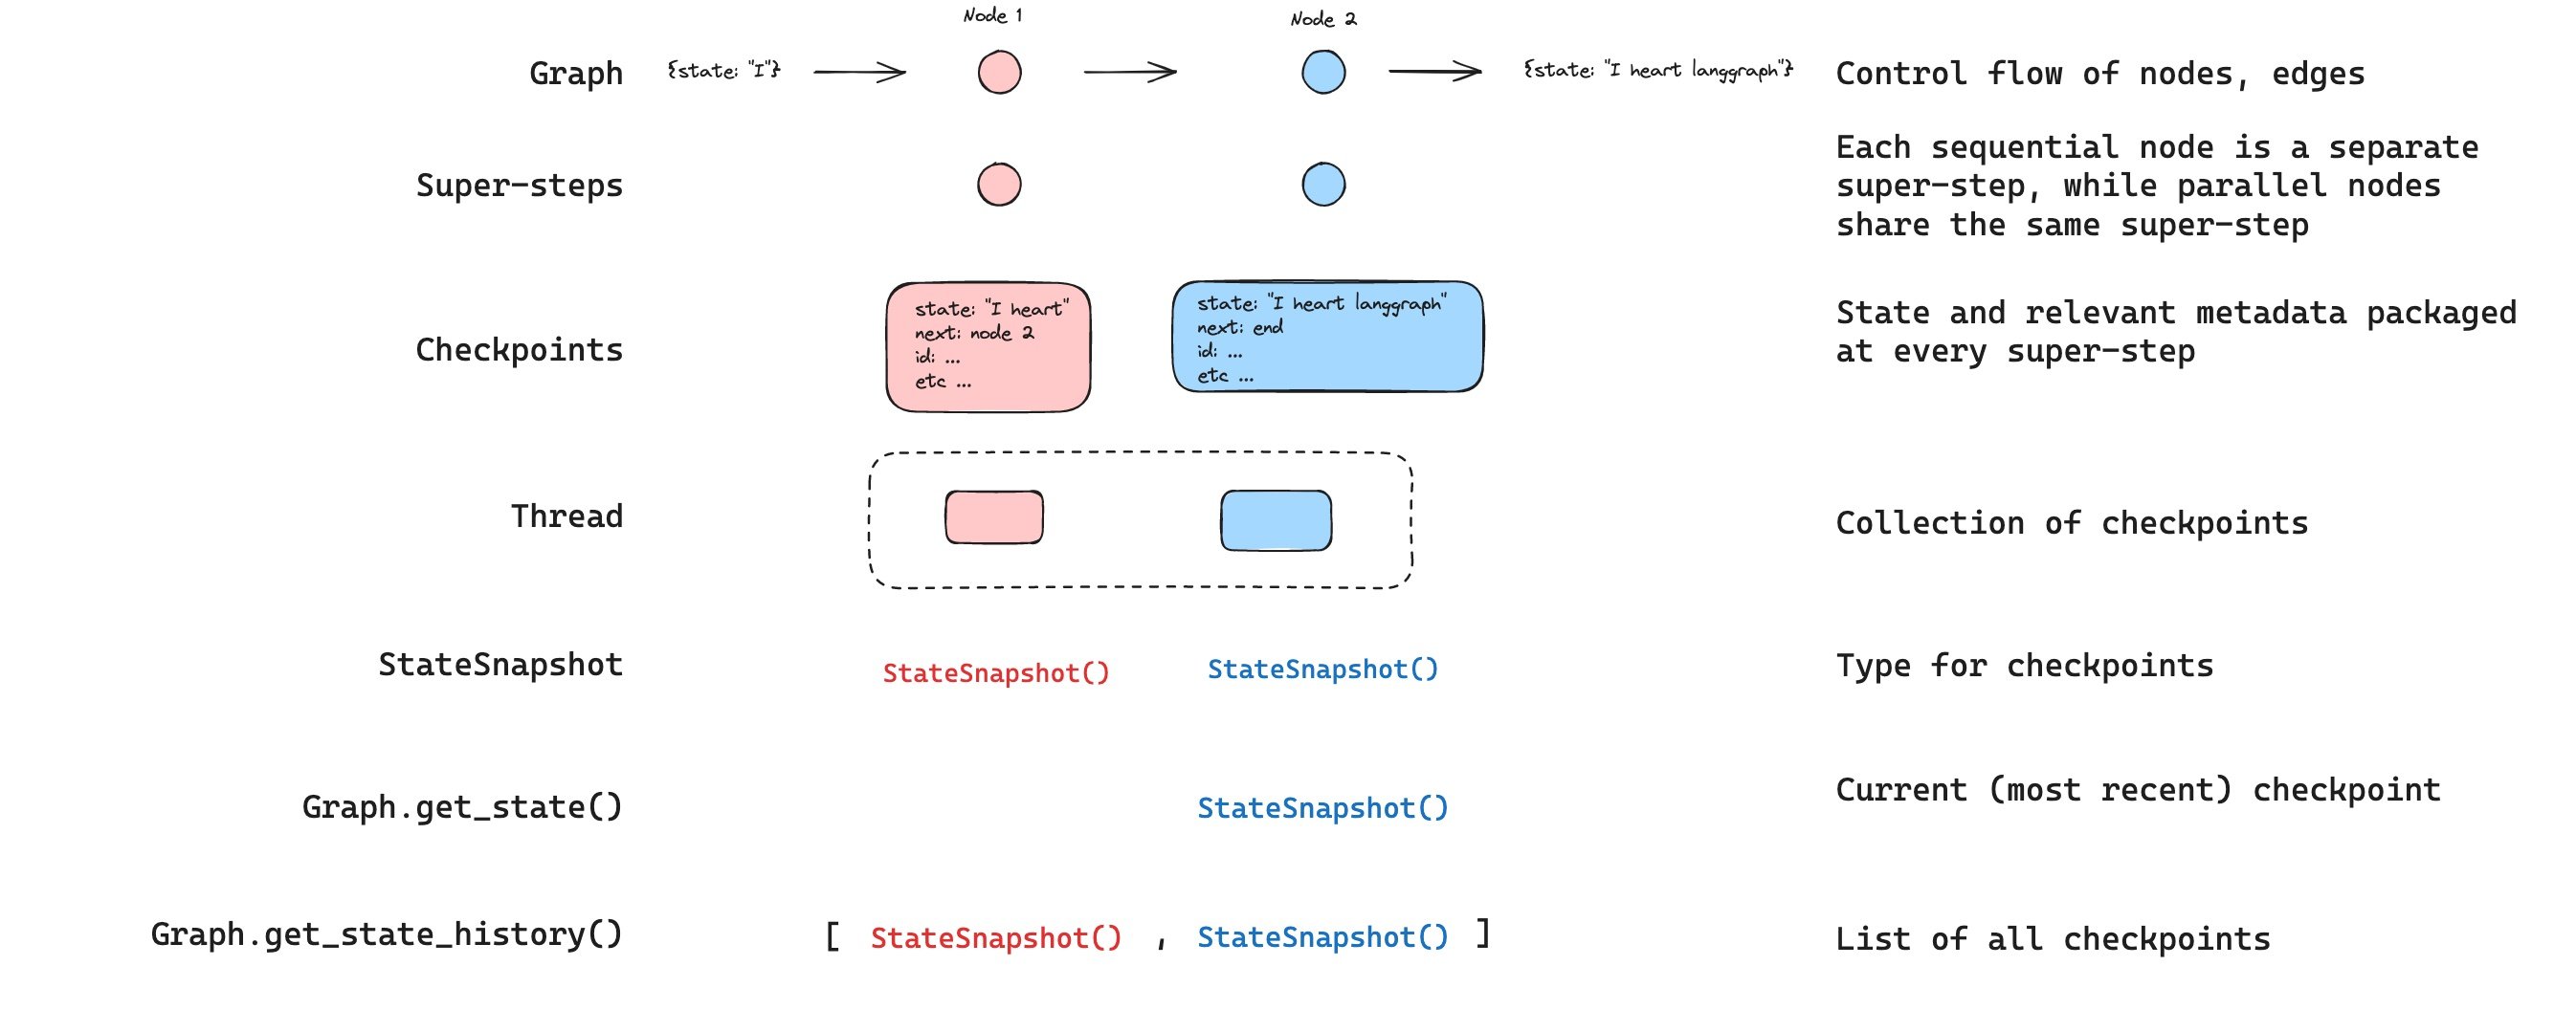
在与已保存的图状态交互时,你必须指定一个线程标识符。你可以通过调用 graph.get_state(config) 来查看图的最新状态。它将返回一个 StateSnapshot 对象,该对象对应于与配置中所提供的线程 ID 相关联的最新检查点,或者(如果提供了检查点 ID)对应于该线程的某个检查点 ID 所关联的检查点。
python
# get the latest state snapshot
config = {"configurable": {"thread_id": "1"}}
graph.get_state(config)

# get a state snapshot for a specific checkpoint_id
config = {"configurable": {"thread_id": "1", "checkpoint_id": "1ef663ba-28fe-6528-8002-5a559208592c"}}
graph.get_state(config)在此示例中,get_state 的输出如下所示:
StateSnapshot(
    values={'foo': 'b', 'bar': ['a', 'b']},
    next=(),
    config={'configurable': {'thread_id': '1', 'checkpoint_ns': '', 'checkpoint_id': '1ef663ba-28fe-6528-8002-5a559208592c'}},
    metadata={'source': 'loop', 'writes': {'node_b': {'foo': 'b', 'bar': ['b']}}, 'step': 2},
    created_at='2024-08-29T19:19:38.821749+00:00',
    parent_config={'configurable': {'thread_id': '1', 'checkpoint_ns': '', 'checkpoint_id': '1ef663ba-28f9-6ec4-8001-31981c2c39f8'}},
    tasks=()
)StateSnapshot 字段
| 字段 | 类型 | 描述 |
|---|---|---|
values | dict | 此检查点处的状态通道值。 |
next | tuple[str, ...] | 接下来要执行的节点名称。空的 () 表示图已完成。 |
config | dict | 包含 thread_id、checkpoint_ns 和 checkpoint_id。 |
metadata | dict | 执行元数据。包含 source("input"、"loop" 或 "update")、writes(节点输出)和 step(super-step 计数器)。 |
created_at | str | 此检查点创建时间的 ISO 8601 时间戳。 |
parent_config | dict | None | 上一个检查点的配置。对于第一个检查点为 None。 |
tasks | tuple[PregelTask, ...] | 此步骤要执行的任务。每个任务都有 id、name、error、interrupts,以及可选的 state(子图快照,在使用 subgraphs=True 时)。 |
获取状态历史
你可以通过调用 graph.get_state_history(config) 来获取给定线程的完整图执行历史。它将返回一个与配置中所提供的线程 ID 相关联的 StateSnapshot 对象列表。重要的是,检查点将按时间顺序排列,最新的检查点 / StateSnapshot 位于列表的第一位。
python
config = {"configurable": {"thread_id": "1"}}
list(graph.get_state_history(config))在此示例中,get_state_history 的输出如下所示:
[
    StateSnapshot(
        values={'foo': 'b', 'bar': ['a', 'b']},
        next=(),
        config={'configurable': {'thread_id': '1', 'checkpoint_ns': '', 'checkpoint_id': '1ef663ba-28fe-6528-8002-5a559208592c'}},
        metadata={'source': 'loop', 'writes': {'node_b': {'foo': 'b', 'bar': ['b']}}, 'step': 2},
        created_at='2024-08-29T19:19:38.821749+00:00',
        parent_config={'configurable': {'thread_id': '1', 'checkpoint_ns': '', 'checkpoint_id': '1ef663ba-28f9-6ec4-8001-31981c2c39f8'}},
        tasks=(),
    ),
    StateSnapshot(
        values={'foo': 'a', 'bar': ['a']},
        next=('node_b',),
        config={'configurable': {'thread_id': '1', 'checkpoint_ns': '', 'checkpoint_id': '1ef663ba-28f9-6ec4-8001-31981c2c39f8'}},
        metadata={'source': 'loop', 'writes': {'node_a': {'foo': 'a', 'bar': ['a']}}, 'step': 1},
        created_at='2024-08-29T19:19:38.819946+00:00',
        parent_config={'configurable': {'thread_id': '1', 'checkpoint_ns': '', 'checkpoint_id': '1ef663ba-28f4-6b4a-8000-ca575a13d36a'}},
        tasks=(PregelTask(id='6fb7314f-f114-5413-a1f3-d37dfe98ff44', name='node_b', error=None, interrupts=()),),
    ),
    StateSnapshot(
        values={'foo': '', 'bar': []},
        next=('node_a',),
        config={'configurable': {'thread_id': '1', 'checkpoint_ns': '', 'checkpoint_id': '1ef663ba-28f4-6b4a-8000-ca575a13d36a'}},
        metadata={'source': 'loop', 'writes': None, 'step': 0},
        created_at='2024-08-29T19:19:38.817813+00:00',
        parent_config={'configurable': {'thread_id': '1', 'checkpoint_ns': '', 'checkpoint_id': '1ef663ba-28f0-6c66-bfff-6723431e8481'}},
        tasks=(PregelTask(id='f1b14528-5ee5-579c-949b-23ef9bfbed58', name='node_a', error=None, interrupts=()),),
    ),
    StateSnapshot(
        values={'bar': []},
        next=('__start__',),
        config={'configurable': {'thread_id': '1', 'checkpoint_ns': '', 'checkpoint_id': '1ef663ba-28f0-6c66-bfff-6723431e8481'}},
        metadata={'source': 'input', 'writes': {'foo': ''}, 'step': -1},
        created_at='2024-08-29T19:19:38.816205+00:00',
        parent_config=None,
        tasks=(PregelTask(id='6d27aa2e-d72b-5504-a36f-8620e54a76dd', name='__start__', error=None, interrupts=()),),
    )
]
查找特定检查点
你可以筛选状态历史,以查找符合特定条件的检查点:
python
history = list(graph.get_state_history(config))

# Find the checkpoint before a specific node executed
before_node_b = next(s for s in history if s.next == ("node_b",))

# Find a checkpoint by step number
step_2 = next(s for s in history if s.metadata["step"] == 2)

# Find checkpoints created by update_state
forks = [s for s in history if s.metadata["source"] == "update"]

# Find the checkpoint where an interrupt occurred
interrupted = next(
    s for s in history
    if s.tasks and any(t.interrupts for t in s.tasks)
)回放
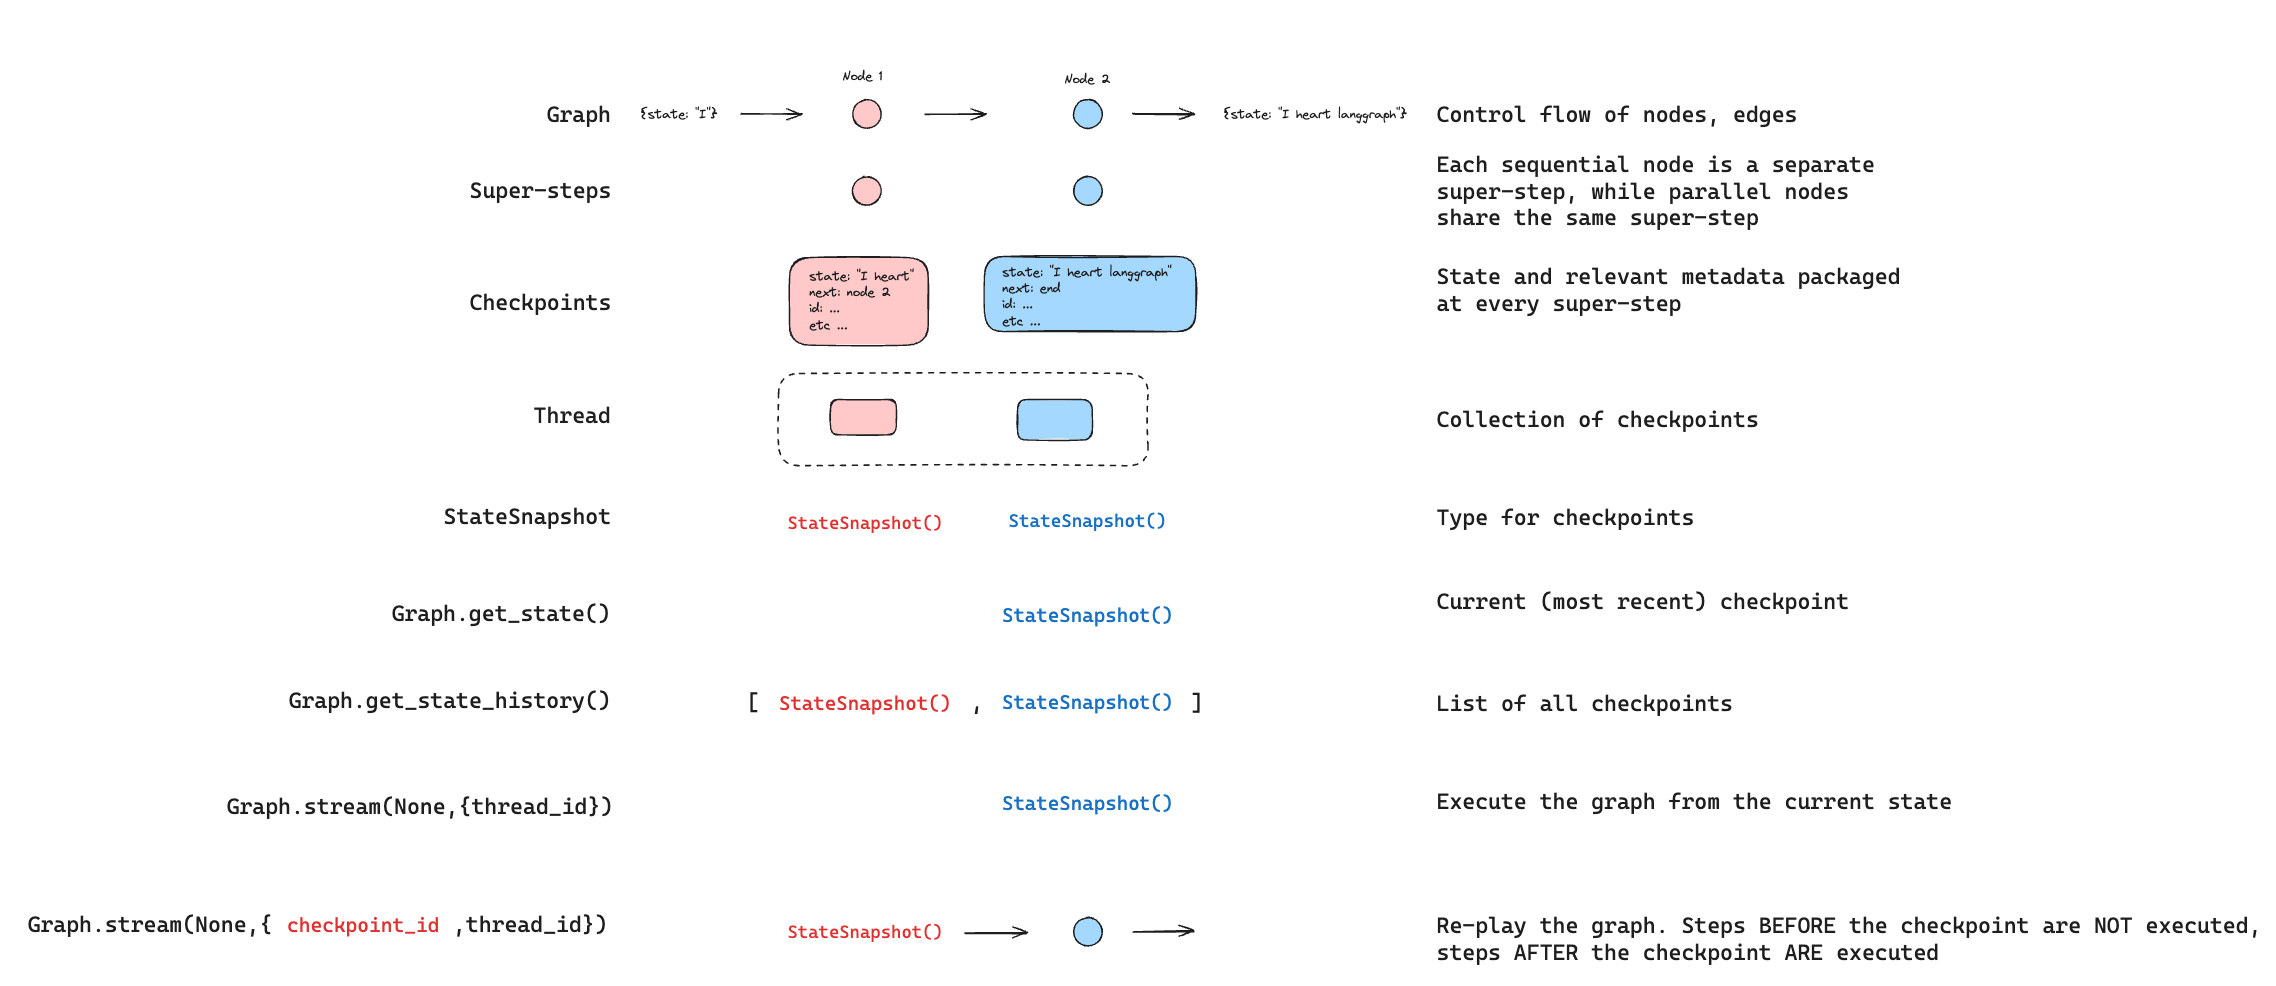
回放会从先前的检查点重新执行步骤。使用先前的 checkpoint_id 调用图,即可重新运行该检查点之后的节点。该检查点之前的节点会被跳过(它们的结果已经保存)。该检查点之后的节点会重新执行,包括任何 LLM 调用、API 请求或中断——这些在回放期间总是会被重新触发。
有关回放过去执行的完整细节和代码示例,请参阅时间旅行。
更新状态
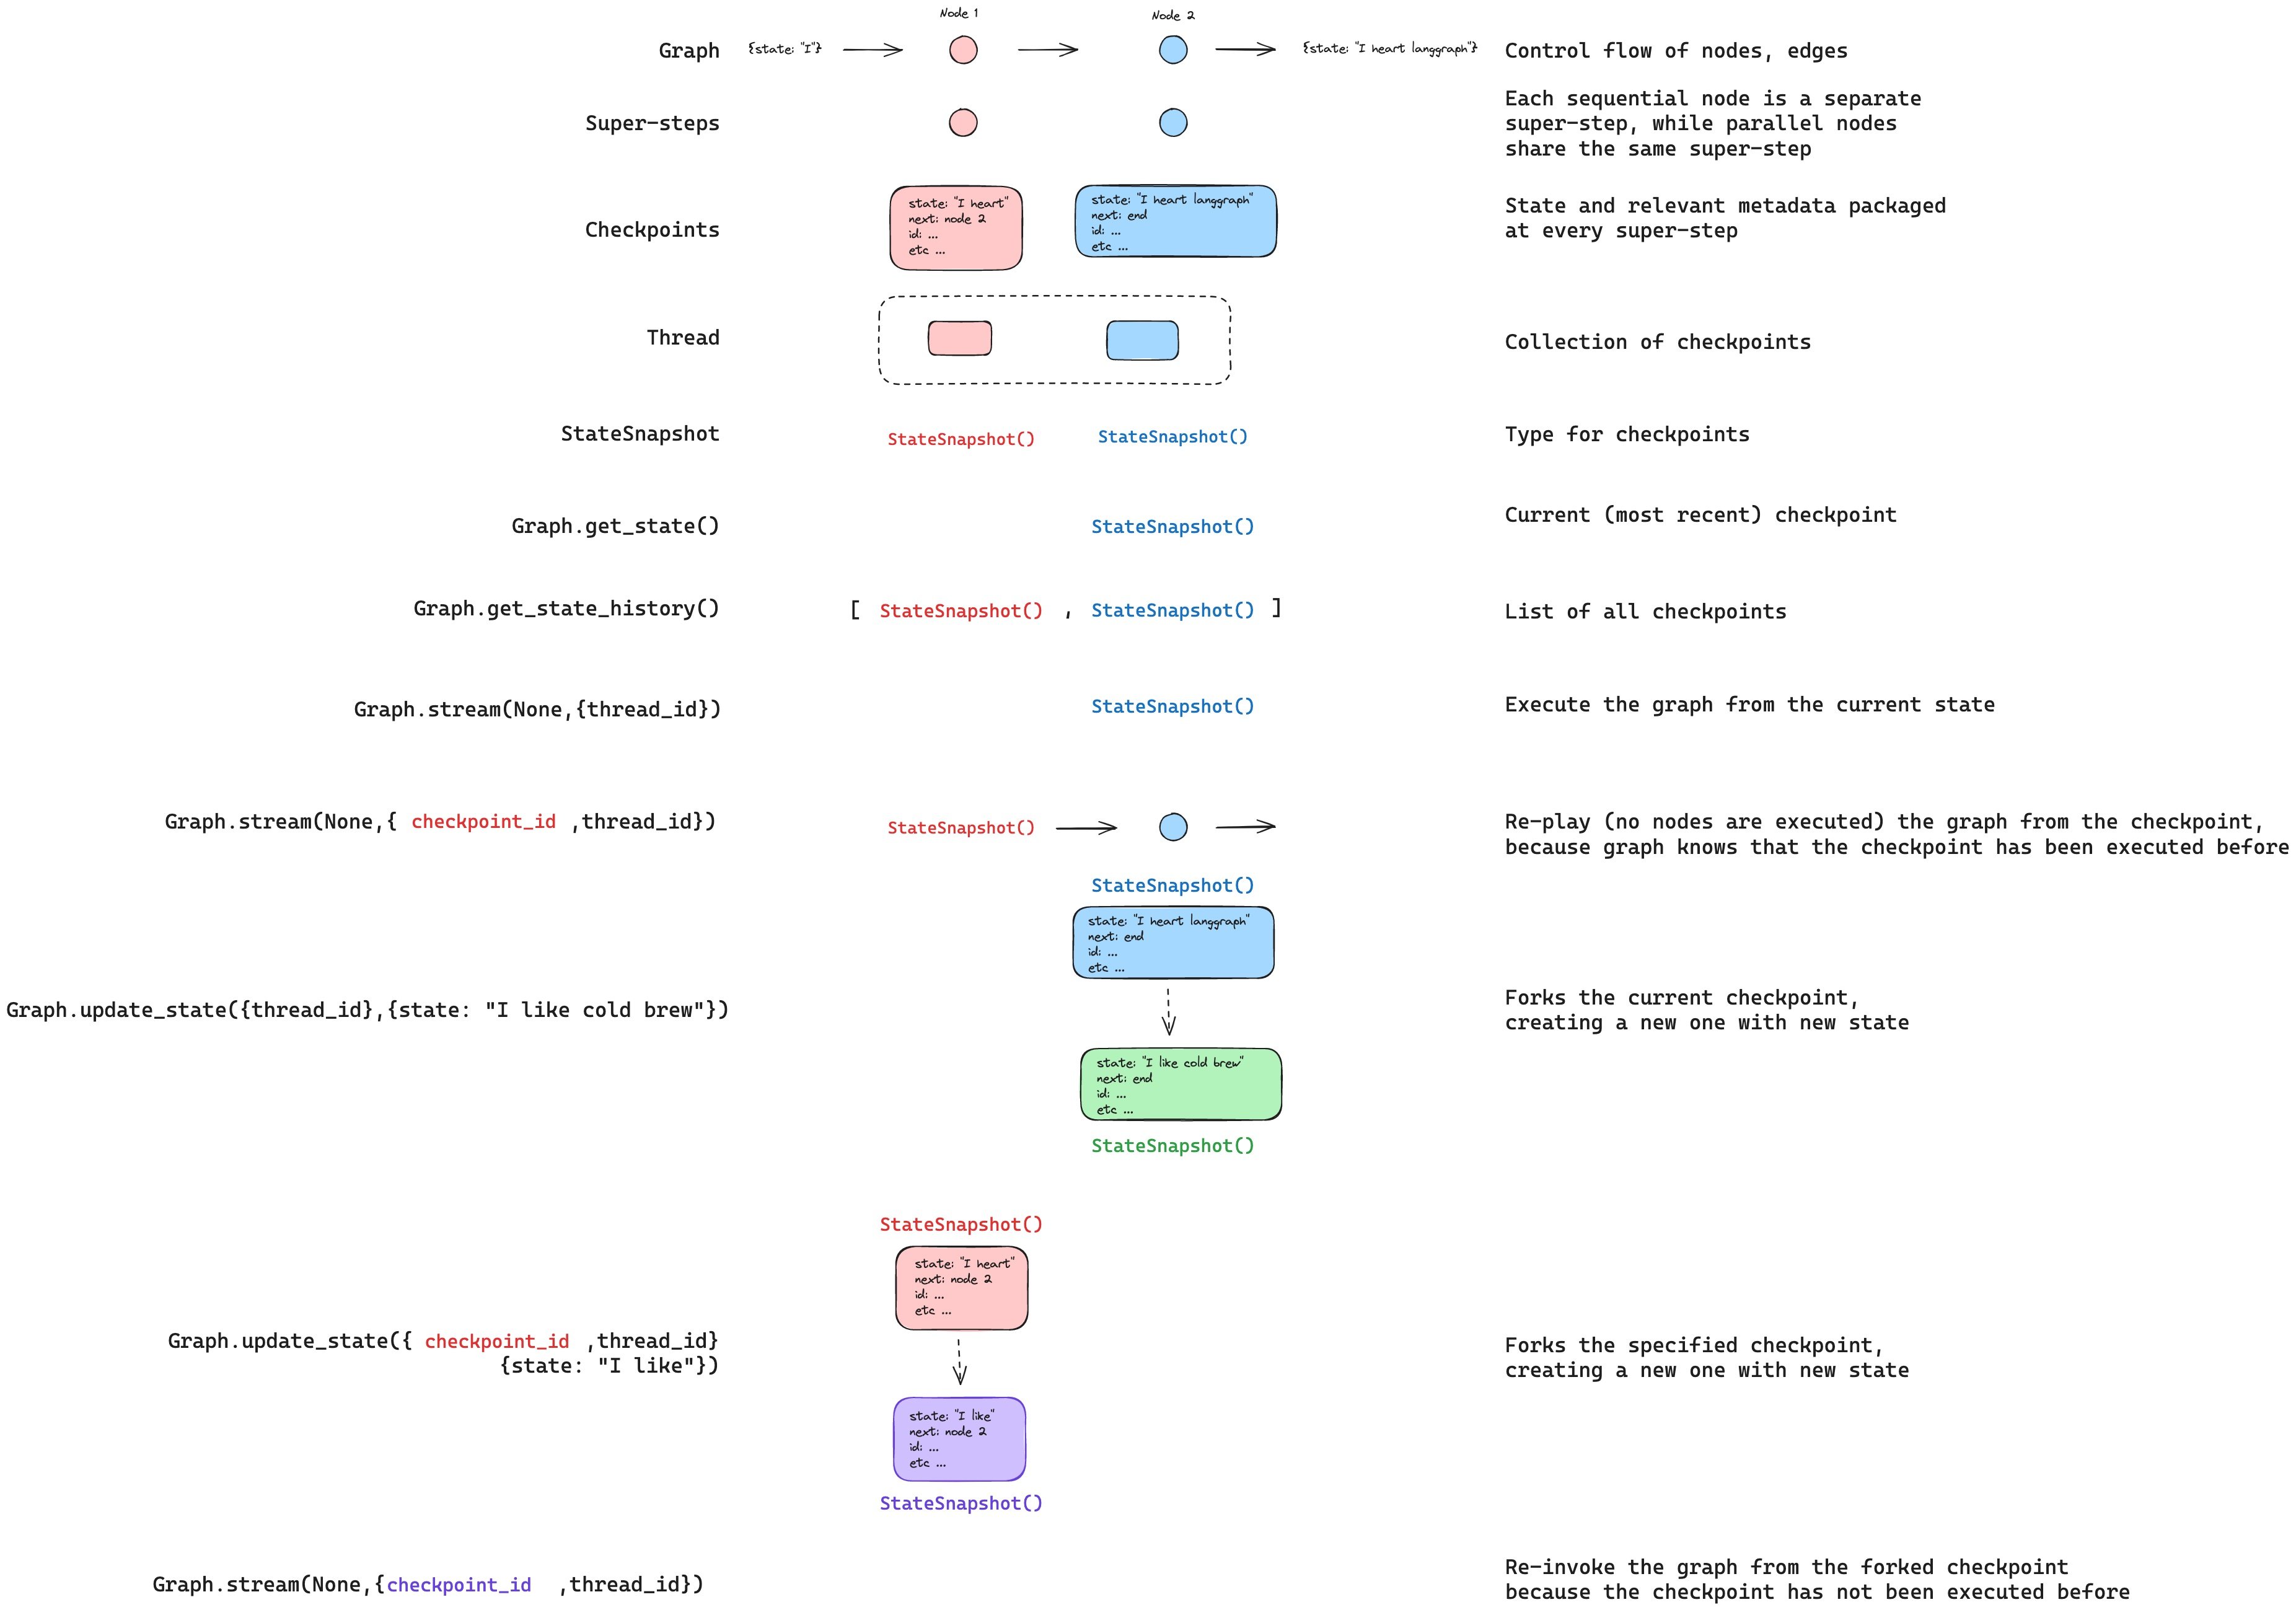
你可以使用 update_state 编辑图状态。这会用更新后的值创建一个新的检查点——它不会修改原始检查点。该更新与节点更新被同等对待:当定义了归约器函数时,值会经过这些函数处理,因此带归约器的通道会累积值,而不是覆盖它们。
你可以选择性地指定 as_node,以控制该更新被视为来自哪个节点,从而影响接下来执行哪个节点。详情请参阅时间旅行:as_node。
持久性模式
LangGraph 支持三种持久性模式,让你在性能和数据一致性之间取得平衡。你可以在调用任何图执行方法时指定持久性模式:
python
graph.stream(
    {"input": "test"},
    durability="sync"
)持久性模式按持久程度从低到高排列如下:
"exit":LangGraph 仅在图执行退出时持久化更改——无论是成功、出错,还是由于人在回路中断。这为长时间运行的图提供了最佳性能,但也意味着中间状态不会被保存,因此你无法在执行中途从系统故障(如进程崩溃)中恢复。"async":LangGraph 在下一步执行的同时异步持久化更改。这提供了良好的性能和持久性,但如果进程在执行期间崩溃,存在 LangGraph 未写入检查点的小风险。"sync":LangGraph 在下一步开始之前同步持久化更改。这确保 LangGraph 在继续执行之前写入每个检查点,以一定的性能开销为代价提供高持久性。
优化检查点存储
默认情况下,LangGraph 检查点在每个 super-step 写入每个状态通道的完整值。对于累积量很大的长时间运行线程——例如多轮对话——这可能会随时间推移导致存储显著增长。
DeltaChannel 只存储增量增量,而不是完整的累积值,从而大幅减小了大量追加的通道的检查点大小。用法以及存储与延迟之间的权衡,请参阅 DeltaChannel。
WARNING
DeltaChannel 需要 langgraph>=1.2,目前处于 beta 阶段。该 API 可能会在未来版本中发生变化。
检查点器库
在底层,检查点化由符合 BaseCheckpointSaver 接口的检查点器对象驱动。LangGraph 提供了若干检查点器实现,它们都通过独立的、可安装的库来实现。
NOTE
可用服务商请参阅检查点器集成。
langgraph-checkpoint:检查点器 saver 的基础接口(BaseCheckpointSaver)以及序列化/反序列化接口(SerializerProtocol)。包含用于实验的内存检查点器实现(InMemorySaver)。LangGraph 自带langgraph-checkpoint。langgraph-checkpoint-sqlite:使用 SQLite 数据库的 LangGraph 检查点器实现(SqliteSaver/AsyncSqliteSaver)。适合实验和本地工作流。需要单独安装。langgraph-checkpoint-postgres:使用 Postgres 数据库的高级检查点器(PostgresSaver/AsyncPostgresSaver),用于 LangSmith。适合在生产中使用。需要单独安装。langgraph-checkpoint-mongodb:使用 MongoDB 的高级检查点器(MongoDBSaver/AsyncMongoDBSaver)。适合在生产中使用。需要单独安装。langchain-azure-cosmosdb:使用 Azure Cosmos DB for NoSQL 的 LangGraph 检查点器实现(CosmosDBSaverSync/CosmosDBSaver)。适合在 Azure 生产环境中使用。支持同步和异步操作,并使用 Microsoft Entra ID 身份认证。需要单独安装。
检查点器接口
每个检查点器都符合 BaseCheckpointSaver 接口,并实现以下方法:
.put- 存储一个检查点及其配置和元数据。.put_writes- 存储链接到某个检查点的中间写入(即待处理写入)。.get_tuple- 使用给定配置(thread_id和checkpoint_id)获取一个检查点元组。它用于填充graph.get_state()中的StateSnapshot。.list- 列出符合给定配置和筛选条件的检查点。它用于填充graph.get_state_history()中的状态历史
如果检查点器与异步图执行(即通过 .ainvoke、.astream、.abatch 执行图)一起使用,则会使用上述方法的异步版本(.aput、.aput_writes、.aget_tuple、.alist)。
NOTE
要异步运行你的图,你可以使用 InMemorySaver,或 Sqlite/Postgres 检查点器的异步版本 —— AsyncSqliteSaver / AsyncPostgresSaver 检查点器。
序列化器
当检查点器保存图状态时,它们需要序列化状态中的通道值。这是通过序列化器对象完成的。
langgraph_checkpoint 定义了用于实现序列化器的协议,并提供了一个默认实现(JsonPlusSerializer),它处理各种各样的类型,包括 LangChain 和 LangGraph 原语、日期时间、枚举等。
使用 pickle 进行序列化
默认序列化器 JsonPlusSerializer 在底层使用 ormsgpack 和 JSON,这并不适合所有类型的对象。
如果你希望对于 msgpack 编码器当前不支持的对象(例如 Pandas dataframe)回退到 pickle, 你可以使用 JsonPlusSerializer 的 pickle_fallback 参数:
python
from langgraph.checkpoint.memory import InMemorySaver
from langgraph.checkpoint.serde.jsonplus import JsonPlusSerializer

# ... Define the graph ...
graph.compile(
    checkpointer=InMemorySaver(serde=JsonPlusSerializer(pickle_fallback=True))
)加密
检查点器可以选择性地加密所有持久化的状态。要启用这一点,请将一个 EncryptedSerializer 实例传递给任何 BaseCheckpointSaver 实现的 serde 参数。创建加密序列化器最简单的方法是通过 from_pycryptodome_aes,它会从 LANGGRAPH_AES_KEY 环境变量中读取 AES 密钥(或接受一个 key 参数):
python
import sqlite3

from langgraph.checkpoint.serde.encrypted import EncryptedSerializer
from langgraph.checkpoint.sqlite import SqliteSaver

serde = EncryptedSerializer.from_pycryptodome_aes()  # reads LANGGRAPH_AES_KEY
checkpointer = SqliteSaver(sqlite3.connect("checkpoint.db"), serde=serde)python
from langgraph.checkpoint.serde.encrypted import EncryptedSerializer
from langgraph.checkpoint.postgres import PostgresSaver

serde = EncryptedSerializer.from_pycryptodome_aes()
checkpointer = PostgresSaver.from_conn_string("postgresql://...", serde=serde)
checkpointer.setup()在 LangSmith 上运行时,只要存在 LANGGRAPH_AES_KEY,加密就会自动启用,因此你只需提供该环境变量。其他加密方案可以通过实现 CipherProtocol 并将其提供给 EncryptedSerializer 来使用。
构建自定义检查点器
TIP
在构建过程中使用一致性测试套件验证你的实现。它覆盖全部五个基础方法以及包括 delta 通道在内的扩展能力。请在发布前于 CI 中运行它。
本节介绍如何为自定义存储后端从零实现 BaseCheckpointSaver。如果你已经有一个可用的检查点器,只需添加 delta 通道支持,请跳转到 Delta 通道支持。
概述
LangGraph 的持久化层建立在两个存储抽象之上:
- 检查点表 —— 每个 superstep 一行;存储序列化后的图状态(
channel_values、channel_versions、versions_seen),并链接到其父检查点。 - 写入表 —— superstep 内每个节点输出一行;存储链接到某个检查点的
(task_id, channel, value)元组。
你的检查点器管理这两个表。put 写入一个检查点行;put_writes 写入节点输出行;get_tuple 将两者读回一个 CheckpointTuple。
基础契约
继承 BaseCheckpointSaver 并实现这五个方法。它们都是必需的——缺少某个基础方法会在运行时引发 NotImplementedError。
python
from collections.abc import AsyncIterator, Iterator, Sequence
from typing import Any
from langchain_core.runnables import RunnableConfig
from langgraph.checkpoint.base import (
    BaseCheckpointSaver,
    ChannelVersions,
    Checkpoint,
    CheckpointMetadata,
    CheckpointTuple,
)

class MyCheckpointer(BaseCheckpointSaver):
    async def aput(
        self,
        config: RunnableConfig,
        checkpoint: Checkpoint,
        metadata: CheckpointMetadata,
        new_versions: ChannelVersions,
    ) -> RunnableConfig:
        ...

    async def aput_writes(
        self,
        config: RunnableConfig,
        writes: Sequence[tuple[str, Any]],
        task_id: str,
        task_path: str = "",
    ) -> None:
        ...

    async def aget_tuple(self, config: RunnableConfig) -> CheckpointTuple | None:
        ...

    async def alist(
        self,
        config: RunnableConfig | None,
        *,
        filter: dict[str, Any] | None = None,
        before: RunnableConfig | None = None,
        limit: int | None = None,
    ) -> AsyncIterator[CheckpointTuple]:
        ...
        yield  # make this an async generator

    async def adelete_thread(self, thread_id: str) -> None:
...put / aput
存储一行检查点。返回一个带有已存储 checkpoint_id 的更新后配置。
关键要求:
- 使用
self.serde.dumps_typed(checkpoint)序列化检查点——它会处理所有 LangGraph 原生类型,包括 delta 通道使用的_DeltaSnapshotblob。 - 完整存储
metadata——不要剥离未知键。LangGraph 会在小版本中新增元数据字段(例如用于 delta 通道的counters_since_delta_snapshot);丢弃它们会悄无声息地破坏功能。 - 将
config["configurable"].get("checkpoint_id")存储为父检查点 ID,以便get_tuple能够填充parent_config。
python
async def aput(self, config, checkpoint, metadata, new_versions):
    thread_id = config["configurable"]["thread_id"]
    checkpoint_ns = config["configurable"]["checkpoint_ns"]
    checkpoint_id = checkpoint["id"]
    parent_id = config["configurable"].get("checkpoint_id")

    type_, blob = self.serde.dumps_typed(checkpoint)
    serialized_metadata = self.serde.dumps_typed(metadata)

    await self.db.execute(
        "INSERT INTO checkpoints (...) VALUES (...)",
        thread_id, checkpoint_ns, checkpoint_id, parent_id,
        type_, blob, *serialized_metadata,
    )
    return {
        "configurable": {
            "thread_id": thread_id,
            "checkpoint_ns": checkpoint_ns,
            "checkpoint_id": checkpoint_id,
        }
}put_writes / aput_writes
为当前 superstep 内的单个任务存储节点输出行。这些行通过 (thread_id, checkpoint_ns, checkpoint_id) 链接到检查点。
python
async def aput_writes(self, config, writes, task_id, task_path=""):
    thread_id = config["configurable"]["thread_id"]
    checkpoint_ns = config["configurable"]["checkpoint_ns"]
    checkpoint_id = config["configurable"]["checkpoint_id"]

    rows = []
    for idx, (channel, value) in enumerate(writes):
        type_, blob = self.serde.dumps_typed(value)
        final_idx = WRITES_IDX_MAP.get(channel, idx)
        rows.append((thread_id, checkpoint_ns, checkpoint_id,
                      task_id, task_path, final_idx, channel, type_, blob))

await self.db.executemany("INSERT INTO writes (...) VALUES (...)", rows)从 langgraph.checkpoint.base 导入 WRITES_IDX_MAP。它将特殊通道(__error__、__interrupt__ 等)映射到保留的负索引,以免与常规写入索引冲突。
get_tuple / aget_tuple
检索一个检查点。配置可能包含:
- 没有
checkpoint_id—— 返回该线程 + 命名空间的最新检查点。 - 有特定的
checkpoint_id—— 返回那个确切的检查点。
两条路径都必须正确工作。 特定 ID 路径用于时间旅行,并且——关键在于——用于每次图调用时的 delta 通道状态重建(请参阅 Delta 通道支持)。特定 ID 查找一旦损坏,就会悄无声息地破坏 delta 通道状态。
python
async def aget_tuple(self, config):
    thread_id = config["configurable"]["thread_id"]
    checkpoint_ns = config["configurable"].get("checkpoint_ns", "")
    checkpoint_id = config["configurable"].get("checkpoint_id")

    if checkpoint_id:
        row = await self.db.fetchone(
            "SELECT * FROM checkpoints "
            "WHERE thread_id=? AND checkpoint_ns=? AND checkpoint_id=?",
            thread_id, checkpoint_ns, checkpoint_id,
        )
    else:
        row = await self.db.fetchone(
            "SELECT * FROM checkpoints "
            "WHERE thread_id=? AND checkpoint_ns=? "
            "ORDER BY checkpoint_id DESC LIMIT 1",
            thread_id, checkpoint_ns,
        )

    if row is None:
        return None

    writes = await self.db.fetchall(
        "SELECT task_id, channel, type, value FROM writes "
        "WHERE thread_id=? AND checkpoint_ns=? AND checkpoint_id=? "
        "ORDER BY task_id, idx",
        thread_id, checkpoint_ns, row["checkpoint_id"],
    )
    pending_writes = [
        (w["task_id"], w["channel"], self.serde.loads_typed((w["type"], w["value"])))
        for w in writes
    ]

    checkpoint = self.serde.loads_typed((row["type"], row["blob"]))
    metadata = self.serde.loads_typed((row["metadata_type"], row["metadata"]))

    parent_config = None
    if row["parent_checkpoint_id"]:
        parent_config = {
            "configurable": {
                "thread_id": thread_id,
                "checkpoint_ns": checkpoint_ns,
                "checkpoint_id": row["parent_checkpoint_id"],
            }
        }

    return CheckpointTuple(
        config={
            "configurable": {
                "thread_id": thread_id,
                "checkpoint_ns": checkpoint_ns,
                "checkpoint_id": row["checkpoint_id"],
            }
        },
        checkpoint=checkpoint,
        metadata=metadata,
        parent_config=parent_config,
        pending_writes=pending_writes,
)WARNING
行键 / 索引设计对特定 ID 查找很重要。 如果你的存储使用按时间排序的键(例如反转的时间戳)且未嵌入 checkpoint_id,你就无法按 ID 直接读取行。你必须在行键中编码 checkpoint_id,或者构建二级索引。在每次查找时进行带值过滤器的扫描虽然可行,但无法扩展。
list / alist
返回某个线程的检查点,最新的在前。遵循 before(只返回早于该配置的 checkpoint_id 的检查点)和 limit。
delete_thread / adelete_thread
删除某个线程的所有检查点和写入。检查点行和写入行都必须删除。
行键 / 索引设计
你如何存储和索引检查点会直接影响正确性和性能。
推荐的 schema(SQL):
sql
CREATE TABLE checkpoints (
    thread_id          TEXT NOT NULL,
    checkpoint_ns      TEXT NOT NULL DEFAULT '',
    checkpoint_id      TEXT NOT NULL,   -- ULID, lexicographically sortable newest-last
    parent_checkpoint_id TEXT,
    type               TEXT,
    checkpoint         BYTEA,
    metadata           JSONB,
    PRIMARY KEY (thread_id, checkpoint_ns, checkpoint_id)
);

CREATE TABLE writes (
    thread_id     TEXT NOT NULL,
    checkpoint_ns TEXT NOT NULL DEFAULT '',
    checkpoint_id TEXT NOT NULL,
    task_id       TEXT NOT NULL,
    task_path     TEXT NOT NULL DEFAULT '',
    idx           INTEGER NOT NULL,
    channel       TEXT NOT NULL,
    type          TEXT,
    value         BYTEA,
    PRIMARY KEY (thread_id, checkpoint_ns, checkpoint_id, task_id, task_path, idx)
);由于 checkpoint_id 是一个 ULID,它按字典序排序——值越大越新。“获取最新”是 ORDER BY checkpoint_id DESC LIMIT 1;“按 ID 获取”是对主键进行等值查找。
对于非 SQL 存储: 同样的原则适用。无论你使用什么键方案,通过 (thread_id, checkpoint_ns, checkpoint_id) 直接查找都必须是 O(1) 或接近 O(1)。避免那种只能通过扫描某个线程的所有行才能按 ID 找到检查点的设计。
序列化
始终对检查点、写入和元数据使用 self.serde(继承自 BaseCheckpointSaver,默认是 JsonPlusSerializer)。不要对元数据直接使用 pickle——它虽然可行,但 JsonPlusSerializer 能产生人类可读的输出,并且更好地处理版本管理。
JsonPlusSerializer 会自动处理所有 LangGraph 原生类型:
_DeltaSnapshot—— delta 通道使用的哨兵 blob(msgpack 扩展代码 7)- Pydantic v2 模型、dataclass、numpy 数组、日期时间、枚举等
如果你编写自定义序列化器,请确保它能对来自 langgraph.checkpoint.serde.types 的 _DeltaSnapshot 进行往返转换。
扩展能力
这些方法是可选的,但能解锁额外的 Agent Server 功能。如果你的存储后端能够高效支持它们,请实现它们。
| 方法 | 它启用的功能 |
|---|---|
adelete_for_runs | 回滚多任务策略 |
acopy_thread | 高效的线程分叉 |
aprune | 线程历史剪枝 |
aget_delta_channel_history | 高效的 delta 通道状态重建(见下文) |
Agent Server 会在启动时自动检测你的检查点器实现了哪些能力,并激活相应的功能。
Delta 通道支持
INFO
DeltaChannel 处于 beta 阶段。 在设计趋于稳定期间,API 和磁盘上的表示形式可能会发生变化。
DeltaChannel 是一种归约器通道,它在检查点 blob 中只存储一个哨兵值(MISSING),而不是完整的通道值。状态通过归约器重放祖先写入来重建。这使得检查点 blob 在每一步为 O(1),而不是像 messages 这类随时间累积的通道那样为 O(N)。
运行时需要什么
当加载一个其 delta 通道不在 channel_values 中的检查点时,LangGraph 会调用 saver.get_delta_channel_history(config=config, channels=[...])。它会为每个通道返回:
writes—— 祖先链中对那个通道的所有写入,从最旧开始,直到最近的快照。seed(可选)—— 最近一个拥有_DeltaSnapshotblob 的祖先处所存储的该 blob;如果向上遍历到达根节点都没有找到快照,则该值缺省。
然后运行时调用 channel.from_checkpoint(seed) 和 channel.replay_writes(writes) 来重建实时值。
默认实现
BaseCheckpointSaver 提供了一个默认的 get_delta_channel_history,它可与任何正确的 get_tuple 实现配合使用:
python
# Simplified from BaseCheckpointSaver
def get_delta_channel_history(self, *, config, channels):
    target = self.get_tuple(config)          # load the head checkpoint
    cursor = target.parent_config            # walk from its parent
    collected = {ch: [] for ch in channels}
    seed = {}
    remaining = set(channels)

    while cursor and remaining:
        tup = self.get_tuple(cursor)         # ← requires correct by-id lookup
        if tup is None:
            break
        for write in reversed(tup.pending_writes or []):
            if write[1] in remaining:
                collected[write[1]].append(write)
        for ch in list(remaining):
            if ch in tup.checkpoint["channel_values"]:
                seed[ch] = tup.checkpoint["channel_values"][ch]
                remaining.discard(ch)
        cursor = tup.parent_config

    return {
        ch: {"writes": list(reversed(collected[ch])), **({"seed": seed[ch]} if ch in seed else {})}
        for ch in channels
}关键的依赖项: get_tuple(cursor) 总是以特定的 checkpoint_id(父级的 id)被调用。如果该查找返回 None,遍历会立即停止,每个 delta 通道都会重建为空——悄无声息,且没有错误。这就是为什么 get_tuple 中的特定 ID 路径必须正确。
性能重写
默认遍历会为每个祖先检查点发起一次 get_tuple 调用。对于查询支持良好的后端,可重写 get_delta_channel_history(及其异步版本),用两次查询检索祖先链和写入:
python
async def aget_delta_channel_history(self, *, config, channels):
    if not channels:
        return {}

    thread_id = config["configurable"]["thread_id"]
    checkpoint_ns = config["configurable"].get("checkpoint_ns", "")
    checkpoint_id = config["configurable"]["checkpoint_id"]

    # Stage 1: stream ancestors newest-first until every channel has a seed
    ancestors = await self.db.fetchall(
        "SELECT checkpoint_id, parent_checkpoint_id, type, checkpoint "
        "FROM checkpoints "
        "WHERE thread_id=? AND checkpoint_ns=? AND checkpoint_id < ? "
        "ORDER BY checkpoint_id DESC",
        thread_id, checkpoint_ns, checkpoint_id,
    )

    chain_by_ch: dict[str, list[str]] = {ch: [] for ch in channels}
    seed_by_ch: dict[str, Any] = {}
    remaining = set(channels)
    cur_id = config["configurable"]["checkpoint_id"]

    for row in ancestors:
        if not remaining:
            break
        parent_id = row["parent_checkpoint_id"]
        ckpt = self.serde.loads_typed((row["type"], row["checkpoint"]))
        cv = ckpt.get("channel_values") or {}
        for ch in list(remaining):
            chain_by_ch[ch].append(row["checkpoint_id"])
            if ch in cv:
                seed_by_ch[ch] = cv[ch]
                remaining.discard(ch)
        cur_id = parent_id

    # Stage 2: fetch writes for each channel's ancestor chain in one query
    result: dict[str, DeltaChannelHistory] = {}
    for ch in channels:
        chain = chain_by_ch[ch]
        if not chain:
            entry: DeltaChannelHistory = {"writes": []}
            if ch in seed_by_ch:
                entry["seed"] = seed_by_ch[ch]
            result[ch] = entry
            continue

        write_rows = await self.db.fetchall(
            f"SELECT checkpoint_id, task_id, idx, type, value FROM writes "
            f"WHERE thread_id=? AND checkpoint_ns=? AND channel=? "
            f"AND checkpoint_id IN ({','.join('?' * len(chain))})"
            f"ORDER BY checkpoint_id, task_id, idx",
            thread_id, checkpoint_ns, ch, *chain,
        )
        writes_by_cid: dict[str, list[PendingWrite]] = {}
        for row in write_rows:
            cid = row["checkpoint_id"]
            value = self.serde.loads_typed((row["type"], row["value"]))
            writes_by_cid.setdefault(cid, []).append((row["task_id"], ch, value))

        # chain is newest-first; iterate oldest-first to get correct replay order
        collected: list[PendingWrite] = []
        for cid in reversed(chain):
            collected.extend(writes_by_cid.get(cid, []))

        entry = {"writes": collected}
        if ch in seed_by_ch:
            entry["seed"] = seed_by_ch[ch]
        result[ch] = entry

return result使用 delta 通道进行剪枝
DeltaChannel 状态并非自包含在单个检查点中——它依赖于一直回溯到最近的 _DeltaSnapshot 的祖先写入链。如果你实现 prune 或 delete_for_runs,你绝不能删除幸存检查点的 delta 通道所依赖的写入行。
安全选项:
- 剪枝前先遍历 —— 对于每个你打算保留的检查点,遍历其祖先链,并将直到最近的
_DeltaSnapshot为止的所有写入行标记为不可删除。 - 剪枝前强制生成快照 —— 在你保留的检查点上重写
channel_values[ch] = _DeltaSnapshot(reconstructed_value),然后就可以自由删除祖先。 - 对 delta 通道线程跳过剪枝 —— 如果你尚不需要剪枝,这是最安全的短期选项。
使用 delta 通道复制线程
在实现 copy_thread 时,复制完整的祖先链——而不仅仅是头部检查点。目标线程必须为每个 delta 通道保留一直回溯到至少一个 _DeltaSnapshot 的写入行,否则这些通道在复制后会被重建为空。
使用一致性套件进行测试
langgraph-checkpoint-conformance 会对照完整契约验证你的实现,包括 delta 通道历史:
python
pip install langgraph-checkpoint-conformancepython
import asyncio
from langgraph.checkpoint.conformance import checkpointer_test, validate

@checkpointer_test(name="MyCheckpointer")
async def my_checkpointer():
    async with MyCheckpointer.create() as saver:
        yield saver

async def main():
    report = await validate(my_checkpointer)
    report.print_report()
    # Fails the process if any base capability is missing or broken
    if not report.passed_all_base():
        raise RuntimeError("Checkpointer failed conformance suite")

asyncio.run(main())该套件会自动检测你的检查点器实现了哪些扩展能力(包括 aget_delta_channel_history),并为每项能力运行相关测试。请在发布前将其作为 CI 的一部分运行。