主题
如何在 UI 中筛选实验
LangSmith 允许你按反馈分数和元数据筛选之前的实验,从而轻松找到你关心的实验。
背景:为实验添加元数据
在 SDK 中运行实验时,你可以附加元数据,以便在 UI 中更轻松地筛选。如果你在运行实验时已经知道要深入分析哪些维度,这会很有帮助。
在我们的示例中,我们将围绕所使用的模型、模型提供商以及 prompt 的已知 ID 为实验附加元数据:
python
models = {
    "openai-gpt-5.5": ChatOpenAI(model="gpt-5.5", temperature=0),
    "openai-gpt-5.4-mini": ChatOpenAI(model="gpt-5.4-mini", temperature=0),
    "anthropic-claude-sonnet-4-6": ChatAnthropic(temperature=0, model_name="claude-sonnet-4-6")
}

prompts = {
    "singleminded": "always answer questions with the word banana.",
    "fruitminded": "always discuss fruit in your answers.",
    "basic": "you are a chatbot."
}

def answer_evaluator(run, example) -> dict:
    llm = ChatOpenAI(model="gpt-5.5", temperature=0)
    answer_grader = hub.pull("langchain-ai/rag-answer-vs-reference") | llm
    score = answer_grader.invoke(
        {
            "question": example.inputs["question"],
            "correct_answer": example.outputs["answer"],
            "student_answer": run.outputs,
        }
    )
    return {"key": "correctness", "score": score["Score"]}

dataset_name = "Filterable Dataset"

for model_type, model in models.items():
    for prompt_type, prompt in prompts.items():
        def predict(example):
            return model.invoke(
                [("system", prompt), ("user", example["question"])]
            )

        model_provider = model_type.split("-")[0]
        model_name = model_type[len(model_provider) + 1:]

        evaluate(
            predict,
            data=dataset_name,
            evaluators=[answer_evaluator],
            # ADD IN METADATA HERE!!
            metadata={
                "model_provider": model_provider,
                "model_name": model_name,
                "prompt_id": prompt_type
            }
)在 UI 中筛选实验
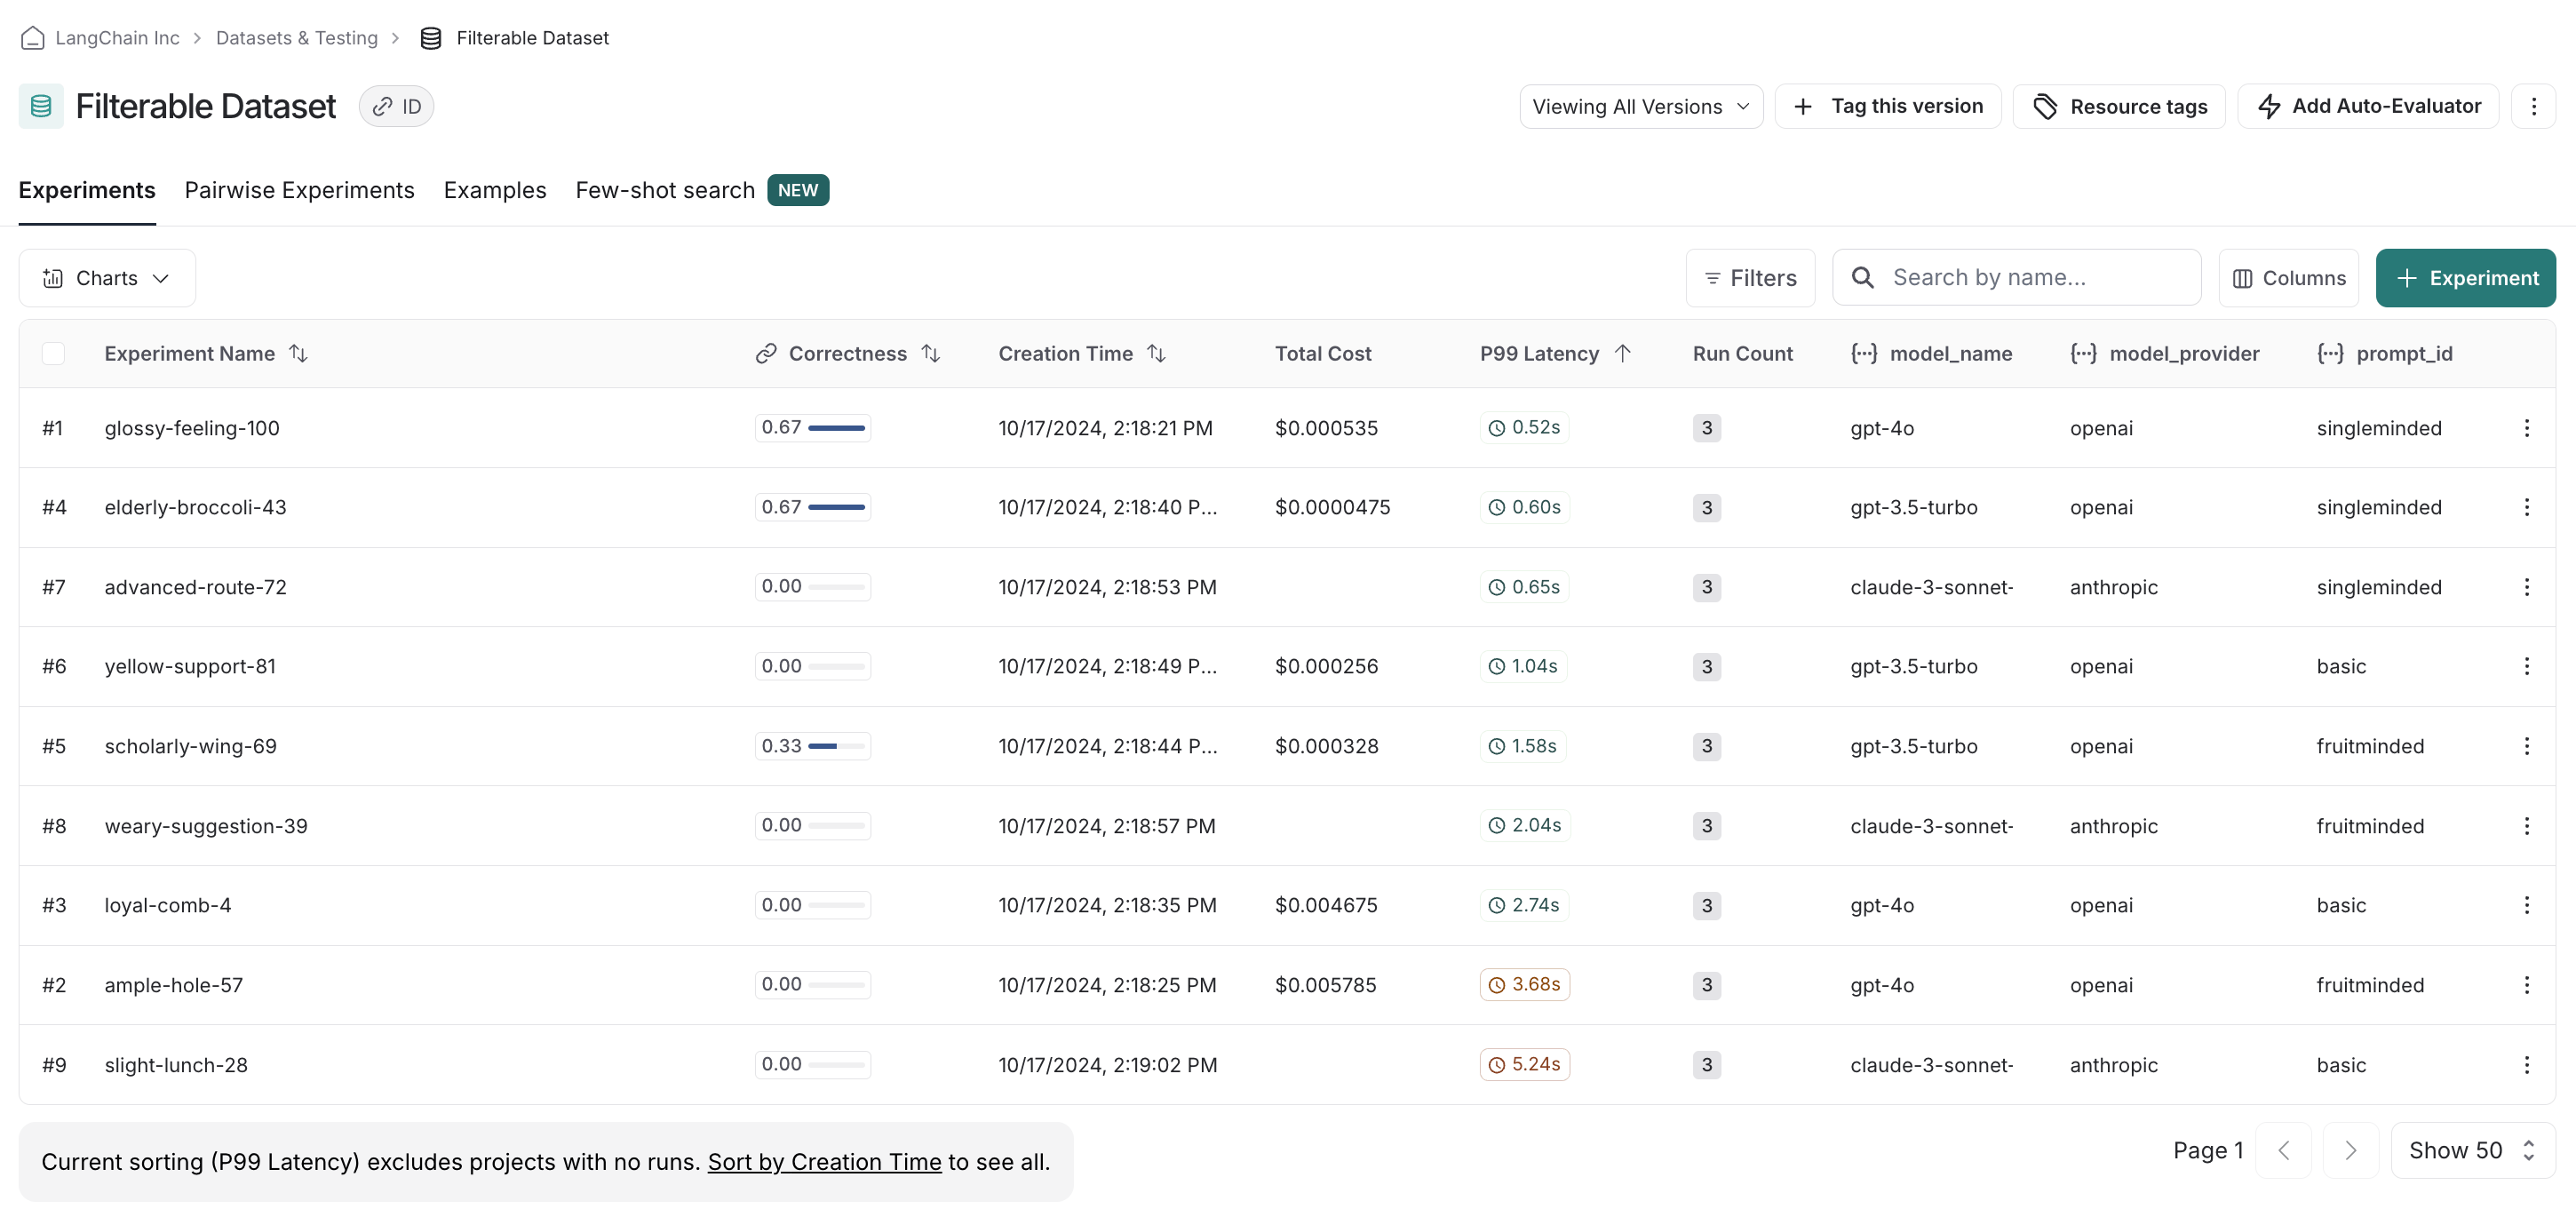
在 UI 中,默认会看到所有已运行的实验。
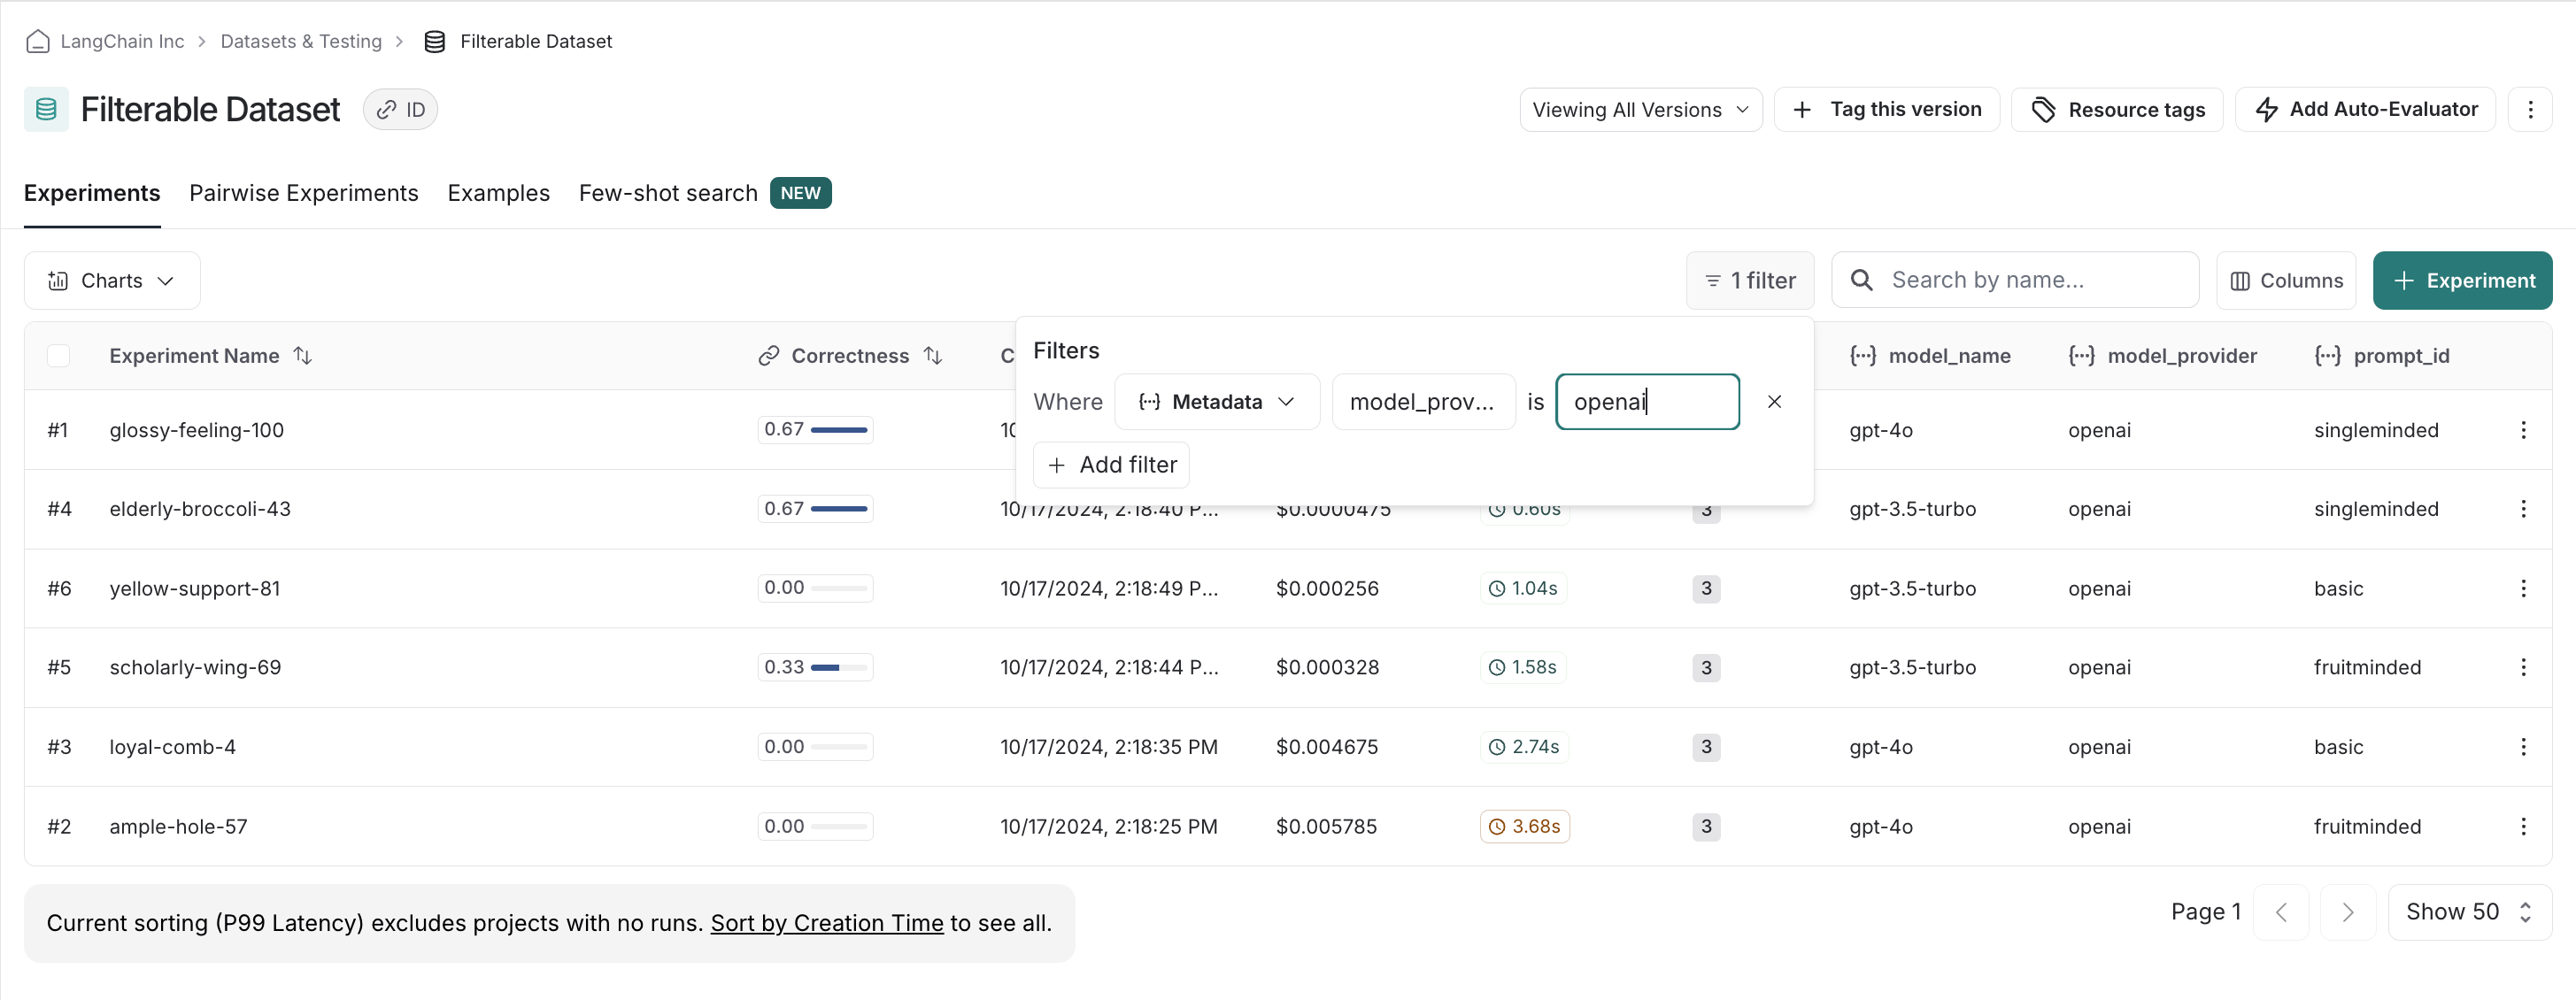
例如,如果我们偏好 openai 模型,可以轻松筛选,先只查看 openai 模型范围内的分数:
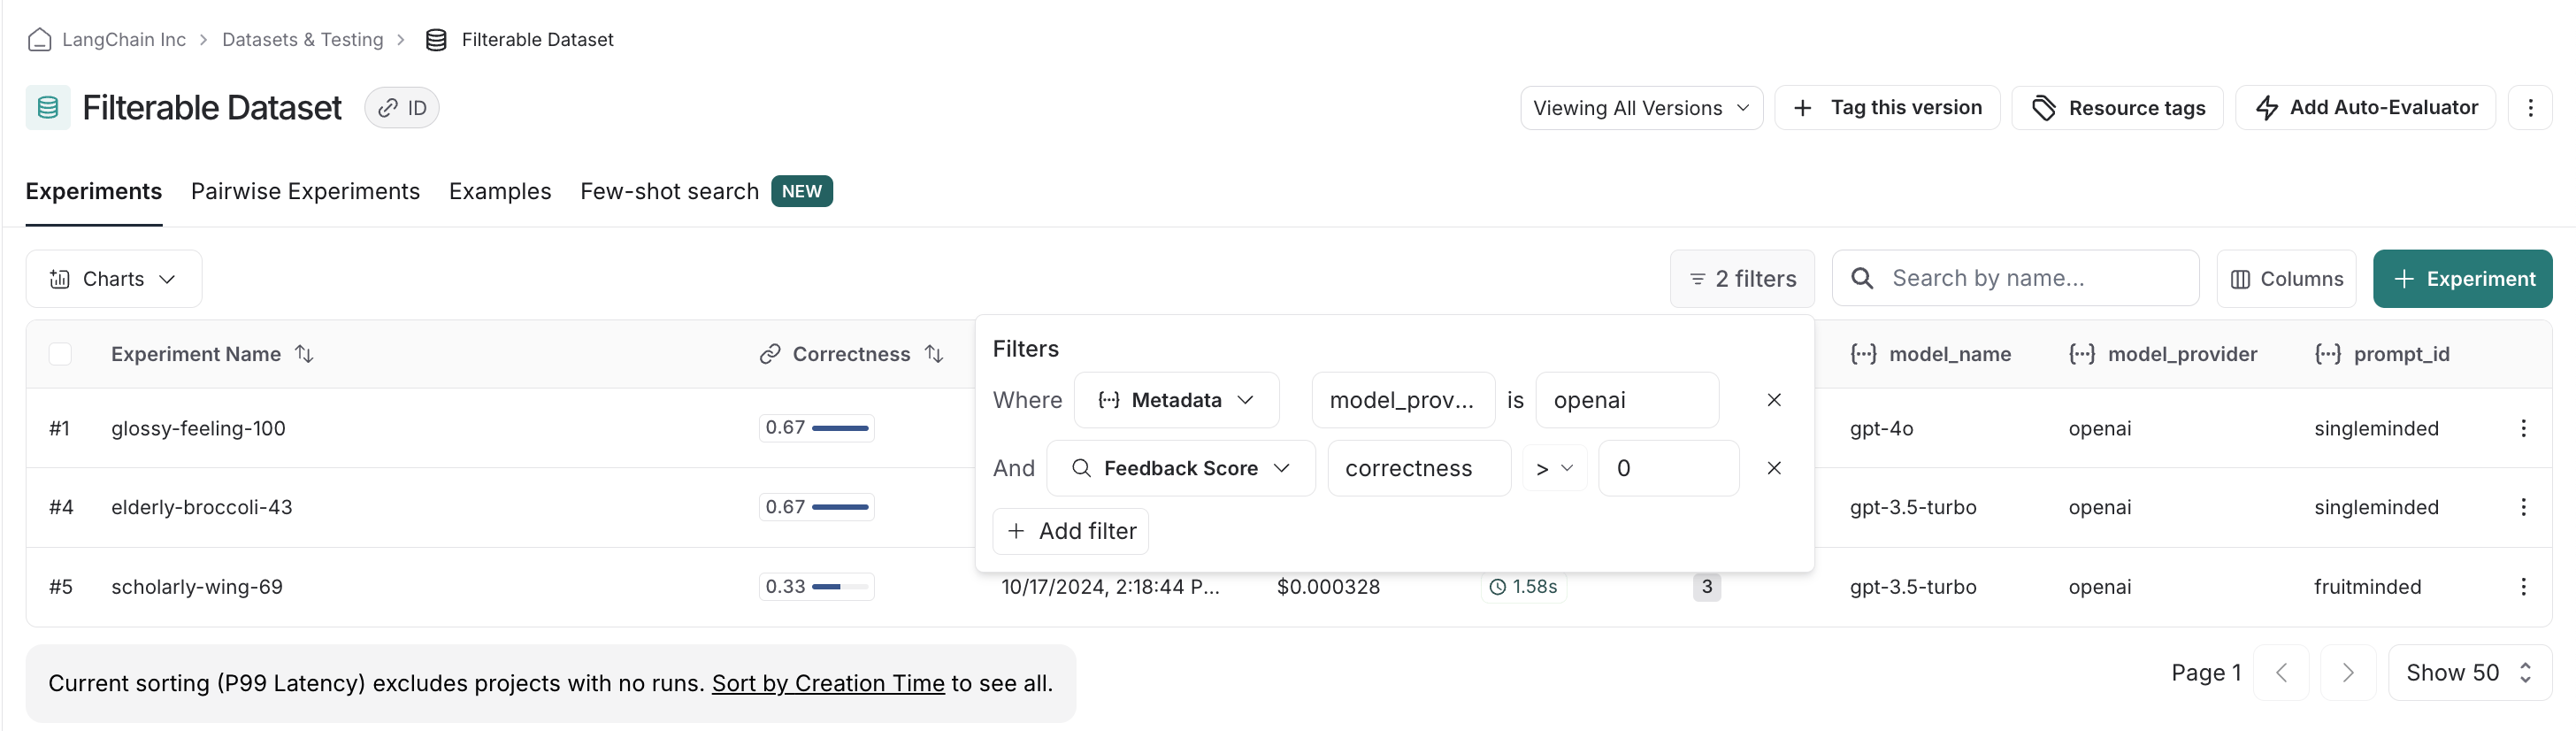
我们可以叠加筛选条件,过滤掉正确性分数较低的实验,确保只比较相关的实验:
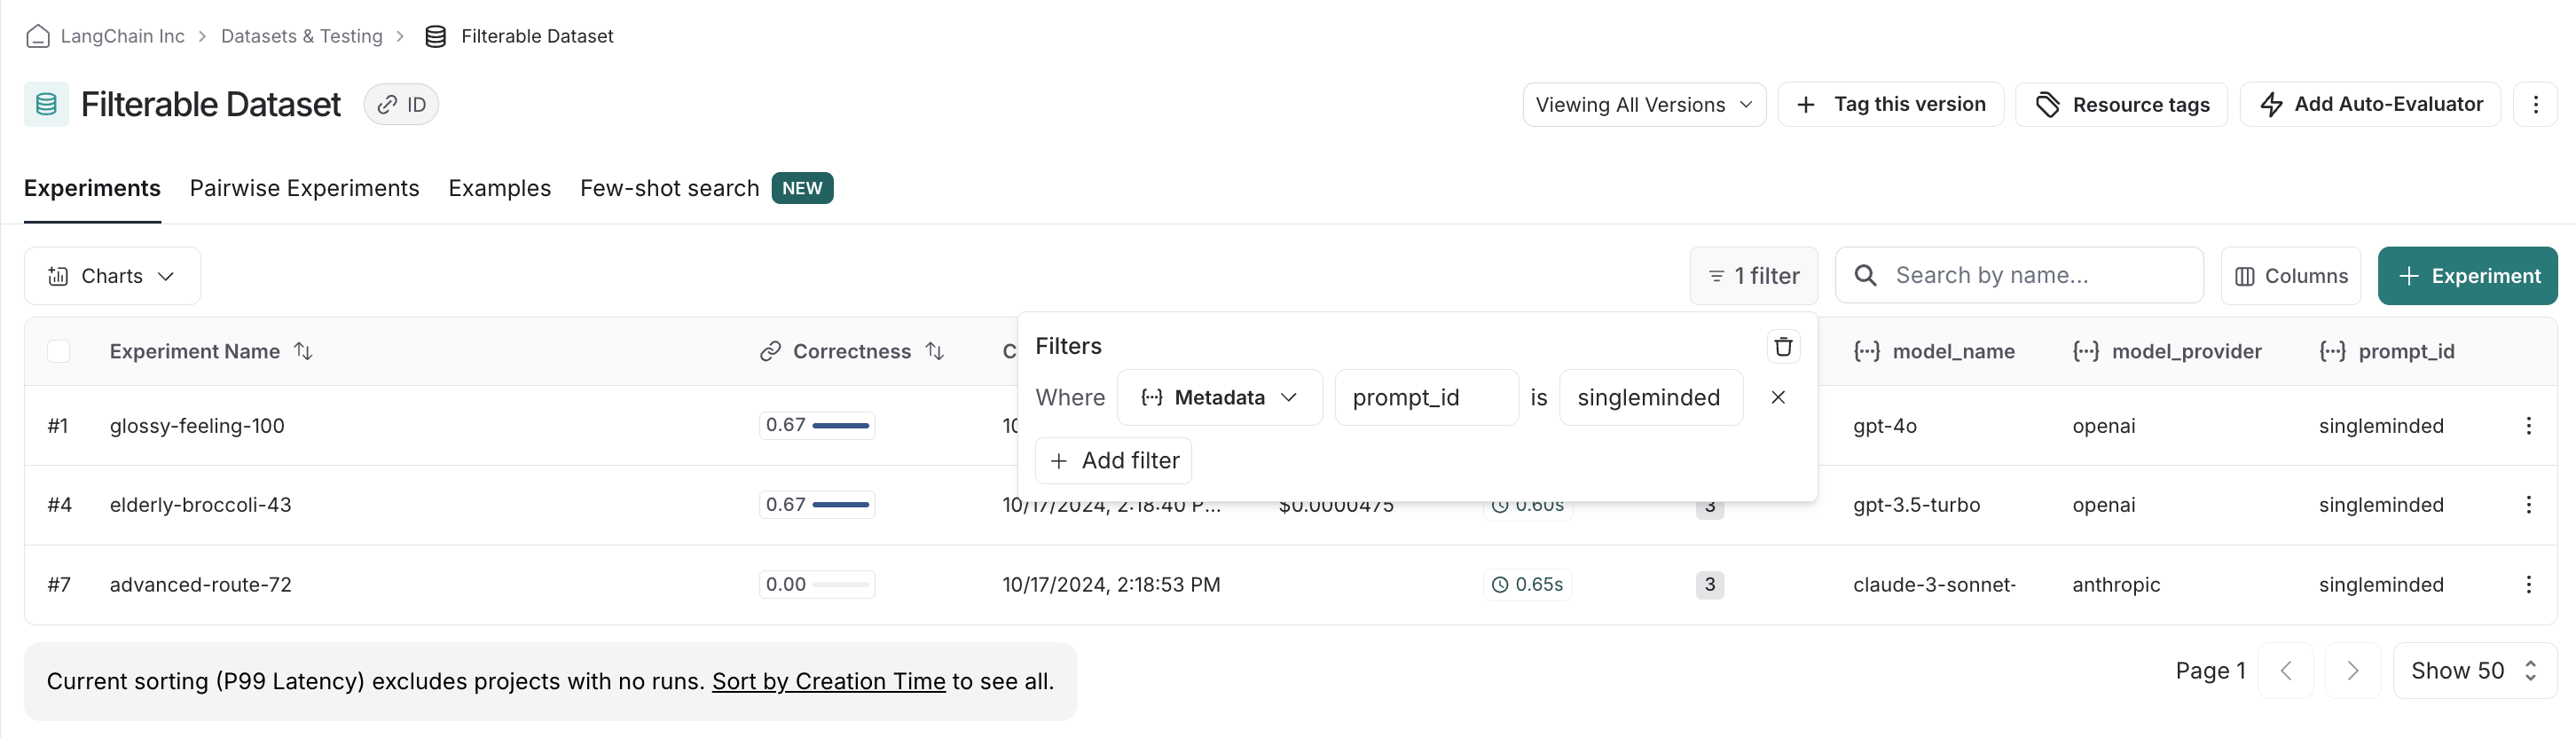
最后,我们可以清除并重置筛选条件。例如,如果我们发现 singleminded prompt 明显胜出,可以更改筛选设置,看看其他模型提供商的模型是否也能很好地配合它: