
主题
记忆
为使用 Deep Agents 构建的智能体添加持久化记忆,使它们能够在多次对话中学习和改进
记忆让你的智能体能够在多次对话中学习和改进。Deep Agents 通过基于文件系统的记忆使记忆成为一等公民:智能体以文件形式读写记忆,而你使用 后端 控制这些文件的存储位置。
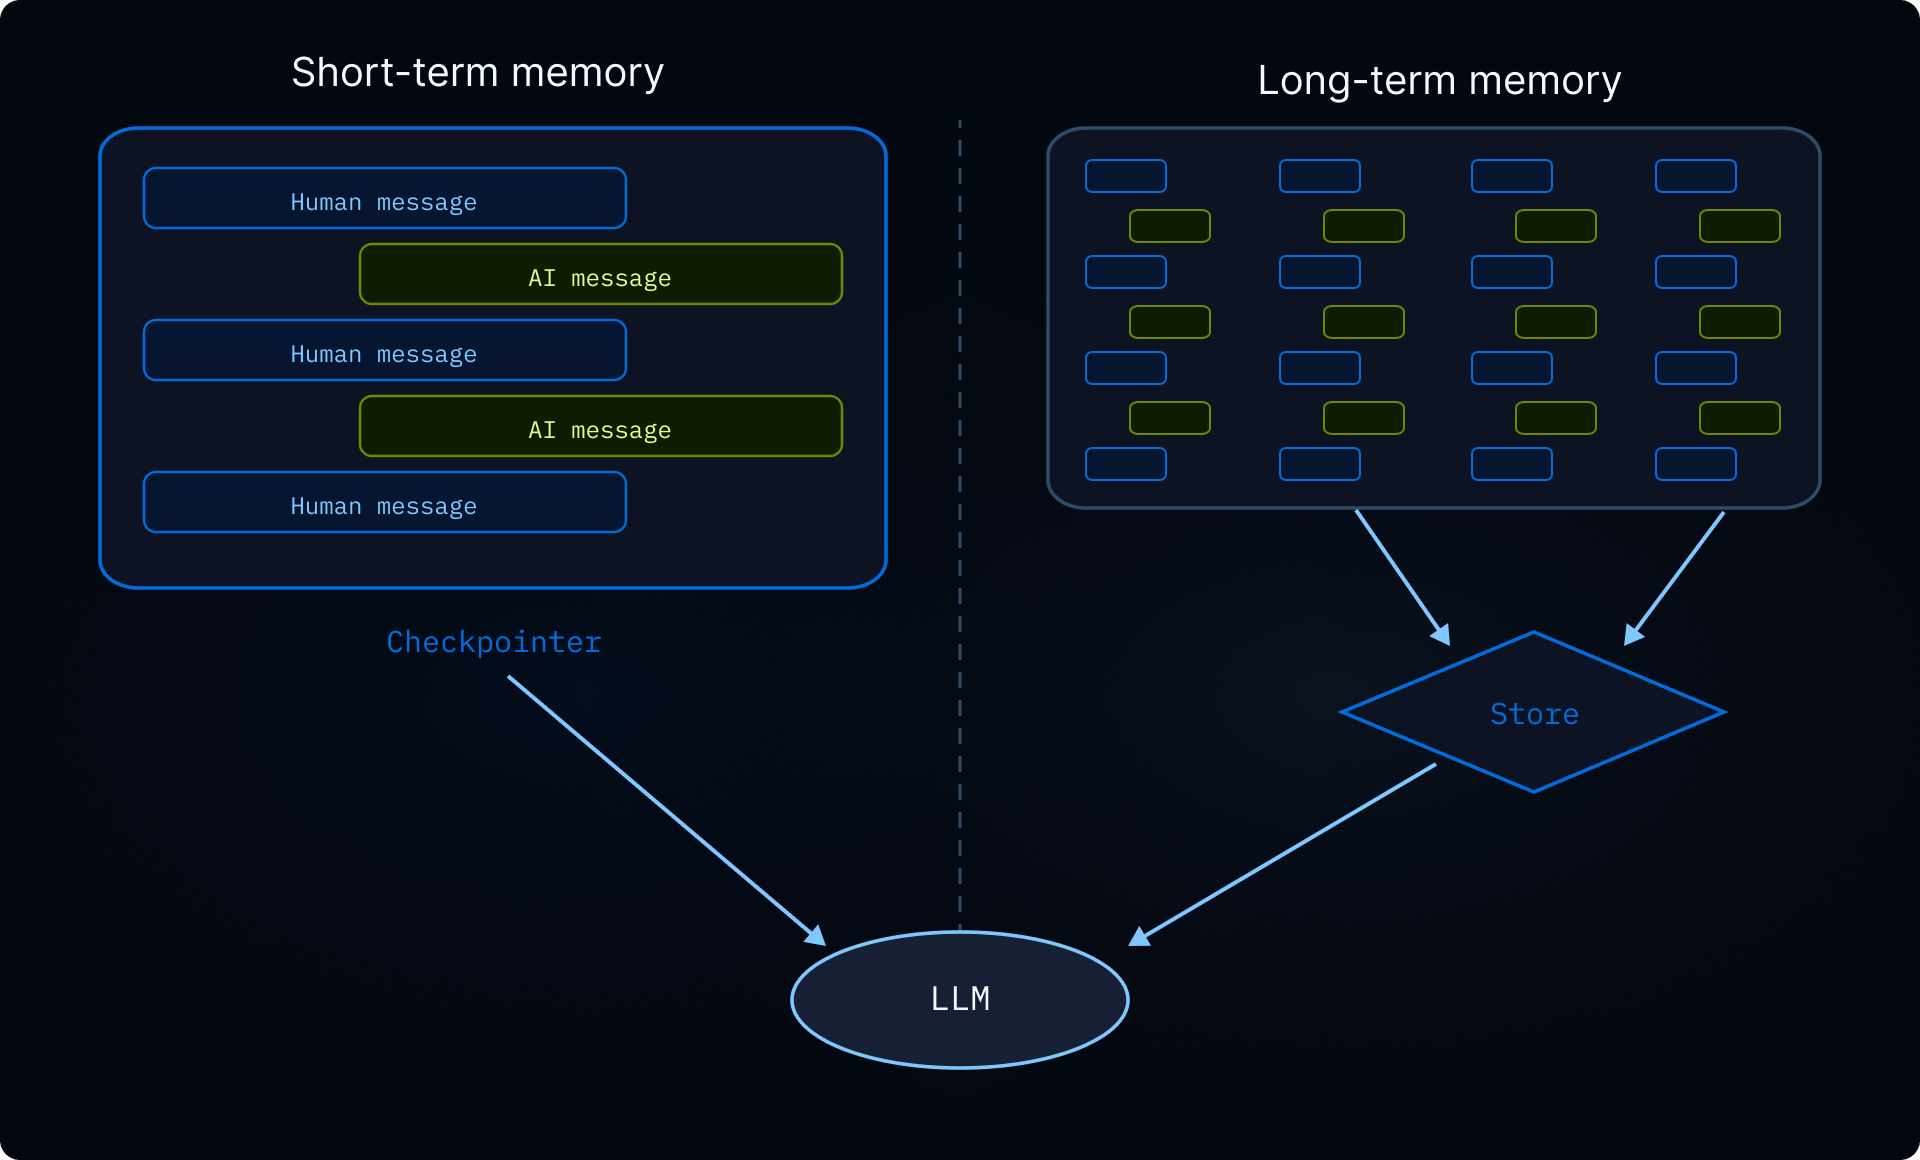
记忆的工作原理
- 让智能体指向记忆文件。 在创建智能体时将文件路径传给
memory=。你也可以通过skills=传入 技能 作为程序性记忆(告诉智能体如何执行任务的可复用指令)。后端 控制文件的存储位置以及谁可以访问它们。 - 智能体读取记忆。 智能体可以在启动时将记忆文件加载到系统提示词中,也可以在对话过程中按需读取它们。例如,技能 使用按需加载:智能体在启动时只读取技能描述,只有当某个技能与任务匹配时才读取完整的技能文件。这样一来,在需要某项能力之前,上下文可以保持精简。
- 智能体更新记忆(可选)。 当智能体学到新信息时,它可以使用内置的
edit_file工具来更新记忆文件。更新可以在对话过程中进行(默认),也可以通过 后台整合 在对话之间的后台进行。更改会被持久化,并在下一次对话中可用。并非所有记忆都是可写的:开发者定义的 技能 和 组织策略 通常是只读的。有关详细信息,请参阅 只读与可写记忆。
最常见的两种模式是 智能体作用域记忆(在所有用户之间共享)和 用户作用域记忆(按用户隔离)。
关于编码智能体可通过 AGENTS.md 发现的生成式仓库 wiki,请参阅 OpenWiki。
作用域记忆
智能体记忆可以设定作用域,从而使同一个记忆文件对所有使用该智能体的人都可访问,或者让记忆文件对每个用户都独立。
智能体作用域记忆
赋予智能体自身随时间演进而持久存在的身份。智能体作用域记忆在所有用户之间共享,因此智能体会在每一次对话中逐步建立自己的角色设定、积累的知识和习得的偏好。随着它与用户交互,它会发展出专长、改进自己的方法,并记住哪些做法有效。当它拥有写入权限时,它还可以学习和更新 技能。
关键在于后端命名空间:将其设置为 (assistant_id,) 意味着该智能体的每一次对话都读写同一个记忆文件。
NOTE
访问 rt.server_info 需要 deepagents>=0.5.0。在更早的版本中,请改为从 get_config()["metadata"]["assistant_id"] 读取 assistant ID。
python
from deepagents import create_deep_agent
from deepagents.backends import CompositeBackend, StateBackend, StoreBackend

agent = create_deep_agent(
    model="google_genai:gemini-3.6-flash",
    memory=["/memories/AGENTS.md"],
    skills=["/skills/"],
    backend=CompositeBackend(
        default=StateBackend(),
        routes={
            "/memories/": StoreBackend(
                namespace=lambda rt: (
                    rt.server_info.assistant_id,
                ),
            ),
            "/skills/": StoreBackend(
                namespace=lambda rt: (
                    rt.server_info.assistant_id,
                ),
            ),
        },
    ),
)完整示例:填充记忆并调用
向存储中填充初始记忆,然后跨两个线程调用智能体,观察它记住并更新所学内容。
python
from langchain_core.utils.uuid import uuid7

from deepagents import create_deep_agent
from deepagents.backends import CompositeBackend, StateBackend, StoreBackend
from deepagents.backends.utils import create_file_data
from langgraph.store.memory import InMemoryStore

store = InMemoryStore()  # Use platform store when deploying to LangSmith

# Seed the memory file
store.put(
    ("my-agent",),
    "/memories/AGENTS.md",
    create_file_data("""## Response style
- Keep responses concise
- Use code examples where possible
"""),
)

# Seed a skill
store.put(
    ("my-agent",),
    "/skills/langgraph-docs/SKILL.md",
    create_file_data("""---
name: langgraph-docs
description: Fetch relevant LangGraph documentation to provide accurate guidance.
---

# langgraph-docs

Use the fetch_url tool to read https://docs.langchain.com/llms.txt, then fetch relevant pages.
"""),
)

agent = create_deep_agent(
    model="google_genai:gemini-3.6-flash",
    memory=["/memories/AGENTS.md"],
    skills=["/skills/"],
    backend=lambda rt: CompositeBackend(
        default=StateBackend(rt),
        routes={
            "/memories/": StoreBackend(
                rt, namespace=lambda rt: ("my-agent",)
            ),
            "/skills/": StoreBackend(
                rt, namespace=lambda rt: ("my-agent",)
            ),
        },
    ),
    store=store,
)

# Thread 1: the agent learns a new preference and saves it to memory
config1 = {"configurable": {"thread_id": str(uuid7())}}
agent.invoke(
    {"messages": [{"role": "user", "content": "I prefer detailed explanations. Remember that."}]},
    config=config1,
)

# Thread 2: the agent reads memory and applies the preference
config2 = {"configurable": {"thread_id": str(uuid7())}}
agent.invoke(
    {"messages": [{"role": "user", "content": "Explain how transformers work."}]},
    config=config2,
)用户作用域记忆
为每个用户提供各自的记忆文件。智能体会按用户记住偏好、上下文和历史,而智能体的核心指令保持不变。如果将 技能 存储在用户作用域的后端中,用户也可以拥有按用户划分的技能。
命名空间使用 (user_id,),因此每个用户都会获得记忆文件的隔离副本。用户 A 的偏好绝不会泄漏到用户 B 的对话中。
python
from deepagents import create_deep_agent
from deepagents.backends import CompositeBackend, StateBackend, StoreBackend

agent = create_deep_agent(
    model="google_genai:gemini-3.6-flash",
    memory=["/memories/preferences.md"],
    skills=["/skills/"],
    backend=CompositeBackend(
        default=StateBackend(),
        routes={
            "/memories/": StoreBackend(
                namespace=lambda rt: (rt.server_info.user.identity,),
            ),
            "/skills/": StoreBackend(
                namespace=lambda rt: (rt.server_info.user.identity,),
            ),
        },
    ),
)完整示例:跨用户的隔离记忆
填充按用户划分的记忆,并以两个不同用户的身份调用智能体。每个用户只能看到自己的偏好。
python
from langchain_core.utils.uuid import uuid7

from deepagents import create_deep_agent
from deepagents.backends import CompositeBackend, StateBackend, StoreBackend
from deepagents.backends.utils import create_file_data
from langgraph.store.memory import InMemoryStore

store = InMemoryStore()  # Use platform store when deploying to LangSmith

# Seed preferences for two users
store.put(
    ("user-alice",),
    "/memories/preferences.md",
    create_file_data("""## Preferences
- Likes concise bullet points
- Prefers Python examples
"""),
)
store.put(
    ("user-bob",),
    "/memories/preferences.md",
    create_file_data("""## Preferences
- Likes detailed explanations
- Prefers TypeScript examples
"""),
)

# Seed a skill for Alice
store.put(
    ("user-alice",),
    "/skills/langgraph-docs/SKILL.md",
    create_file_data("""---
name: langgraph-docs
description: Fetch relevant LangGraph documentation to provide accurate guidance.
---

# langgraph-docs

Use the fetch_url tool to read https://docs.langchain.com/llms.txt, then fetch relevant pages.
"""),
)

agent = create_deep_agent(
    model="google_genai:gemini-3.6-flash",
    memory=["/memories/preferences.md"],
    skills=["/skills/"],
    backend=lambda rt: CompositeBackend(
        default=StateBackend(rt),
        routes={
            "/memories/": StoreBackend(
                rt,
                namespace=lambda rt: (rt.server_info.user.identity,),
            ),
            "/skills/": StoreBackend(
                rt,
                namespace=lambda rt: (rt.server_info.user.identity,),
            ),
        },
    ),
    store=store,
)

# When deployed, each authenticated request resolves
# `rt.server_info.user.identity` to the calling user, so Alice and Bob
# automatically see only their own preferences.
agent.invoke(
    {"messages": [{"role": "user", "content": "How do I read a CSV file?"}]},
    config={"configurable": {"thread_id": str(uuid7())}},
)高级用法
除了记忆路径和作用域的基本配置选项之外,你还可以为记忆配置更高级的参数:
| 维度 | 它回答的问题 | 选项 |
|---|---|---|
| 持续时间 | 它能持续多久? | 短期(单次对话)或 长期(跨对话) |
| 信息类型 | 它是什么类型的信息? | 情景式(过往经历)、程序式(指令和技能)或 语义式(事实) |
| 作用域 | 谁可以查看和修改它? | 用户、智能体 或 组织 |
| 更新策略 | 记忆在何时写入? | 对话期间(默认)或 对话之间 |
| 检索 | 记忆如何被读取? | 加载到提示词中(默认)或按需读取(例如 技能) |
| 智能体权限 | 智能体可以写入记忆吗? | 读写(默认)或 只读(用于共享策略) |
情景式记忆
情景式记忆存储过往经历的记录:发生了什么、按什么顺序发生,以及结果是什么。与语义式记忆(存储在诸如 AGENTS.md 这类文件中的事实和偏好)不同,情景式记忆保留了完整的对话上下文,因此智能体可以回想起问题如何被解决,而不仅仅是从中学到了什么。要为编码智能体生成并维护仓库级别的 wiki,请参阅 OpenWiki。
Deep Agents 已经使用了 检查点器,它正是支持情景式记忆的机制:每一次对话都会作为一个带检查点的线程被持久化。
为了让过往对话可被搜索,请将线程搜索封装为一个工具。user_id 会从运行时上下文中获取,而不是作为参数传入:
python
from langgraph_sdk import get_client
from langchain.tools import tool, ToolRuntime

client = get_client(url="<DEPLOYMENT_URL>")

@tool
async def search_past_conversations(query: str, runtime: ToolRuntime) -> str:
    """Search past conversations for relevant context."""
    user_id = runtime.server_info.user.identity
    threads = await client.threads.search(
        metadata={"user_id": user_id},
        limit=5,
    )
    results = []
    for thread in threads:
        history = await client.threads.get_history(thread_id=thread["thread_id"])
        results.append(history)
return str(results)你可以通过调整元数据过滤器,按用户或组织限定线程搜索的作用域:
python
# Search conversations for a specific user
threads = await client.threads.search(
    metadata={"user_id": user_id},
    limit=5,
)

# Search conversations across an organization
threads = await client.threads.search(
    metadata={"org_id": org_id},
    limit=5,
)这对于执行复杂、多步骤任务的智能体很有用。例如,编码智能体可以回顾过去的一次调试会话,并直接跳到可能的根本原因。
组织级记忆
组织级记忆遵循与用户作用域记忆相同的模式,但使用的是组织范围的命名空间,而不是按用户划分的命名空间。可将它用于应适用于组织中所有用户和智能体的策略或知识。
组织记忆通常是 只读的,以防止通过共享状态进行提示词注入。有关详细信息,请参阅 只读与可写记忆。
python
from deepagents import create_deep_agent
from deepagents.backends import CompositeBackend, StateBackend, StoreBackend

agent = create_deep_agent(
    model="google_genai:gemini-3.6-flash",
    memory=[
        "/memories/preferences.md",
        "/policies/compliance.md",
    ],
    backend=CompositeBackend(
        default=StateBackend(),
        routes={
            "/memories/": StoreBackend(
                namespace=lambda rt: (rt.server_info.user.identity,),
            ),
            "/policies/": StoreBackend(
                namespace=lambda rt: (rt.context.org_id,),
            ),
        },
    ),
)从你的应用程序代码中填充组织记忆:
python
from langgraph_sdk import get_client
from deepagents.backends.utils import create_file_data

client = get_client(url="<DEPLOYMENT_URL>")

await client.store.put_item(
    (org_id,),
    "/compliance.md",
    create_file_data("""## Compliance policies
- Never disclose internal pricing
- Always include disclaimers on financial advice
"""),
)使用 权限 强制组织级记忆为只读,或使用 策略钩子 实现自定义验证逻辑。
后台整合
默认情况下,智能体在对话期间写入记忆(热路径)。另一种方式是将记忆处理作为后台任务在 对话之间 进行,这有时被称为 睡眠时间计算(sleep time compute)。一个独立的深度智能体会审阅最近的对话,提取关键事实,并将它们与现有记忆合并。
| 方式 | 优点 | 缺点 |
|---|---|---|
| 热路径(对话期间) | 记忆立即可用,对用户透明 | 增加延迟,智能体必须同时处理多项任务 |
| 后台(对话之间) | 没有面向用户的延迟,可以跨多次对话进行综合 | 记忆要到下一次对话才可用,需要第二个智能体 |
对于大多数应用来说,热路径就足够了。当你需要降低延迟或在大量对话中提升记忆质量时,可以添加后台整合。
推荐的做法是:在主智能体旁部署一个 整合智能体 —— 一个读取最近对话历史、提取关键事实并将它们合并到记忆存储中的深度智能体 —— 并通过 cron 调度 触发它。选择一个能反映用户实际与智能体交互频率的节奏:每天流量稳定的聊天产品可能每隔几小时就整合一次,而每周只使用几次的工具则只需每晚或每周运行一次。整合的频率远高于用户对话的频率,只会在无效运行中白白消耗 token。
整合智能体
整合智能体读取最近的对话历史,并将关键事实合并到记忆存储中。在 langgraph.json 中将它注册到主智能体旁边:
python
from datetime import datetime, timedelta, timezone

from deepagents import create_deep_agent
from langchain.tools import tool, ToolRuntime
from langgraph_sdk import get_client

sdk_client = get_client(url="<DEPLOYMENT_URL>")

@tool
async def search_recent_conversations(query: str, runtime: ToolRuntime) -> str:
    """Search this user's conversations updated in the last 6 hours."""
    user_id = runtime.server_info.user.identity

    since = datetime.now(timezone.utc) - timedelta(hours=6)
    threads = await sdk_client.threads.search(
        metadata={"user_id": user_id},
        updated_after=since.isoformat(),
        limit=20,
    )
    conversations = []
    for thread in threads:
        history = await sdk_client.threads.get_history(
            thread_id=thread["thread_id"]
        )
        conversations.append(history["values"]["messages"])
    return str(conversations)

agent = create_deep_agent(
    model="google_genai:gemini-3.6-flash",
    system_prompt="""Review recent conversations and update the user's memory file.
Merge new facts, remove outdated information, and keep it concise.""",
    tools=[search_recent_conversations],
)json
{
  "dependencies": ["."],
  "graphs": {
    "agent": "./agent.py:agent",
    "consolidation_agent": "./consolidation_agent.py:agent"
  },
  "env": ".env"
}Cron
cron 任务 会按固定计划运行整合智能体。该智能体会搜索最近的对话并将它们综合到记忆中。请让计划与你的使用模式相匹配,以便整合运行大致跟踪真实活动。
graph LR
    Store[(Memory store)] -.->|reads| Conv1[Conversation 1]
    Store -.->|reads| Conv2[Conversation 2]
    Cron[Cron schedule] -->|periodic| Agent[Consolidation agent]
    Agent -->|writes| Store

    classDef trigger fill:#F6FFDB,stroke:#6E8900,stroke-width:2px,color:#2E3900
    classDef process fill:#E5F4FF,stroke:#006DDD,stroke-width:2px,color:#030710
    classDef output fill:#EBD0F0,stroke:#885270,stroke-width:2px,color:#441E33
    classDef schedule fill:#FDF3FF,stroke:#7E65AE,stroke-width:2px,color:#504B5F

    class Conv1,Conv2 trigger
    class Agent process
    class Store output
    class Cron schedule
使用 cron 任务来调度整合智能体:
python
from langgraph_sdk import get_client

client = get_client(url="<DEPLOYMENT_URL>")

cron_job = await client.crons.create(
    assistant_id="consolidation_agent",
    schedule="0 */6 * * *",
    input={"messages": [{"role": "user", "content": "Consolidate recent memories."}]},
)NOTE
所有 cron 计划都按 UTC 解释。有关管理和删除 cron 任务的详细信息,请参阅 cron 任务。
WARNING
cron 间隔必须与整合智能体内部的回看窗口相匹配。上面的示例每 6 小时运行一次(0 */6 * * *),而智能体的 search_recent_conversations 工具回看 timedelta(hours=6) —— 请保持这两者同步。如果 cron 的运行频率高于回看窗口,你会重复处理相同的对话;如果运行频率低于回看窗口,则会丢失落在窗口之外的记忆。
有关使用后台进程部署智能体的更多内容,请参阅 投入生产。
只读与可写记忆
默认情况下,智能体既可以读取也可以写入记忆文件。对于组织策略或合规规则之类的共享状态,你可能希望将记忆设为 只读,以便智能体可以引用但不能修改它。这可以防止通过共享记忆进行提示词注入,并确保只有你的应用程序代码才能控制文件中的内容。
| 权限 | 使用场景 | 工作原理 |
|---|---|---|
| 读写(默认) | 用户偏好、智能体自我改进、习得的 技能 | 智能体通过 edit_file 工具更新文件 |
| 只读 | 组织策略、合规规则、共享知识库、开发者定义的 技能 | 通过应用程序代码或 Store API 填充。使用 权限 拒绝对特定路径的写入,或使用 策略钩子 实现自定义验证逻辑。 |
安全注意事项: 如果一个用户可以写入另一个用户会读取的记忆,恶意用户就可能向共享状态注入指令。为缓解此问题:
- 默认使用用户作用域
(user_id),除非你有特定理由需要共享 - 对共享策略使用 只读记忆(通过应用程序代码填充,而不是由智能体填充)
- 在智能体写入共享记忆之前添加 人在回路 验证。使用 中断 要求对敏感路径的写入获得人工批准。
要强制实施只读记忆,请使用 权限 以声明方式拒绝对特定路径的写入。对于自定义验证逻辑(速率限制、审计日志记录、内容检查),请使用 后端策略钩子。
并发写入
多个线程可以并行写入记忆,但对 同一文件 的并发写入可能导致「最后写入者获胜」的冲突。对于用户作用域记忆,这种情况很少见,因为用户通常一次只有一个活跃对话。对于智能体作用域或组织作用域记忆,请考虑使用 后台整合 来串行化写入,或将记忆按主题结构化为不同的文件以减少争用。
在实践中,如果一次写入因冲突而失败,LLM 通常足够聪明,能够重试或优雅地恢复,因此单次写入丢失并不是灾难性的。
同一部署中的多个智能体
要在共享部署中让每个智能体拥有自己的记忆,请将 assistant_id 添加到命名空间:
python
StoreBackend(
    namespace=lambda rt: (
        rt.server_info.assistant_id,
        rt.server_info.user.identity,
    ),
)如果你只需要按智能体隔离而不需要按用户作用域划分,可以单独使用 assistant_id。
TIP
使用 LangSmith 追踪 来审计智能体写入记忆的内容。每一次文件写入都会在追踪中显示为一个工具调用。