
主题
过滤追踪(ClickHouse)
用过滤栏、过滤快捷方式和已保存过滤器,在一个由 ClickHouse 支撑的 LangSmith 追踪项目中过滤线程、追踪和运行。
追踪项目会跨线程、追踪和运行积累大量数据。LangSmith 的过滤工具让你精确地导航和分析那些数据。
NOTE
追踪项目有两种过滤体验。查看你项目顶部,确认哪一种适用于你:
- 一个带左侧范围选择器的搜索栏:参阅过滤追踪。
- 一个构建过滤 chip 的 Add filter 按钮:参阅过滤追踪(ClickHouse)。
本页涵盖:
- 从过滤栏和 Filter Shortcuts 面板应用过滤器
- 按属性、全文内容和键值对过滤
- 保存并复制过滤配置
- 在 Details 视图内过滤
- 针对根或子运行属性过滤的高级过滤器
如果你要通过 API 或 SDK 以编程方式导出数据做分析,请改参阅导出追踪指南。
创建并应用过滤器
按运行属性过滤
有两种方式在一个追踪项目中过滤数据:
过滤器:位于 Tracing 项目页面左上角。这是你构造和管理过滤条件的地方。
- 第一个下拉菜单过滤默认和已保存视图。
- 按 Threads、Traces 或 Runs 快速过滤。
- Add filter 用于基于一个属性或全文搜索配置一个过滤器。
Filter Shortcuts:位于 Tracing 项目页面的右侧边栏。过滤快捷方式栏提供对你项目运行中最常出现属性为基础的过滤器的快速访问。
过滤运算符
可用的过滤运算符取决于你过滤的属性数据类型。这里是常见运算符的概览:
- is:对过滤值精确匹配
- is not:对过滤值负向匹配
- contains:对过滤值部分匹配
- does not contain:对过滤值负向部分匹配
- is one of:匹配列表中任一指定的值
>/<:可用于数值字段
具体过滤技术
过滤运行(span)
要过滤运行(span),把默认从 Traces 改为 Runs。例如,若你想按运行的 run name 过滤、或按 run type 过滤,就会这样做。
运行元数据和标签也很适合过滤。它们依赖于你流水线各部分的良好打标。要了解更多,参阅向追踪添加元数据和标签。
当你指定更多过滤器时,你可以逐个点击每个过滤器来更新你在搜索的属性。
基于输入和输出过滤
你可以基于线程、追踪或运行的输入和输出中的内容来过滤追踪数据。
要过滤输入或输出,你可以用 **
Full-Text Search** 过滤器,它会匹配任一字段中的关键词。要做更有针对性的搜索,你可以用 **{
} 输入** 或 **
输出** 过滤器,它们只会基于对应字段匹配内容。
NOTE
出于性能,LangSmith 为全文搜索最多索引 250 个字符的数据。如果你的搜索查询超出这个上限,我们建议改用输入/输出键值搜索。
你也可以指定多个词以匹配所提供的所有词,方式是:
- 用 Full-Text Search 包含多个以空白分隔的词。
- 在加了第一个过滤器之后,用
按钮添加多个过滤器。
LangSmith 拆分文本并按任意顺序匹配任何部分关键词匹配。LangSmith 从搜索中排除常见的停用词(来自 nltk 停用词表以及另外几个常见的 JSON 关键词)。
NOTE
令牌必须至少 2 个字符长才会被索引。单字符令牌(例如 a、x)被排除在搜索之外。


基于图中的过滤器,系统会在输入或输出中搜索 python 和 tensorflow,并在输入中搜索 embedding、在输出中搜索 fine 和 tune。
你可以按需从过滤路径中移除过滤器,这会把搜索放宽到剩余的过滤器。
基于输入/输出键值对过滤
除全文搜索外,你还能基于输入和输出中的特定键值对过滤。这让过滤更精确,尤其在处理结构化数据时。
NOTE
LangSmith 每个运行最多索引 100 个唯一键,以保持你的数据有序且可搜索。每个键也有每值 250 个字符的字符上限。如果你的数据超出其中任一上限,文本不会被索引。这有助于确保快速可靠的性能。
要基于键值对过滤,例如,要匹配以下输入:
json
{
  "input": "What is the capital of France?"
}- 选择 Add filter。
- 从第一个下拉菜单选择 Input,把 Key 留作第二个下拉菜单,并选择 input 作为键。
- 点击 + Value 并输入值:把
What is the capital of France?作为值。
你也可以用点记法选择嵌套键名来匹配嵌套键。例如,要匹配输出中的嵌套键:
json
{
  "documents": [
    {
      "page_content": "The capital of France is Paris",
      "metadata": {},
      "type": "Document"
    }
  ]
}选择 Output Key,输入 documents.page_content 作为键,并输入 The capital of France is Paris 作为值。这会匹配带指定值的嵌套键 documents.page_content。
你可以添加多个键值过滤器来创建更复杂的查询。你也可以用右侧的 Filter Shortcuts 来快速基于常见键值对过滤:
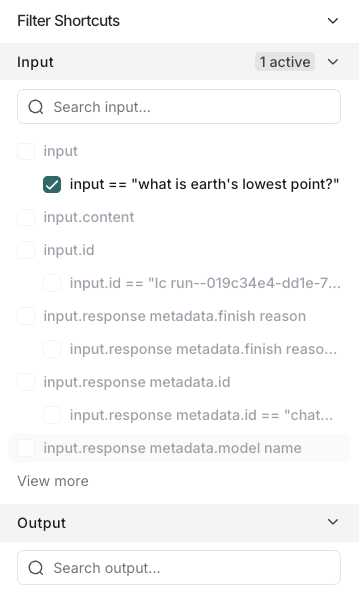
示例:过滤工具调用
搜索包含特定工具调用的追踪很常见。工具调用通常在 LLM 运行的输出中指示。要过滤工具调用,你会用 Output Key 过滤器。
虽然这个例子会告诉你如何过滤工具调用,但你能套用同样的逻辑来过滤输出中的任何键值对。
在这里,假设这是你想过滤的输出:
json
{
  "generations": [
    [
      {
        "text": "",
        "type": "ChatGeneration",
        "message": {
          "lc": 1,
          "type": "constructor",
          "id": [],
          "kwargs": {
            "type": "ai",
            "id": "run-ca7f7531-f4de-4790-9c3e-960be7f8b109",
            "tool_calls": [
              {
                "name": "Plan",
                "args": {
                  "steps": [
                    "Research LangGraph's node configuration capabilities",
                    "Investigate how to add a Python code execution node",
                    "Find an example or create a sample implementation of a code execution node"
                  ]
                },
                "id": "toolu_01XexPzAVknT3gRmUB5PK5BP",
                "type": "tool_call"
              }
            ]
          }
        }
      }
    ]
  ],
  "llm_output": null,
  "run": null,
  "type": "LLMResult"
}通过这个例子,KV 搜索会把每个嵌套 JSON 路径映射为一个键值对,供你搜索和过滤。
LangSmith 会把它拆成以下一组可搜索的键值对:
| 键 | 值 |
|---|---|
generations.type | ChatGeneration |
generations.message.type | constructor |
generations.message.kwargs.type | ai |
generations.message.kwargs.id | run-ca7f7531-f4de-4790-9c3e-960be7f8b109 |
generations.message.kwargs.tool_calls.name | Plan |
generations.message.kwargs.tool_calls.args.steps | Research LangGraph's node configuration capabilities |
generations.message.kwargs.tool_calls.args.steps | Investigate how to add a Python code execution node |
generations.message.kwargs.tool_calls.args.steps | Find an example or create a sample implementation of a code execution node |
generations.message.kwargs.tool_calls.id | toolu_01XexPzAVknT3gRmUB5PK5BP |
generations.message.kwargs.tool_calls.type | tool_call |
type | LLMResult |
要搜索一个特定的工具调用,你可以用以下 Output Key 搜索,同时移除根运行过滤器:
generations.message.kwargs.tool_calls.name = Plan
这会匹配 tool_calls 名为 Plan 的根运行和非根运行。
对键值对做负向过滤
不同类型的负向过滤可应用于 {x} 元数据、**
输入** 和 **
输出** 字段上,以从你的结果中排除特定运行。
例如,要找到元数据键 phone 不等于 1234567890 的所有运行:
- 把 Metadata Key 运算符设为
is,把 Key 字段设为phone。 - 把 Value 运算符设为
is not,把 Value 字段设为1234567890。
这会匹配所有带元数据键 phone、值为除 1234567890 之外的任何值的运行。
要找到没有某个特定元数据键的运行:把 Key 运算符设为 is not。例如,把 Key 运算符设为 is not 并以 phone 作为键,会匹配其元数据中没有 phone 字段的所有运行。
你也能过滤既没有某个特定键、也没有某个特定值的运行。要找到元数据中既无键 phone、也无任何字段值为 1234567890 的运行,把 Key 运算符设为 is not 且键为 phone,并把 Value 运算符设为 is not 且值为 1234567890。
最后,你也能过滤没有某个特定键、但有一个特定值的运行。要找到无 phone 键、但某个其他键的值为 1234567890 的运行,把 Key 运算符设为 is not 且键为 phone,并把 Value 运算符设为 is 且值为 1234567890。
TIP
你可以用 does not contain 运算符替代 is not 来执行子串匹配。
保存一个过滤器
保存过滤器让你存储并复用常用的过滤配置。已保存过滤器是特定于某个追踪项目的。
构造好你的过滤器后,点击 Save as 按钮保存它。这会弹出一个对话框来指定过滤器的名字和描述。
保存一个过滤器后,它会在视图下拉菜单中作为一个快速过滤器供你使用。
更新一个已保存过滤器
在选中下拉菜单中的过滤器后,你可以对过滤参数做任何更改。然后点击 Save 更新过滤器。
删除一个已保存过滤器
点击
图标(在下拉菜单中所保存过滤器旁),并用垃圾桶
图标删除过滤器。
复制一个过滤器
你可以复制一个构造好的过滤器,以与同事分享、以后再复用,或在 API 或 SDK 中以编程方式查询运行。
要复制过滤器:
- 在 UI 中创建它。
- 点击
图标(在过滤栏中)。如果你构造了树或追踪过滤器,你也能复制那些。 3. 这会给你一个用 LangSmith 查询语言表示过滤器的字符串。例如:and(eq(is_root, true), and(eq(feedback_key, "user_score"), eq(feedback_score, 1)))。
有关查询语言语法的更多信息,参阅追踪查询语法。
在 Details 视图中过滤运行
你也可以直接在 Details 视图中应用过滤器,这对筛选带大量运行的追踪很有用。主运行表视图中可用的同样过滤器也能在这里应用。
默认情况下,只显示匹配过滤器的运行。要在更宽的追踪树上下文中查看匹配的运行,把视图选项从 "Filtered Only" 切换到 "Show All" 或 "Most relevant"。
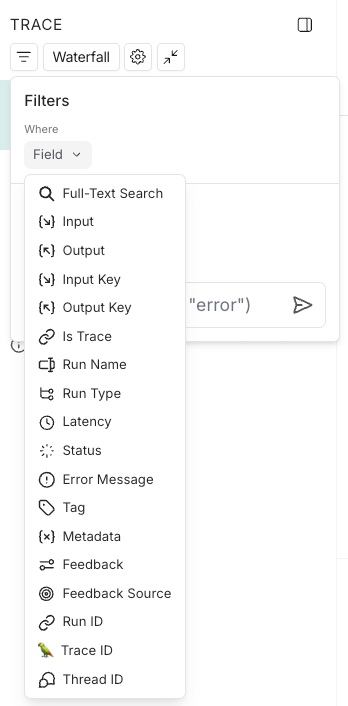
在 LangSmith 查询语言中手动指定一个原始查询
如果你复制了一个先前构造的过滤器,你可能想在以后的会话中手动应用这个原始查询。
要做到这一点,你可以在 Details 视图过滤器弹出框底部点击 Switch to raw query。从那里你能把一个原始查询粘贴进文本框。
NOTE
这会把那个查询添加到现有查询,而非覆盖它。
高级过滤器
按根的属性过滤运行(span)
一个常见概念是过滤那些属于某条追踪的运行,而该追踪的根运行带有某个属性。一个例子是过滤某一类型的运行,其根运行带有与之关联的正面(或负面)反馈。要做到这一点:
- 在 Threads/Traces/Runs 切换中点击 Runs。
- 添加另一条过滤规则。然后你能点击过滤器下拉菜单底部的 Advanced 过滤器链接。
- 会打开一个模态框,你可以在其中添加 Trace 过滤器。这些过滤器会应用于你已过滤的各个运行的所有父运行的追踪。
过滤那些子运行带有某属性的运行(span)
你可能想搜索带有特定类型子运行的运行。一个例子是搜索所有有一条名为 Foo 的子运行的追踪。当 Foo 并非总是被调用、而你想分析它被调用的情形时,这很有用。
- 在 Threads/Traces/Runs 切换中点击 Runs。
- 添加另一条过滤规则。然后你能点击过滤器下拉菜单底部的 Advanced 过滤器链接。
- 会打开一个模态框,你可以在其中添加 Tree 过滤器。这会让你指定的规则应用于你已过滤的各个运行的所有子运行。
示例:过滤树中含工具调用过滤器的所有运行
拓展工具调用过滤示例,如果你想过滤其树包含该工具调用过滤器的所有运行,你能在 Advanced 过滤器设置中使用树过滤器。