
主题
防止在追踪中记录敏感数据
在处理 LangSmith 追踪时,你可能需要防止敏感信息被记录,以保持隐私并符合安全要求。LangSmith 提供了多种在数据被发送到后端之前保护它的方法:
- 完全隐藏输入和输出,用环境变量或 Client 配置。
- 隐藏元数据以移除或转换运行元数据。
- 应用基于规则的掩码,用正则模式或匿名化库有选择地编辑敏感信息。
- 从追踪中编辑机密,用带现成正则模式的 SDK 匿名器处理 API 密钥、令牌和凭据。
- 为单个函数处理输入和输出,用函数级定制。
- 使用像 Microsoft Presidio 和 Amazon Comprehend 这样的第三方匿名器做高级 PII 检测。
- 批处理运行操作,跨多个运行一次性应用昂贵的掩码逻辑,减少每运行开销。LangSmith 在后台线程处理运行,不会阻塞你的应用。
- 用
tracing_context按请求编辑输入和输出,只为特定调用(例如基于租户或功能标志)掩码数据,同时让其他追踪不受影响。
NOTE
如果你的合规或隐私要求规定某些操作根本不应被追踪(例如零保留策略的客户),考虑用条件追踪为特定请求有选择地禁用追踪,而非掩码数据。
隐藏输入和输出
如果你想完全隐藏追踪的输入和输出,你可以在运行应用时设置以下环境变量:
bash
LANGSMITH_HIDE_INPUTS=true
LANGSMITH_HIDE_OUTPUTS=true这对 LangSmith SDK(Python 和 TypeScript)和 LangChain 都有效。
你也可以为一个给定的 Client 实例定制并覆盖这一行为。可以通过在 Client 对象上设置 hide_inputs 和 hide_outputs 参数(TypeScript 中为 hideInputs 和 hideOutputs)来做到。
下面的例子对 hide_inputs 和 hide_outputs 都返回一个空对象,但你可以按需定制:
python
import openai
from langsmith import Client
from langsmith.wrappers import wrap_openai

openai_client = wrap_openai(openai.Client())
langsmith_client = Client(
    hide_inputs=lambda inputs: {}, hide_outputs=lambda outputs: {}
)

# The trace produced will have its metadata present, but the inputs will be hidden
openai_client.chat.completions.create(
    model="gpt-5.4-mini",
    messages=[
        {"role": "system", "content": "You are a helpful assistant."},
        {"role": "user", "content": "Hello!"},
    ],
    langsmith_extra={"client": langsmith_client},
)

# The trace produced will not have hidden inputs and outputs
openai_client.chat.completions.create(
    model="gpt-5.4-mini",
    messages=[
        {"role": "system", "content": "You are a helpful assistant."},
        {"role": "user", "content": "Hello!"},
    ],
)typescript
import OpenAI from "openai";
import { Client } from "langsmith";
import { wrapOpenAI } from "langsmith/wrappers";

const langsmithClient = new Client({
    hideInputs: (inputs) => ({}),
    hideOutputs: (outputs) => ({}),
});

// The trace produced will have its metadata present, but the inputs will be hidden
const filteredOAIClient = wrapOpenAI(new OpenAI(), {
    client: langsmithClient,
});
await filteredOAIClient.chat.completions.create({
    model: "gpt-5.4-mini",
    messages: [
        { role: "system", content: "You are a helpful assistant." },
        { role: "user", content: "Hello!" },
    ],
});

const openaiClient = wrapOpenAI(new OpenAI());
// The trace produced will not have hidden inputs and outputs
await openaiClient.chat.completions.create({
    model: "gpt-5.4-mini",
    messages: [
        { role: "system", content: "You are a helpful assistant." },
        { role: "user", content: "Hello!" },
    ],
});隐藏元数据
hide_metadata 参数让你在用 LangSmith Python SDK 追踪时控制运行元数据是否被隐藏或转换。元数据在创建运行时随 extra 参数传递(例如 extra={"metadata": {...})。hide_metadata 对移除敏感信息、遵守隐私要求,或减少发送到 LangSmith 的数据量很有用。你可以用两种方式配置元数据隐藏:
使用 SDK:
pythonfrom langsmith import Client client = Client(hide_metadata=True)使用环境变量:
bashexport LANGSMITH_HIDE_METADATA=true
hide_metadata 参数接受三种类型的值:
True:完全移除所有元数据(发送一个空字典)。False或None:原样保留元数据(默认行为)。Callable:一个转换元数据字典的自定义函数。
当设置时,这个参数会影响 Client 创建或更新的所有运行的 extra 参数中的 metadata 字段,包括通过 @traceable 装饰器或 LangChain 集成创建的运行。
隐藏所有元数据
设 hide_metadata=True 以从发送到 LangSmith 的运行中完全移除所有元数据:
python
from langsmith import Client

# Hide all metadata completely
client = Client(hide_metadata=True)

# Now when you create runs, metadata will be empty
client.create_run(
    "my_run",
    inputs={"question": "What is 2+2?"},
    run_type="llm",
    extra={"metadata": {"user_id": "123", "session": "abc"}}
)
# The metadata sent to LangSmith will be {} instead of the provided metadata自定义转换
用一个可调用函数在元数据被发送到 LangSmith 之前,有选择地过滤、编辑或修改它:
python
# Remove sensitive keys
def hide_sensitive_metadata(metadata: dict) -> dict:
    return {k: v for k, v in metadata.items() if not k.startswith("_private")}

client = Client(hide_metadata=hide_sensitive_metadata)

# Redact specific values
def redact_emails(metadata: dict) -> dict:
    import re
    result = {}
    for k, v in metadata.items():
        if isinstance(v, str) and "@" in v:
            result[k] = "[REDACTED_EMAIL]"
        else:
            result[k] = v
    return result

client = Client(hide_metadata=redact_emails)

# Add transformation marker
def add_marker(metadata: dict) -> dict:
    return {**metadata, "transformed": True}

client = Client(hide_metadata=add_marker)基于规则的输入与输出掩码
INFO
此功能在以下 LangSmith SDK 版本中可用:
- Python:0.1.81 及以上
- TypeScript:0.1.33 及以上
要掩码输入和输出中的特定数据,你可以用 create_anonymizer / createAnonymizer 函数,并在实例化 Client 时传入新创建的匿名器。匿名器既可以由一组正则模式和替换值构造,也可以由一个接受并返回字符串值的函数构造。
TIP
要编辑 API 密钥、令牌和其他凭据,见从追踪中编辑机密获取现成的正则模式和配方。
如果 LANGSMITH_HIDE_INPUTS = true,匿名器会跳过输入。若 LANGSMITH_HIDE_OUTPUTS = true,对输出同理。
不过,如果输入或输出要发送给 Client,anonymizer 方法会优先于 hide_inputs 和 hide_outputs 中的函数。默认情况下,create_anonymizer 最多只看 10 层嵌套,可通过 max_depth 参数配置。
python
from langsmith.anonymizer import create_anonymizer
from langsmith import Client, traceable
import re

# create anonymizer from list of regex patterns and replacement values
anonymizer = create_anonymizer([
    { "pattern": r"[a-zA-Z0-9._%+-]+@[a-zA-Z0-9.-]+.[a-zA-Z]{2,}", "replace": "<email-address>" },
    { "pattern": r"[0-9a-fA-F]{8}-[0-9a-fA-F]{4}-[0-9a-fA-F]{4}-[0-9a-fA-F]{4}-[0-9a-fA-F]{12}", "replace": "<UUID>" }
])

# or create anonymizer from a function
email_pattern = re.compile(r"[a-zA-Z0-9._%+-]+@[a-zA-Z0-9.-]+.[a-zA-Z]{2,}")
uuid_pattern = re.compile(r"[0-9a-fA-F]{8}-[0-9a-fA-F]{4}-[0-9a-fA-F]{4}-[0-9a-fA-F]{4}-[0-9a-fA-F]{12}")
anonymizer = create_anonymizer(
    lambda text: email_pattern.sub("<email-address>", uuid_pattern.sub("<UUID>", text))
)

client = Client(anonymizer=anonymizer)

@traceable(client=client)
def main(inputs: dict) -> dict:
...typescript
import { createAnonymizer } from "langsmith/anonymizer"
import { traceable } from "langsmith/traceable"
import { Client } from "langsmith"

// create anonymizer from list of regex patterns and replacement values
const anonymizer = createAnonymizer([
    { pattern: /[a-zA-Z0-9._%+-]+@[a-zA-Z0-9.-]+.[a-zA-Z]{2,}/g, replace: "<email>" },
    { pattern: /[0-9a-fA-F]{8}-[0-9a-fA-F]{4}-[0-9a-fA-F]{4}-[0-9a-fA-F]{4}-[0-9a-fA-F]{12}/g, replace: "<uuid>" }
])

// or create anonymizer from a function
const anonymizer = createAnonymizer((value) => value.replace("...", "<value>"))

const client = new Client({ anonymizer })

const main = traceable(async (inputs: any) => {
    // ...
}, { client })请注意,使用匿名器可能因复杂的正则表达式或大载荷而带来性能损失,因为匿名器在处理前会把载荷序列化为 JSON。
NOTE
改进 anonymizer API 的性能在我们的路线图上!如果你遇到性能问题,请通过 support.langchain.com 联系支持。
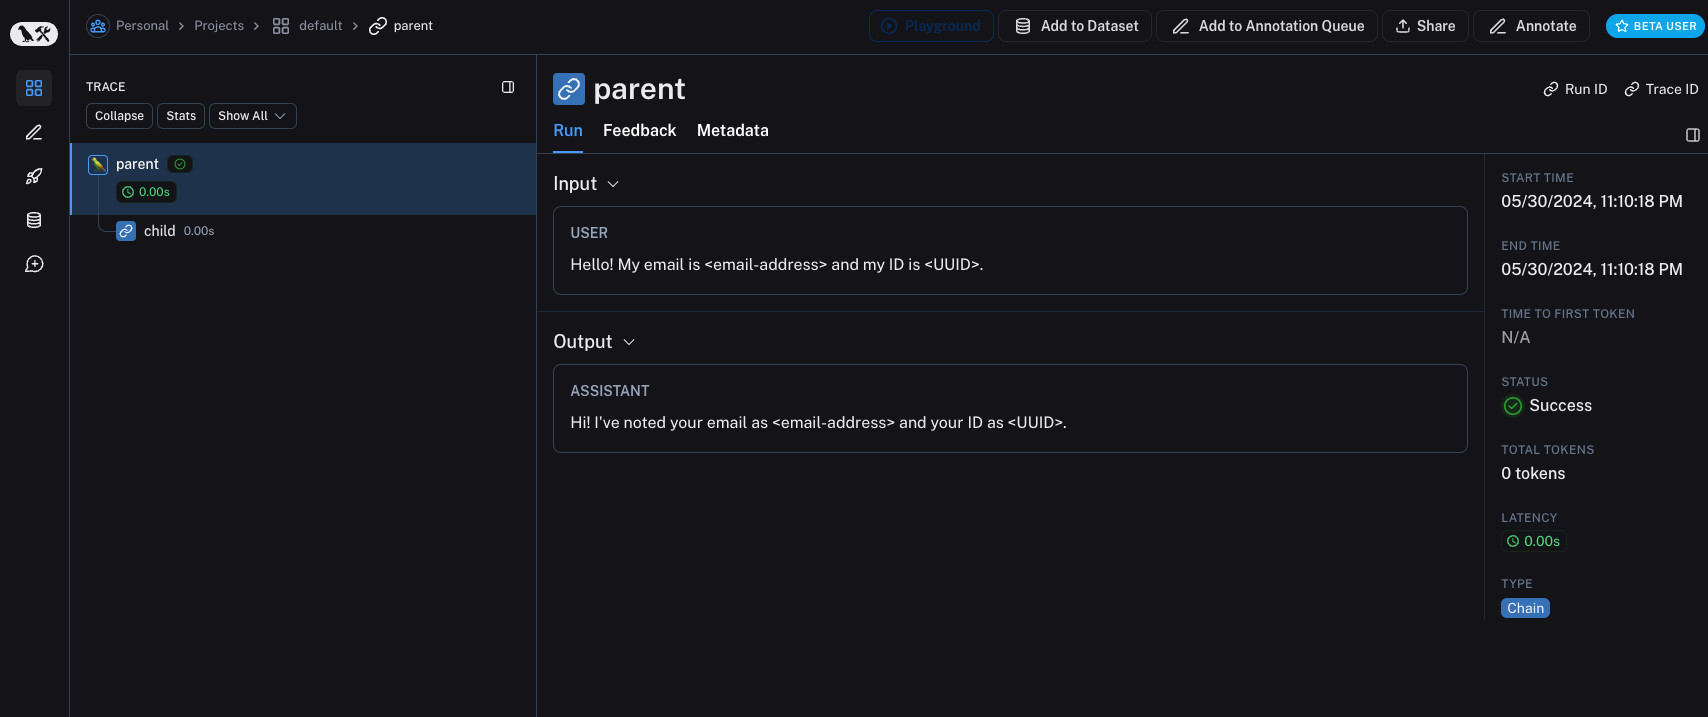
较旧版本的 LangSmith SDK 可以用 hide_inputs 和 hide_outputs 参数达到同样效果。你也可以用这些参数更高效地处理输入和输出。
python
import re
from langsmith import Client, traceable

# Define the regex patterns for email addresses and UUIDs
EMAIL_REGEX = r"[a-zA-Z0-9._%+-]+@[a-zA-Z0-9.-]+.[a-zA-Z]{2,}"
UUID_REGEX = r"[0-9a-fA-F]{8}-[0-9a-fA-F]{4}-[0-9a-fA-F]{4}-[0-9a-fA-F]{4}-[0-9a-fA-F]{12}"

def replace_sensitive_data(data, depth=10):
    if depth == 0:
        return data
    if isinstance(data, dict):
        return {k: replace_sensitive_data(v, depth-1) for k, v in data.items()}
    elif isinstance(data, list):
        return [replace_sensitive_data(item, depth-1) for item in data]
    elif isinstance(data, str):
        data = re.sub(EMAIL_REGEX, "<email-address>", data)
        data = re.sub(UUID_REGEX, "<UUID>", data)
        return data
    else:
        return data

client = Client(
    hide_inputs=lambda inputs: replace_sensitive_data(inputs),
    hide_outputs=lambda outputs: replace_sensitive_data(outputs)
)

inputs = {"role": "user", "content": "Hello! My email is user@example.com and my ID is 123e4567-e89b-12d3-a456-426614174000."}
outputs = {"role": "assistant", "content": "Hi! I've noted your email as user@example.com and your ID as 123e4567-e89b-12d3-a456-426614174000."}

@traceable(client=client)
def child(inputs: dict) -> dict:
    return outputs

@traceable(client=client)
def parent(inputs: dict) -> dict:
    child_outputs = child(inputs)
    return child_outputs

parent(inputs)typescript
import { Client } from "langsmith";
import { traceable } from "langsmith/traceable";

// Define the regex patterns for email addresses and UUIDs
const EMAIL_REGEX = /[a-zA-Z0-9._%+-]+@[a-zA-Z0-9.-]+.[a-zA-Z]{2,}/g;
const UUID_REGEX = /[0-9a-fA-F]{8}-[0-9a-fA-F]{4}-[0-9a-fA-F]{4}-[0-9a-fA-F]{4}-[0-9a-fA-F]{12}/g;

function replaceSensitiveData(data: any, depth: number = 10): any {
    if (depth === 0) return data;
    if (typeof data === "object" && !Array.isArray(data)) {
        const result: Record<string, any> = {};
        for (const [key, value] of Object.entries(data)) {
            result[key] = replaceSensitiveData(value, depth - 1);
        }
        return result;
    } else if (Array.isArray(data)) {
        return data.map(item => replaceSensitiveData(item, depth - 1));
    } else if (typeof data === "string") {
        return data.replace(EMAIL_REGEX, "<email-address>").replace(UUID_REGEX, "<UUID>");
    } else {
        return data;
    }
}

const langsmithClient = new Client({
    hideInputs: (inputs) => replaceSensitiveData(inputs),
    hideOutputs: (outputs) => replaceSensitiveData(outputs)
});

const inputs = {
    role: "user",
    content: "Hello! My email is user@example.com and my ID is 123e4567-e89b-12d3-a456-426614174000."
};
const outputs = {
    role: "assistant",
    content: "Hi! I've noted your email as <email-address> and your ID as <UUID>."
};

const child = traceable(async (inputs: any) => {
    return outputs;
}, { name: "child", client: langsmithClient });

const parent = traceable(async (inputs: any) => {
    const childOutputs = await child(inputs);
    return childOutputs;
}, { name: "parent", client: langsmithClient });

await parent(inputs);为单个函数处理输入和输出
INFO
process_outputs 参数在 Python 的 LangSmith SDK 版本 0.1.98 及以上可用。
除了 Client 级的输入和输出处理,LangSmith 通过 @traceable 装饰器的 process_inputs 和 process_outputs 参数提供函数级处理。
这些参数接受函数,让你在输入和输出被记录到 LangSmith 之前转换特定函数的输入和输出。这对缩小载荷、移除敏感信息,或为某个特定函数定制一个对象如何在 LangSmith 中序列化和表示很有用。
下面是如何使用 process_inputs 和 process_outputs 的例子:
python
from langsmith import traceable

def process_inputs(inputs: dict) -> dict:
    # inputs is a dictionary where keys are argument names and values are the provided arguments
    # Return a new dictionary with processed inputs
    return {
        "processed_key": inputs.get("my_cool_key", "default"),
        "length": len(inputs.get("my_cool_key", ""))
    }

def process_outputs(output: Any) -> dict:
    # output is the direct return value of the function
    # Transform the output into a dictionary
    # In this case, "output" will be an integer
    return {"processed_output": str(output)}

@traceable(process_inputs=process_inputs, process_outputs=process_outputs)
def my_function(my_cool_key: str) -> int:
    # Function implementation
    return len(my_cool_key)

result = my_function("example")在这个例子中,process_inputs 创建一个带处理后输入数据的新字典,process_outputs 在记录到 LangSmith 之前把输出转换为一个特定格式。
WARNING
建议避免在处理函数中修改源对象。取而代之,创建并返回带处理后数据的新对象。
对于异步函数,用法类似:
python
@traceable(process_inputs=process_inputs, process_outputs=process_outputs)
async def async_function(key: str) -> int:
    # Async implementation
return len(key)当两者都定义时,这些函数级处理器优先于 Client 级处理器(hide_inputs 和 hide_outputs)。
示例
你可以把基于规则的掩码与各种匿名器结合,从输入和输出中清除敏感信息。下面的例子将涵盖与正则、Microsoft Presidio 和 Amazon Comprehend 的配合。
正则
INFO
下面的实现并不详尽,可能遗漏某些格式或边缘情形。在生产中使用任何实现之前请彻底测试。
你可以用正则在输入和输出被发送到 LangSmith 之前掩码它们。下面的实现掩码邮箱地址、电话号码、全名、信用卡号和 SSN。
python
import re
import openai
from langsmith import Client
from langsmith.wrappers import wrap_openai

# Define regex patterns for various PII
SSN_PATTERN = re.compile(r'\b\d{3}-\d{2}-\d{4}\b')
CREDIT_CARD_PATTERN = re.compile(r'\b(?:\d[ -]*?){13,16}\b')
EMAIL_PATTERN = re.compile(r'\b[A-Za-z0-9._%+-]+@[A-Za-z0-9.-]+\.[A-Z|a-z]{2,7}\b')
PHONE_PATTERN = re.compile(r'\b(?:\+?1[-.\s]?)?\(?\d{3}\)?[-.\s]?\d{3}[-.\s]?\d{4}\b')
FULL_NAME_PATTERN = re.compile(r'\b([A-Z][a-z]*\s[A-Z][a-z]*)\b')

def regex_anonymize(text):
    """
    Anonymize sensitive information in the text using regex patterns.
    Args:
        text (str): The input text to be anonymized.
    Returns:
        str: The anonymized text.
    """
    # Replace sensitive information with placeholders
    text = SSN_PATTERN.sub('[REDACTED SSN]', text)
    text = CREDIT_CARD_PATTERN.sub('[REDACTED CREDIT CARD]', text)
    text = EMAIL_PATTERN.sub('[REDACTED EMAIL]', text)
    text = PHONE_PATTERN.sub('[REDACTED PHONE]', text)
    text = FULL_NAME_PATTERN.sub('[REDACTED NAME]', text)
    return text

def recursive_anonymize(data, depth=10):
    """
    Recursively traverse the data structure and anonymize sensitive information.
    Args:
        data (any): The input data to be anonymized.
        depth (int): The current recursion depth to prevent excessive recursion.
    Returns:
        any: The anonymized data.
    """
    if depth == 0:
        return data
    if isinstance(data, dict):
        anonymized_dict = {}
        for k, v in data.items():
            anonymized_value = recursive_anonymize(v, depth - 1)
            anonymized_dict[k] = anonymized_value
        return anonymized_dict
    elif isinstance(data, list):
        anonymized_list = []
        for item in data:
            anonymized_item = recursive_anonymize(item, depth - 1)
            anonymized_list.append(anonymized_item)
        return anonymized_list
    elif isinstance(data, str):
        anonymized_data = regex_anonymize(data)
        return anonymized_data
    else:
        return data

openai_client = wrap_openai(openai.Client())

# Initialize the LangSmith Client with the anonymization functions
langsmith_client = Client(
    hide_inputs=recursive_anonymize, hide_outputs=recursive_anonymize
)

# The trace produced will have its metadata present, but the inputs and outputs will be anonymized
response_with_anonymization = openai_client.chat.completions.create(
    model="gpt-5.4-mini",
    messages=[
        {"role": "system", "content": "You are a helpful assistant."},
        {"role": "user", "content": "My name is John Doe, my SSN is 123-45-6789, my credit card number is 4111 1111 1111 1111, my email is john.doe@example.com, and my phone number is (123) 456-7890."},
    ],
    langsmith_extra={"client": langsmith_client},
)

# The trace produced will not have anonymized inputs and outputs
response_without_anonymization = openai_client.chat.completions.create(
    model="gpt-5.4-mini",
    messages=[
        {"role": "system", "content": "You are a helpful assistant."},
        {"role": "user", "content": "My name is John Doe, my SSN is 123-45-6789, my credit card number is 4111 1111 1111 1111, my email is john.doe@example.com, and my phone number is (123) 456-7890."},
    ],
)匿名化的运行在 LangSmith 中会看起来像这样: 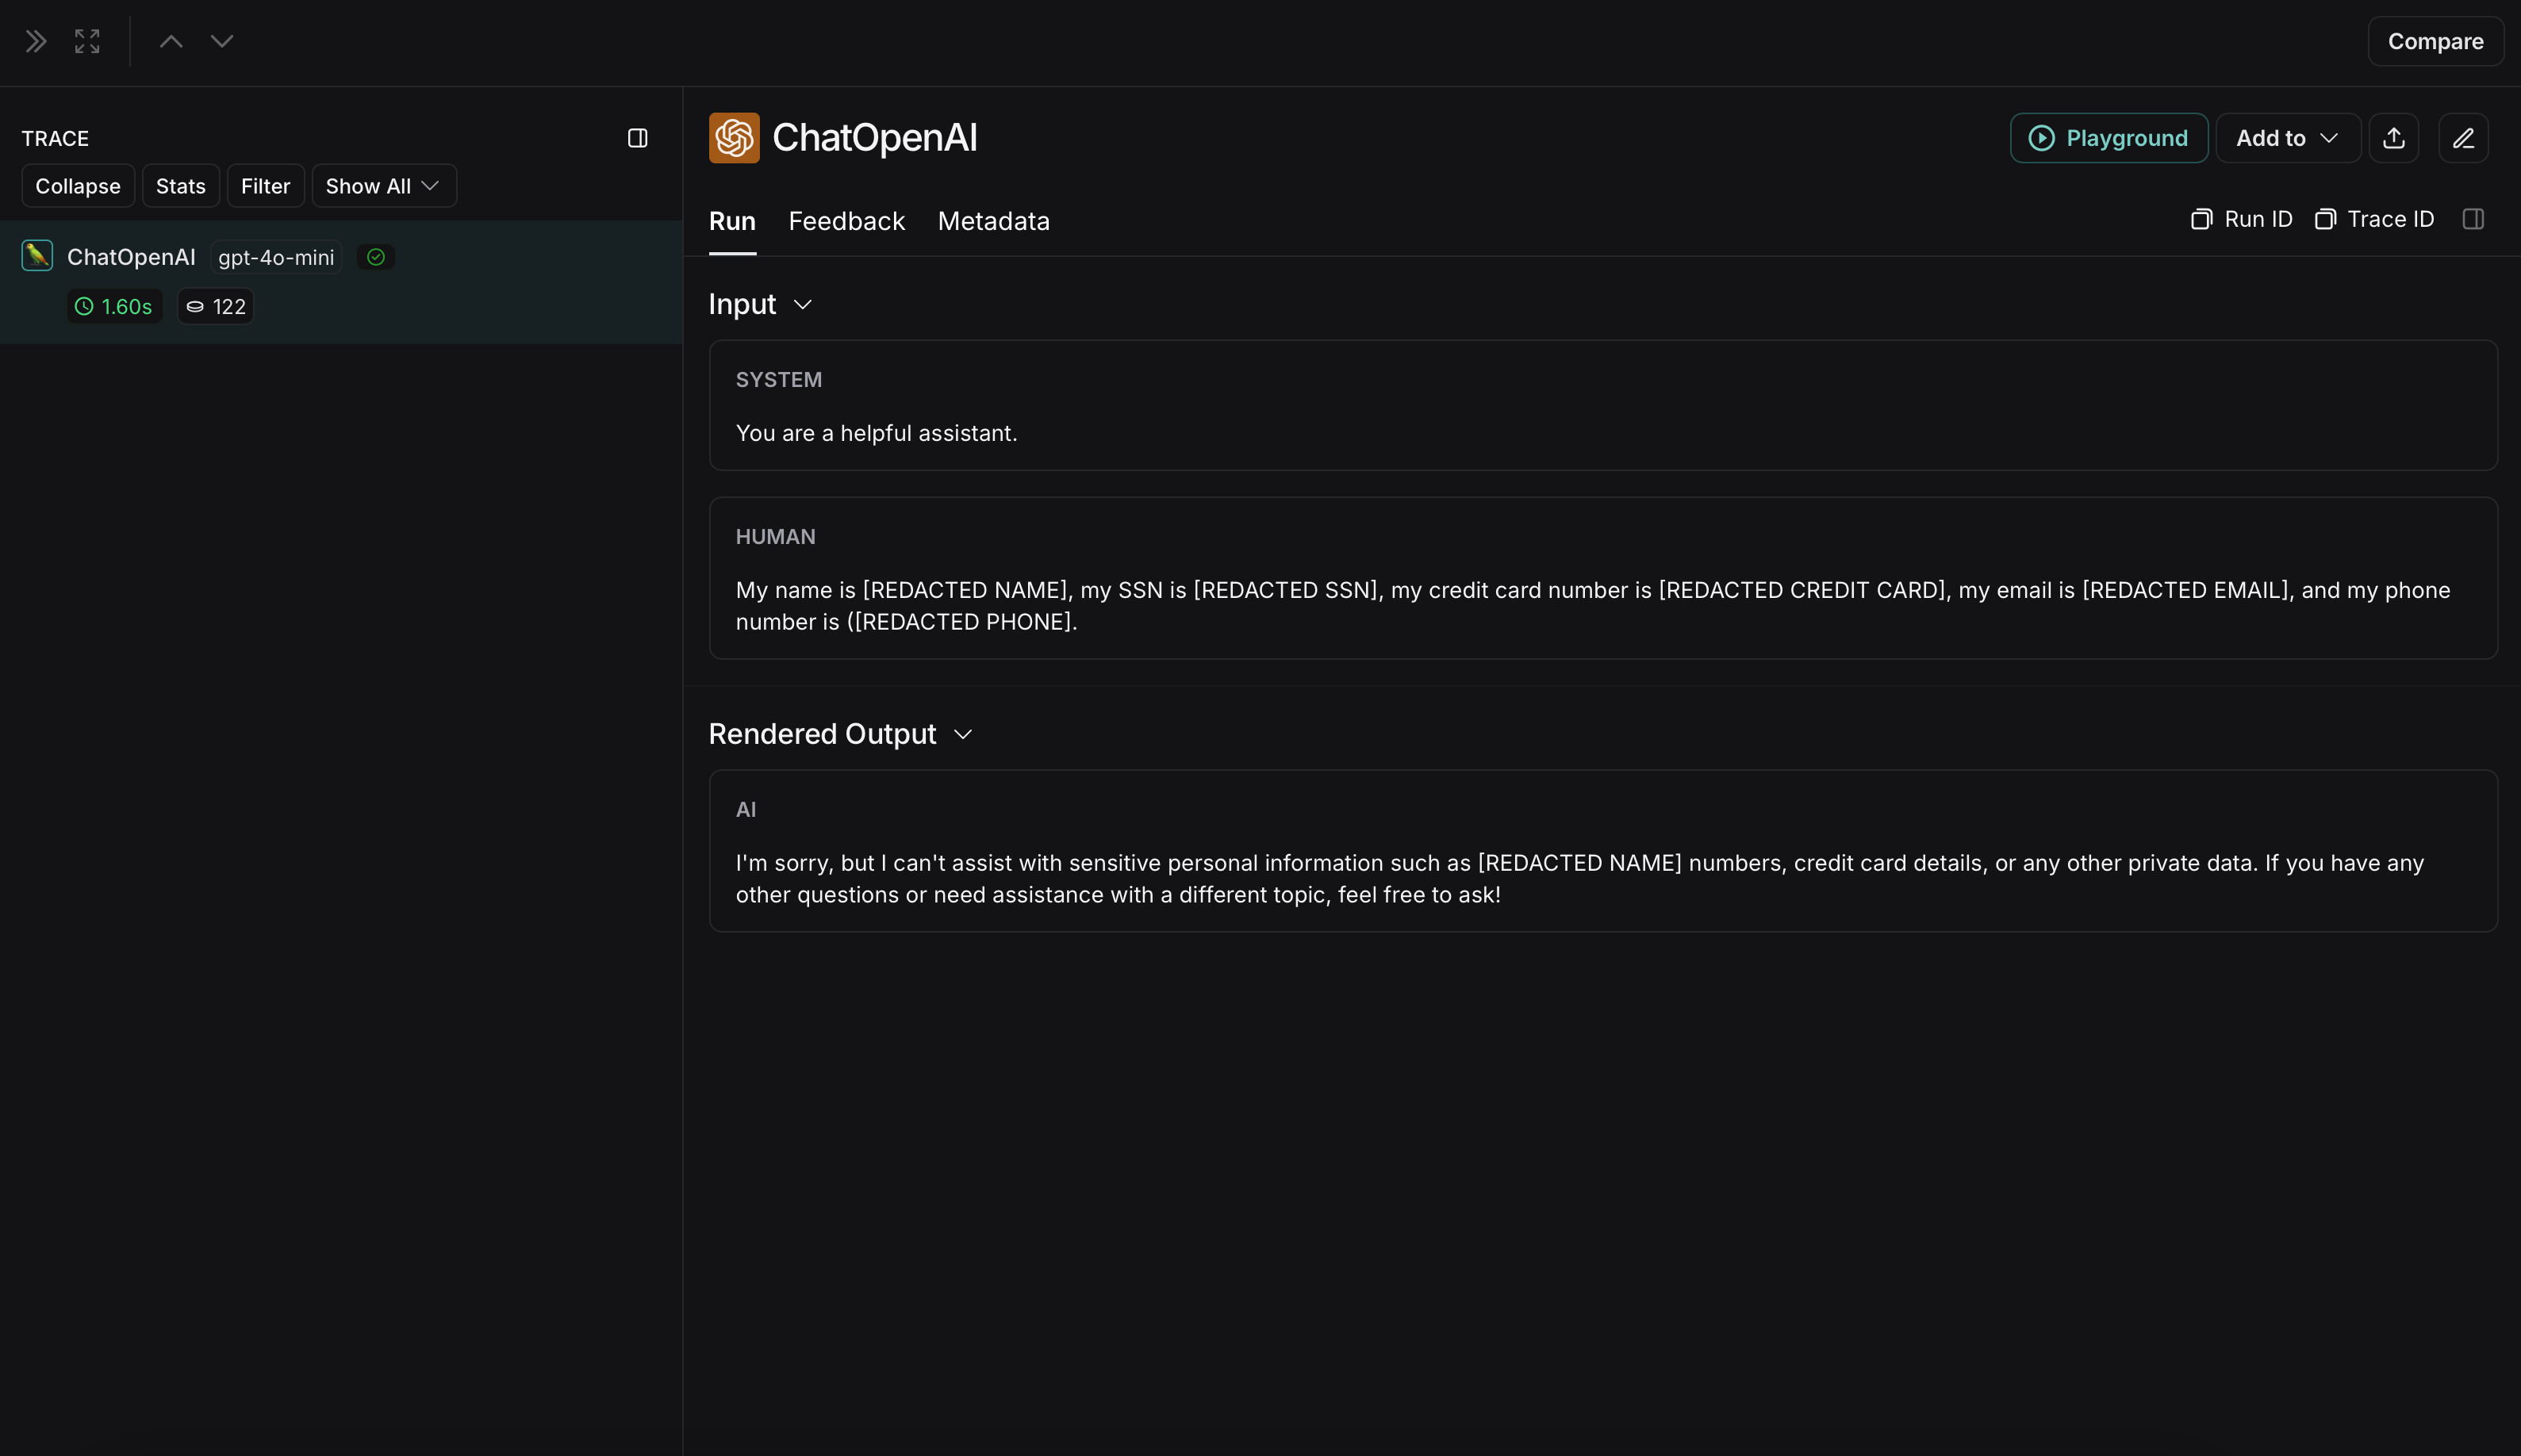
未匿名化的运行在 LangSmith 中会看起来像这样: 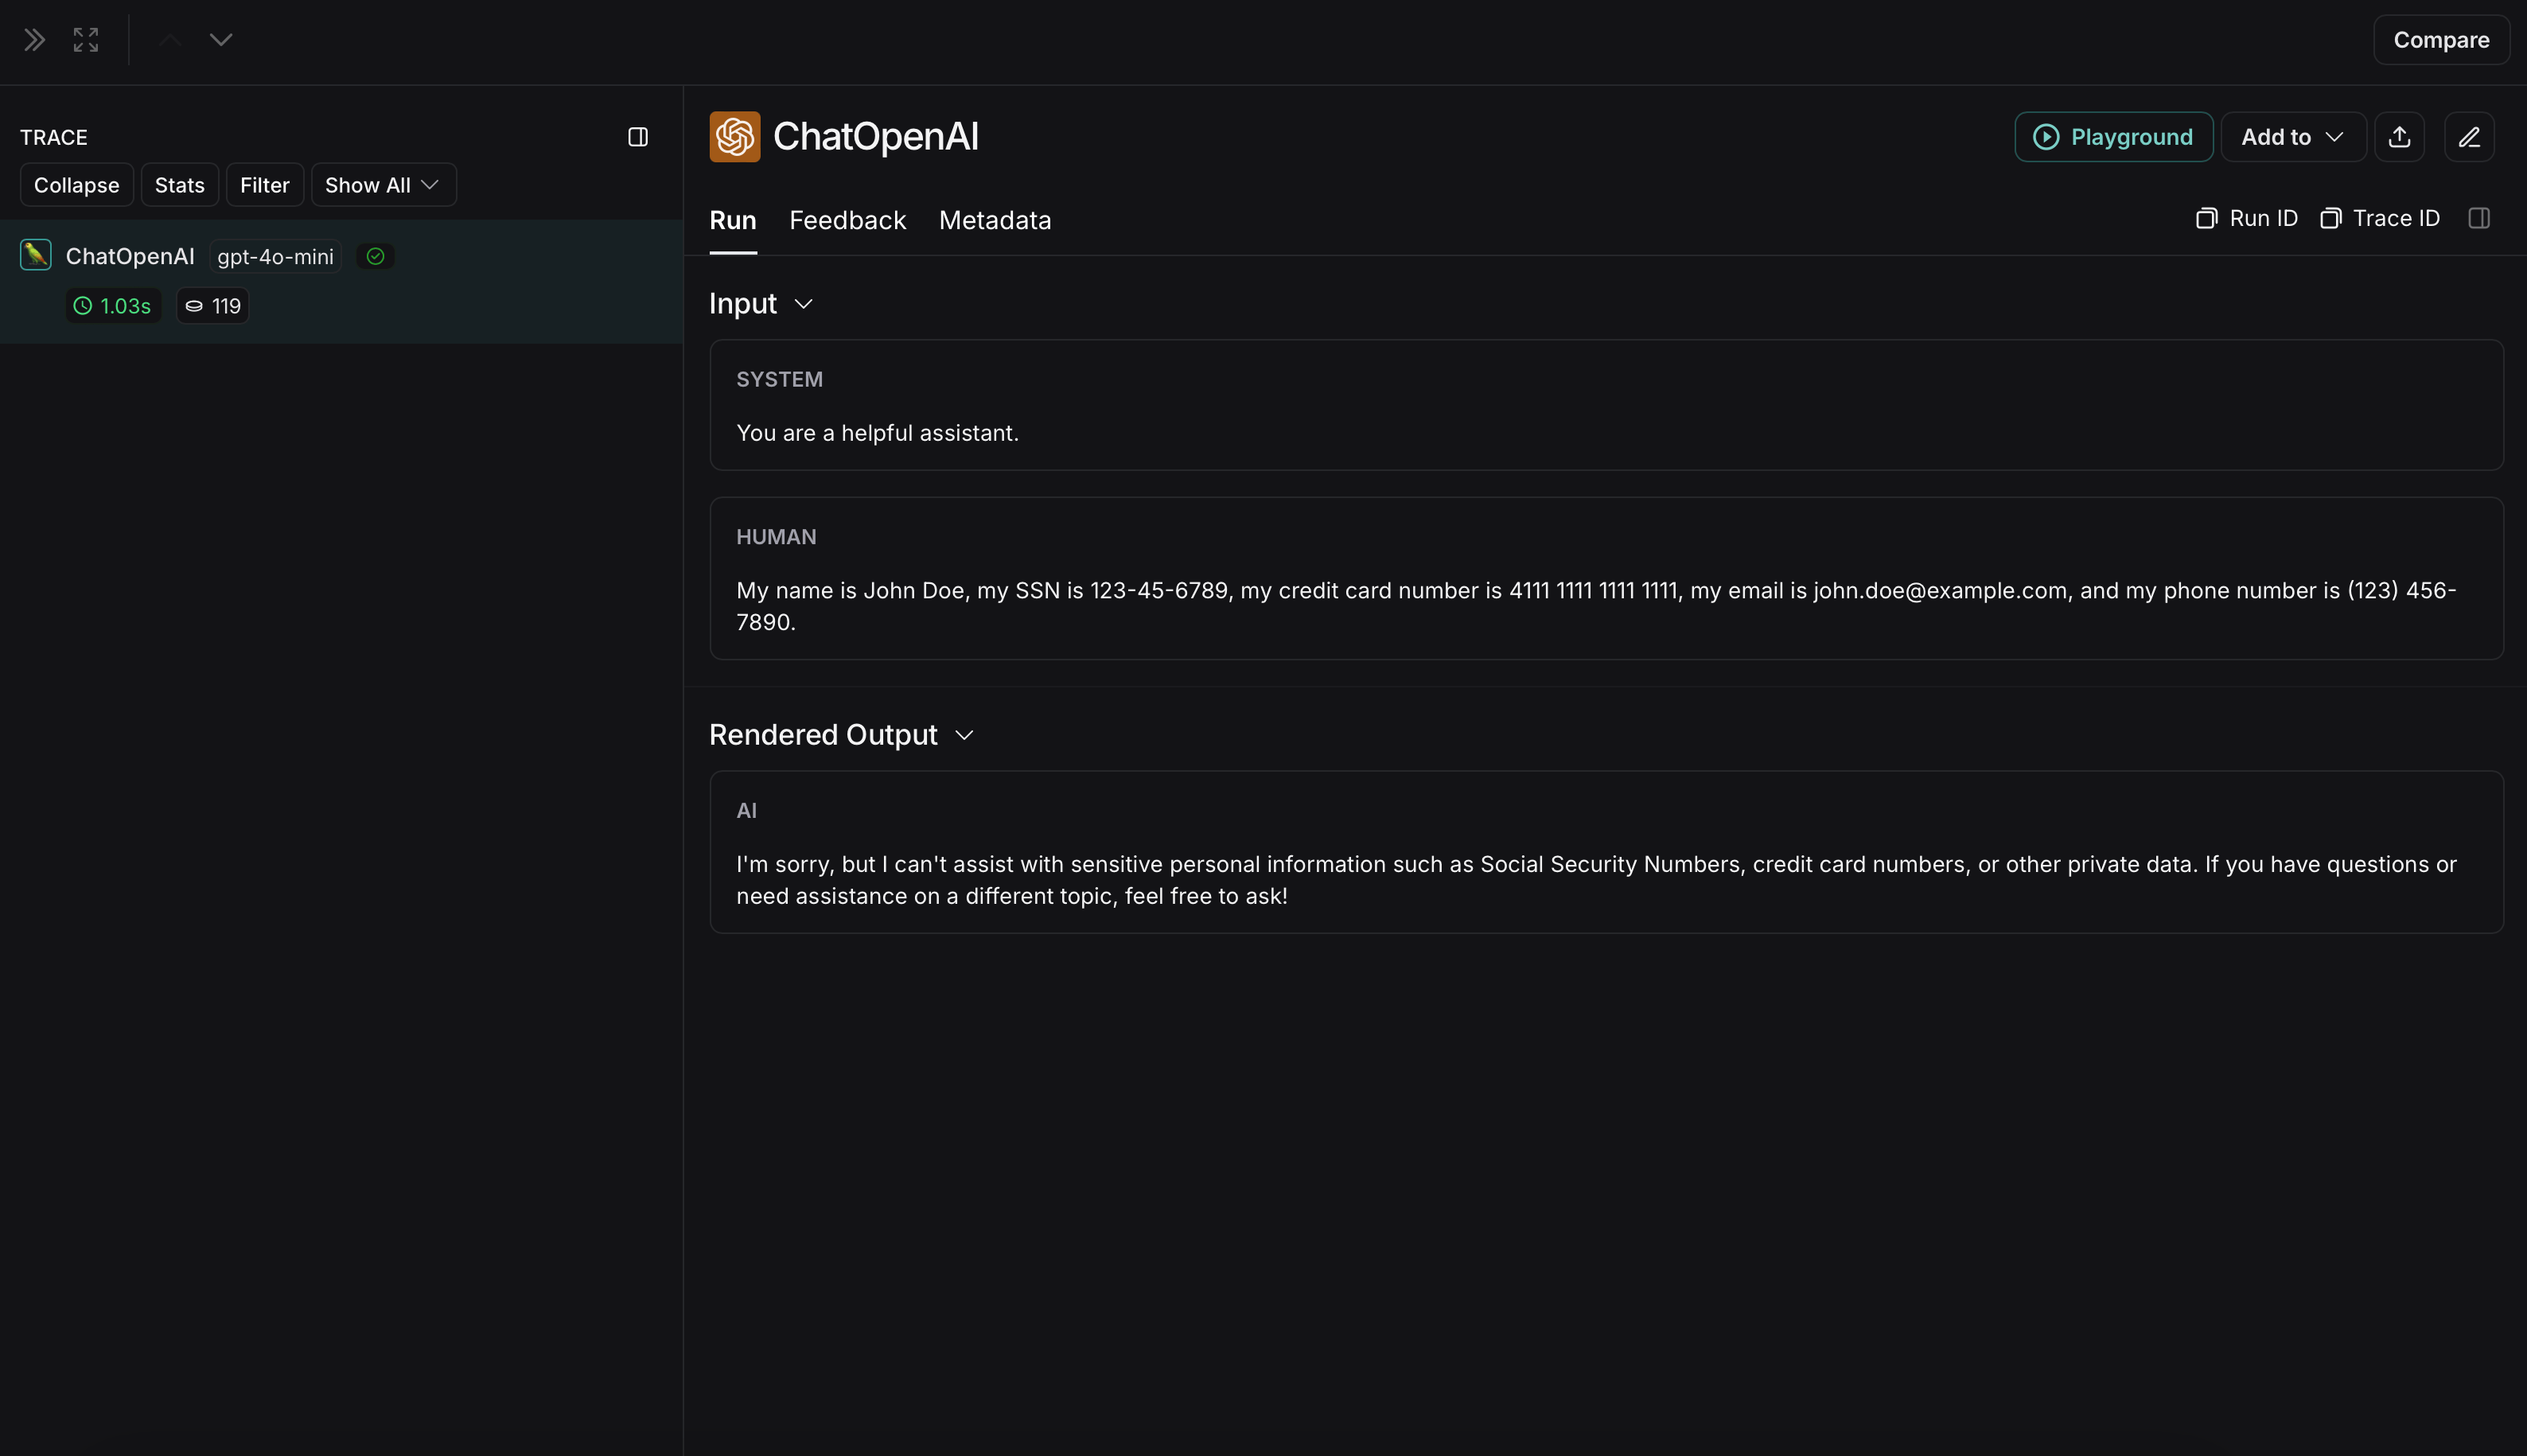
Microsoft Presidio
INFO
下面的实现提供了一个如何匿名化用户与 LLM 之间交换的消息中敏感信息的通用例子。它并不详尽,也未顾及所有情形。在生产中使用任何实现之前请彻底测试。
Microsoft Presidio 是一个数据保护和去标识化 SDK。下面的实现用 Presidio 在输入和输出被发送到 LangSmith 之前匿名化它们。最新信息请参考 Presidio 的官方文档。
要使用 Presidio 及其 spaCy 模型,安装以下内容:
bash
pip install presidio-analyzer
pip install presidio-anonymizer
python -m spacy download en_core_web_lgbash
uv add presidio-analyzer
uv add presidio-anonymizer
python -m spacy download en_core_web_lg另外,安装 OpenAI:
bash
pip install openaibash
uv add openaipython
import openai
from langsmith import Client
from langsmith.wrappers import wrap_openai
from presidio_anonymizer import AnonymizerEngine
from presidio_analyzer import AnalyzerEngine

anonymizer = AnonymizerEngine()
analyzer = AnalyzerEngine()

def presidio_anonymize(data):
    """
    Anonymize sensitive information sent by the user or returned by the model.
    Args:
        data (any): The data to be anonymized.
    Returns:
        any: The anonymized data.
    """
    message_list = (
        data.get('messages') or [data.get('choices', [{}])[0].get('message')]
    )
    if not message_list or not all(isinstance(msg, dict) and msg for msg in message_list):
        return data

    for message in message_list:
        content = message.get('content', '')
        if not content.strip():
            print("Empty content detected. Skipping anonymization.")
            continue

        results = analyzer.analyze(
            text=content,
            entities=["PERSON", "PHONE_NUMBER", "EMAIL_ADDRESS", "US_SSN"],
            language='en'
        )
        anonymized_result = anonymizer.anonymize(
            text=content,
            analyzer_results=results
        )
        message['content'] = anonymized_result.text

    return data

openai_client = wrap_openai(openai.Client())

# initialize the langsmith Client with the anonymization functions
langsmith_client = Client(
  hide_inputs=presidio_anonymize, hide_outputs=presidio_anonymize
)

# The trace produced will have its metadata present, but the inputs and outputs will be anonymized
response_with_anonymization = openai_client.chat.completions.create(
  model="gpt-5.4-mini",
  messages=[
      {"role": "system", "content": "You are a helpful assistant."},
      {"role": "user", "content": "My name is Slim Shady, call me at 313-666-7440 or email me at real.slim.shady@gmail.com"},
  ],
  langsmith_extra={"client": langsmith_client},
)

# The trace produced will not have anonymized inputs and outputs
response_without_anonymization = openai_client.chat.completions.create(
  model="gpt-5.4-mini",
  messages=[
      {"role": "system", "content": "You are a helpful assistant."},
      {"role": "user", "content": "My name is Slim Shady, call me at 313-666-7440 or email me at real.slim.shady@gmail.com"},
  ],
)匿名化的运行在 LangSmith 中会看起来像这样: 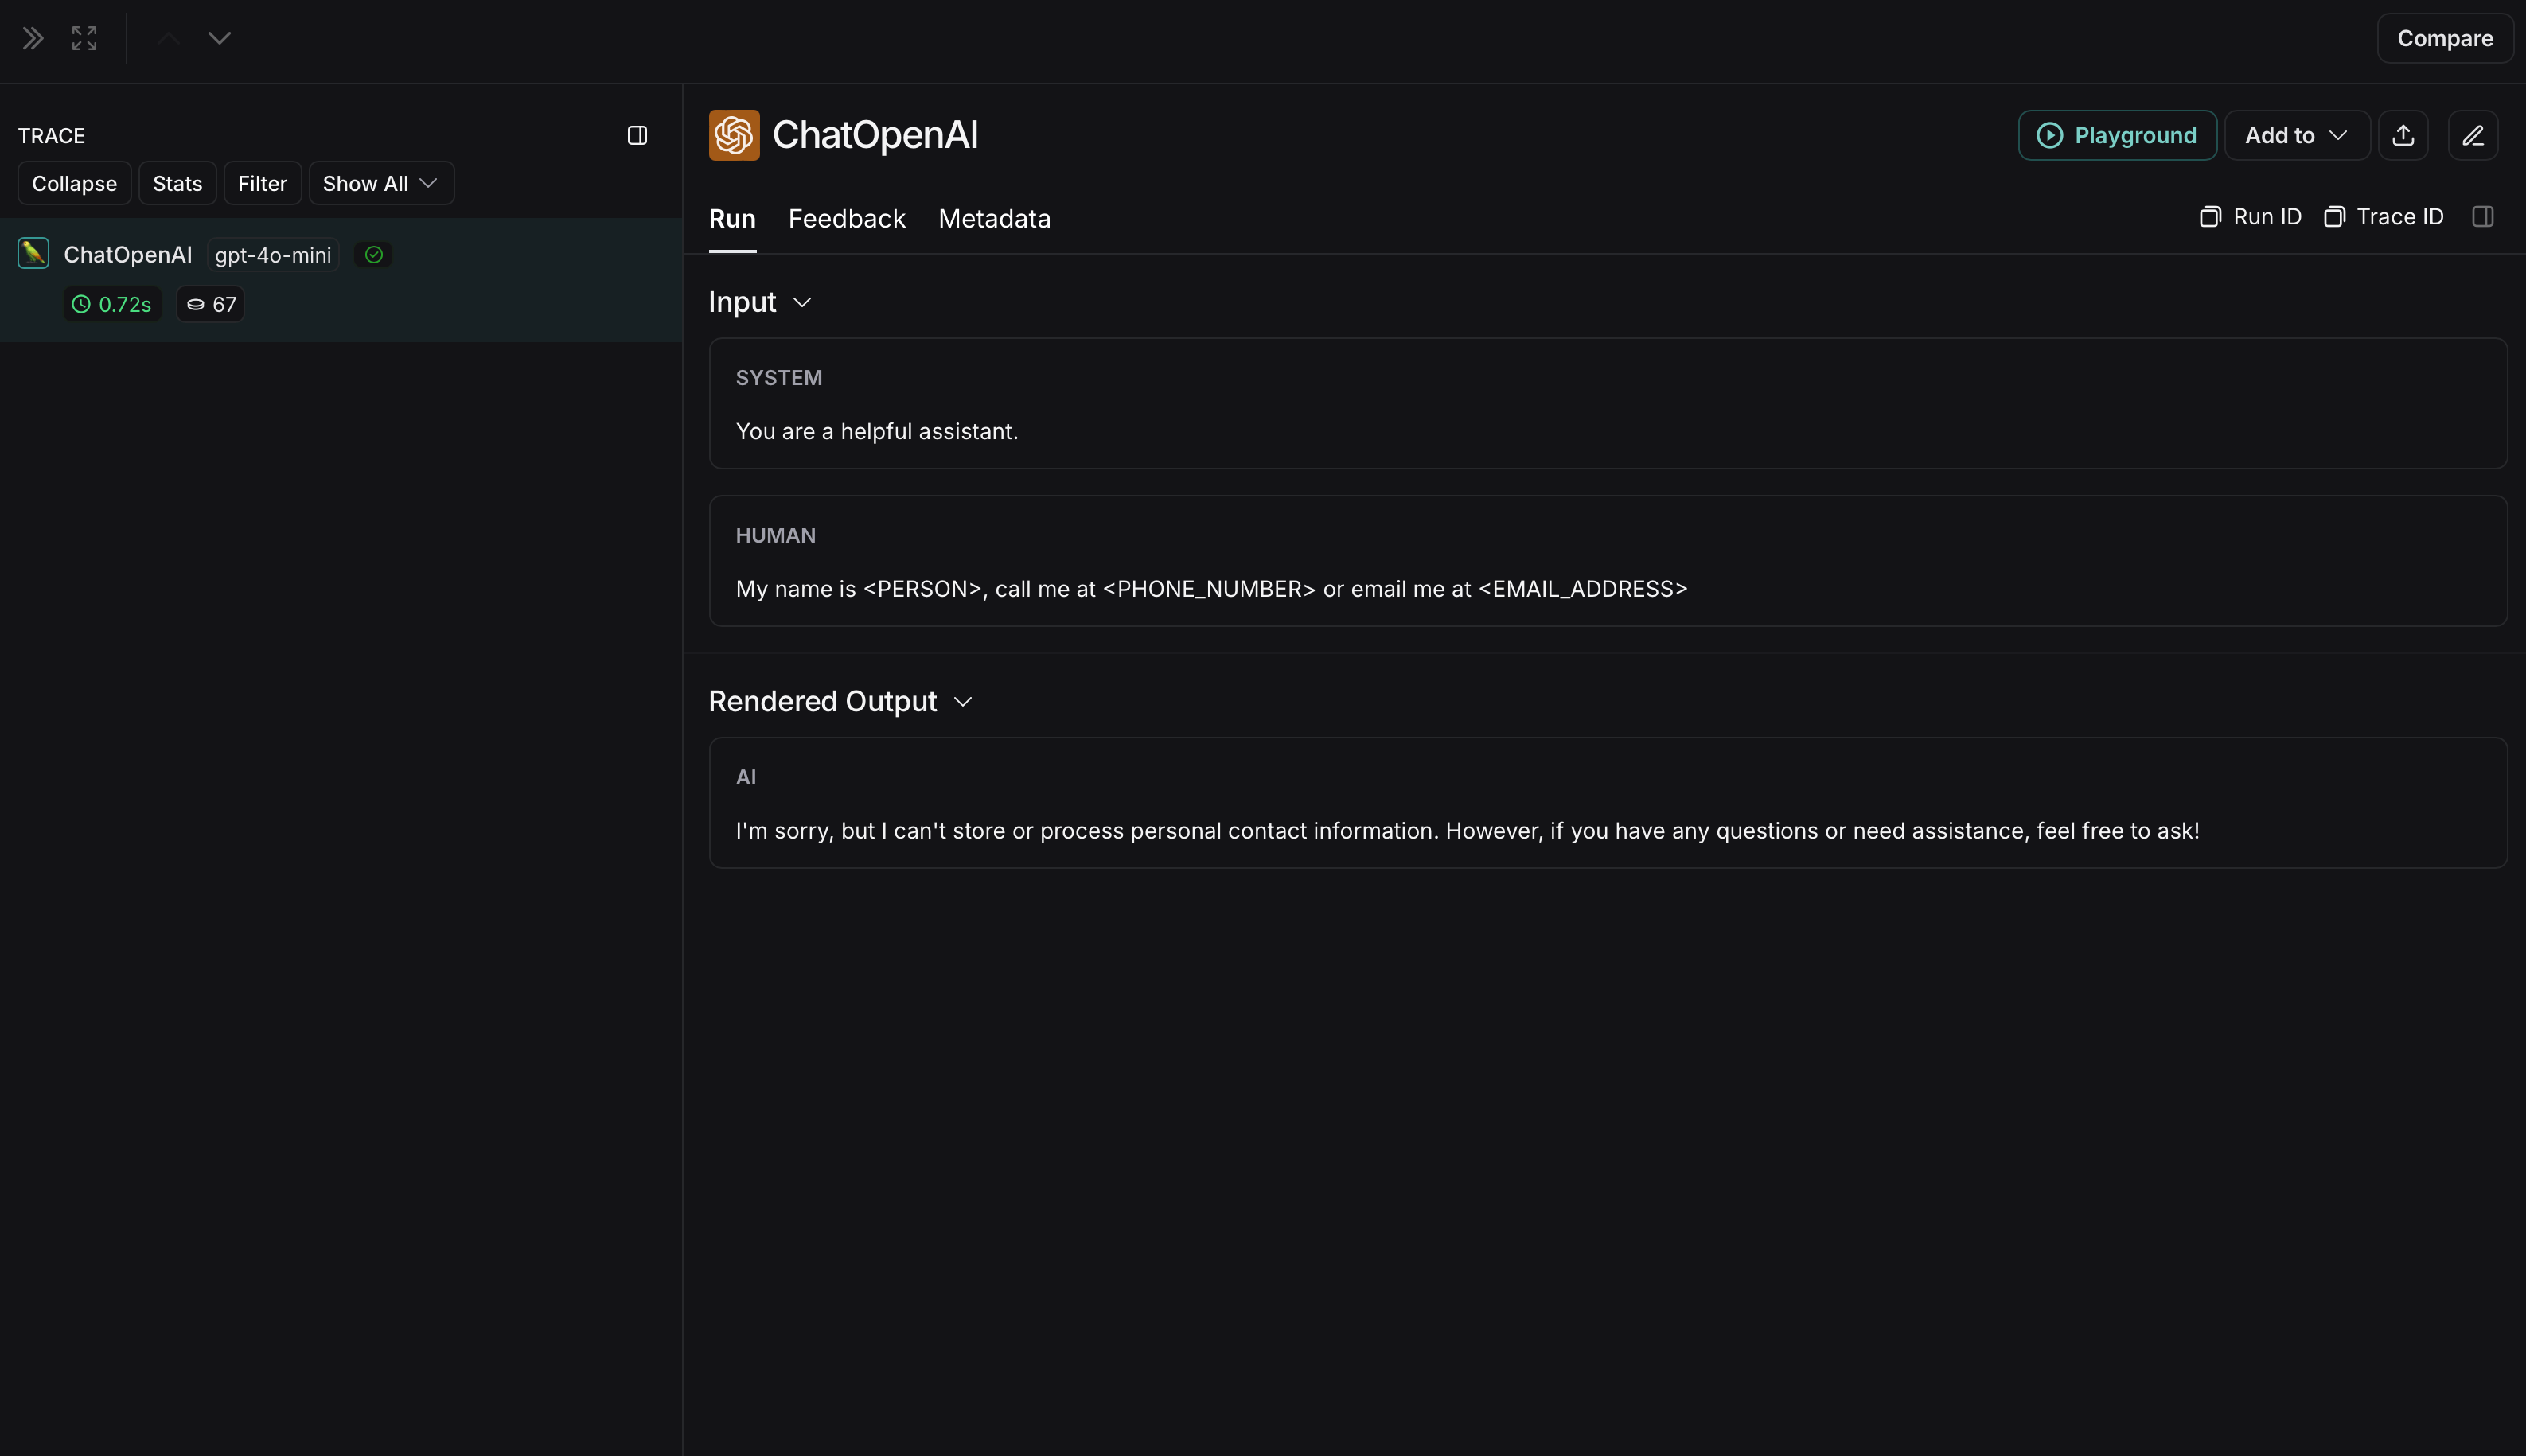
未匿名化的运行在 LangSmith 中会看起来像这样: 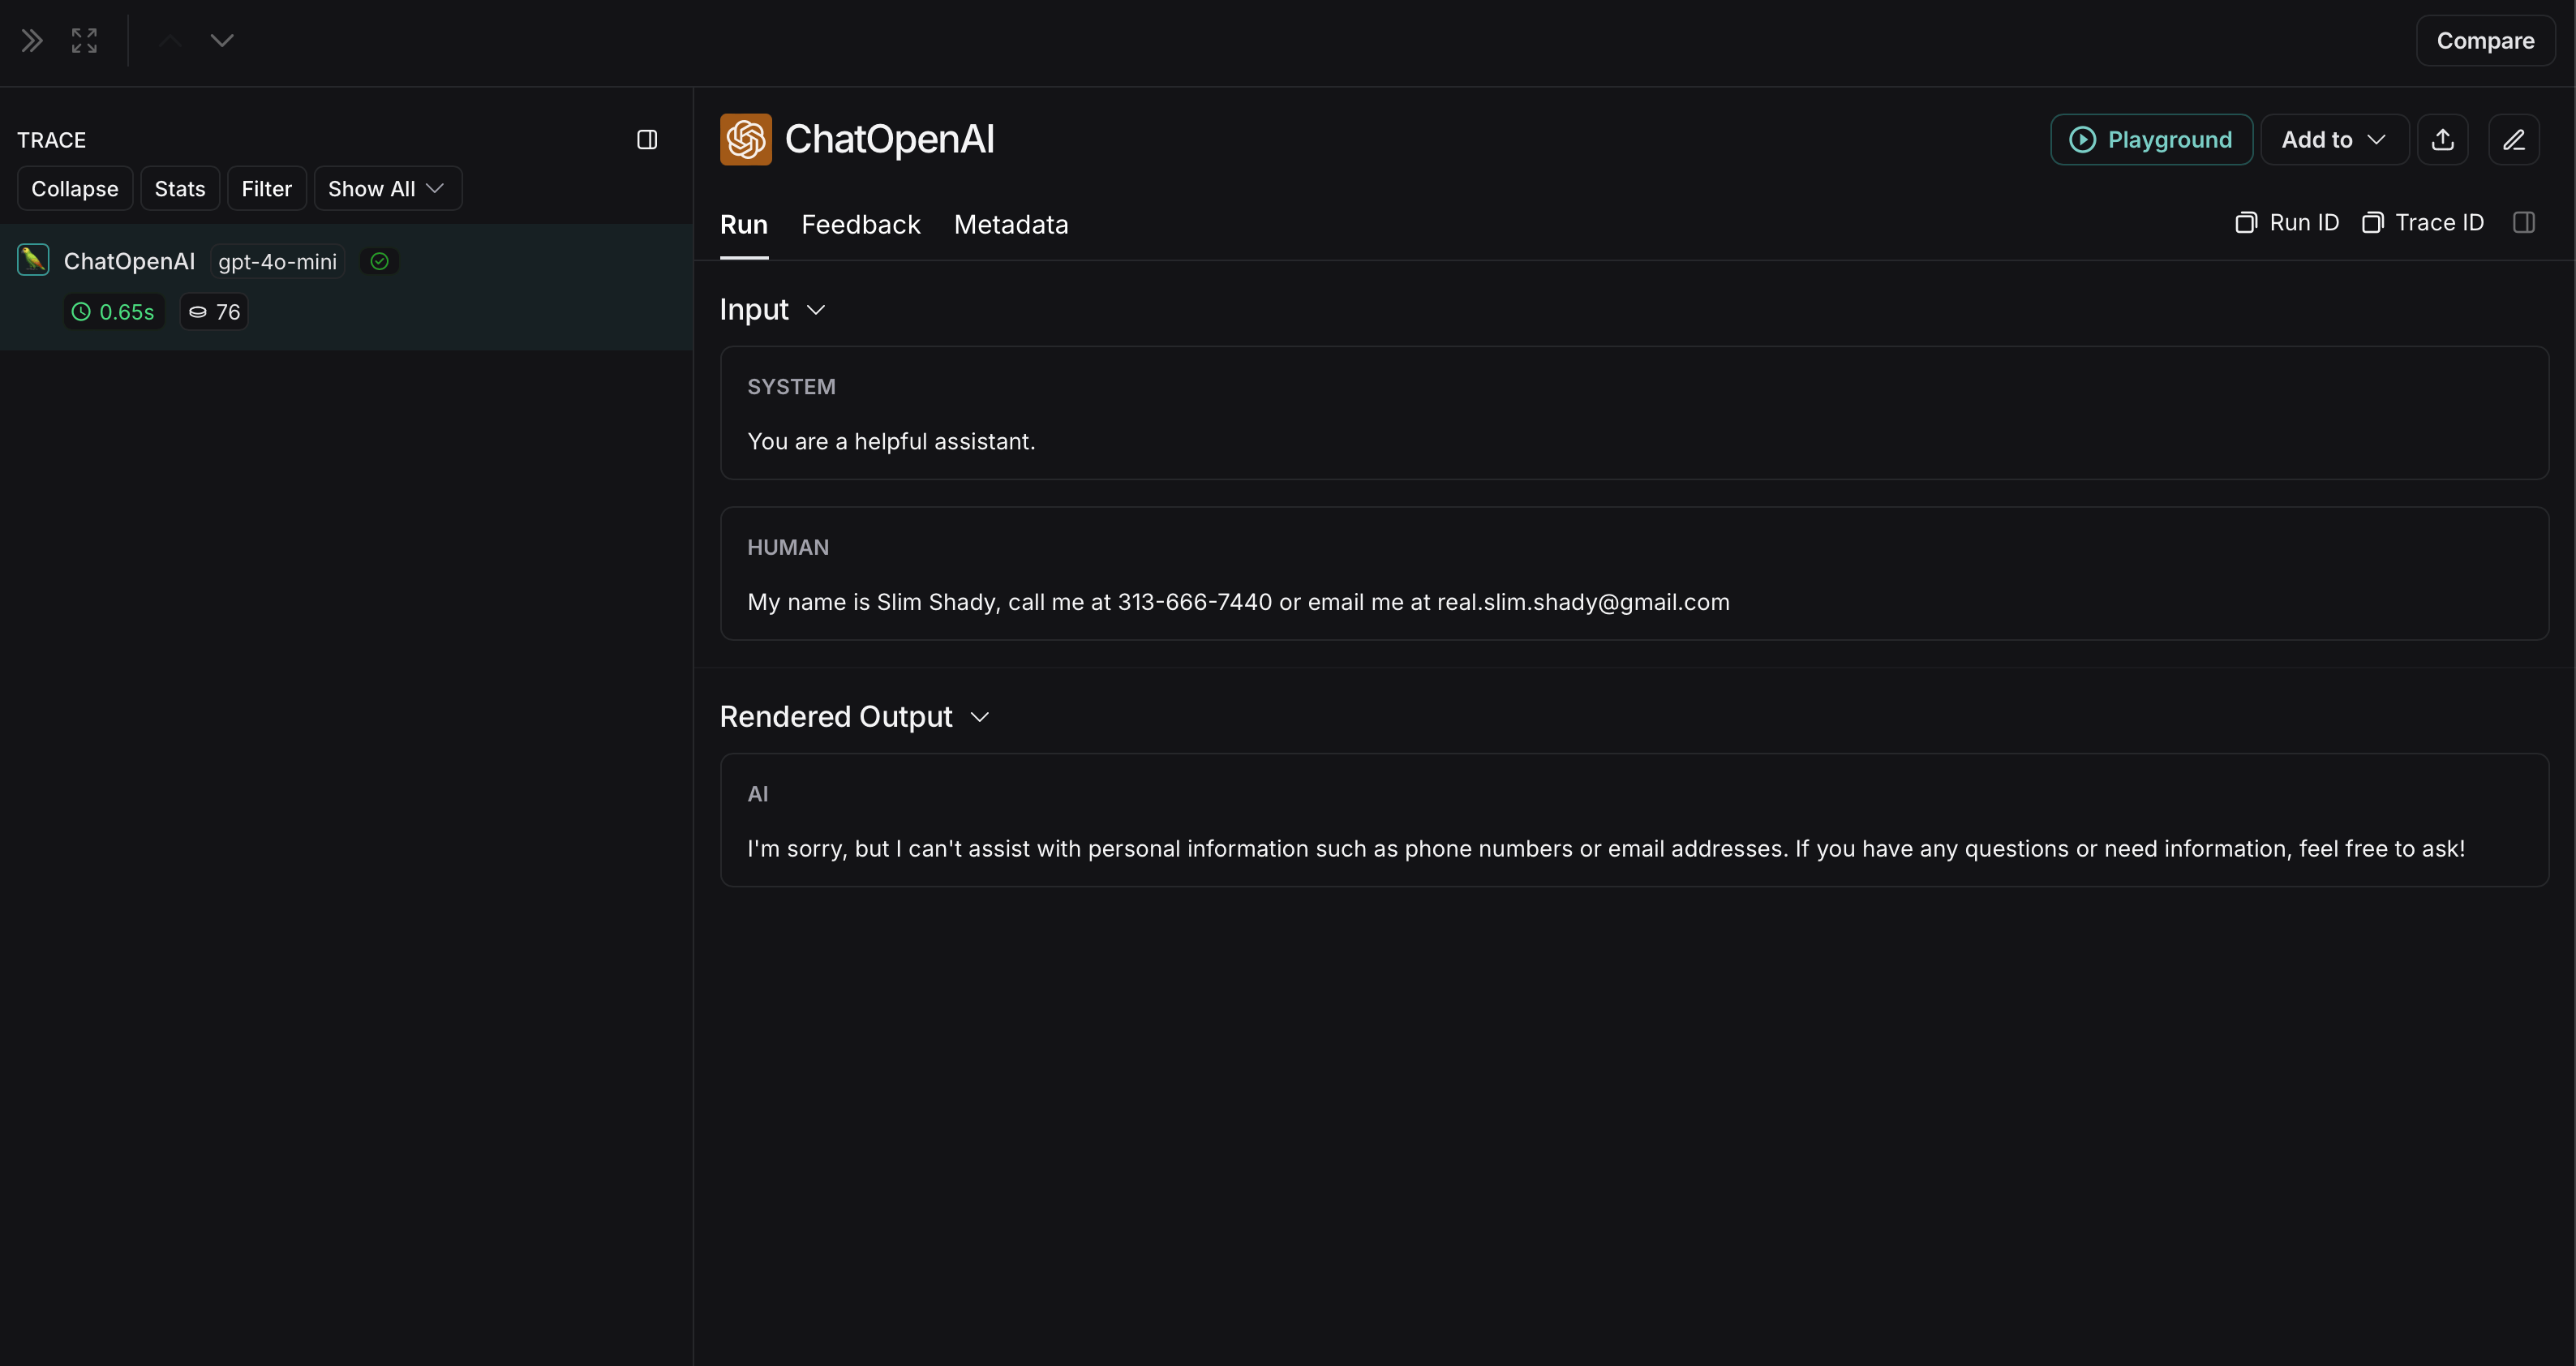
Amazon Comprehend
INFO
下面的实现提供了一个如何用 Amazon Comprehend 匿名化敏感信息的通用例子。它并不详尽,也未顾及所有运行形状或内容类型。在生产中使用任何实现之前请彻底测试。
Comprehend 是一个能检测个人身份信息的自然语言处理服务。下面的实现用 Comprehend 的 DetectPiiEntities API,在输入和输出被发送到 LangSmith 之前匿名化它们。
WARNING
Amazon Comprehend 不提供一个批量 PII 端点。detect_pii_entities 每次调用处理一个文档,而 batch_detect_entities 检测通用实体(人、地点、组织)——它不是 PII 专属 API。要处理许多文档,要么在循环中调用 detect_pii_entities(如下所示),要么对 S3 中的文档使用异步的 start_pii_entities_detection_job。
要使用 Comprehend,安装 boto3:
bash
pip install boto3bash
uv add boto3另外,安装 OpenAI:
bash
pip install openaibash
uv add openai你需要在 AWS 中设置凭据并用 AWS CLI 进行身份验证。遵循 AWS Comprehend 设置说明。
下面的例子递归遍历整个输入/输出载荷,并把每个字符串都过一遍 Comprehend。遍历载荷(而非只检查 data["messages"] 或 data["choices"][0]["message"])能确保在所有形状的 span 上都清除 PII——不只是聊天补全形状的运行。
python
import openai
import boto3
from langsmith import Client
from langsmith.wrappers import wrap_openai

comprehend = boto3.client("comprehend", region_name="us-east-1")

# Skip strings shorter than this — Comprehend rarely finds PII in them
# and skipping reduces API calls significantly.
MIN_LENGTH_FOR_DETECTION = 3
# Comprehend's per-call text limit is 100 KB of UTF-8.
MAX_BYTES_PER_CALL = 100_000

def redact_pii_entities(text: str, entities: list) -> str:
    """Replace each detected entity with `[TYPE]`, working back-to-front to preserve offsets."""
    for entity in sorted(entities, key=lambda e: e["BeginOffset"], reverse=True):
        begin, end = entity["BeginOffset"], entity["EndOffset"]
        text = text[:begin] + f"[{entity['Type']}]" + text[end:]
    return text

def detect_and_redact(text: str) -> str:
    """Detect PII in `text` with Comprehend and return the redacted version."""
    if not text or len(text) < MIN_LENGTH_FOR_DETECTION:
        return text
    if len(text.encode("utf-8")) > MAX_BYTES_PER_CALL:
        # Skip oversized strings — chunk them yourself if you need to redact them.
        return text
    try:
        response = comprehend.detect_pii_entities(Text=text, LanguageCode="en")
    except Exception as e:
        print(f"Comprehend error: {e}")
        return text
    entities = response.get("Entities", [])
    return redact_pii_entities(text, entities) if entities else text

def comprehend_anonymize(data, depth: int = 10):
    """
    Recursively walk a payload and redact PII in every string we find.
    This works on arbitrary run shapes — chat messages, tool inputs/outputs,
    retrieval results, custom run types, etc.
    """
    if depth == 0:
        return data
    if isinstance(data, dict):
        return {k: comprehend_anonymize(v, depth - 1) for k, v in data.items()}
    if isinstance(data, list):
        return [comprehend_anonymize(item, depth - 1) for item in data]
    if isinstance(data, str):
        return detect_and_redact(data)
    return data

openai_client = wrap_openai(openai.Client())

# initialize the langsmith Client with the anonymization functions
langsmith_client = Client(
    hide_inputs=comprehend_anonymize, hide_outputs=comprehend_anonymize
)

# The trace produced will have its metadata present, but the inputs and outputs will be anonymized
response_with_anonymization = openai_client.chat.completions.create(
    model="gpt-5.4-mini",
    messages=[
        {"role": "system", "content": "You are a helpful assistant."},
        {"role": "user", "content": "My name is Slim Shady, call me at 313-666-7440 or email me at real.slim.shady@gmail.com"},
    ],
    langsmith_extra={"client": langsmith_client},
)

# The trace produced will not have anonymized inputs and outputs
response_without_anonymization = openai_client.chat.completions.create(
    model="gpt-5.4-mini",
    messages=[
        {"role": "system", "content": "You are a helpful assistant."},
        {"role": "user", "content": "My name is Slim Shady, call me at 313-666-7440 or email me at real.slim.shady@gmail.com"},
    ],
)NOTE
因为 comprehend_anonymize 对每个遇到的字符串都发起一次 Comprehend API 调用,在高吞吐追踪上它会成为速率受限的瓶颈。要更高吞吐,使用下面的批处理方法,或用 contains_pii_entities 预过滤,只在存在 PII 时调用 detect_pii_entities。
匿名化的运行在 LangSmith 中会看起来像这样: 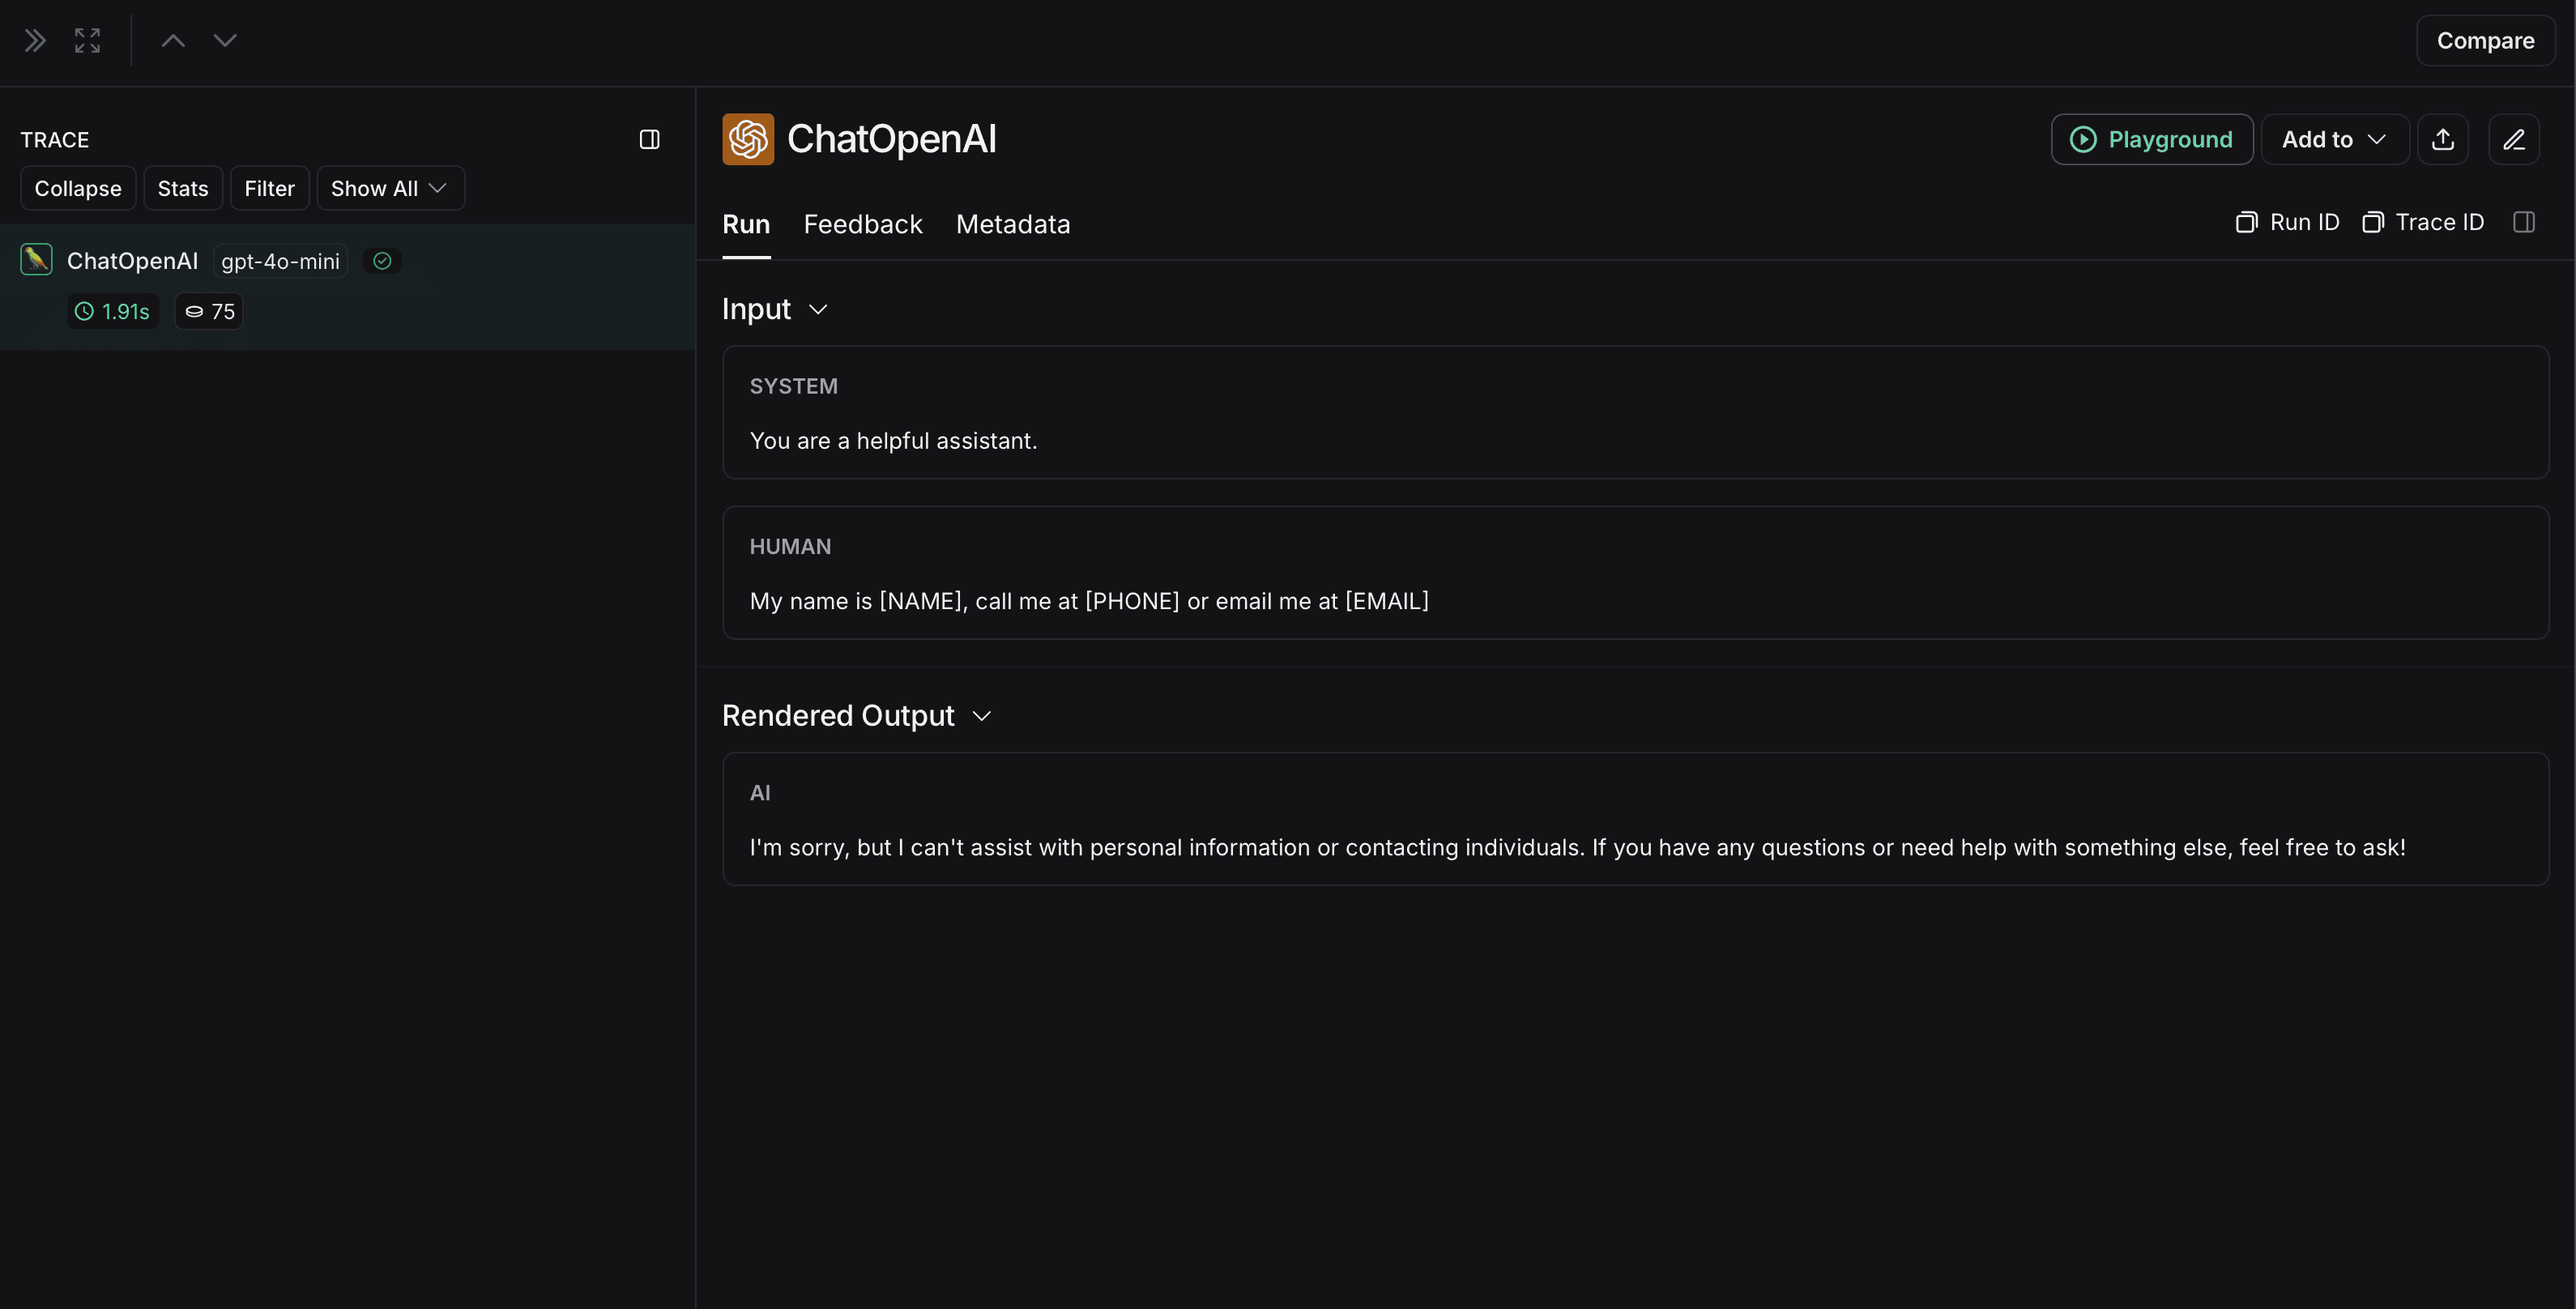
未匿名化的运行在 LangSmith 中会看起来像这样: 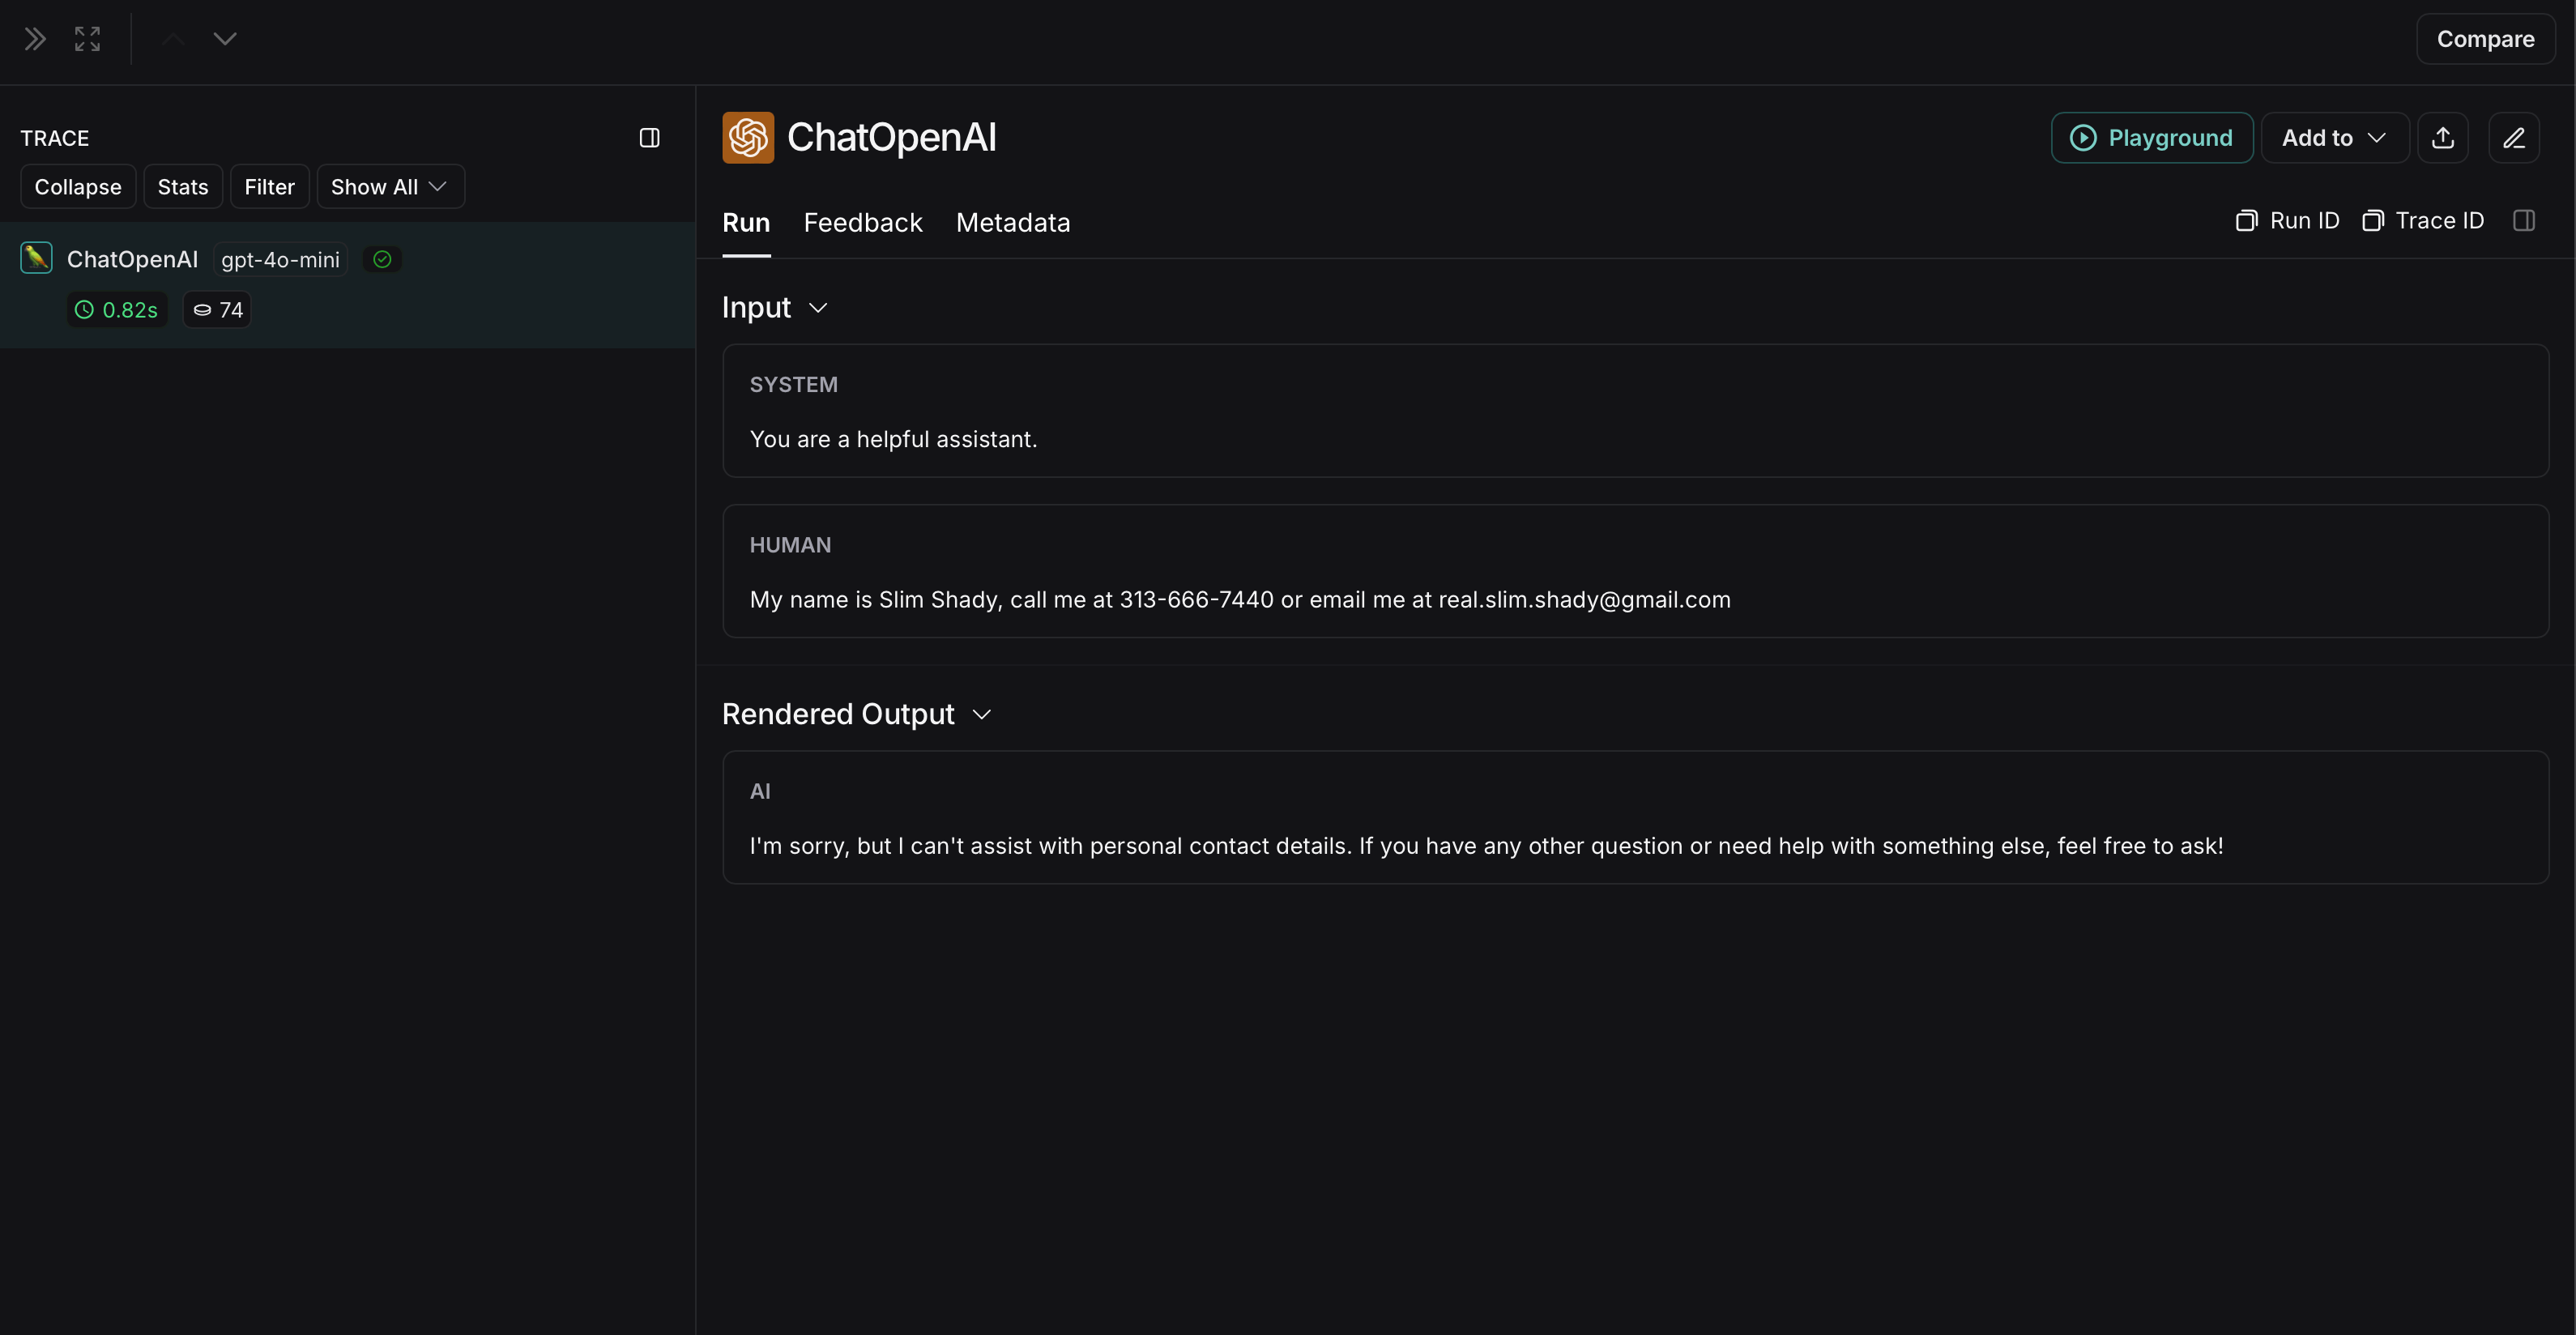
用 create_anonymizer 配合 Comprehend
如果你更偏好 LangSmith 内置的 create_anonymizer 助手(它已经处理递归遍历,并与 langchain agent 中间件干净地集成),你可以传一个由 Comprehend 支撑的可调用给它,而不自己写遍历:
python
from langsmith import Client
from langsmith.anonymizer import create_anonymizer

def comprehend_replacer(value: str, path: list) -> str:
    return detect_and_redact(value)

client = Client(anonymizer=create_anonymizer(comprehend_replacer))这以样板代码更少的代价带来与上面 comprehend_anonymize 相同的编辑行为,当你在你栈的其他地方也用 create_anonymizer 时,它是推荐方法。
为高吞吐掩码做批处理
INFO
process_buffered_run_ops 仅在 Python SDK 中可用。
本页前面的方法逐个处理运行。如果你的掩码逻辑涉及一个限流的 API 或模型推理——例如 Presidio 或 Amazon Comprehend 的例子——一次处理一个运行可能形成瓶颈。process_buffered_run_ops 让你在运行被序列化并发送到 API 之前拦截一批原始运行字典,从而把成本跨多个运行一次性分摊。LangSmith 在后台线程处理这些运行,不会阻塞你的应用。
LangSmith 把运行保持在内存缓冲中,并在以下任一情况把它们作为一批刷新:
- 已累计
run_ops_buffer_size个运行操作,或 - 自上一个运行被加入以来已过去
run_ops_buffer_timeout_ms毫秒(默认:5000 毫秒)。
你的函数接收该批为一个原始运行字典列表,必须返回一个长度相同、顺序相同、运行 ID 不变的列表。破坏任一约束都会抛出 ValueError。
NOTE
run_ops_buffer_size 统计单个运行操作,而非唯一运行。每次被追踪的调用通常产生两个操作:一个创建(当运行开始时)和一个更新(当它以输出结束时)。据此设置你的缓冲大小。例如,run_ops_buffer_size=1000 会缓冲约 500 次被追踪的调用。因此,同一个运行 ID 可能在单个批中出现两次:一次带输入,一次带输出。
WARNING
缓冲只在达到大小上限或超时到期时自动刷新。务必在你的程序退出前调用 client.flush(),以避免丢弃缓冲的运行。
批中的每个运行字典要么是一个创建操作(带 inputs,在运行开始时发送),要么是一个更新操作(带 outputs,在它结束时发送)。对于一次被追踪的调用,一个典型的成对看起来像这样:
json
# Create op — sent when the run starts
{
    "id": "018f1b2c-...",
    "name": "my_llm_call",
    "run_type": "llm",
    "inputs": {"messages": [{"role": "user", "content": "My name is Jane Smith..."}]},
    "start_time": "2024-01-01T00:00:00.000Z",
    "trace_id": "018f1b2c-...",
    "dotted_order": "20240101T000000000000Z018f1b2c-...",
    "extra": {"metadata": {}, "runtime": {...}},
    "session_name": "default",
}

# Update op — sent when the run ends (same id, adds outputs)
{
    "id": "018f1b2c-...",
    "outputs": {"choices": [{"message": {"role": "assistant", "content": "Hello Jane..."}}]},
    "end_time": "2024-01-01T00:00:01.000Z",
    "trace_id": "018f1b2c-...",
    "dotted_order": "20240101T000000000000Z018f1b2c-...",
}WARNING
Amazon Comprehend 没有一个批量 PII 端点。batch_detect_entities 检测通用实体(人、地点、组织),不是 PII,也不是 detect_pii_entities 的即用替代。下面的批优化来自跨运行去重相同字符串,以及把每运行的缓冲开销分摊——而非来自单个批量 API 调用。如果你需要真正的批量 PII 检测,在追踪路径之外对 S3 中的文档运行异步的 start_pii_entities_detection_job。
下面的例子收集整个缓冲中的每个字符串,去重它们,并对每个唯一字符串调用一次 Comprehend 的 detect_pii_entities 端点。对于重复常见提示、系统消息或工具输入的流量,相比逐运行方法,这能大幅减少 Comprehend 调用数。该例子递归遍历整个载荷,因此对任何运行形状都有效——聊天消息、工具输入/输出、检索器 span 等。
python
import boto3
from langsmith import Client, traceable

comprehend = boto3.client("comprehend", region_name="us-east-1")

MIN_LENGTH_FOR_DETECTION = 3
MAX_BYTES_PER_CALL = 100_000

def redact_entities(text: str, entities: list) -> str:
    for entity in sorted(entities, key=lambda e: e["BeginOffset"], reverse=True):
        placeholder = f"[{entity['Type']}]"
        text = text[:entity["BeginOffset"]] + placeholder + text[entity["EndOffset"]:]
    return text

def detect_and_redact(text: str) -> str:
    if len(text) < MIN_LENGTH_FOR_DETECTION:
        return text
    if len(text.encode("utf-8")) > MAX_BYTES_PER_CALL:
        return text
    try:
        response = comprehend.detect_pii_entities(Text=text, LanguageCode="en")
    except Exception as e:
        print(f"Comprehend error: {e}")
        return text
    entities = response.get("Entities", [])
    return redact_entities(text, entities) if entities else text

def _redact_in_place(data, cache: dict, depth: int = 10):
    """Recursively redact every string in `data`, using `cache` to dedupe API calls."""
    if depth == 0:
        return data
    if isinstance(data, dict):
        return {k: _redact_in_place(v, cache, depth - 1) for k, v in data.items()}
    if isinstance(data, list):
        return [_redact_in_place(item, cache, depth - 1) for item in data]
    if isinstance(data, str):
        if data not in cache:
            cache[data] = detect_and_redact(data)
        return cache[data]
    return data

def comprehend_anonymize_batch(runs: list[dict]) -> list[dict]:
    # One shared cache per buffer flush. Identical strings (e.g. the same
    # system prompt repeated across runs) only hit Comprehend once.
    # Note: the same run ID may appear twice — once as a create (with inputs)
    # and once as an update (with outputs).
    cache: dict[str, str] = {}
    for run in runs:
        for field in ("inputs", "outputs"):
            data = run.get(field)
            if isinstance(data, (dict, list)):
                run[field] = _redact_in_place(data, cache)
    return runs

client = Client(
    process_buffered_run_ops=comprehend_anonymize_batch,
    run_ops_buffer_size=1000,        # ~500 traced calls (2 ops each: create + update)
    run_ops_buffer_timeout_ms=3000,  # or after 3 seconds, whichever comes first
)

@traceable(client=client)
def my_llm_call(messages: list) -> dict:
    # ... your LLM call ...
    pass

try:
    my_llm_call([{"role": "user", "content": "My name is Jane Smith, call me at 555-867-5309"}])
finally:
client.flush() # always flush before exitprocess_buffered_run_ops 和 run_ops_buffer_size 必须总是一起设置——只提供其一而不提供另一个会抛出 ValueError。