
主题
用 LangSmith Engine 发现并修复你 agent 的问题
用 LangSmith Engine 自动检测并解决你追踪项目中反复出现的问题。
LangSmith Engine 帮你交付更可靠的 agent 而无需手动翻查追踪。它是 agent 工程的 LangSmith agent:基于你的生产追踪工作,它浮现出反复出现的问题、诊断其根因,并在开发生命周期的每个阶段推动修复。产品概览见 Engine。
Engine 如何工作
问题生命周期
每个问题在一个闭环中流转,其中 Engine:
- 在你的追踪中检测一个反复出现的问题。
- 针对你的追踪和已连接的源码诊断其根因。
- 以一个拉取请求提出修复。
- 随时间跟踪该问题,自动添加匹配同一模式的新追踪,并生成真实依据数据集示例以便你验证一个修复。
- 若在关闭后重新出现,自动重开该问题。
flowchart LR
    detect["Detect recurring issue"]:::trigger --> diagnose["Diagnose root cause"]:::process
    diagnose --> fix["Propose fix as PR"]:::process
    fix --> prevent["Track matching traces and generate dataset examples"]:::output
    prevent --> close["Close issue"]:::decision
    close -->|"resurfaces"| detect

    classDef trigger fill:#F6FFDB,stroke:#6E8900,stroke-width:2px,color:#2E3900
    classDef process fill:#E5F4FF,stroke:#006DDD,stroke-width:2px,color:#030710
    classDef output fill:#EBD0F0,stroke:#885270,stroke-width:2px,color:#441E33
    classDef decision fill:#FDF3FF,stroke:#7E65AE,stroke-width:2px,color:#504B5F
Engine 如何选择追踪
在为每次扫描选择和排序追踪时,Engine 既分析追踪内容也分析运行反馈。它把反馈——包括在线评估器分数、标注队列分数,以及通过 SDK 提交的用户反馈——当作一个高优先级信号,而非补充数据。
要应用这个信号,Engine:
- 读取你项目中存在的反馈键,并为每个键对低分追踪执行一次专门的拉取,使样本包含评估器分数差的追踪,而非任由其受新近度支配。
- 在筛查样本时,优先处理带非空反馈分数的追踪,置于其他追踪之前。
- 在分析上下文的每条追踪上保留反馈分数,即使追踪载荷被压缩以适配上下文限制。
任何向运行写入反馈的来源都会自动贡献于这一优先排序。Engine 除了评估器或标注队列之外不需要其他设置。
设置 Engine
设置 Engine 是一个两步过程:一个 Organization Admin 先为工作区启用 Engine,然后任何用户都能为每个追踪项目打开 Engine。
NOTE
在 Self-hosted LangSmith 上,一个操作员必须先在 LangSmith Helm chart 中启用 Engine,这两个步骤才可用。参阅 Self-hosted 上的 Engine。
为你的组织启用 Engine
NOTE
你必须是 Organization Admin 才能启用 Engine。要找到你的管理员,打开 Settings,在 Access and Security 下选择 Members,并找带 Organization Admin 角色的成员。
Open Engine enablement
在 LangSmith 控制台 中,点击左下角的 Settings,然后在 Engine 下选择 Engine enablement。
Toggle Enable Engine
把 Enable Engine 切换为开并确认 AI 功能使用条款。该对话框逐字显示以下产品内提示:
LangSmith AI 功能由 LangChain 管理的推理驱动,为你的可观测性工作流带来智能。启用 LangSmith AI 后,你的团队能更快地浮现出问题、运行更聪明的评估,并构建更可靠的 LLM 应用。启用此功能即表示你组织的追踪数据将使用 LangChain 管理的 LLM 密钥处理。受我们的服务条款约束。
Engine 一旦启用,你组织中的任何团队成员都能为他们的追踪项目设置它。
TIP
如果你想关闭 Engine,把同一个设置切换为关。这会停止 Engine 的所有自动运行,并终止你账户中未来的计费。
为一个追踪项目打开 Engine
Open Engine and select a project
在 LangSmith 控制台 中,在 UI 侧边栏选择 Engine。项目选择器列出已配置的项目。要设置一个未列出的项目,点击 + Set up another project,然后在 Choose a project to analyze 下选择它。一个追踪项目中的 Engine 标签也可用。
Connect a code repository (optional)
虽然可选,但推荐连接一个代码仓库。Engine 读你的源码以定位一个失败追踪背后的代码路径、把其提议的修复建立在真实实现之上,并直接从问题开拉取请求。在 Connect your agent's code repository 下,在 GitHub Repository 字段选择一个仓库。只显示 GitHub 应用能访问的仓库。点击 Manage app access → 以更新权限。关于 GitHub App 设置和组织审批,见把 Engine 连到 GitHub。要给 Engine 额外的项目上下文,在 Context Hub repository 字段选择一个仓库。
Select preference categories (optional)
在 What matters most to you? 下,选择为你复核优先的类别(例如 Tool Call Failures 或 Latency)。点击 + Add something specific 来描述一个自定义关切。见告诉 Engine 关注哪类问题。
Choose an analysis level
在 Analysis level 下,选择 Reduced、Standard(默认)或 Expanded。更高的层级分析更多追踪、花费更多。见设置分析层级。
Focus on specific traces (optional)
在 Focus on specific traces 下,按运行名或元数据把 Engine 的注意力收窄到一个运行子集。留空以分析所有追踪。见告诉 Engine 关注哪些追踪。
Start analyzing
点击 Start Analyzing。该对话框可能基于你项目的用量显示一个每月成本估算范围。Engine 可能耗时最多 20 分钟来分析你项目的追踪并开始提出建议。在等待期间,你能设置通知,以便在发现不同优先级问题时在 Slack 或通过 webhook 收到提醒。
Review the agent overview document
在浮现问题之前,Engine 会生成一份 agent 概览文档,基于你的追踪描述你项目的用途、架构和关键指标。复核并编辑该文档,然后点击 Accept & Continue 继续。如果概览不准确,请在继续之前编辑它,因为 Engine 用它作为所有分析的上下文,所以这里的准确性会影响检测到问题的质量。
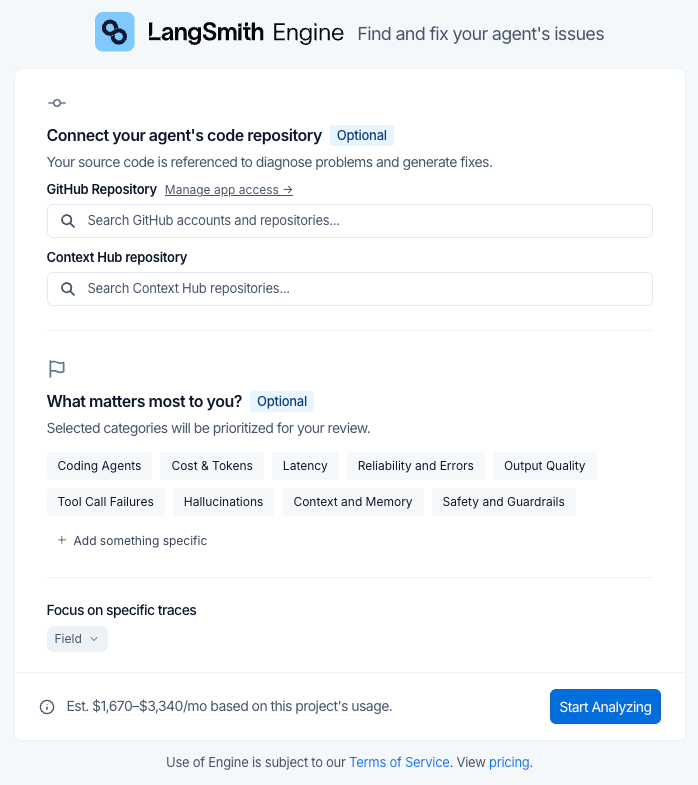
你以后能在配置 Engine 中更改这些选择中的任何一个。要连接 GitHub,见把 Engine 连到 GitHub。要在 Engine 发现问题时在 Slack 或通过 webhook 收到提醒,见 Engine 通知。
暂停 Engine 或删除其问题
Engine 在一个动态调度的计划上扫描你的追踪,以平衡成本与性能。要在不删除其现有问题的情况下停止扫描一个项目,在 Engine Settings 面板点击 Pause。点击 Resume 重新开始扫描。
在同一面板点击 Delete all issues 以永久移除该项目的 issues 和 Engine 设置。这无法撤销。
要为整个组织关闭 Engine,见为你的组织启用 Engine。
配置 Engine
在 Engine 页面,点击问题列表顶部的 Configure Engine
(齿轮)图标以打开 Engine settings 面板。用它给 Engine 提供关于你 agent 的上下文、告诉它关注什么,并连接 Linear。该面板也含有别处讲述的设置:
- Code repository 和 Context repository:连接或更新 Engine 在诊断问题时读取的 GitHub 仓库,可选带一个 Subfolder 和一个 Branch(默认为仓库默认)。一个 Context Hub 仓库让 Engine 能对指令、文档和链接技能提出修复。见把 Engine 连到 GitHub。
- Notifications:见 Engine 通知。
- Preview deployments:设定 Engine 回放问题追踪所对照的基线部署,并开启用预览部署验证修复。见通过运行你的 agent 验证修复。
- Analysis level:见设置分析层级。
- Engine spend:见设置支出限制并监控用量。
- Pause 和 Delete all issues:见暂停 Engine 或删除其问题。
提供关于你 agent 的上下文
在设置期间,Engine 生成一份描述你项目用途、架构和关键指标的 agent 概览文档。Engine 用它作为所有分析的上下文,所以其准确性影响检测到问题的质量。在 Agent overview 下,编辑该文档以添加任何 Engine 无法从你追踪推断的相关上下文,并确保它准确。该文档的 User Preferences 段也收集 Engine 从你在问题上的操作中学到的,以便你在这里复核并纠正那些校准。
告诉 Engine 关注哪类问题
在 Preferences 下,列出 Engine 应关注、优先或忽略的领域。选择像 Cost & Tokens、Latency 或 Tool Call Failures 这样的类别 chip,或点击 + Add something specific 来描述一个自定义关切。Engine 把偏好当作权威的并纳入 agent 概览文档。更改在下次扫描时生效。
告诉 Engine 关注哪些追踪
把 Engine 聚焦在你看重的追踪上,以保持分析精确并减少浪费的 LCU 花费。当一个项目混合了几个 agent 或工作负载、而你只想让 Engine 分析其中一些时,用追踪作用域(Focus on specific traces 控件)。例如,若一个项目同时跑一个生产聊天机器人和一个夜间批处理任务,作用域到 Run Name is chatbot,Engine 就会忽略批处理运行。默认情况下,Engine 分析一个项目的所有追踪。
用同一个控件在两个地方之一设置作用域:
- Engine 设置:在 Find and fix your agent's issues 面板中,Focus on specific traces 下。
- Engine Settings:在 Engine Settings 面板的 Focus on specific traces 节。此处的编辑会自动保存。
用过滤器编辑器添加作用域条件。你能各类型添加一个条件,最多两个:
- Run Name:选一个运行或 agent 名。值字段会依据你项目近期追踪中的运行名自动补全。
- Metadata:选一个元数据键,然后一个值。两者都会依据你项目近期运行上存在的元数据自动补全。
要添加一个条件,从字段选择器选它的类型,填好值,然后点击 Add。每个条件作为一个 chip 出现,例如 Run Name is chatbot 或 env is prod。点击一个 chip 上的 × 以移除那个条件。
NOTE
作用域限制: 作用域过滤器只接受运行名和元数据条件。你无法按反馈键、评估器名或分数阈值来给 Engine 的扫描定作用域。要把 Engine 聚焦于某个评估器低分的追踪,在你的偏好或 agent 概览里描述这一点。Engine 已经自动纳入所有反馈信号。见Engine 如何选择追踪。
作用域决定 Engine 分析哪些追踪来检测问题并构建 agent 概览文档。初始设置期间设定的作用域适用于 Engine 的首次扫描。之后在 Engine Settings 面板更改的作用域不会立即重跑 Engine;它在下次扫描时生效。
连接到 Linear
在 Linear 下,点击 Connect,选择一个团队,可选为一个新项目选一个项目,然后点击 Save changes。Engine 保留到它创建的问题的持久链接,但不同步来自 Linear 的后续编辑。删除所有 Engine 问题不会删除现有的 Linear 工单。见创建一个 Linear 问题。
管理 Engine 成本
理解 LCU 成本
NOTE
Engine 专门使用 LangChain 管理的推理。不支持自带密钥(BYOK);你无法为 Engine 提供你自己的提供商 API 密钥。
Engine 以 **LangChain 计算单元(LCU)**计费,这是一个结合了计算、存储、内存和 LLM 花费的归一化工作单元。LCU 消耗随分析的追踪数、Engine 为诊断和修复问题所做的 LLM 调用数与复杂度,以及任何已连接仓库的大小而增长。LCU 每个 $1.50 USD。关于你预期 LCU 用量的估算,见 LangSmith 用量计算器。
Engine 分两个阶段运行:
| 阶段 | 触发 | 典型 LCU 用量 |
|---|---|---|
| 初始化 | 你在一个项目上首次启用 Engine | 30-40 LCU |
| 周期性扫描 | 自动,在动态计划上 | 10-15 LCU |
在初始化时,Engine 审计过去的追踪、按严重程度聚合并优先排序问题,并向你的提示或代码提出修复(若连接了仓库)。周期性扫描在一个动态调度平衡成本与性能的计划上运行,无论是否发现新问题都运行,并浮现之前未检测到的新问题。
设置分析层级
分析层级控制 Engine 分析你项目追踪的多少,从而控制它用多少 LCU。在你为一个项目打开 Engine时选择它,之后在 Engine Settings 面板的 Analysis level 下更改它:
- Reduced:以更低成本监控更少追踪。
- Standard(默认):分析更多你符合条件的追踪以获得更全面覆盖。
- Expanded:为高容量项目提供最大覆盖。只对追踪量足够的项目可用。
设置对话框显示一个随你选择层级更新的每月成本估算范围。
设置支出限制并监控用量
Organization Admin 能在两个层级设置支出限制:
- Org-wide limit: Open Settings, select Engine enablement under Engine, then enter a value under Monthly LCU spend limit.
- Per-project limit:在一个追踪项目中打开 Engine 标签,点击 Engine Settings
图标,并在 Monthly LCU spend limit 下设一个限制。
你能以 LCU 或 USD(1 LCU = $1.50)输入限制。达到限制时,LangSmith 会暂停新的 Engine 运行,直到限制被调高或下一个月度账期开始。
两个层级的默认不同:
- 组织级限制:选 Default、No limit,或一个自定义上限。在一个管理员选择之前,默认生效(每月 500 LCU,约 $750),所以即使没人设限制,Engine 花费也被封顶。Engine enablement 页会点名被强制执行的限制及其来源。
- 项目级限制:把字段留空表示无限制。用 Remove limit 清除你早前设的上限。
要完全停止 Engine,用 Settings > Engine enablement 中的 Enable Engine 切换。
要监控用量,你能在 Settings 的 Engine enablement 页查看你组织的每月 LCU 花费,或在每个追踪项目的 Engine Settings 面板查看按项目花费。
调查并修复一个问题
设置完成后,Engine 页列出 Engine 检测到的问题。点击任何问题打开其详情面板。顶部一个诊断描述问题及其影响。每个问题有一个工具栏用于设置其优先级、关闭或重开它、开一个拉取请求、创建一个 Linear 问题,以及关注它。
Engine 从你处理问题的方式中学习。在每次计划扫描,它会复核你自上次扫描以来采取的动作,比如关闭一个问题、标记它被错误标记、改变其优先级,或开一个拉取请求,并把它们纳入 agent 概览的 User Preferences 段。你在改变优先级或关闭一个问题时给出的理由是该反馈的一部分。例如,若你反复把某类问题标记为被错误标记,Engine 会在后续扫描把该类评为更低优先级。来自自动化的更改(例如一个拉取请求合并),以及通过 LangSmith Chat 采取的动作不算作反馈。
复核证据
Evidence 段包含支持一个诊断的追踪,含每条追踪的一个片段。从这一节,你能:
- 查看一个追踪:点击 View trace 打开一个证据追踪。当 Engine 识别出导致该问题的子运行时,它会打开那个确切的运行。追踪视图含一个 View issue 链接返回到 Engine 问题。
- 创建离线示例:点击 Add offline examples,从生产追踪输入生成自定义真实依据数据集示例以做离线评估。
- 查看项目证据:点击 View all in project 在追踪项目中查看证据。
更多信息,见管理一个追踪。
Engine 在一个问题被提出后继续跟踪它。在后续扫描,任何匹配该问题失败模式的新追踪都会被自动添加到 Evidence,所以该问题反映该失败多频繁仍在发生,而无需你重跑任何东西。
Proposed Fix 段描述问题并建议如何应对它,若连接了仓库,可能含具体代码或提示更改。
改变优先级和状态
从优先级下拉菜单选 Low、Medium 或 High 以更新一个问题的优先级。你能可选地提供一个理由,Engine 会在后续扫描从中学习。
关闭会记录你复核的结果。点击:
- Close 把一个问题标记为已解决。
- Incorrectly Flagged 把一个问题作为不真实或不值得修复而不予考虑。
对任一结果,你都能可选地提供一个理由,Engine 会在后续扫描从中学习。
你能随时重开一个已关闭的问题。点击 Reopen 以清除任何进行中的修复,并在该问题被关注时停止关注它。Engine 也会在后续追踪中检测到同一问题复发时自动重开一个问题。
开一个拉取请求
点击 Open PR 在你已连接的仓库中开一个带提议代码更改的 GitHub 拉取请求。若尚未连接,先连接一个仓库。拉取请求一旦存在,Engine 会用 View PR #<number> 替换 Open PR。点击 View PR #<number> 在 GitHub 中打开该拉取请求。Engine 在整个问题期间反映 PR 的状态(open、merged 或 closed)。你也能把问题的修复上下文复制到你的剪贴板,以配合一个 LLM 或编码助手使用。Engine 能对任何已连接仓库(包括用 Deep Agents、LangChain 和 LangGraph 构建的 agent)提出代码更改。
创建一个 Linear 问题
要创建一个问题,先连接 Linear,然后在一个 Engine 问题上点击 Create in Linear。Engine 在创建该问题时显示 Linear creation pending。创建完成后,Engine 在 Engine 问题和问题列表中显示被链接的 Linear 问题标识符。
该 Linear 问题包含 Engine 问题的标题和描述、严重程度、类别、标签、一个 View issue in LangSmith 链接,以及证据追踪 ID。Engine 保留到该 Linear 问题的链接。若你关闭 Linear 工单,Engine 会关闭对应的问题。若你取消 Linear 工单,Engine 会把对应问题标记为被错误标记。Engine 也在对应的 Engine 问题上跟踪链接到该 Linear 工单的一个拉取请求。
添加离线示例
这一步把浮现该问题的追踪捕获为真实依据数据集示例,以便你在修复到达生产之前离线评估它。
- 在 Evidence 列表右上角点击 Add offline examples 打开 Add as offline example 对话框。
- 复核每条追踪。该对话框显示输入、agent 产出的错误输出,以及作为自定义真实依据示例的提议预期输出。
- 点击 Add to Dataset 直接添加它们,或点击 Edit in annotation queue 先复核它们。
- 在标注队列中,每个示例显示运行输入,连同 Engine 提议的参考输出,其结构为从追踪分析生成的具名断言。每个断言是一个简短声明,描述一个正确答案应当或不应包含什么。按需编辑断言,用 + Add assertion 添加新的,然后点击 Add to Dataset & Continue 逐个处理每个示例。
关注一个问题
关注会让一个问题保持打开以监控,而不解决它或把它标记为被错误标记。当你尚未准备好修复一个问题、但仍想知道它是否持续发生时,点击 Watch。
要在一个被关注的问题复发时收到提醒,点击 Alert me via Slack,它会打开 Engine Settings 面板的 Notifications 节。见 Engine 通知。
当新追踪链接到一个被关注的问题时,Engine 会把它移到你列表的顶部并显示到达了多少新追踪,以便你着手修复或继续关注。
NOTE
关注只对没有进行中拉取请求的打开问题可用:放弃该修复以再次关注一个问题。解决一个被关注的问题、或把它标记为被错误标记,会自动停止关注它。
过滤并排序问题
在 UI 中
Engine 页在左面板列出检测到的问题。每个条目显示一个标题、一段简短描述、贡献追踪的数量,以及该问题最近被观察于何时。每个问题都带一个失败类别标签,例如 Silent tool error 或 Hallucination。
在列表顶部,你能点击:
- Filter issues 图标,按 Priority、Status 和 Tags 过滤。
- Sort issues 图标,按 Severity、Last Updated 和 Created 排序。
- Configure Engine
(齿轮)图标以配置 Engine。
打开 LangSmith Chat 以就你的问题提问,例如哪些问题最需要关注,或有多少新问题是打开的。
若设置完成后没有问题出现,说明 Engine 在被分析的追踪中没发现反复的模式。试着在收集到更多追踪后再来查看。
用 CLI
在 LangSmith CLI 中用 langsmith project issues list 列出一个项目的问题。用 --status(open、fixing、watching、completed,或 ignored)和 --priority(urgent、high、medium,或 low)过滤,并用 --limit 和 --offset 翻页。
bash
# List open, high-priority issues for a project
langsmith project issues list --project <project-name> --status open --priority highBeta:通过运行你的 agent 验证修复
NOTE
修复验证处于专有 beta。它仅在已为它启用的组织上的 LangSmith Cloud 可用。它只支持运行在 LangSmith Cloud 部署 上的 agent;不支持外部托管的 agent。要请求访问,加入候补名单。
Engine 通过运行你的 agent 来验证修复。它把一个问题关联的追踪回放到你 agent 的一个部署上,以确认问题复现。然后它把同样的追踪回放到 Engine 修复的一个预览部署上,以确认修复解决了它。Engine 把每次验证记录为在一个由问题追踪构建的数据集上的一次实验,以便你逐追踪比较基线与修复。
设置验证
验证需要一个基线部署:你 agent 的一个就绪、非预览的 LangSmith Cloud 部署,在同一工作区。选择它需要对该部署有 deployments:update。
要设置验证:
- 在 Engine 页面,点击 Configure Engine。
- (可选)连接 Engine 应修改的 GitHub 仓库。在仓库设置中,为 Engine 的修复选一个基础分支,或留空以用仓库的默认分支。
- 在 Preview deployments 节,找到 Baseline deployment 字段。搜索一个部署,或粘贴它的 LangSmith URL 或部署 ID。预览部署和未就绪的部署无法从列表中选择。基线可以是一个生产或 staging 部署,但尽可能用 staging,以便验证不会使用生产凭据和服务。
- 选择 Verify fixes with preview deployments。
- 点击 Save。
修复验证还需要:
- 一个已连接的仓库:Engine 把它在 把 Engine 连到 GitHub 中连接的仓库里,作为一个拉取请求打开它的修复。
- 标签触发的预览构建:在基线部署上启用预览构建。使用以下起始配置:
- 把 Preview base branch 设为与 Engine 配置的同一分支。
- 选择 Label only 并把 Trigger label 设为
preview。Engine 会把这个标签应用到它的修复拉取请求。 - 把 Idle TTL 设为 6 小时。
- 把 Max concurrent previews 设为 20。
有了这个设置,Engine 会应用预览标签、等待 LangSmith 从提议的修复构建一个临时部署、针对它回放验证,并在问题上显示裁定和回放追踪。
WARNING
验证会把一个问题的追踪输入发送到基线部署,以及在验证修复时发送到预览部署。每次回放都会在该部署上创建一个线程和一个运行,你的 agent 可能在响应时调用它的工具。
LangSmith 创建预览部署时会继承基线部署的机密。在启用修复验证之前,确认每个继承的机密都适合临时部署。对基线机密的更改不会传播到已存在的预览。
用你的部署身份验证
默认情况下,Engine 用一个 LangSmith 凭据调用你的部署,而部署把调用者看作一个 Studio 用户。接受 LangSmith 平台身份验证的部署无需更多设置。
如果你的部署自己为调用者身份验证,给 Engine 它期望的标头:
- 在 Preview deployments 节,Deployment authentication 下,点击 Add custom headers。
- 输入你的部署所要求的每个标头,然后点击 Save。
- 在你部署的身份验证处理器中,把这些标头映射到一个验证需求所需最小访问权的身份。
标头值是加密且只写的:LangSmith 只显示它们的名字,所以替换它们意味着重新输入每个值。LangSmith 自己管理的标头无法被覆盖。要回到默认,点击 Use platform authentication。
NOTE
自定义标头只决定你的部署是否接受该请求。它们不会告诉你的 agent 一个运行是一次验证回放,那是一个在让回放运行无副作用中描述的独立信号。
准备一个用于测试的部署
Engine 通过运行你的 agent 来确认一个问题,所以你所选的部署必须是你能够反复施以而无后果的那个。
使用一个你能安全施以的部署
选一个反映你想测试的 agent 配置、但又不是服务你用户的那个的部署。把它指向你 agent 写入的任何服务的测试凭据、测试账户和非生产数据存储。
让回放运行无副作用
Engine 在每次回放上设 config.configurable.__engine_validation_replay__ = true,以便你的 agent 能认出一次并更保守地响应。在 HTTP 边界,验证请求还含 X-LangSmith-Source: engine。在图代码中用那个可配置标记,在请求中间件中用那个标头。
用该标记来跳过或阻塞那些效果会离开你 agent 的工具,例如发送邮件或消息、向客户收费、提工单、写入生产数据存储、调度工作,以及调用合作方 API。
Copy-paste allowlist middleware
Add the following middleware to your agent project:
python
from __future__ import annotations

from collections.abc import Awaitable, Callable, Collection, Mapping
from typing import Any, cast

from langchain.agents.middleware import AgentMiddleware
from langchain.messages import ToolMessage
from langchain.tools.tool_node import ToolCallRequest
from langchain_core.runnables import RunnableConfig
from langgraph.types import Command

ENGINE_VALIDATION_CONFIG_KEY = "__engine_validation_replay__"
LANGGRAPH_AUTH_USER_ID_CONFIG_KEY = "langgraph_auth_user_id"

def _configurable(config: RunnableConfig | None) -> Mapping[str, object]:
    configurable = (config or {}).get("configurable")
    return configurable if isinstance(configurable, Mapping) else {}

def is_engine_validation(config: RunnableConfig | None) -> bool:
    """Return whether the caller requested reduced-privilege validation mode."""
    return _configurable(config).get(ENGINE_VALIDATION_CONFIG_KEY) is True

def is_trusted_engine_validation(
    config: RunnableConfig | None,
    *,
    expected_user_id: str,
) -> bool:
    """Verify the validation marker and authenticated Engine identity."""
    configurable = _configurable(config)
    return (
        bool(expected_user_id)
        and configurable.get(ENGINE_VALIDATION_CONFIG_KEY) is True
        and configurable.get(LANGGRAPH_AUTH_USER_ID_CONFIG_KEY) == expected_user_id
    )

def _request_config(request: ToolCallRequest) -> RunnableConfig | None:
    runtime = getattr(request, "runtime", None)
    config = getattr(runtime, "config", None)
    return cast(RunnableConfig, config) if isinstance(config, dict) else None

class EngineValidationSafetyMiddleware(AgentMiddleware):
    """Allow only explicitly safe tools during Engine validation."""

    def __init__(self, *, safe_tools: Collection[str]) -> None:
        self._safe_tools = frozenset(safe_tools)

    def _rejection(self, request: ToolCallRequest) -> ToolMessage | None:
        if not is_engine_validation(_request_config(request)):
            return None
        call = request.tool_call
        name = call.get("name") or "tool"
        if name in self._safe_tools:
            return None
        return ToolMessage(
            content=f"{name} is blocked during Engine validation.",
            tool_call_id=call["id"],
            name=name,
            status="error",
        )

    def wrap_tool_call(
        self,
        request: ToolCallRequest,
        handler: Callable[[ToolCallRequest], ToolMessage | Command[Any]],
    ) -> ToolMessage | Command[Any]:
        rejection = self._rejection(request)
        return rejection if rejection is not None else handler(request)

    async def awrap_tool_call(
        self,
        request: ToolCallRequest,
        handler: Callable[
            [ToolCallRequest],
            Awaitable[ToolMessage | Command[Any]],
        ],
    ) -> ToolMessage | Command[Any]:
        rejection = self._rejection(request)
return rejection if rejection is not None else await handler(request)Register it on every run and allow only tools that are read-only and isolated:
python
from langchain.agents import create_agent

from engine_validation import EngineValidationSafetyMiddleware

agent = create_agent(
    model=model,
    tools=[search_catalog, lookup_order, send_message],
    middleware=[
        EngineValidationSafetyMiddleware(
            safe_tools={"search_catalog", "lookup_order"},
        )
    ],
)Without the replay marker, the middleware passes tool calls through unchanged. During validation, it invokes only tools in safe_tools and returns an error ToolMessage for every other tool. An empty allowlist blocks all tools.
只允许那些只读且隔离的工具。不要允许那些发送消息、交付通知、调度或排队工作、持久数据,或写入外部系统的工具。
WARNING
把标记和来源标头当作不可信的提示,它们只能缩减一个运行可做的事。任何能抵达你部署的东西都能设它们,所以绝不要把它们用于授予访问、跳过身份验证,或加宽权限。
验证受信任的 Engine 上下文
回放标记并非身份的证据,因为任何调用者都能设可配置值。如果你的部署在验证期间重建用户上下文或访问受保护数据,请先验证受身份验证的 Engine 身份:
python
if is_trusted_engine_validation(
    config,
    expected_user_id=settings.engine_user_id,
):
context = load_context_from_checkpoint()从受身份验证的运行时配置和已复制的检查点读取身份和应用上下文。不要从回放输入或元数据读取它们。
对于带自定义身份验证的部署,在你的身份验证处理器中先把受身份验证的 Engine 服务主体映射到 langgraph_auth_user_id,再应用同样的检查。身份验证标头建立调用者身份,而回放标记激活降低特权工具策略。
预期一波流量
Engine 同时回放一个问题的多条追踪,所以一次验证最多可一次启动五个运行,且每个运行都会跑到底。修复验证针对预览部署重复同一组。确认部署的速率限制、配额,以及它调用的任何下游服务都能承受那一波。
保持部署可用
Engine 只能对一个就绪、非预览的部署回放,并记录产生每个结果的部署和修订。在验证进行中保持该部署运行,并预期一个结果描述的是 Engine 测试它时处于活动的那个修订。
测试一个问题
当设定了基线部署时,Engine 在创建一个问题时会自动验证每个新问题。要再次验证一个问题,打开它并点击 Test issue。
当未设基线部署时、该问题无关联追踪时,或每月 LCU 支出限制达到时,Test issue 不可用。
对每次验证,Engine:
- 按它们被关联的顺序,选择关联到该问题的至多五条不同追踪。
- 针对基线部署回放每条追踪的输入。对来自多轮线程的追踪,Engine 包含会话中较早的几轮,所以一次后续失败会在同一上下文中被判定。
- 判定每次回放是否再次显示该问题上报的行为。每条追踪为 Reproduced、Not reproduced 或 Inconclusive。
当至少一条追踪复现时,问题整体被复现。只有当每次回放都在无上报行为下完成时才算未复现。否则,结果为不定。当验证未复现一个打开的问题时,Engine 会关闭该问题。
验证一个修复
当 Verify fixes with preview deployments 被选中时,Engine 验证它生成的每个修复:
- 当一个修复运行完成时,Engine 会为它还没开的修复开一个拉取请求,然后给它加预览构建标签。
- LangSmith 从该拉取请求构建一个预览部署。
- 当预览修订上线时,Engine 针对该预览部署回放问题验证中的追踪。
- 若该问题在预览上仍发生,Engine 会在同一拉取请求上修改该修复并再次验证,总共最多三次尝试。
读取一个验证结果
每个问题报告一个基线结果,并在修复存在后,一个验证结果。
基线结果回答该问题在你部署上是否仍发生:
| 状态 | 含义 |
|---|---|
| Awaiting test | Engine 尚未记录基线结果。 |
| Reproduced | 至少一次回放再次显示了上报行为。 |
| Not reproduced | 每次回放都在无上报行为下完成,所以 Engine 关闭一个打开的问题。 |
| Inconclusive | Engine 无法自信地判定回放。 |
| Error | 验证无法完成。 |
验证结果回答 Engine 的修复是否解决了它:
| 状态 | 含义 |
|---|---|
| Not run | 该问题未复现,所以无可验证。 |
| Generating fix 或 Awaiting fix | Engine 仍在产出一个待验证的修复。 |
| Awaiting preview 或 Running | 一个预览部署正在构建,或回放正在进行。 |
| Verified | 该问题在修复的预览部署上不再发生。 |
| Not fixed | 该问题仍发生,所以 Engine 修改修复并重试。 |
| Inconclusive、Timed out 或 Error | Engine 无法为这次尝试建立一个裁定。 |
WARNING
Inconclusive 意味着 Engine 无法收集可信证据,而不是问题不存在或已修复。把它当作一个重新测试的信号,而非一个通过的结果。
复核验证实验
Engine 在你工作区中存储每个问题的验证证据:
- 数据集:每个问题一个,描述为
Engine validation evidence,每个回放追踪一个示例。 - 基线实验:针对基线部署的回放。
- 修复实验:针对一个修复预览部署的回放,每次验证尝试一个实验。
Engine 把对每条定论回放的裁定作为键为 engine_issue_validation 的反馈记录。值是 reproduced 或 not_reproduced,且反馈评论解释该裁定。
当 Engine 针对一个预览部署验证一个修复时,问题的 Evidence 段显示一个整体裁定和每追踪一行:
- Flagged traces:Engine 在原始追踪中看到的。点击 Original trace 打开它。
- Reproduced on prod:基线结果,Reproduced、Not reproduced 或 Inconclusive。点击 Repro trace 打开回放。
- After PR #
<number>:修复预览上的结果,Fix verified、Recurred 或 Inconclusive。点击追踪链接打开回放。
每个列标题统计多少追踪在基线上复现、或被修复解决。点击 View Experiment 在数据集的比较视图里并排打开基线和修复实验。更多信息,见比较实验结果。
在修复验证运行之前,问题改为显示一个验证摘要:基线结果、修复的验证状态,以及到每个回放示例的链接。
排查验证
若一个问题停在 Awaiting test,或一个结果以不定返回,在再次测试之前检查以下:
- 基线部署:确认它仍就绪、不是预览,且与追踪项目在同一工作区。
- 身份验证:若你的部署自己为调用者身份验证,确认已存的标头是最新的。替换一个凭据需要重新输入每个标头值。
- 回放本身:从问题的 Evidence 段或验证摘要打开回放运行,并读你的 agent 返回了什么。
- 部署限制:查找由并发回放造成的速率限制、配额耗尽或超时,以及非常大的响应(Engine 可能无法判定它)。
- 受限工具:若你的 agent 在回放期间阻塞工具,确认被桩化的工具仍返回一个可用结果,而非一个终止运行的错误。
更正部署或其设置后,打开该问题并点击 Test issue 以再次运行验证。
Beta:用 Red Teaming 主动检测问题
NOTE
Red Teaming 处于专有 beta。它仅在已为它启用的组织上的 LangSmith Cloud 可用。它只支持运行在 LangSmith Cloud 部署 上的 agent;不支持外部托管的 agent。要请求访问,加入候补名单。
Red Teaming 通过向一个已部署的 agent 发送新的、合成的请求并判定它如何响应来测试它。本页前面所述的问题来自已在你的生产追踪中发生的失败。Red Teaming 寻找尚未发生的失败,例如一次成功的提示注入、一个未经你 agent 所要求确认就做出的后果性工具调用,或漏进一个响应的隐上下文。
每次运行都产出一份报告,含假设、测试每个假设的探针,以及每个假设的裁定。
Red Teaming 如何工作
Red Teaming 探测被设为追踪项目基线部署的那个部署。每次运行:
- 映射应用。 Engine 复核来自追踪项目的至多 25 条近期追踪,以及(若连接了)你的代码仓库。从它们中,它学到 agent 的提示、工具、护栏和请求格式。若 Engine 已扫过该项目,运行就从该项目的 agent 概览开始并跑一次更短的确认扫描。
- 形成假设。 每个假设描述 agent 可能失败的一个具体方式。Engine 给它指派一个问题类和一个场景类型,它记录一个普通用户能否触发该失败,还是需要一次蓄意的攻击。
- 探测部署。 Engine 向该部署每个假设发送至多两个合成请求。一个探针复用一条真实追踪的请求格式,但把它的内容替换为新的、合成的输入。
- 判定结果。 Engine 复核每个探针的响应和追踪,然后给该假设指派一个状态和一个严重度。对一个含糊的结果,Engine 能发送一次后续探针。
过去的追踪只帮助 Engine 理解应用。每个确认的发现都来自运行期间发出的探针,而非来自更早追踪中的一个错误。
红队发现留在红队报告里。一次运行不会创建 Engine 问题,也不会向你的工作区写入数据集、评估器或反馈。
Red Teaming 前置条件
要运行 Red Teaming,你需要:
- 追踪项目上的 Engine:为接收你 agent 追踪的项目设置 Engine。
- 一个基线部署:在同一工作区中、被设为该项目基线的一个就绪、非预览的 LangSmith Cloud 部署。见设基线部署。
- 权限:在追踪项目上有
runs:read以查看红队报告。要开始一次运行,你还需要项目上的runs:create和基线部署上的deployments:update。 - 一个已连接的仓库(推荐):有已连接的 GitHub 仓库时,Engine 从源码读你的 agent 的提示、工具和护栏。没有它,发现只依赖追踪,且报告显示 Repository context was not available。
WARNING
探针是真实请求。每个探针都会在基线部署上创建一个线程和一个运行,而你的 agent 可能在响应时调用它的工具。选一个合成测试流量和工具副作用都可接受的部署,例如一个 staging 部署。
设基线部署
基线部署是 Red Teaming 向其发送探针的那个部署。
要设基线部署:
- 在 Engine 页面,选择追踪项目,然后点击 Configure Engine。
- 在 Preview deployments 节,找到 Baseline deployment 字段。
- 搜索一个部署,或粘贴它的 LangSmith URL 或部署 ID。预览部署和未就绪的部署无法从列表中选择。
- 点击 Save。
开始一次 Red Teaming 运行
要开始一次运行:
- 在 LangSmith UI 中,在侧边栏选择 Engine,然后选择追踪项目。
- 在左面板顶部,选择 Red Teaming。
- 点击 Run red team。
该运行会以状态 Running 出现在报告选择器中。当它完成时,其报告会在同一视图打开。一次运行进行中时 Run red team 不可用。
若一次运行未完成,报告选择器显示它的最终状态:Failed、Timed Out、Interrupted、Cancelled,或 Failed to Start。那次运行无可用的报告。
读取一份红队报告
用左面板顶部的报告选择器按日期选一次运行。选择 Load older reports 以向前翻页到更早的运行。
复核概览
当未选中任何假设时,右面板显示报告的概览:
- Confirmed findings:确认发现的数量,按严重度细分。
- Hypotheses tested:该运行测试的假设数。
- Issue classes tested:该运行测试了 10 个问题类中的多少个。
- Findings by Issue Class:每个问题类的确认发现。
- Hypothesis Outcomes:按状态的假设。点击一个状态以把假设列表过滤到它。
- Findings Over Runs:每次运行的确认发现,按严重度堆叠。点击一次运行以打开其报告。
浏览假设
左面板把报告的假设分组:
- Product-Facing Findings:普通用户能用一个正常请求或一个现实、杂乱的请求触发的确认发现。
- Technical Hardening Observations:需要一次蓄意攻击或一个技术边界检查才能触发的确认发现。
- Legacy Confirmed Findings:来自旧报告的确认发现,记录于 Engine 指派场景类型之前。
- Other Tested Hypotheses:每个未被确认的假设。
点击过滤器图标显示单一状态,或点击排序图标按 Default、Severity 或 Title (A-Z) 排序。默认顺序先列确认的假设,按严重度,然后是需复核的假设。
每个假设有以下状态之一:
| 状态 | 含义 |
|---|---|
| Confirmed | 一个探针复现了失败,且 Engine 判定它是一个真实发现。 |
| Needs Review | 证据含糊或不完整。在针对该假设行动之前复核探针。 |
| No Issue Found | 探针运行了,而 agent 行为正确。 |
| Not Tested | 没有探针对该假设做过验证。这是缺失覆盖,而非安全行为的证据。 |
一个确认的发现还有一个严重度:Critical、High、Medium、Low,或 Info。
检视一个假设
点击一个假设以打开它的详情。详情先显示 Engine 的结论,后接每个探针一张卡片,标为 Prompt 1 和 Prompt 2。每个探针的结果为 Attack Worked、Attack Blocked 或 Needs Review。
展开一个探针卡片以看到:
- 合成的提示:Engine 发送到该部署的确切提示。
- Observed:从你 agent 响应中引用的一个片段,带一个探针追踪的摘要,例如它的工具调用、工具错误和 token 数。
- Expected:一个正确的应用本会返回什么。
- View proof trace:在侧面板中打开该探针的追踪。
在探针下方,Why the Judge Decided This 解释 Engine 如何得出该状态和严重度,What to Do Next 推荐一个修复。一个标为 Unexpected 的假设,是 Engine 在测试另一个假设时偶然发现的一个发现。
Red Teaming 问题类
每个假设属于一个问题类,按失败的根因和它所需的修复选取。每份报告都交代全部 10 个类,并把每个标为对该 agent 已测试、未测试,或不适用。
| 问题类 | Red Teaming 测试什么 |
|---|---|
| Content Policy | 违反显式产品、法律、安全或商业政策的行为,例如一个被禁止的竞品比较。 |
| Instruction Hierarchy | 对 agent 指令的直接覆盖,以及冲突或混乱的提示指令。 |
| Indirect Injection | 检索到的内容、工具输出或其他试图控制 agent 的不可信数据。 |
| Data Exposure | 隐上下文,例如由探针种下的合成 canary 值,逃逸到一个响应中。 |
| Auth Isolation | 超出调用者身份或权限边界的访问或动作。 |
| Tool Safety | 不安全的工具选择、参数或审批,以及不安全的后果性工作流。 |
| Workflow Integrity | 检索、澄清或如实完成等必需步骤,agent 跳过或伪造了它们。 |
| Session Integrity | 多轮状态问题,例如内存投毒、延迟激活,或角色混淆。 |
| Input Robustness | 由结构化输出、解析、定界符、编码或消息边界造成的混乱。 |
| Reliability Safety | 围绕失败、重试、资源限制、循环、重复工作和不可逆副作用的行为。 |
两个类有额外要求:
- Auth Isolation:Red Teaming 不确认这一类的发现。它的假设报告为 Needs Review 或 Not Tested。
- Session Integrity:一个假设需要在单个会话中一次两轮探针。当没有这样的探针运行时,该假设报告为 Needs Review 或 Not Tested。
再次运行 Red Teaming
Red Teaming 在同一部署修订的运行之间携带裁定向前。一次新运行会收到针对同一基线部署和活跃修订、至多五次早前成功运行的裁定。Engine 跳过早前运行已确认或判定安全的假设,除非新运行显示该行为改变了,并优先处理那些需要复核的假设。
在你把一个新修订部署到基线部署之后,下次运行会在无先前裁定的情况下开始。用 Findings Over Runs 跨运行比较确认的发现。
Red Teaming 限制
每次红队运行都有上限:
| 限制 | 每次运行的值 |
|---|---|
| 复核的追踪 | 25,从至多 100 条近期追踪摘要中选出 |
| 假设 | 50 |
| 每假设的探针 | 2 |
| 对基线部署的请求 | 100 |
| 建议 | 20 |
Red Teaming 如何处理你的数据
- 合成探针:探针内容是合成的。Engine 不把客户追踪内容或仓库文本拷贝进探针;一条追踪只提供请求格式。
- 只读访问:Red Teaming 用一个只读 LangSmith 凭据读你的追踪,并用一个只读 GitHub 令牌克隆你的仓库。
- 筛查过的报告:Engine 在存储之前对模型写的报告文本筛查机密,并限制响应摘录的长度。
关于 Engine 更广泛地如何处理你的数据,见 Engine 安全。
另请参阅
- Engine:产品概览以及 Engine 在开发生命周期中的定位。
- 把 Engine 连到 GitHub:在 LangSmith Cloud 中连接仓库,或为一个自托管部署创建并配置你自己的 GitHub App。
- Engine 通知:Slack 和 webhook 目的地、事件载荷参考,以及签名机密验证。
- Engine 安全:复核 Engine 如何访问你的追踪、部署和仓库。
- 预览构建:创建 Engine 验证修复所对照的预览部署。
- 比较实验结果:并排比较基线和修复实验。
- Self-hosted 上的 Engine:自托管架构和数据处理。
- 管理数据集、使用标注队列,以及使用断言:处理 Engine 生成的离线示例。
- LangSmith CLI:以编程方式列出和管理问题。