主题
管理数据集
LangSmith 提供了管理和使用你的数据集的工具。本页描述数据集操作,包括:
- 对数据集进行版本管理以随时间跟踪变更。
- 为评估对数据集进行过滤和拆分。
- 公开地共享数据集。
- 以各种格式导出数据集。
你还将学习如何把过滤后的追踪从实验导出回数据集,以进行进一步的分析和迭代。
TIP
LangSmith Engine 能够从你的生产追踪自动地生成真值数据集示例。
对数据集进行版本管理
在 LangSmith 中,数据集是版本化的。这意味着每当你添加、更新或删除数据集中的示例时,都会创建数据集的一个新版本。
创建数据集的一个新版本
每当你添加、更新或删除数据集中的示例时,你的数据集都会创建一个新的版本。这让你能够随时间跟踪对数据集的变更并理解你的数据集如何演进。
默认情况下,版本由变更的时间戳定义。当你点击数据集某个特定版本(按时间戳)在 Examples 标签中时,你会看到数据集在那一时点的状态。
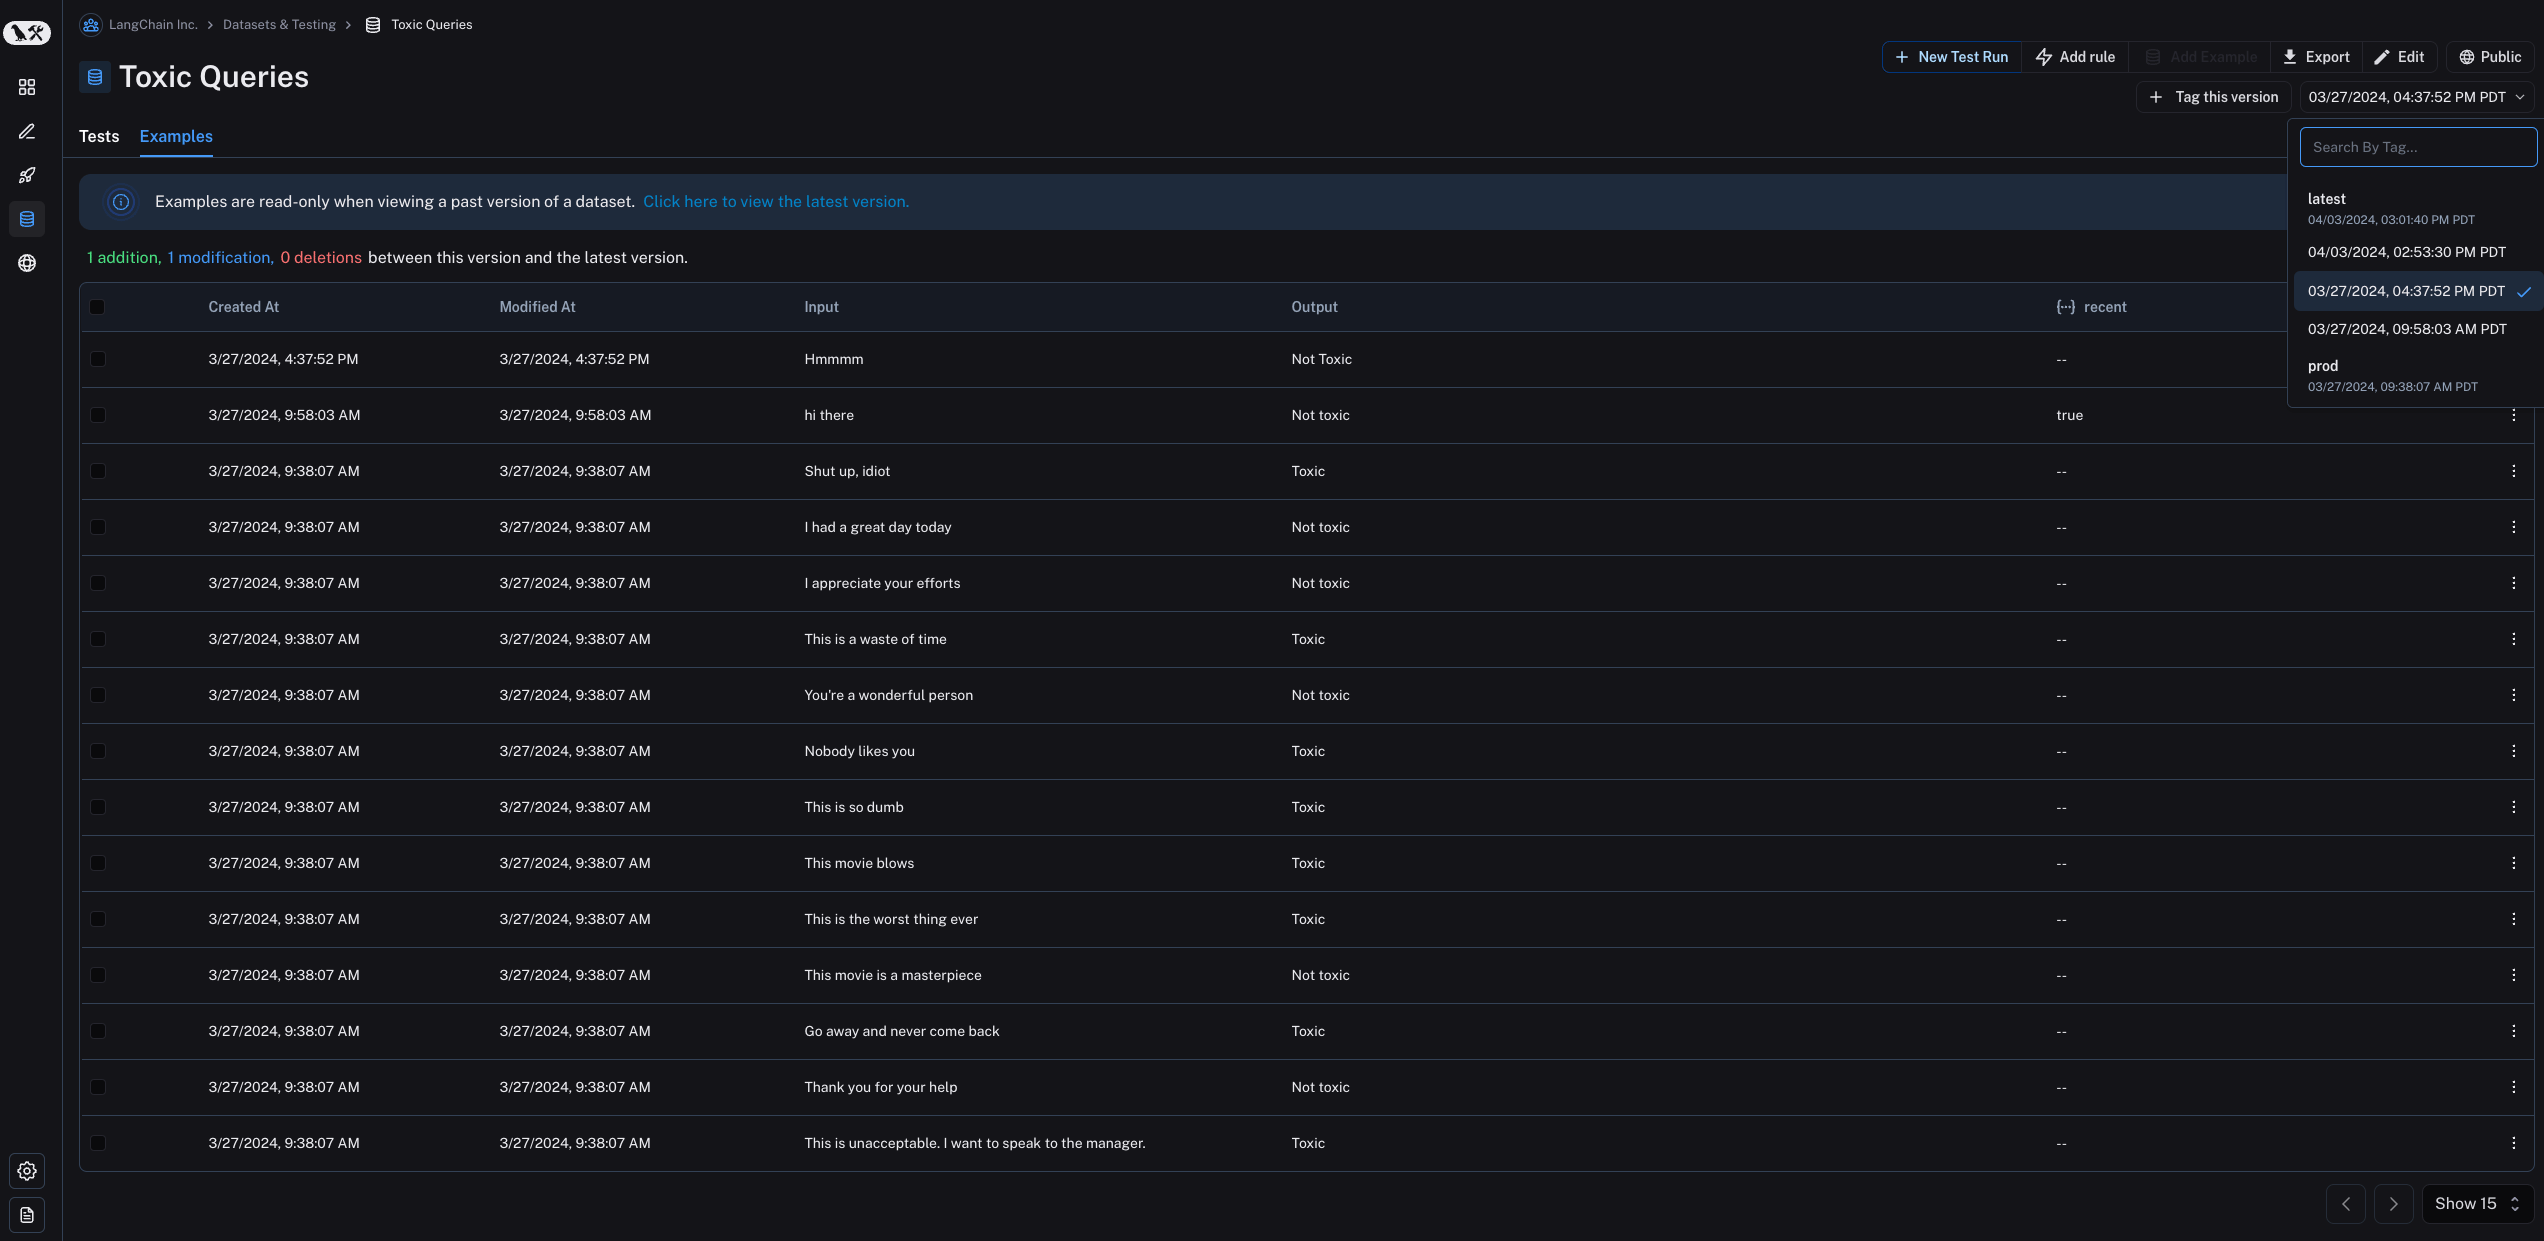
注意,在查看数据集的过去版本时示例是只读的。你还会看到此版本数据集与最新数据集之间发生的操作。
NOTE
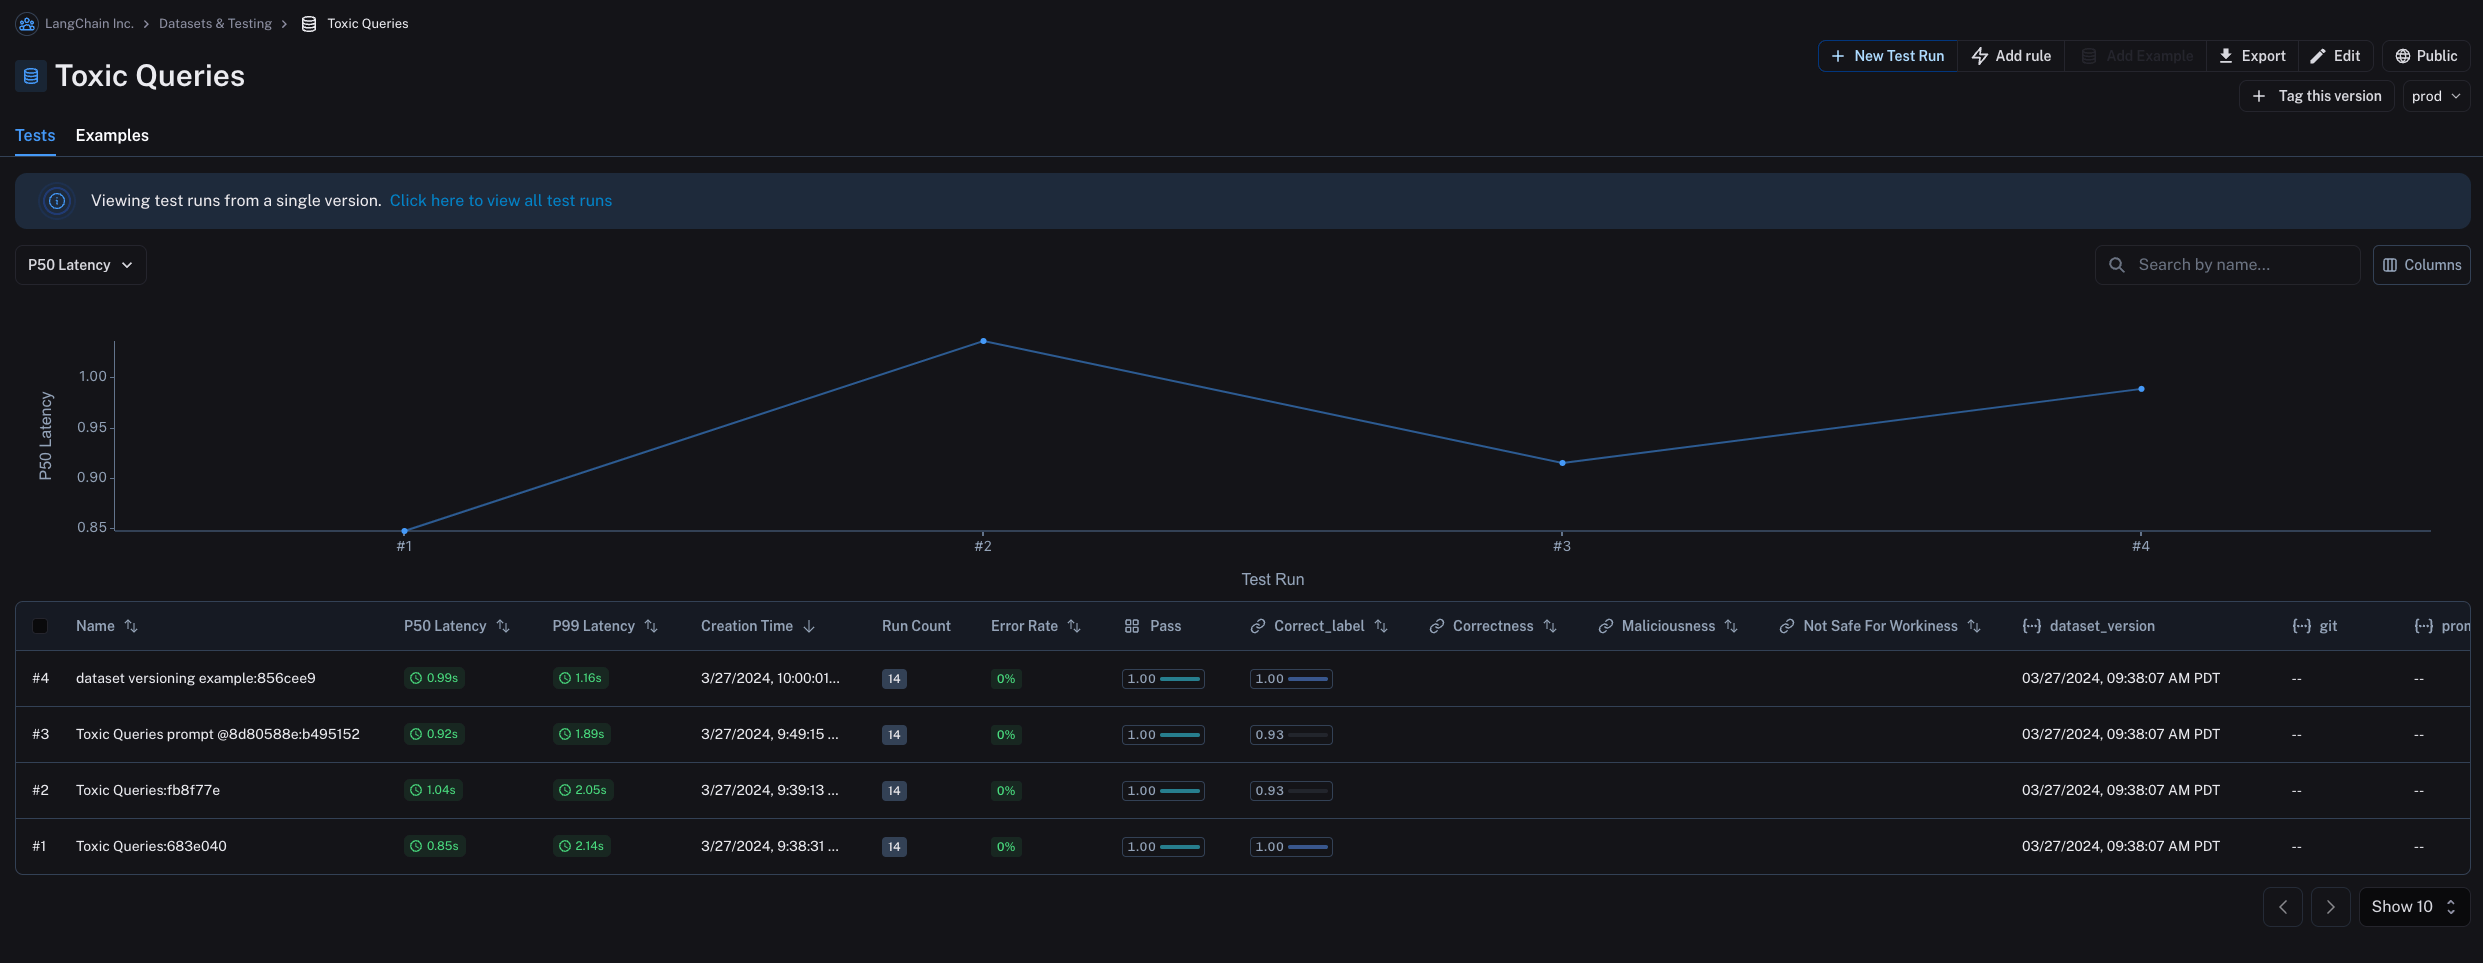
默认情况下,Examples 标签中显示的是数据集的最新版本,而 Tests 标签中显示的是来自所有版本的实验。
在 Tests 标签中,你会找到在不同版本的数据集上运行的测试结果。
为版本打标签
你也可以为你的数据集的版本打标签,赋予它们更易读的名称,这对于标记你数据集历史中的重要时刻很有用。
例如,你可能把数据集的某个版本标记为 "prod",并用它来针对你的 LLM 流水线运行测试。
你可以在 UI 中通过点击 Examples 标签里的 + Tag this version 为你数据集的某个版本打标签。
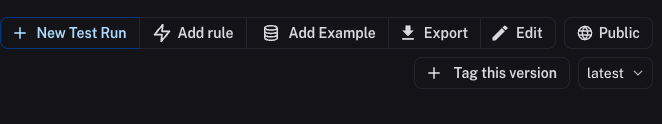
你也可以用 SDK 为数据集的版本打标签。下面是用 Python SDK 为数据集某个版本打标签的示例:
python
from langsmith import Client
from datetime import datetime

client = Client()
initial_time = datetime(2024, 1, 1, 0, 0, 0) # The timestamp of the version you want to tag

# You can tag a specific dataset version with a semantic name, like "prod"
client.update_dataset_tag(
    dataset_name=toxic_dataset_name, as_of=initial_time, tag="prod"
)要在数据集某个打了标签的特定版本上运行评估,参阅在特定的数据集版本上评估一节。
在特定的数据集版本上评估
使用 list_examples
你可以用 evaluate / aevaluate 传入一个示例的可迭代对象,以在数据集的某个特定版本上评估。用 list_examples / listExamples 通过 as_of / asOf 从某个特定的版本标签获取示例,并把它传入 data 参数。
python
from langsmith import Client

ls_client = Client()

# Assumes actual outputs have a 'class' key.
# Assumes example outputs have a 'label' key.
def correct(outputs: dict, reference_outputs: dict) -> bool:
  return outputs["class"] == reference_outputs["label"]

results = ls_client.evaluate(
    lambda inputs: {"class": "Not toxic"},
    # Pass in filtered data here:
    data=ls_client.list_examples(
      dataset_name="Toxic Queries",
      as_of="latest",  # specify version here
    ),
    evaluators=[correct],
)typescript
import { evaluate } from "langsmith/evaluation";

await evaluate((inputs) => labelText(inputs["input"]), {
  data: langsmith.listExamples({
    datasetName: datasetName,
    asOf: "latest",
  }),
  evaluators: [correctLabel],
});java
import com.langchain.smith.models.examples.ExampleListParams;

ExampleListParams listParams = ExampleListParams.builder()
    .datasetId(datasetId)
    .asOf("latest")
var examples = client.examples().list(listParams);在以编程方式创建和管理数据集页上了解更多关于获取数据集视图的内容。
在数据集的拆分 / 过滤视图上评估
在数据集的过滤视图上评估
你可以用 list_examples / listExamples 方法从数据集获取一个要评估的示例子集。
一个常见的工作流是获取具有某个特定元数据键值对的示例。
python
from langsmith import evaluate

results = evaluate(
    lambda inputs: label_text(inputs["text"]),
    data=client.list_examples(dataset_name=dataset_name, metadata={"desired_key": "desired_value"}),
    evaluators=[correct_label],
    experiment_prefix="Toxic Queries",
)typescript
import { evaluate } from "langsmith/evaluation";

await evaluate((inputs) => labelText(inputs["input"]), {
  data: langsmith.listExamples({
    datasetName: datasetName,
    metadata: {"desired_key": "desired_value"},
  }),
  evaluators: [correctLabel],
  experimentPrefix: "Toxic Queries",
});java
import com.langchain.smith.models.examples.ExampleListParams;

ExampleListParams listParams = ExampleListParams.builder()
    .datasetId(datasetId)
    .metadata("{\"desired_key\":\"desired_value\"}")
    .build();
var examples = client.examples().list(listParams);有关更多过滤能力,参阅这篇操作指南。
在数据集的拆分上评估
你可以用 list_examples / listExamples 方法在你数据集的一个或多个拆分上评估。splits 参数接收一个你想评估的拆分列表。
python
from langsmith import evaluate

results = evaluate(
    lambda inputs: label_text(inputs["text"]),
    data=client.list_examples(dataset_name=dataset_name, splits=["test", "training"]),
    evaluators=[correct_label],
    experiment_prefix="Toxic Queries",
)typescript
import { evaluate } from "langsmith/evaluation";

await evaluate((inputs) => labelText(inputs["input"]), {
  data: langsmith.listExamples({
    datasetName: datasetName,
    splits: ["test", "training"],
  }),
  evaluators: [correctLabel],
  experimentPrefix: "Toxic Queries",
});java
import com.langchain.smith.models.examples.ExampleListParams;
import java.util.Arrays;
import java.util.List;

List<String> splits = Arrays.asList("test", "training");

ExampleListParams listParams = ExampleListParams.builder()
    .datasetId(datasetId)
    .splits(splits)
    .build();
var examples = client.examples().list(listParams);有关获取数据集视图的更多详情,参阅获取数据集指南。
共享一个数据集
公开地共享一个数据集
WARNING
公开地共享一个数据集会让数据集示例、实验和相关的运行,以及对该数据集的反馈,对所有拥有该链接的人可访问,即便他们没有 LangSmith 账户。确保你没有分享敏感信息。
此功能仅在 LangSmith 的云托管版本中可用。
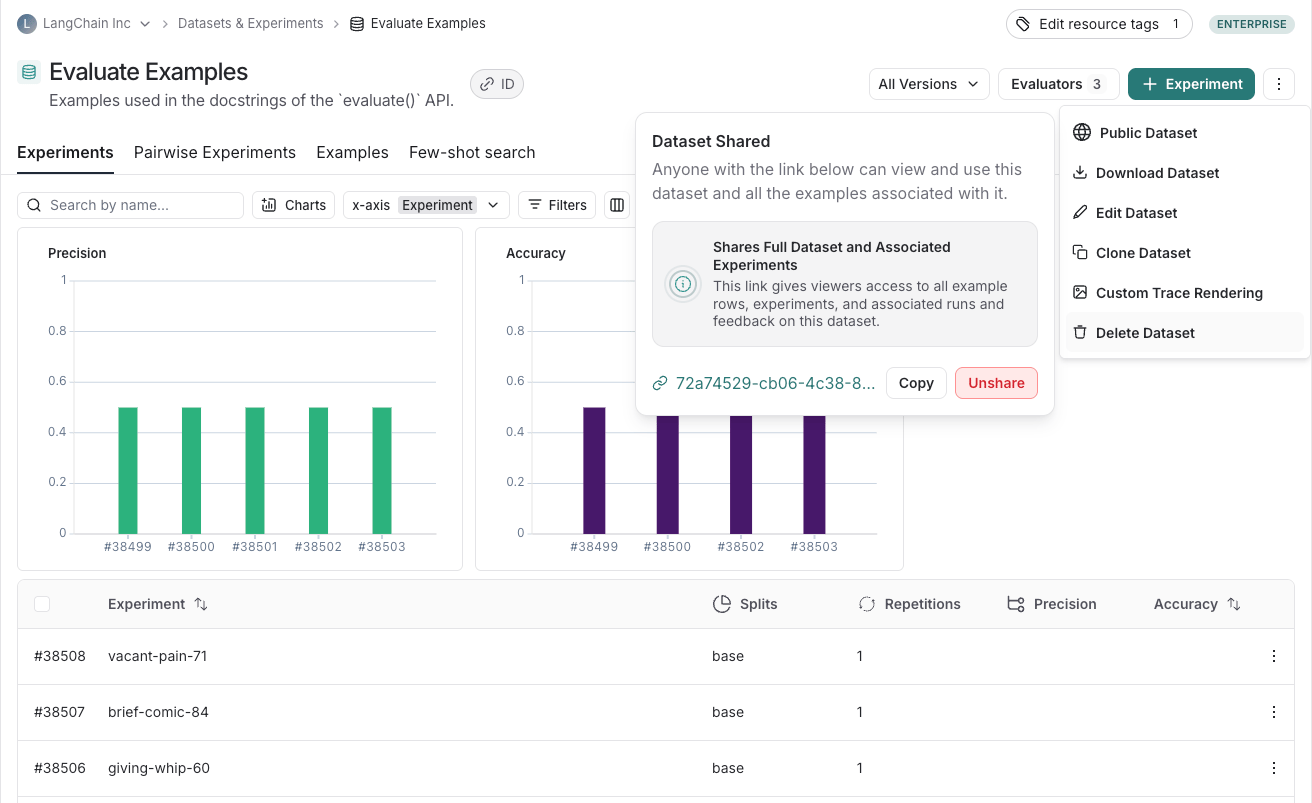
从 Dataset & Experiments 标签,选择一个数据集,点击 ⋮(页面右上角),点击 Share Dataset。这会打开一个对话框,你可以在其中复制该数据集的链接。
取消共享一个数据集
通过在任一公开共享的数据集右上角点击 Public、进而在对话框中点击 Unshare 来点击 Unshare。
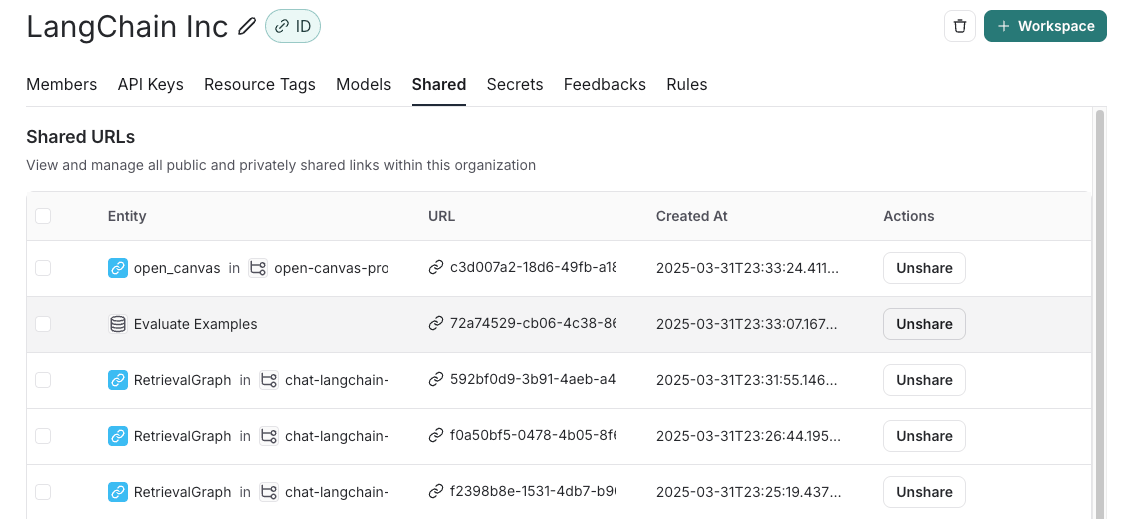
通过点击 Settings -> Shared URLs 或这个链接导航到你组织公开共享数据集的列表,然后点击你想取消共享的数据集旁边的 Unshare。
导出一个数据集
你可以从 LangSmith UI 把你的 LangSmith 数据集导出为 CSV、JSONL 或 OpenAI 的微调格式。要在不导出的情况下对一个轨迹数据集微调一个模型,使用 Smithtune。
从 Dataset & Experiments 标签,选择一个数据集,点击 ⋮(页面右上角),点击 Download Dataset。
把过滤后的追踪从实验导出到数据集
在 LangSmith 中运行一次离线评估后,你可能想把满足某些评估标准的追踪导出到一个数据集。
查看实验追踪
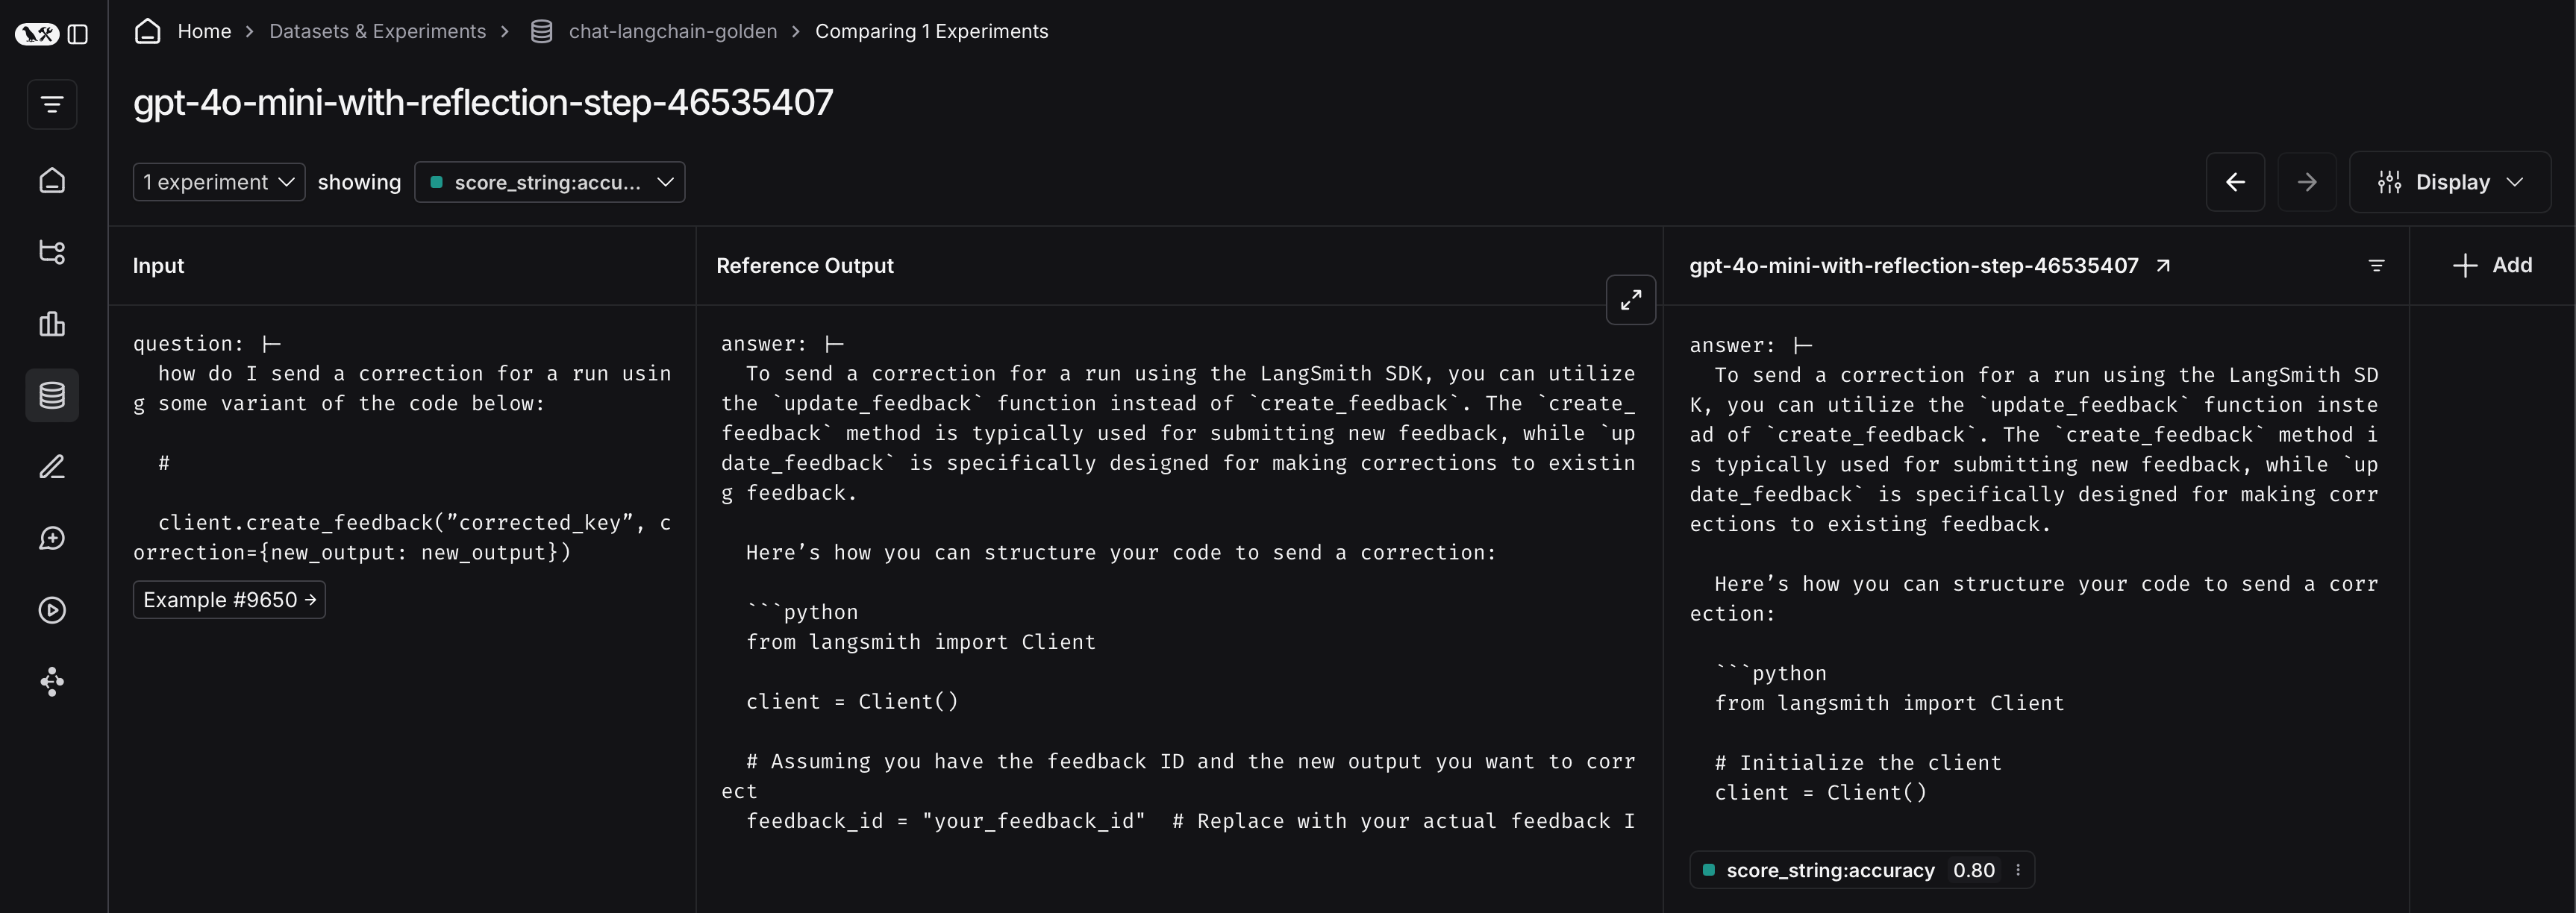
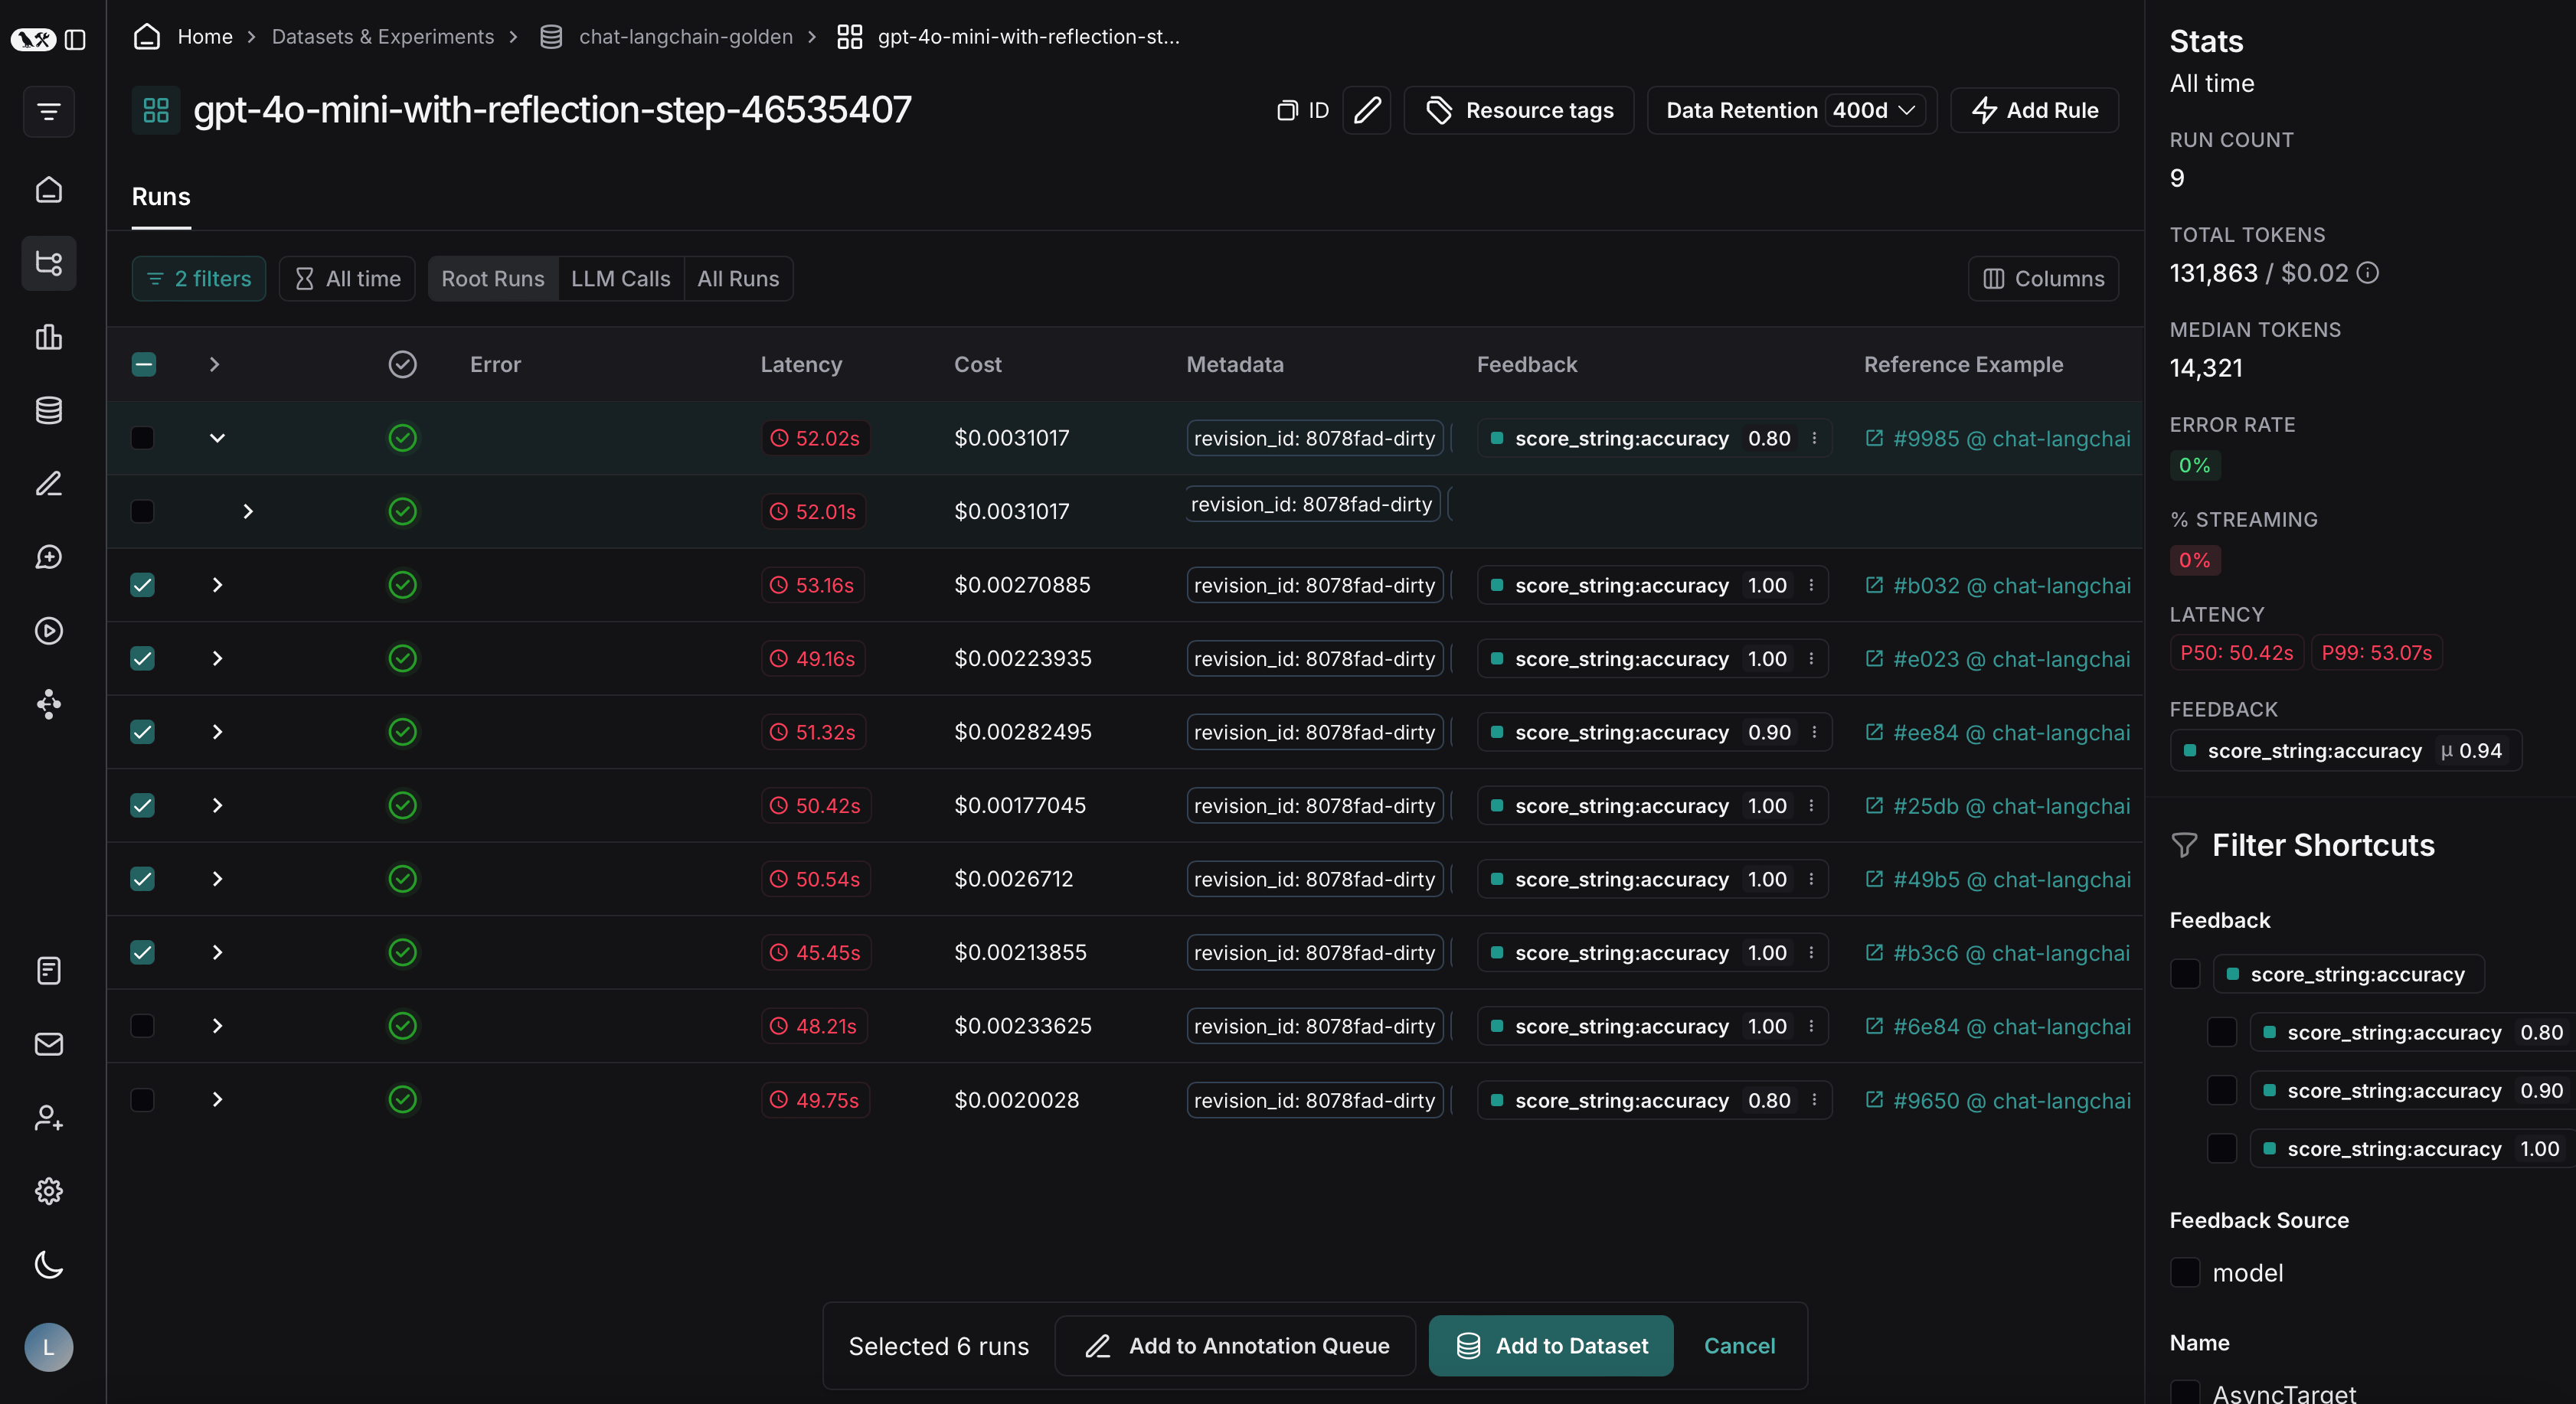
为此,先点击你实验名旁边的 arrow="true" 图标。这会将你导向一个包含由你实验生成的追踪的项目。
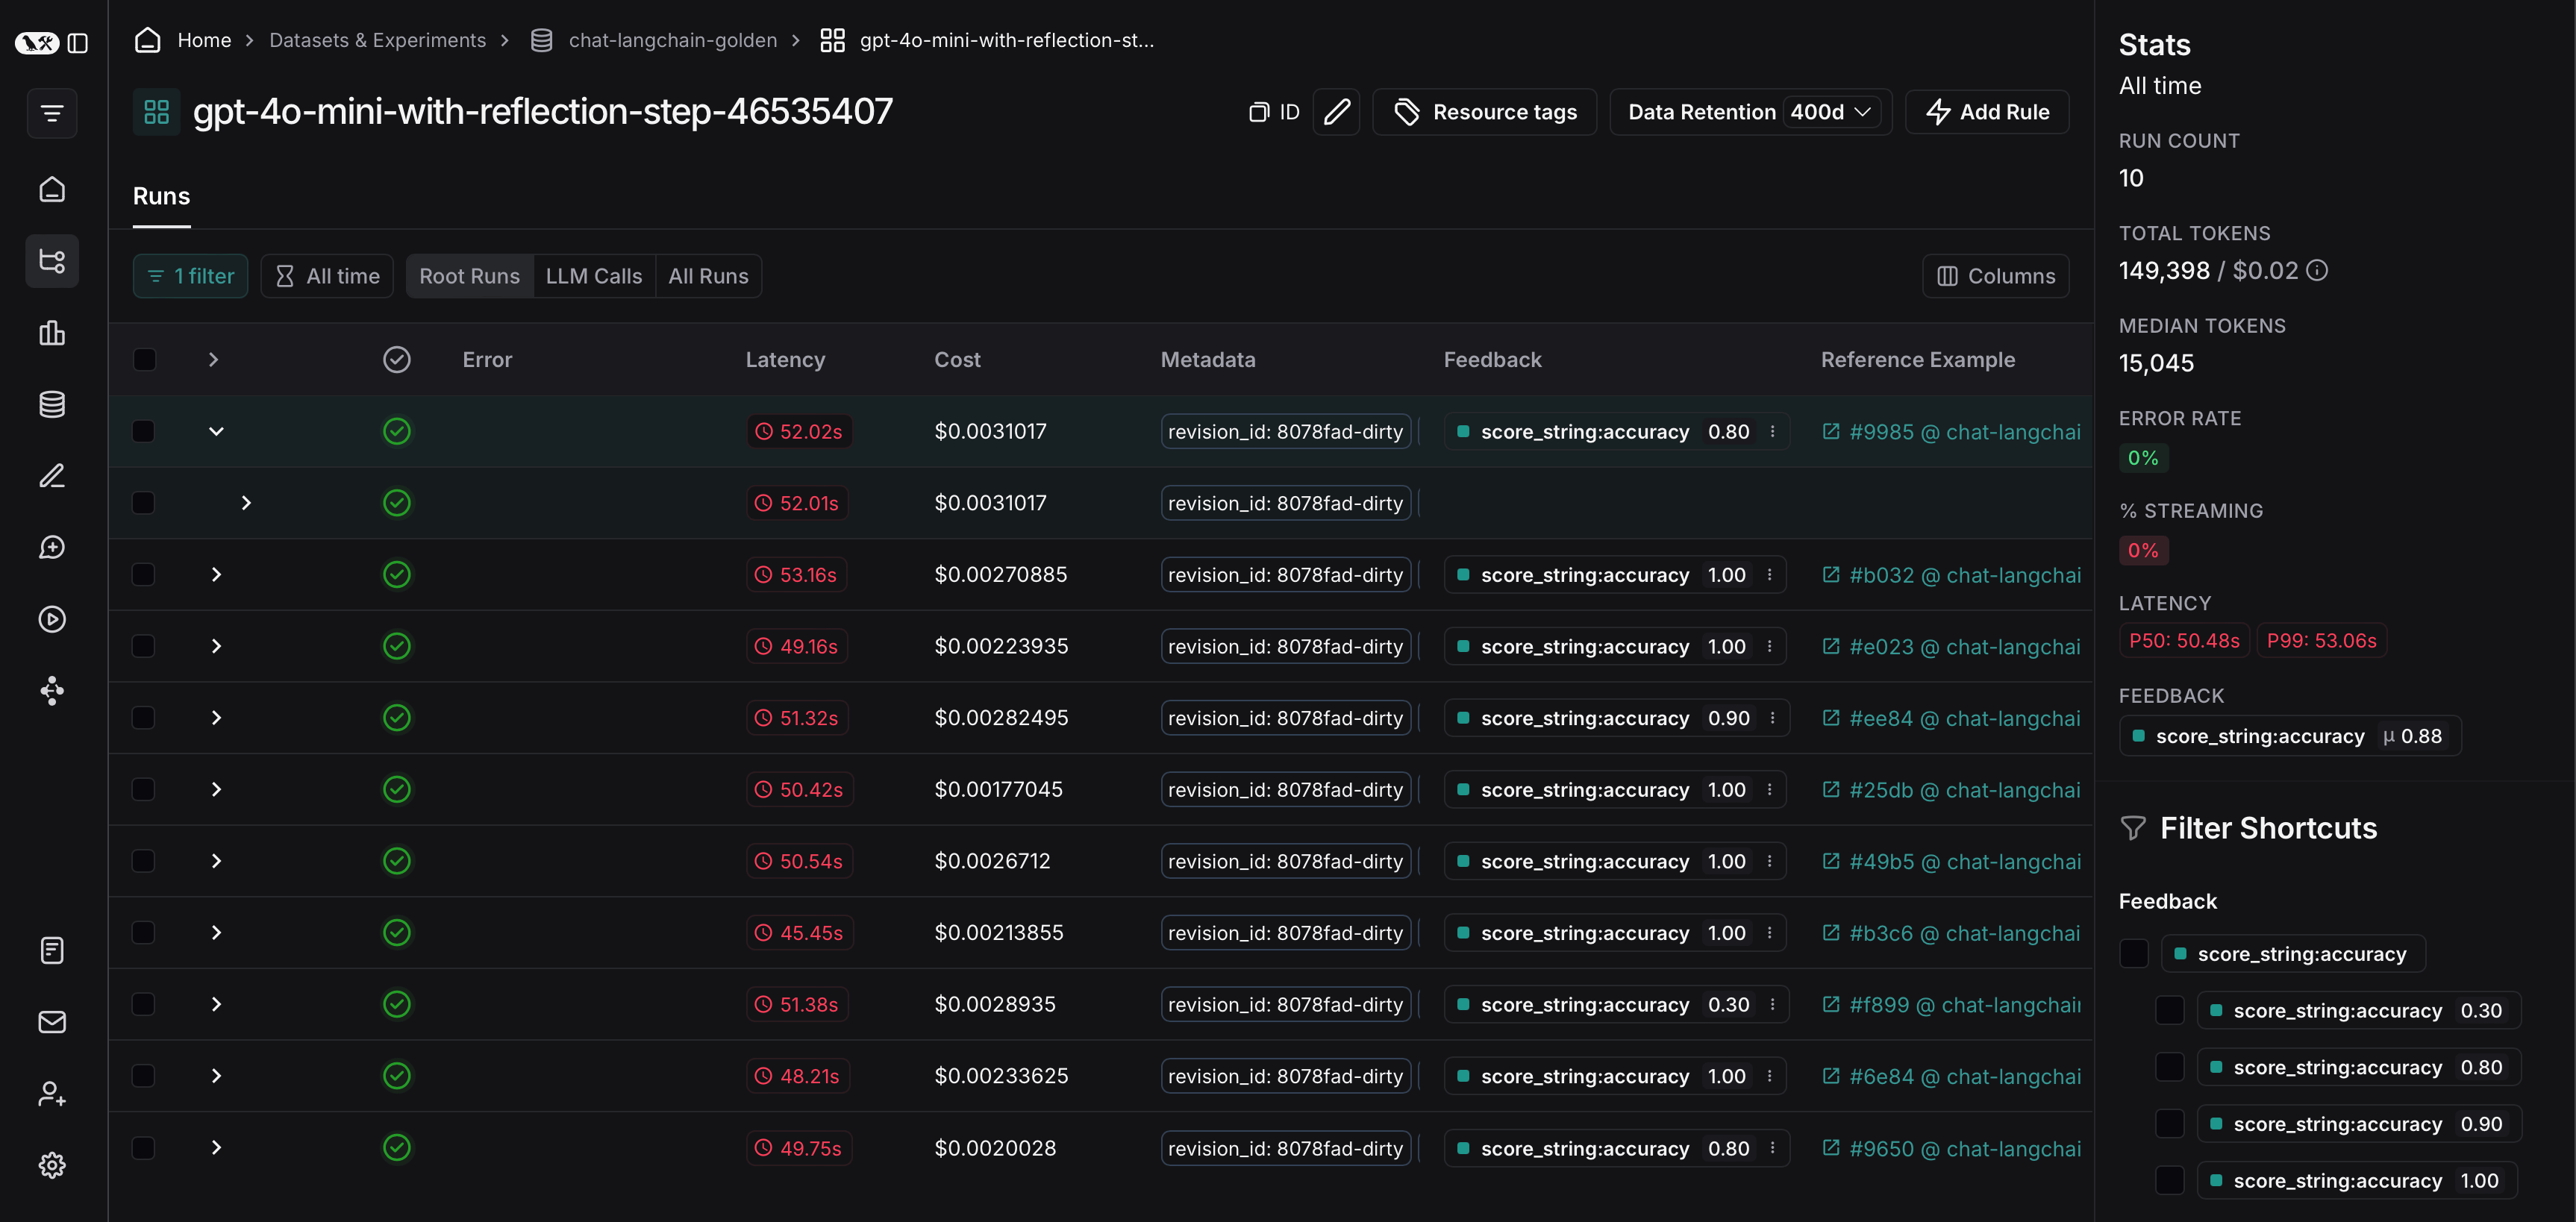
从那里,你可以根据你的评估标准过滤追踪。在这个示例中,我们过滤所有收到大于 0.5 准确性分数的追踪。
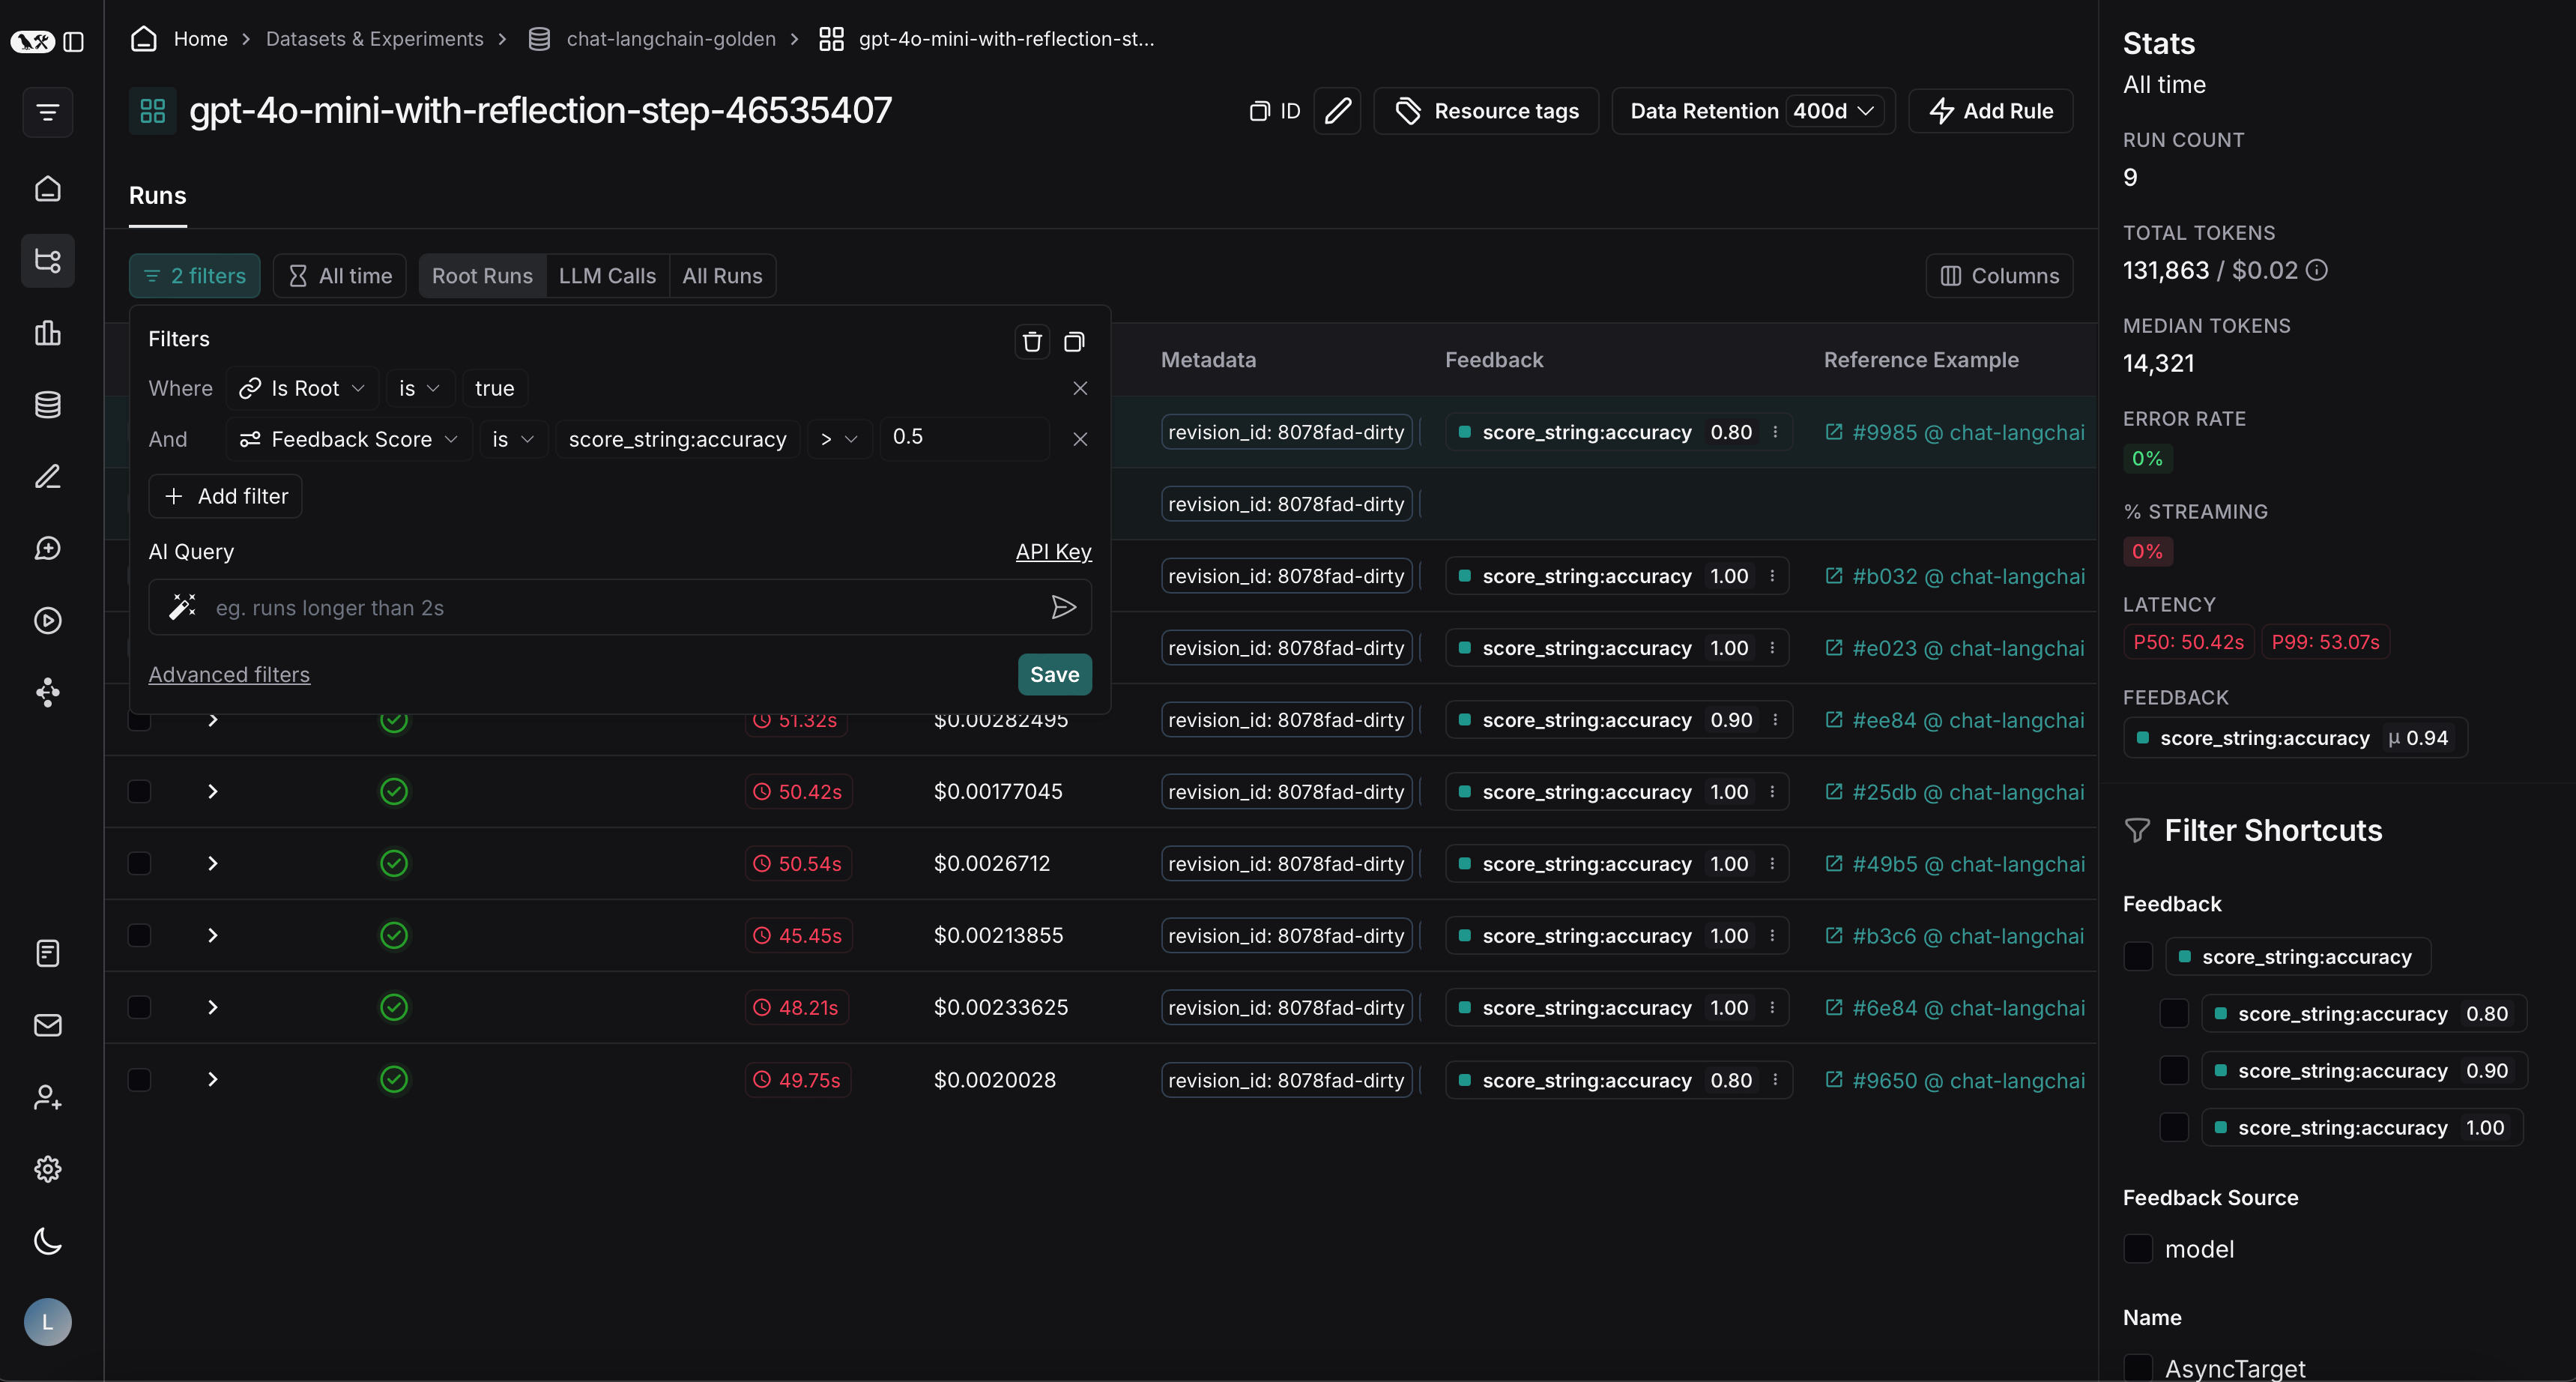
在该项目上应用过滤器之后,我们可以多选要添加到数据集的运行,并点击 Add to Dataset。