
主题
如何用 Vitest/Jest 运行评估
LangSmith 提供了与 Vitest 和 Jest 的集成,让 JavaScript 和 TypeScript 开发者能用熟悉的语法定义他们的数据集并进行评估。
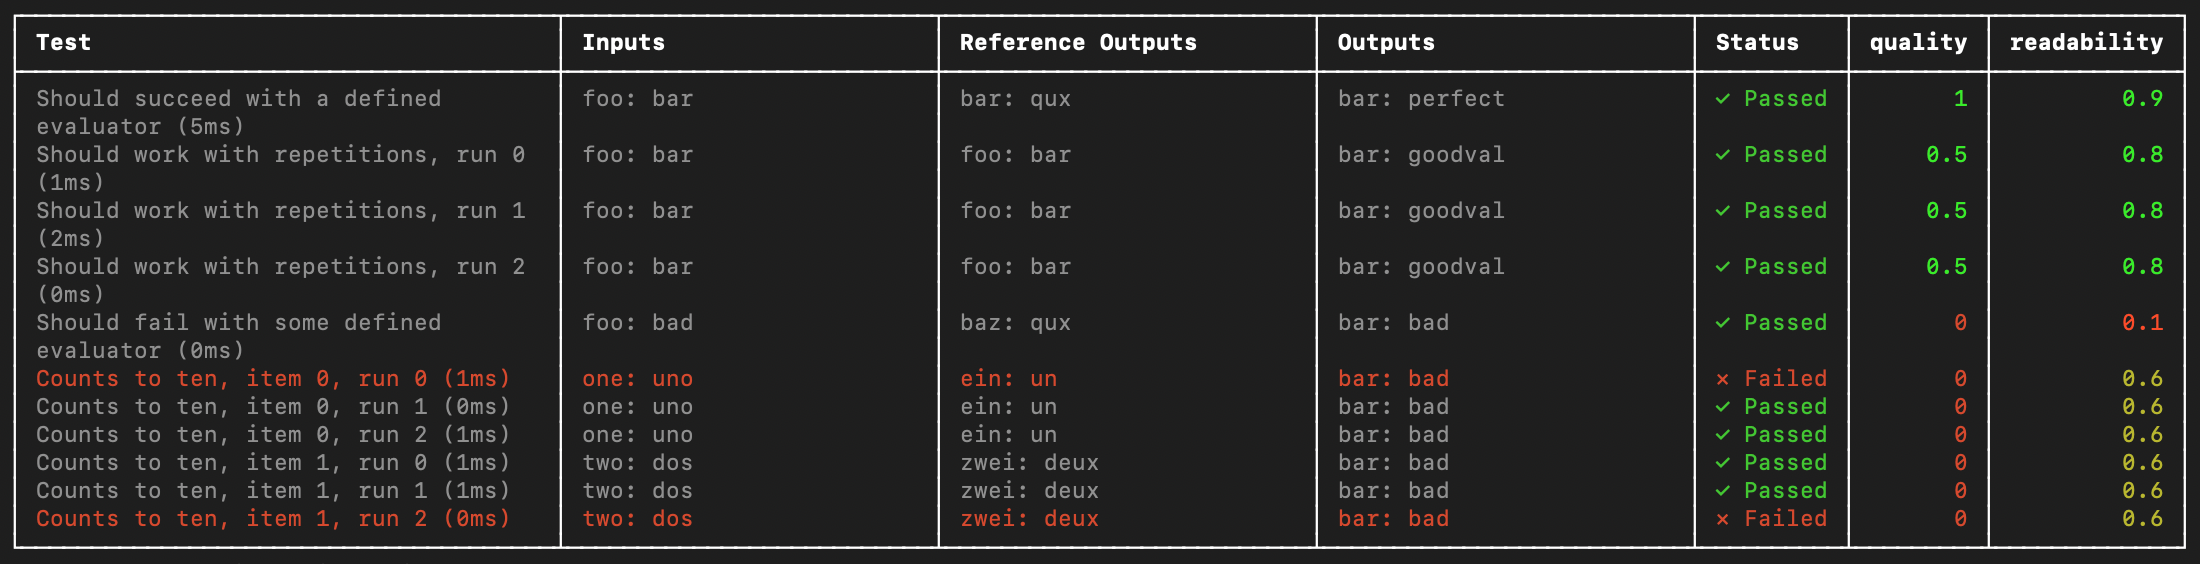
与 evaluate() 评估流程相比,Vitest 或 Jest 测试框架在以下情形很有用:
- 每个示例需要不同的评估逻辑:标准评估流程假定所有数据集示例上应用和评估器的执行是一致的。对于更复杂的系统或更全面的评估,特定的系统子集可能需要用特定的输入类型和指标来评估。这些异构评估作为彼此跟踪的独立测试用例套件来写更简单。
- 你想断言二元期望:在 LangSmith 中跟踪断言,并在本地(例如在 CI 流水线中)抛出断言错误。当既要评估系统输出、又要对其断言基本属性时,测试工具有所帮助。
- 你想利用 mock、watch 模式、本地结果,或 Vitest/Jest 生态的其他特性。
INFO
需要 JS/TS SDK 版本 langsmith>=0.3.1。
INFO
Python SDK 有一个类似的 pytest 集成。
设置
按如下方式设置这些集成。注意,虽然你可以用现有的测试配置文件,把 LangSmith 评估与你的其他单元测试(作为标准的 *.test.ts 文件)并列添加,但下面的示例也会设置一个单独的测试配置文件和命令来运行你的评估。它会假定你以 .eval.ts 结尾命名测试文件。
这确保自定义测试 reporter 和其他 LangSmith 触点不会修改你现有的测试输出。
Vitest
如果你尚未安装,安装所需的开发依赖:
bash
yarn add -D vitest dotenvbash
npm install -D vitest dotenvbash
pnpm add -D vitest dotenv下面的示例也需要 openai(和 langsmith)作为依赖:
bash
yarn add langsmith openaibash
npm install langsmith openaibash
pnpm add langsmith openai然后,用一个 ls.vitest.config.ts 单独的文件,配上下面的基础配置:
typescript
import { defineConfig } from "vitest/config";

export default defineConfig({
  test: {
    include: ["**/*.eval.?(c|m)[jt]s"],
    reporters: ["langsmith/vitest/reporter"],
    setupFiles: ["dotenv/config"],
    testTimeout: 30000,
  },
});include确保只运行你项目中以某种eval.ts变体结尾的文件reporters负责把你的输出漂亮地格式化为上面所示setupFiles在运行你的评估之前运行dotenv以加载环境变量testTimeout为每个测试设置一个全局默认超时。因为 LLM 调用可能很慢,我们从 Vitest 默认值上调了它
WARNING
目前不支持 JSDom 环境。你应当要么从你的配置中省略 "environment" 字段,要么把它设为 "node"。
最后,把以下内容添加到你的 package.json 的 scripts 字段,以用你刚创建的配置运行 Vitest:
json
{
  "name": "YOUR_PROJECT_NAME",
  "scripts": {
    "eval": "vitest run --config ls.vitest.config.ts"
  },
  "dependencies": {
    ...
  },
  "devDependencies": {
    ...
  }
}注意,该脚本在运行评估时会禁用 Vitest 的默认 watch 模式,因为许多评估器可能包含运行较慢的 LLM 调用。
Jest
如果你尚未安装,安装所需的开发依赖:
bash
yarn add -D jest dotenvbash
npm install -D jest dotenvbash
pnpm add -D jest dotenv下面的示例也需要 openai(和 langsmith)作为依赖:
bash
yarn add langsmith openaibash
npm install langsmith openaibash
pnpm add langsmith openaiINFO
以下设置说明针对基础 JS 文件和 CJS。要添加对 TypeScript 和 ESM 的支持,参阅 Jest 的官方文档或使用 Vitest。
然后,创建一个名为 ls.jest.config.cjs 的单独配置文件:
javascript
module.exports = {
  testMatch: ["**/*.eval.?(c|m)[jt]s"],
  reporters: ["langsmith/jest/reporter"],
  setupFiles: ["dotenv/config"],
  testTimeout: 30000,
};testMatch确保只运行你项目中以某种eval.js变体结尾的文件reporters负责把你的输出漂亮地格式化为上面所示setupFiles在运行你的评估之前运行dotenv以加载环境变量testTimeout为每个测试设置一个全局默认超时。因为 LLM 调用可能很慢,我们从 Jest 默认值上调了它
WARNING
目前不支持 JSDom 环境。你应当要么从你的配置中省略 "testEnvironment" 字段,要么把它设为 "node"。
最后,把以下内容添加到你的 package.json 的 scripts 字段,以用你刚创建的配置运行 Jest:
json
{
  "name": "YOUR_PROJECT_NAME",
  "scripts": {
    "eval": "jest --config ls.jest.config.cjs"
  },
  "dependencies": {
    ...
  },
  "devDependencies": {
    ...
  }
}定义并运行评估
你现在可以用熟悉的 Vitest/Jest 语法把评估定义为测试,有几点注意:
- 你应当从
langsmith/jest或langsmith/vitest入口点导入describe和test。 - 你必须把测试用例包裹在一个
describe块中。 - 在声明测试时,签名略有不同——有一个额外的参数,含示例输入和预期输出。
创建一个名为 sql.eval.ts(如果你用不带 TypeScript 的 Jest,则 sql.eval.js)的文件,把这段代码粘贴进去,试一试:
typescript
import * as ls from "langsmith/vitest";
import { expect } from "vitest";
// import * as ls from "langsmith/jest";
// import { expect } from "@jest/globals";
import OpenAI from "openai";
import { traceable } from "langsmith/traceable";
import { wrapOpenAI } from "langsmith/wrappers/openai";

// Add "openai" as a dependency and set OPENAI_API_KEY as an environment variable
const tracedClient = wrapOpenAI(new OpenAI());

const generateSql = traceable(
  async (userQuery: string) => {
    const result = await tracedClient.chat.completions.create({
      model: "gpt-5.4-mini",
      messages: [
        {
          role: "system",
          content:
            "Convert the user query to a SQL query. Do not wrap in any markdown tags.",
        },
        {
          role: "user",
          content: userQuery,
        },
      ],
    });
    return result.choices[0].message.content;
  },
  { name: "generate_sql" }
);

ls.describe("generate sql demo", () => {
  ls.test(
    "generates select all",
    {
      inputs: { userQuery: "Get all users from the customers table" },
      referenceOutputs: { sql: "SELECT * FROM customers;" },
    },
    async ({ inputs, referenceOutputs }) => {
      const sql = await generateSql(inputs.userQuery);
      ls.logOutputs({ sql }); // <-- Log run outputs, optional
      expect(sql).toEqual(referenceOutputs?.sql); // <-- Assertion result logged under 'pass' feedback key
    }
  );
});你可以把每个 ls.test 用例看作对应一个数据集示例,而 ls.describe() 看作定义一个 LangSmith 数据集。如果你在运行测试套件时设置了 LangSmith 追踪环境变量,SDK 会做以下事情:
- 如果不存在,就在 LangSmith 中创建一个与传给
ls.describe()的名字同名的数据集。 - 为每个传给测试用例的输入和预期输出,在数据集中创建一个示例(若尚无匹配的话)。
- 创建一个新实验,为每个测试用例有一条结果。
- 在每个测试用例的
pass反馈键下收集通过/失败率。
当你运行这个测试时,它会有一个基于测试用例通过/失败、默认的 pass 布尔反馈键。它还会跟踪你用 ls.logOutputs() 记录、或从测试函数返回的任何输出,作为该实验来自你应用的"actual"结果值。
如果你还没有 .env 文件,创建一个,含你的 OPENAI_API_KEY 和 LangSmith 凭据:
bash
OPENAI_API_KEY="YOUR_KEY_HERE"
LANGSMITH_API_KEY="YOUR_LANGSMITH_KEY"
LANGSMITH_TRACING="true"现在用上一步我们设置的 eval 脚本来运行测试:
bash
yarn run evalbash
npm run evalbash
pnpm run eval你声明的测试应当就会运行了!
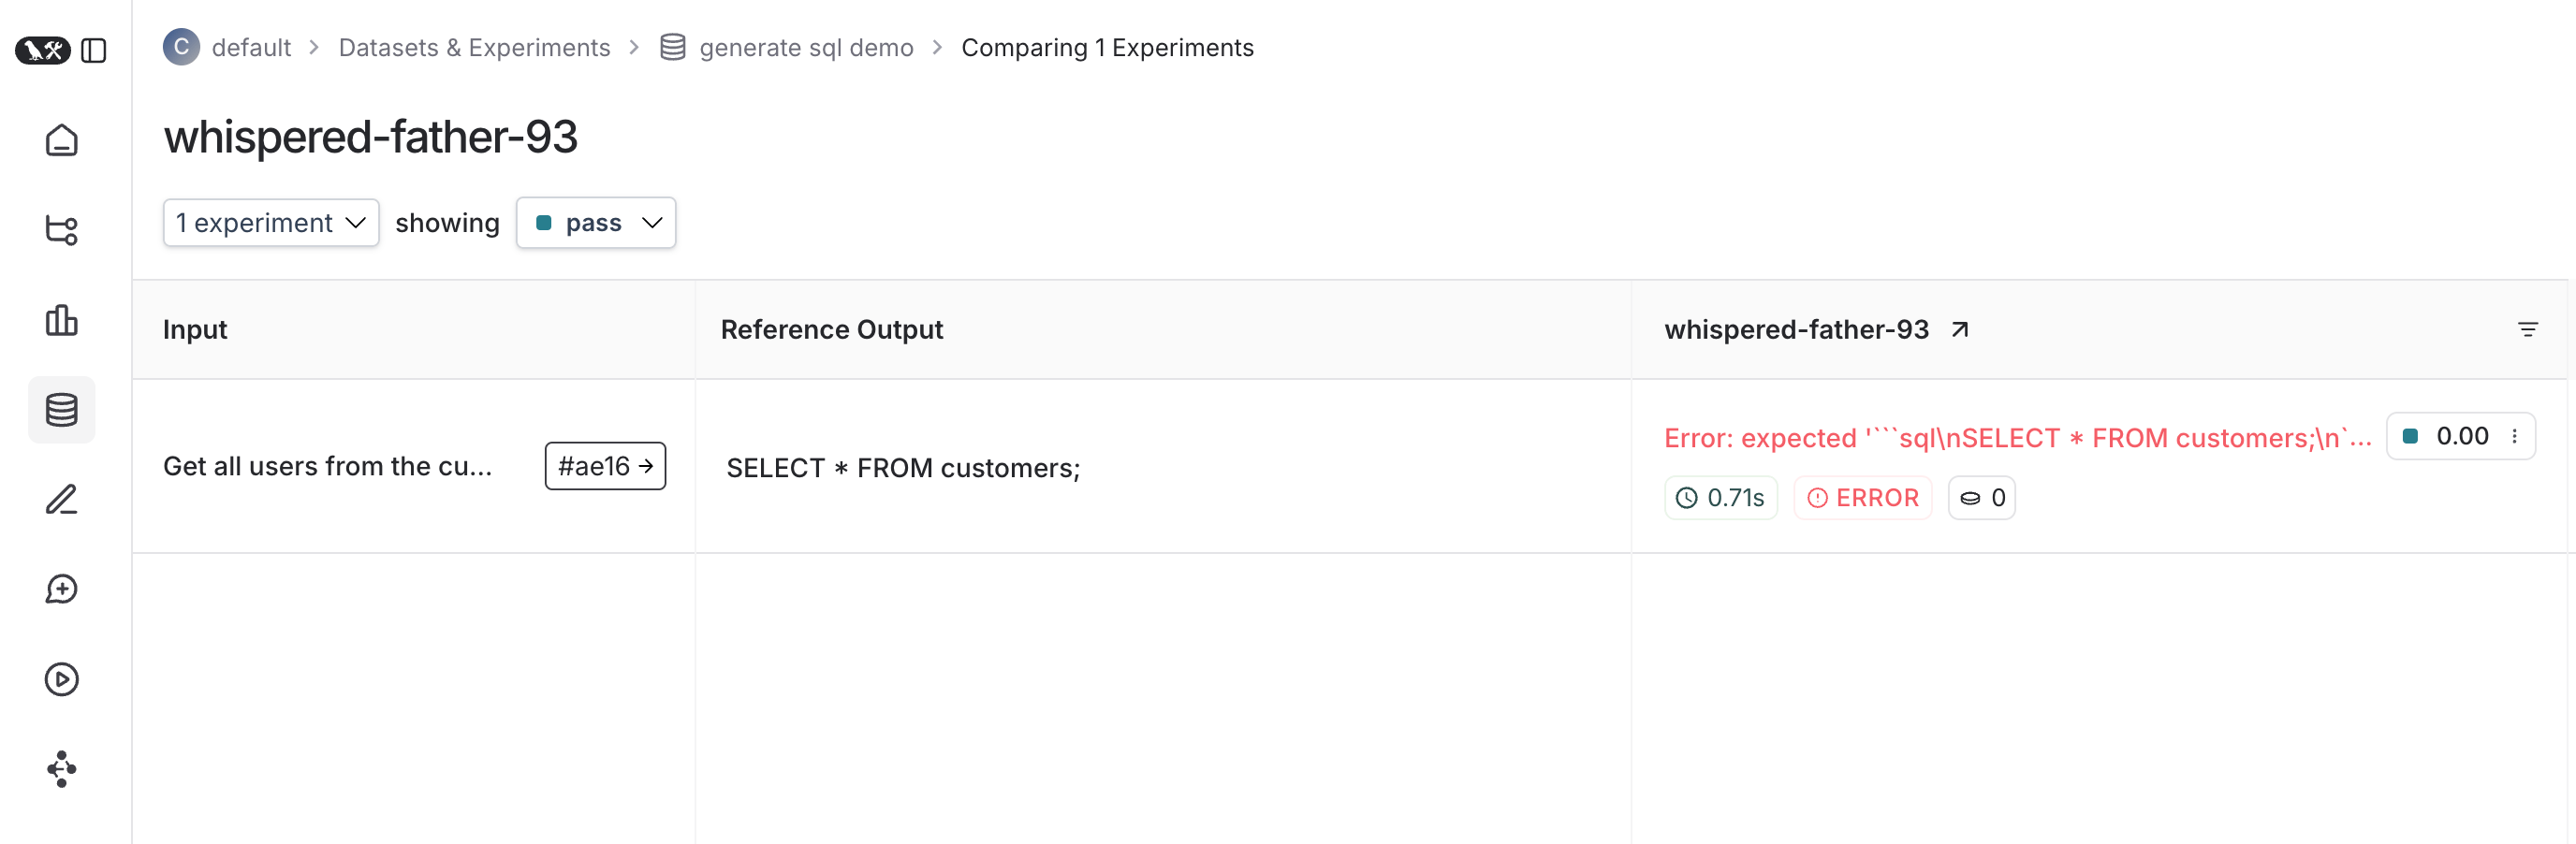
一旦它完成,如果你设置了 LangSmith 环境变量,你会在测试结果旁看到一个把你导向在 LangSmith 中创建的实验的链接。
针对那个测试套件的实验大概是这样:
追踪反馈
默认情况下,LangSmith 在每个测试用例的 pass 反馈键下收集通过/失败率。你可以用 ls.logFeedback() 或 ls.wrapEvaluator() 添加额外反馈。为此,试着把下面这个作为你的 sql.eval.ts 文件(如果你用不带 TypeScript 的 Jest,则 sql.eval.js):
typescript
import * as ls from "langsmith/vitest";
// import * as ls from "langsmith/jest";
import OpenAI from "openai";
import { traceable } from "langsmith/traceable";
import { wrapOpenAI } from "langsmith/wrappers/openai";

// Add "openai" as a dependency and set OPENAI_API_KEY as an environment variable
const tracedClient = wrapOpenAI(new OpenAI());

const generateSql = traceable(
  async (userQuery: string) => {
    const result = await tracedClient.chat.completions.create({
      model: "gpt-5.4-mini",
      messages: [
        {
          role: "system",
          content:
            "Convert the user query to a SQL query. Do not wrap in any markdown tags.",
        },
        {
          role: "user",
          content: userQuery,
        },
      ],
    });
    return result.choices[0].message.content ?? "";
  },
  { name: "generate_sql" }
);

const myEvaluator = async (params: {
  outputs: { sql: string };
  referenceOutputs: { sql: string };
}) => {
  const { outputs, referenceOutputs } = params;
  const instructions = [
    "Return 1 if the ACTUAL and EXPECTED answers are semantically equivalent, ",
    "otherwise return 0. Return only 0 or 1 and nothing else.",
  ].join("\n");
  const grade = await tracedClient.chat.completions.create({
    model: "gpt-5.4-mini",
    messages: [
      {
        role: "system",
        content: instructions,
      },
      {
        role: "user",
        content: `ACTUAL: ${outputs.sql}\nEXPECTED: ${referenceOutputs?.sql}`,
      },
    ],
  });
  const score = parseInt(grade.choices[0].message.content ?? "");
  return { key: "correctness", score };
};

ls.describe("generate sql demo", () => {
  ls.test(
    "generates select all",
    {
      inputs: { userQuery: "Get all users from the customers table" },
      referenceOutputs: { sql: "SELECT * FROM customers;" },
    },
    async ({ inputs, referenceOutputs }) => {
      const sql = await generateSql(inputs.userQuery);
      ls.logOutputs({ sql });
      const wrappedEvaluator = ls.wrapEvaluator(myEvaluator);
      // Will automatically log "correctness" as feedback
      await wrappedEvaluator({
        outputs: { sql },
        referenceOutputs,
      });
      // You can also manually log feedback with `ls.logFeedback()`
      ls.logFeedback({
        key: "harmfulness",
        score: 0.2,
      });
    }
  );
  ls.test(
    "offtopic input",
    {
      inputs: { userQuery: "what's up" },
      referenceOutputs: { sql: "sorry that is not a valid query" },
    },
    async ({ inputs, referenceOutputs }) => {
      const sql = await generateSql(inputs.userQuery);
      ls.logOutputs({ sql });
      const wrappedEvaluator = ls.wrapEvaluator(myEvaluator);
      // Will automatically log "correctness" as feedback
      await wrappedEvaluator({
        outputs: { sql },
        referenceOutputs,
      });
      // You can also manually log feedback with `ls.logFeedback()`
      ls.logFeedback({
        key: "harmfulness",
        score: 0.2,
      });
    }
  );
});注意在 myEvaluator 函数周围对 ls.wrapEvaluator() 的使用。这使得 LLM-as-judge 调用与测试用例其余部分分开追踪以避免杂乱,并在被包裹函数的返回值匹配 { key: string; score: number | boolean } 时便捷地创建反馈。在这种情况下,评估器追踪不会出现在主测试用例运行中,而是出现在与 correctness 反馈键关联的一条追踪中。
你可以通过点击 UI 中对应的反馈小chip,在 LangSmith 中看到评估器运行。
对一个测试用例运行多个示例
你可以用 ls.test.each() 对多个示例运行同一测试用例并参数化你的测试。当你想以相同方式针对不同输入评估你的应用时,这很有用:
typescript
import * as ls from "langsmith/vitest";
// import * as ls from "langsmith/jest";

const DATASET = [
  {
    inputs: { userQuery: "what's up" },
    referenceOutputs: { sql: "sorry that is not a valid query" }
  },
  {
    inputs: { userQuery: "what color is the sky?" },
    referenceOutputs: { sql: "sorry that is not a valid query" }
  },
  {
    inputs: { userQuery: "how are you today?" },
    referenceOutputs: { sql: "sorry that is not a valid query" }
  }
];

ls.describe("generate sql demo", () => {
  ls.test.each(DATASET)(
    "offtopic inputs",
    async ({ inputs, referenceOutputs }) => {
      ...
    },
  );
});如果你启用了跟踪,本地数据集中的每个示例都会被同步到在 LangSmith 中创建的那个。
使用现有数据集(仅 Vitest)
除了内联定义示例,你还可以针对 LangSmith 中一个现有数据集运行测试:
- 用
client.listExamples()从 LangSmith 中一个已存在的数据集获取示例。 - 通过遍历该异步生成器,把示例收集到一个数组(例如
testExamples)中。 - 把该数组传给
ls.test.each(),以对你数据集中的每个示例运行你的测试逻辑。
typescript
import * as ls from "langsmith/vitest";
import { expect } from "vitest";
import { Client, Example } from "langsmith";
import OpenAI from "openai";
import { traceable } from "langsmith/traceable";
import { wrapOpenAI } from "langsmith/wrappers/openai";

const tracedClient = wrapOpenAI(new OpenAI());

const generateSql = traceable(
  async (userQuery: string) => {
    const result = await tracedClient.chat.completions.create({
      model: "gpt-4o-mini",
      messages: [
        {
          role: "system",
          content:
            "Convert the user query to a SQL query. Do not wrap in any markdown tags.",
        },
        {
          role: "user",
          content: userQuery,
        },
      ],
    });
    return result.choices[0].message.content;
  },
  { name: "generate_sql" }
);

// Fetch examples from an existing dataset
const client = new Client();

const examples = client.listExamples({
  datasetName: "generate sql demo",
});

const testExamples: Example[] = [];

for await (const example of examples) {
  testExamples.push(example);
}

ls.describe(
  "generate sql demo",
  () => {
    ls.test.each(testExamples)(
      "generates valid sql",
      async ({ inputs, referenceOutputs }) => {
        const sql = await generateSql(inputs.userQuery);
        ls.logOutputs({ sql });
        expect(sql).toEqual(referenceOutputs?.sql);
      }
    );
  }
);记录输出
我们每次运行一个测试,都会把它同步到一个数据集示例并作为一次运行追踪。要追踪该运行的最终输出,你可以像这样用 ls.logOutputs():
typescript
import * as ls from "langsmith/vitest";
// import * as ls from "langsmith/jest";

ls.describe("generate sql demo", () => {
  ls.test(
    "offtopic input",
    {
      inputs: { userQuery: "..." },
      referenceOutputs: { sql: "..." }
    },
    async ({ inputs, referenceOutputs }) => {
      ls.logOutputs({ sql: "SELECT * FROM users;" })
    },
  );
});被记录的输出会出现在你的 reporter 摘要中和 LangSmith 中。
你也可以直接从你的测试函数返回一个值:
typescript
import * as ls from "langsmith/vitest";
// import * as ls from "langsmith/jest";

ls.describe("generate sql demo", () => {
  ls.test(
    "offtopic input",
    {
      inputs: { userQuery: "..." },
      referenceOutputs: { sql: "..." }
    },
    async ({ inputs, referenceOutputs }) => {
      return { sql: "SELECT * FROM users;" }
    },
  );
});不过请记住,如果你这样做,那么当你的测试因断言失败或其他错误而无法完成时,你的输出不会出现。
追踪中间调用
LangSmith 会自动追踪测试用例执行过程中发生的任何可追踪的中间调用。
聚焦或跳过测试
你可以在 ls.test() 和 ls.describe() 上链式调用 Vitest/Jest 的 .skip 和 .only 方法:
typescript
import * as ls from "langsmith/vitest";
// import * as ls from "langsmith/jest";

ls.describe("generate sql demo", () => {
  ls.test.skip(
    "offtopic input",
    {
      inputs: { userQuery: "..." },
      referenceOutputs: { sql: "..." }
    },
    async ({ inputs, referenceOutputs }) => {
      return { sql: "SELECT * FROM users;" }
    },
  );
  ls.test.only(
    "other",
    {
      inputs: { userQuery: "..." },
      referenceOutputs: { sql: "..." }
    },
    async ({ inputs, referenceOutputs }) => {
      return { sql: "SELECT * FROM users;" }
    },
  );
});配置测试套件
你可以通过向 ls.describe() 为整个套件传入一个额外参数,或向 ls.test() 为单个测试传入一个 config 字段,用元数据或自定义客户端之类的值来配置测试套件:
typescript
ls.describe("test suite name", () => {
  ls.test(
    "test name",
    {
      inputs: { ... },
      referenceOutputs: { ... },
      // Extra config for the test run
      config: { tags: [...], metadata: { ... } }
    },
    {
      name: "test name",
      tags: ["tag1", "tag2"],
      skip: true,
      only: true,
    }
  );
}, {
  testSuiteName: "overridden value",
  metadata: { ... },
  // Custom client
  client: new Client(),
});测试套件还会自动从 process.env.ENVIRONMENT、process.env.NODE_ENV 和 process.env.LANGSMITH_ENVIRONMENT 提取环境变量,并把它们作为元数据设在创建的实验上。然后你可以在 LangSmith 的 UI 中按元数据过滤实验。
完整的配置选项列表参阅 API 参考。
试运行模式
如果你想在不同步结果到 LangSmith 的情况下运行测试,你可以省略你的 LangSmith 追踪环境变量,或在环境中设置 LANGSMITH_TEST_TRACKING=false。
测试会照常运行,但实验日志不会发送到 LangSmith。