
主题
应用专属的评估方法
下面,我们将讨论几种流行类型的 LLM 应用的评估。
智能体
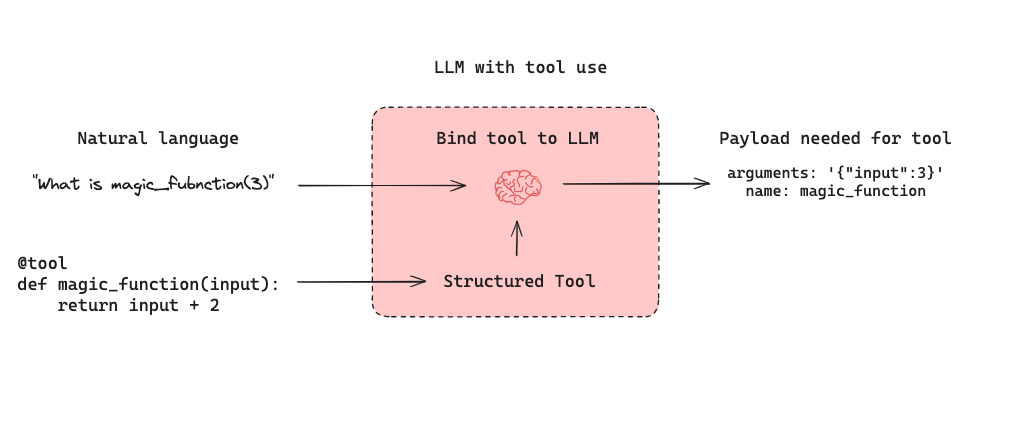
LLM 驱动的自主 agent 结合三个组件(1)工具调用、(2)记忆,以及(3)规划。agent 使用工具调用,配合规划(例如常通过提示)和记忆(例如常是短期消息历史)来生成响应。工具调用让模型通过生成两样东西来响应给定的提示:(1)要调用的工具,以及(2)所需的输入参数。
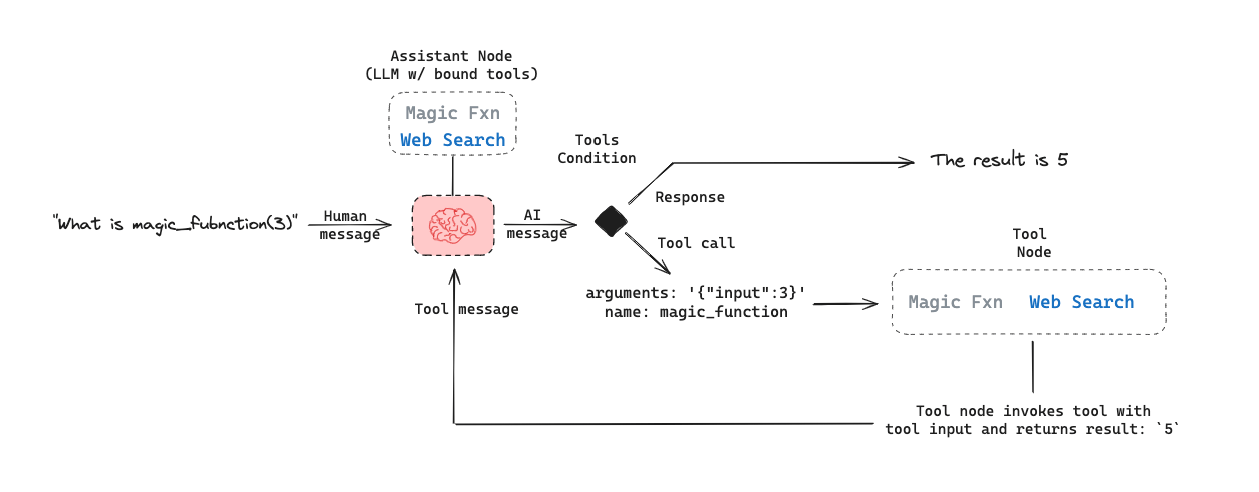
下面是 LangGraph 中的一个工具调用 agent。assistant node 是一个 LLM,它根据输入决定是否调用工具。tool condition 查看是否有一个工具被 assistant node 选中,如果有,则路由到 tool node。tool node 执行工具并把输出作为一条工具消息返回给 assistant node。只要 assistant node 选中了一个工具,这个循环就会继续。如果没有选中工具,则 agent 直接返回 LLM 响应。
这设定了用户通常感兴趣的三种通用类型的 agent 评估:
Final Response:评估 agent 的最终响应。Single step:孤立地评估任何 agent 步骤(例如,它是否选择了合适的工具)。Trajectory:评估 agent 是否采取了预期的路径(例如,工具调用序列)以得出最终答案。
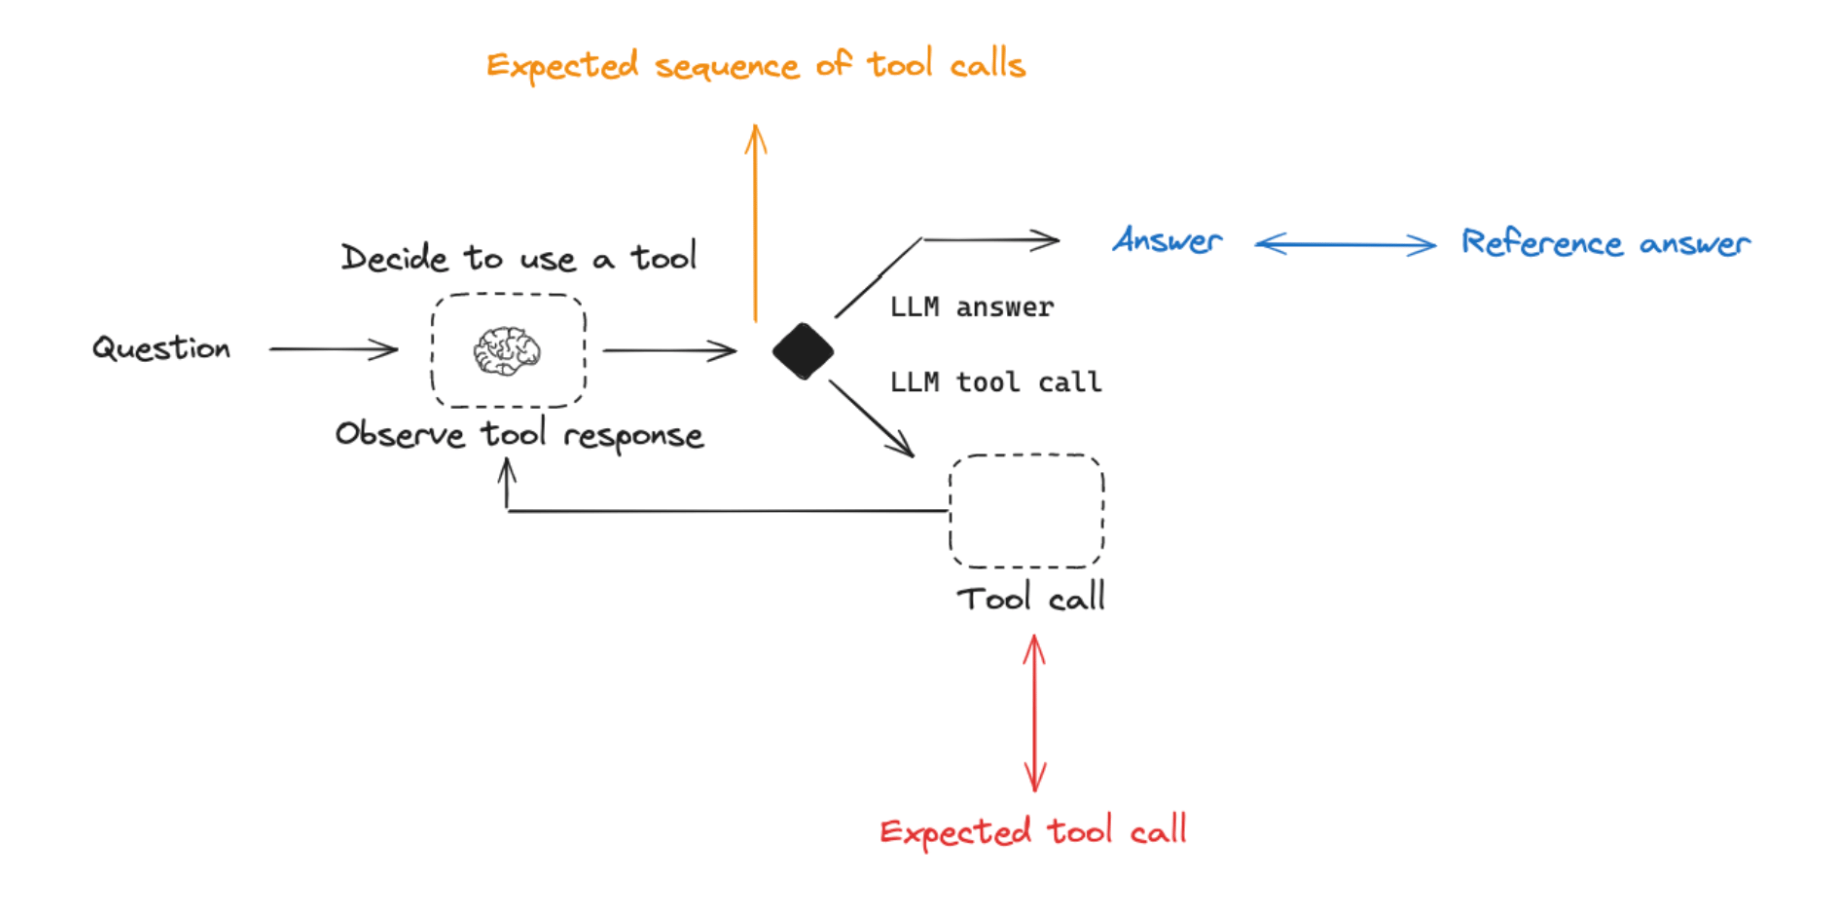
接下来的章节涵盖这些是什么、每一个所需的组件(输入、输出、评估器),以及你何时应考虑它。常见用例通常会使用这些评估类型中的多种或全部;它们并非互斥。
评估 agent 的最终响应
评估 agent 的一种方式是在一个任务上评估其整体表现。这基本上是把 agent 当作黑盒,仅评估它是否把活干成了。
输入应当是用户输入,以及(可选)一个工具列表。在某些情况下,工具是硬编码进 agent 的一部分,无需传入。在另一些情况下,agent 更通用,意味着它没有固定的一组工具,需要在运行时传入工具。
输出应当是 agent 的最终响应。
评估器因你要求 agent 做的任务而异。许多 agent 执行一套相对复杂的步骤,然后输出一个最终文本响应。与 RAG 类似,LLM-as-judge 评估器在这些情况下通常有效,因为它们可以直接从文本响应评估 agent 是否把活干成了。
然而,这种评估有几个缺点。第一,它通常需要较长时间运行。第二,你没有评估 agent 内部发生的任何事情,所以在失败出现时难以调试。第三,有时难以定义合适的评估指标。
评估 agent 的单个步骤
agent 通常执行多个动作。虽然端到端地评估它们很有用,但评估这些单个动作也可能有用。这通常是评估 agent 的单个步骤——即它决定做什么的那次 LLM 调用。
输入应当是单个步骤的输入。根据你在测试什么,这可能只是原始的用户输入(例如一个提示和/或一组工具),也可以包含先前完成的步骤。
输出只是那个步骤的输出,通常就是 LLM 响应。LLM 响应通常包含工具调用,指示 agent 下一步应采取什么动作。
这里的评估器通常是关于是否选对了工具的二元分数,以及关于工具输入是否正确的一些启发式判断。参考工具可以简单地指定为一个字符串。
这种评估有几个好处。它允许你评估单个动作,从而让你聚焦于应用可能失败之处。它们运行起来也相对快(因为它们只涉及一次 LLM 调用),且评估通常使用对选中工具相对于参考工具的简单启发式判断。一个缺点是它们没有捕捉完整的 agent——只有一个特定步骤。另一个缺点是数据集创建可能很有挑战,尤其是当你想在 agent 输入中纳入过去的历史时。为 agent 轨迹中靠前的步骤生成数据集很容易(例如,这可能只包括输入提示),但为轨迹中靠后的步骤生成数据集可能很难(例如,纳入大量先前的 agent 动作和响应)。
评估 agent 的轨迹
评估 agent 的轨迹涉及评估 agent 采取的所有步骤。
输入同样是对整体 agent 的输入(用户输入,以及可选的一个工具列表)。
输出是一个工具调用列表,可以表述为一个“精确”轨迹(例如一个预期的工具调用序列),或仅仅是预期的(任意顺序的)一组工具调用。
这里的评估器是关于所采取步骤的某个函数。评估“精确”轨迹可以使用一个二元分数,确认序列中每个工具名的精确匹配。这很简单,但有些缺陷。有时可能有多条正确路径。这种评估也没有捕捉到轨迹只差一步与完全错误之间的差别。
为解决这些缺陷,评估指标可以聚焦于采取的“不正确”步骤数,这能更好地为接近的轨迹与显著偏离的轨迹做出区分。评估指标也可以聚焦于是否所有预期的工具都以任意顺序被调用。
然而,这些方法都没有评估工具的输入;它们只聚焦于被选中的工具。为考虑到这一点,另一种评估技术是把完整 agent 的轨迹(连同一条参考轨迹)作为一组消息(例如所有 LLM 响应和工具调用)传给一个 LLM-as-judge。这可以评估 agent 的完整行为,但它是最难编制的参考。这就是像 LangGraph 这样的框架能帮上忙的地方。另一个缺点是评估指标可能有点难以想出来。
评估 RAG 应用
检索增强生成(RAG) 为用户输入检索文档并将其传给一个模型,以便响应可以使用外部知识。要逐步演练,参阅评估一个 RAG 应用。
选择一个数据集
在评估 RAG 应用时,首先决定你是否为每个示例都有一个参考答案:
- 带参考答案:把它们用作真值来为答案正确性打分。
- 不带参考答案:使用检查文档相关性、答案忠实度和有用性的无参考提示(参阅 RAG 评估摘要)。
选择评估器
LLM-as-judge 评估器很适合 RAG,因为它们可以为文本之间的事实准确性和一致性打分。
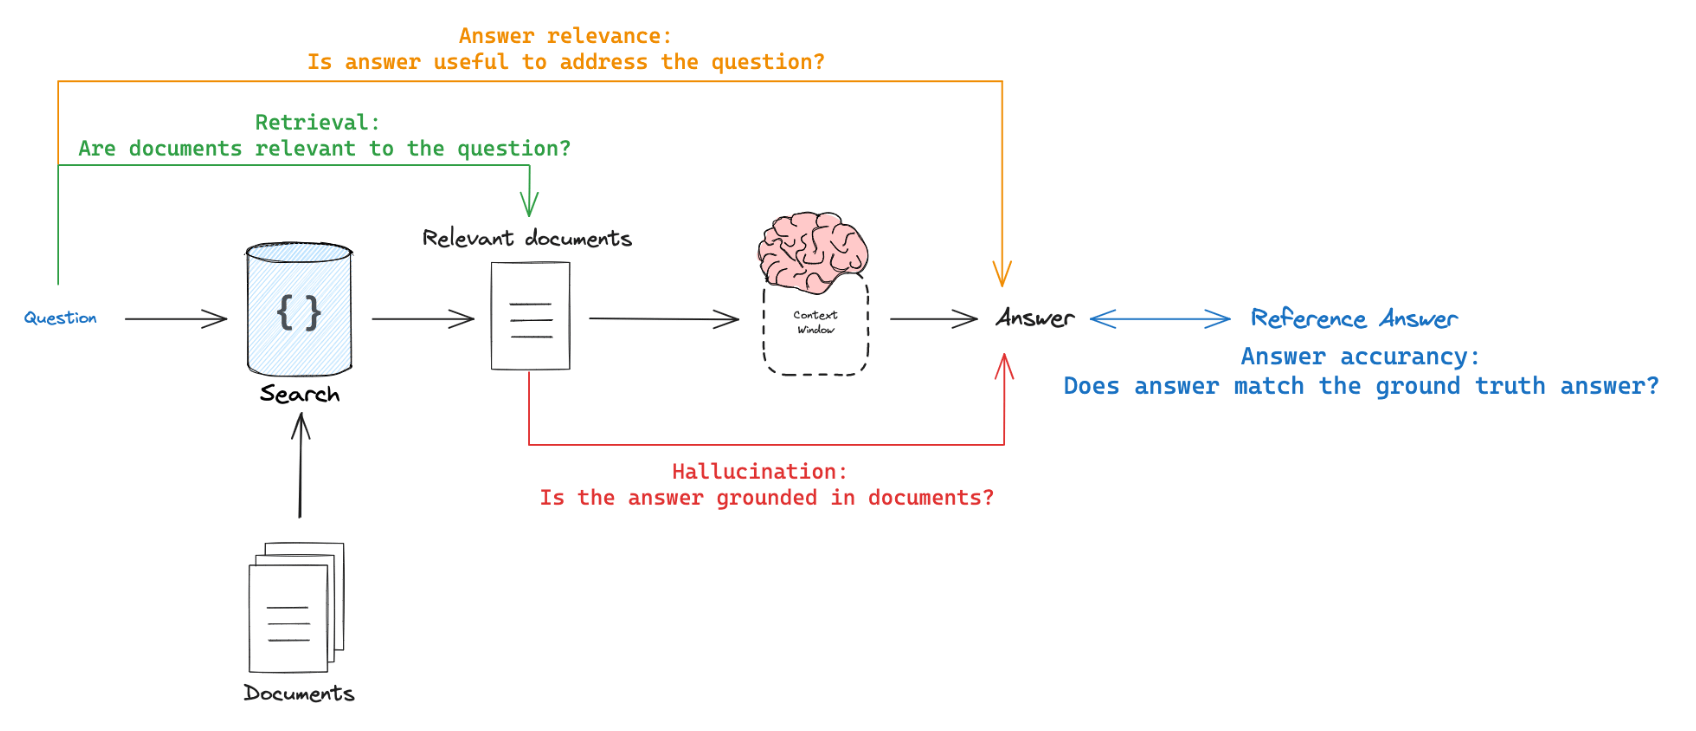
你可以使用两种评估器:
- 基于参考:将生成的答案或检索到的文档与一个参考答案或参考检索结果进行比较。
- 无参考:运行不需要参考答案的自一致性检查(上图中橙色、绿色和红色部分)。
选择评估模式
- 离线:当提示需要参考答案时使用,最常用于答案正确性。
- 在线:用于无参考提示,以便你为实时流量打分。
- 成对:就格式或风格等标准比较来自不同 RAG 链的答案。改为使用自一致性或参考答案来评判正确性。
RAG 评估摘要
| 评估器 | 详情 | 需要参考输出 | LLM-as-judge? | 成对相关 |
|---|---|---|---|---|
| 文档相关性 | 文档与问题相关吗? | 否 | 是 - prompt | 否 |
| 答案忠实度 | 答案是否有据于文档? | 否 | 是 - prompt | 否 |
| 答案有用性 | 答案有助于回应问题吗? | 否 | 是 - prompt | 否 |
| 答案正确性 | 答案与参考答案一致吗? | 是 | 是 - prompt | 否 |
| 成对比较 | 多个答案版本如何比较? | 否 | 是 - prompt | 是 |
摘要
摘要是自由式写作的一个特定类型。评估目标通常是依据一组标准来检查所写的东西(摘要)。
待摘本文本的 Developer curated examples 常用于评估(参阅一个摘要数据集示例)。不过,来自一个生产(摘要)应用的 user logs 可用于在线评估,搭配下面任何 Reference-free 评估提示。
LLM-as-judge 通常用于摘以及(以及其他类型的写作)的评估,它使用遵循所提供标准来为摘要打分的 Reference-free 提示。提供特定的 Reference 摘要的情形较少,因为摘要是一项创造性任务,有许多可能的正确答案。
Online 或 Offline 评估都是可行的,因为使用的是 Reference-free 提示。Pairwise 评估也是一种在不同摘要链(例如不同的摘要提示或 LLM)之间进行比较的强大方式:
| 用例 | 详情 | 需要参考输出 | LLM-as-judge? | 成对相关 |
|---|---|---|---|---|
| 事实准确性 | 相对于源文档,摘要准确吗? | 否 | 是 - prompt | 是 |
| 忠实度 | 摘要是否有据于源文档(例如无幻觉)? | 否 | 是 - prompt | 是 |
| 有用性 | 摘要相对于用户需求有帮助吗? | 否 | 是 - prompt | 是 |
分类与标注
分类与标注为一个给定输入应用一个标签(例如用于毒性检测、情感分析等)。分类/标注评估通常使用以下组件,我们将在下文详述:
分类/标注评估的一个核心考量是你是否拥有一个带 reference 标签的数据集。如果没有,用户常常想定义一个使用标准为一个输入(例如文本、用户问题等)应用标签(例如毒性等)的评估器。然而,如果提供了真值类别标签,那么评估目标就聚焦于相对于真值类别标签为一个分类/标注链打分(例如使用精确率、召回率等指标)。
如果提供了真值参考标签,那么通常简单地定义一个自定义启发式评估器来把真值标签与链输出进行比较。然而,鉴于 LLM 的出现,越来越常见的是直接根据指定标准(在没有真值参考的情况下)使用 LLM-as-judge 对一个输入进行分类/标注。
当使用搭配 Reference-free 提示的 LLM-as-judge 时,Online 或 Offline 评估是可行的。特别是,当用户想为一个输入打标签/分类(例如为了毒性等)时,这很适合 Online 评估。
| 用例 | 详情 | 需要参考输出 | LLM-as-judge? | 成对相关 |
|---|---|---|---|---|
| Accuracy | 标准定义 | 是 | 否 | 否 |
| Precision | 标准定义 | 是 | 否 | 否 |
| Recall | 标准定义 | 是 | 否 | 否 |