主题
Portkey 是一个全栈 LLMOps 平台,可可靠、安全地将你的生成式 AI 应用投入生产。
Portkey 与 Llamaindex 集成的关键特性:

- 日志记录:跟踪所有请求以进行监控和调试。
- 请求追踪:了解每个请求的路径以进行优化。
- 自定义标签:对请求进行分段和分类,以获得更好的洞察。
- 反馈收集:无缝收集对任何已服务请求的反馈,无论是生成级别还是对话级别。
- 加权反馈:通过为用户反馈值附加权重来获取细致的信息。
- 反馈元数据:将自定义元数据与反馈结合以提供上下文,从而实现更丰富的洞察和分析。
- 虚拟密钥:Portkey 将原始提供商密钥转换为虚拟密钥,确保你的主要凭据保持不变。
- 多个标识符:可以为同一提供商添加多个密钥,或以不同名称添加同一密钥,便于识别且不影响安全。
要利用这些功能,让我们从设置开始:
如果你在 Colab 中打开这个 Notebook,可能需要先安装 LlamaIndex 🦙。
%pip install llama-index-llms-portkey!pip install llama-index# Installing Llamaindex & Portkey SDK
!pip install -U llama_index
!pip install -U portkey-ai
# Importing necessary libraries and modules
from llama_index.llms.portkey import Portkey
from llama_index.core.llms import ChatMessage
import portkey as pk你无需安装任何其他 SDK,也无需在 Llamaindex 应用中导入它们。
步骤 1️⃣:获取你的 Portkey API 密钥以及 OpenAI、Anthropic 等的虚拟密钥
Portkey API 密钥:登录 Portkey,然后点击左上角的个人资料图标并选择“复制 API 密钥”。
import os

os.environ["PORTKEY_API_KEY"] = "PORTKEY_API_KEY"- 前往 Portkey 仪表板上的“Virtual Keys”页面,点击右上角的“Add Key”按钮。
- 选择你的 AI 提供商(OpenAI、Anthropic、Cohere、HuggingFace 等),为密钥指定唯一名称,如有需要,记下任何相关的使用说明。你的虚拟密钥就准备好了!
 3. 现在复制并粘贴下面的密钥——你可以在 Portkey 生态系统的任何地方使用它们,同时保持你原始密钥的安全和不受影响。
openai_virtual_key_a = ""
openai_virtual_key_b = ""

anthropic_virtual_key_a = ""
anthropic_virtual_key_b = ""

cohere_virtual_key_a = ""
cohere_virtual_key_b = ""如果你不想使用 Portkey 的虚拟密钥,也可以直接使用你的 AI 提供商密钥。
os.environ["OPENAI_API_KEY"] = ""
os.environ["ANTHROPIC_API_KEY"] = ""第 2️⃣ 步:配置 Portkey 功能
为了充分发挥 Portkey 与 Llamaindex 集成的潜力,你可以如上所示配置各种功能。以下是所有 Portkey 功能及其预期值的指南:
| 功能 | 配置键 | 值(类型) | 是否必需 |
|---|---|---|---|
| API 密钥 | api_key | string | ✅ 必需(可在外部设置) |
| 模式 | mode | fallback、loadbalance、single | ✅ 必需 |
| 缓存类型 | cache_status | simple、semantic | ❔ 可选 |
| 强制缓存刷新 | cache_force_refresh | True、False | ❔ 可选 |
| 缓存时效 | cache_age | integer(单位:秒) | ❔ 可选 |
| 追踪 ID | trace_id | string | ❔ 可选 |
| 重试 | retry | integer [0,5] | ❔ 可选 |
| 元数据 | metadata | json object 更多信息 | ❔ 可选 |
| 基础 URL | base_url | url | ❔ 可选 |
api_key和mode是必需的值。你可以通过 Portkey 构造函数设置 Portkey API 密钥,也可以将其设置为环境变量。
共有 3 种模式——Single、Fallback、Loadbalance。
以下是如何设置其中一些功能的示例:
portkey_client = Portkey(
    mode="single",
)

# Since we have defined the Portkey API Key with os.environ, we do not need to set api_key again here第 3️⃣ 步:构造 LLM
借助 Portkey 集成,构造 LLM 变得简化。对所有提供商都使用 LLMOptions 函数,并采用你在 OpenAI 或 Anthropic 构造函数中熟悉的完全相同键。唯一新增的键是 weight,它对负载均衡功能至关重要。
openai_llm = pk.LLMOptions(
    provider="openai",
    model="gpt-4",
    virtual_key=openai_virtual_key_a,
)上面的代码展示了如何使用 LLMOptions 函数设置带有 OpenAI 提供商和 GPT-4 模型的 LLM。同一个函数也可用于其他提供商,从而使集成过程在各提供商之间保持精简和一致。
第 4️⃣ 步:激活 Portkey 客户端
一旦你使用 LLMOptions 函数构造好 LLM,下一步就是用 Portkey 激活它。此步骤对于确保你的 LLM 可以使用所有 Portkey 功能至关重要。
portkey_client.add_llms(openai_llm)就这样!仅需 4 个步骤,你就为 Llamaindex 应用注入了强大的生产级能力。
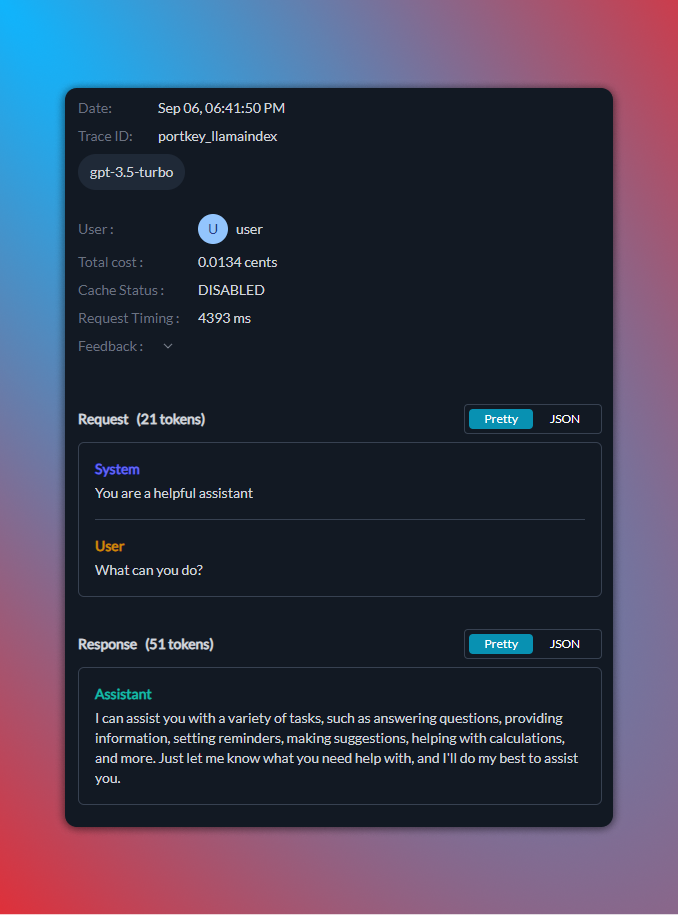
🔧 测试集成
让我们确保一切设置正确。下面我们创建一个简单的聊天场景,并将其传给 Portkey 客户端以查看响应。
messages = [
    ChatMessage(role="system", content="You are a helpful assistant"),
    ChatMessage(role="user", content="What can you do?"),
]
print("Testing Portkey Llamaindex integration:")
response = portkey_client.chat(messages)
print(response)以下是你的日志在 Portkey 仪表板上的显示效果:
⏩ 流式响应
使用 Portkey,流式响应从未如此简单。Portkey 提供 4 个响应函数:
.complete(prompt).stream_complete(prompt).chat(messages).stream_chat(messages)
complete 函数需要字符串输入(str),而 chat 函数则使用 ChatMessage 对象数组。
用法示例:
# Let's set up a prompt and then use the stream_complete function to obtain a streamed response.

prompt = "Why is the sky blue?"

print("\nTesting Stream Complete:\n")
response = portkey_client.stream_complete(prompt)
for i in response:
    print(i.delta, end="", flush=True)

# Let's prepare a set of chat messages and then utilize the stream_chat function to achieve a streamed chat response.

messages = [
    ChatMessage(role="system", content="You are a helpful assistant"),
    ChatMessage(role="user", content="What can you do?"),
]

print("\nTesting Stream Chat:\n")
response = portkey_client.stream_chat(messages)
for i in response:
print(i.delta, end="", flush=True)🔍 回顾与参考
恭喜!🎉 你已成功设置并测试了 Portkey 与 Llamaindex 的集成。回顾一下步骤:
- pip install portkey-ai
- from llama_index.llms import Portkey
- 获取你的 Portkey API 密钥,并从此处创建虚拟提供商密钥。
- 构造你的 Portkey 客户端并设置模式:
portkey_client=Portkey(mode="fallback") - 使用 LLMOptions 构造你的提供商 LLM:
openai_llm = pk.LLMOptions(provider="openai", model="gpt-4", virtual_key=openai_key_a) - 使用
portkey_client.add_llms(openai_llm)将 LLM 添加到 Portkey - 像使用任何其他 LLM 一样正常调用 Portkey 方法,例如
portkey_client.chat(messages)
以下是所有函数及其参数的指南:
🔁 使用 Portkey 实现回退与重试
回退和重试对于构建有弹性的 AI 应用至关重要。使用 Portkey,实现这些功能非常简单:
- 回退:如果主服务或模型发生故障,Portkey 会自动切换到备用模型。
- 重试:如果请求失败,可以将 Portkey 配置为多次重试该请求。
下面,我们演示如何使用 Portkey 设置回退和重试:
portkey_client = Portkey(mode="fallback")
messages = [
    ChatMessage(role="system", content="You are a helpful assistant"),
    ChatMessage(role="user", content="What can you do?"),
]

llm1 = pk.LLMOptions(
    provider="openai",
    model="gpt-4",
    retry_settings={"on_status_codes": [429, 500], "attempts": 2},
    virtual_key=openai_virtual_key_a,
)

llm2 = pk.LLMOptions(
    provider="openai",
    model="gpt-3.5-turbo",
    virtual_key=openai_virtual_key_b,
)

portkey_client.add_llms(llm_params=[llm1, llm2])

print("Testing Fallback & Retry functionality:")
response = portkey_client.chat(messages)
print(response)⚖️ 使用 Portkey 实现负载均衡
负载均衡可确保传入请求在多个模型之间高效分配。这不仅提升了性能,而且在某个模型发生故障时还提供了冗余。
使用 Portkey,实现负载均衡非常简单。你需要:
- 为每个 LLM 定义
weight参数。该权重决定请求在 LLM 之间的分配方式。 - 确保所有 LLM 的权重之和等于 1。
以下是使用 Portkey 设置负载均衡的示例:
portkey_client = Portkey(mode="ab_test")

messages = [
    ChatMessage(role="system", content="You are a helpful assistant"),
    ChatMessage(role="user", content="What can you do?"),
]

llm1 = pk.LLMOptions(
    provider="openai",
    model="gpt-4",
    virtual_key=openai_virtual_key_a,
    weight=0.2,
)

llm2 = pk.LLMOptions(
    provider="openai",
    model="gpt-3.5-turbo",
    virtual_key=openai_virtual_key_a,
    weight=0.8,
)

portkey_client.add_llms(llm_params=[llm1, llm2])

print("Testing Loadbalance functionality:")
response = portkey_client.chat(messages)
print(response)🧠 使用 Portkey 实现语义缓存
语义缓存是一种理解请求上下文的智能缓存机制。语义缓存不是仅根据精确输入匹配进行缓存,而是识别相似请求并提供缓存结果,从而减少冗余请求、缩短响应时间并节省成本。
让我们看看如何使用 Portkey 实现语义缓存:
import time

portkey_client = Portkey(mode="single")

openai_llm = pk.LLMOptions(
    provider="openai",
    model="gpt-3.5-turbo",
    virtual_key=openai_virtual_key_a,
    cache_status="semantic",
)

portkey_client.add_llms(openai_llm)

current_messages = [
    ChatMessage(role="system", content="You are a helpful assistant"),
    ChatMessage(role="user", content="What are the ingredients of a pizza?"),
]

print("Testing Portkey Semantic Cache:")

start = time.time()
response = portkey_client.chat(current_messages)
end = time.time() - start

print(response)
print(f"{'-'*50}\nServed in {end} seconds.\n{'-'*50}")

new_messages = [
    ChatMessage(role="system", content="You are a helpful assistant"),
    ChatMessage(role="user", content="Ingredients of pizza"),
]

print("Testing Portkey Semantic Cache:")

start = time.time()
response = portkey_client.chat(new_messages)
end = time.time() - start

print(response)
print(f"{'-'*50}\nServed in {end} seconds.\n{'-'*50}")Portkey 的缓存还支持另外两个对缓存至关重要的功能——强制刷新和缓存时效。
cache_force_refresh:强制向你的提供商发送请求,而不是从缓存中提供服务。cache_age:确定此特定字符串的缓存存储自动刷新的间隔。缓存时效以秒为单位设置。
以下是如何使用它:
# Setting the cache status as `semantic` and cache_age as 60s.
openai_llm = pk.LLMOptions(
    provider="openai",
    model="gpt-3.5-turbo",
    virtual_key=openai_virtual_key_a,
    cache_force_refresh=True,
    cache_age=60,
)🔬 使用 Portkey 进行可观测性管理
深入了解应用的行为至关重要。Portkey 的可观测性功能让你可以轻松监控、调试和优化 AI 应用。你可以跟踪每个请求、了解其路径,并基于自定义标签对其进行分段。这种级别的细节有助于识别瓶颈、优化成本并提升整体用户体验。
以下是如何使用 Portkey 设置可观测性:
metadata = {
    "_environment": "production",
    "_prompt": "test",
    "_user": "user",
    "_organisation": "acme",
}

trace_id = "llamaindex_portkey"

portkey_client = Portkey(mode="single")

openai_llm = pk.LLMOptions(
    provider="openai",
    model="gpt-3.5-turbo",
    virtual_key=openai_virtual_key_a,
    metadata=metadata,
    trace_id=trace_id,
)

portkey_client.add_llms(openai_llm)

print("Testing Observability functionality:")
response = portkey_client.chat(messages)
print(response)🌉 开源 AI 网关
Portkey 的 AI 网关内部使用开源项目 Rubeus。Rubeus 为 LLM 互操作性、负载均衡、回退等功能提供支持,并充当中间层,确保你的请求以最优方式处理。
使用 Portkey 的优势之一是其灵活性。你可以轻松自定义其行为、将请求重定向到不同提供商,甚至完全绕过向 Portkey 记录日志。
以下是使用 Portkey 自定义行为的示例:
portkey_client.base_url=None📝 使用 Portkey 收集反馈
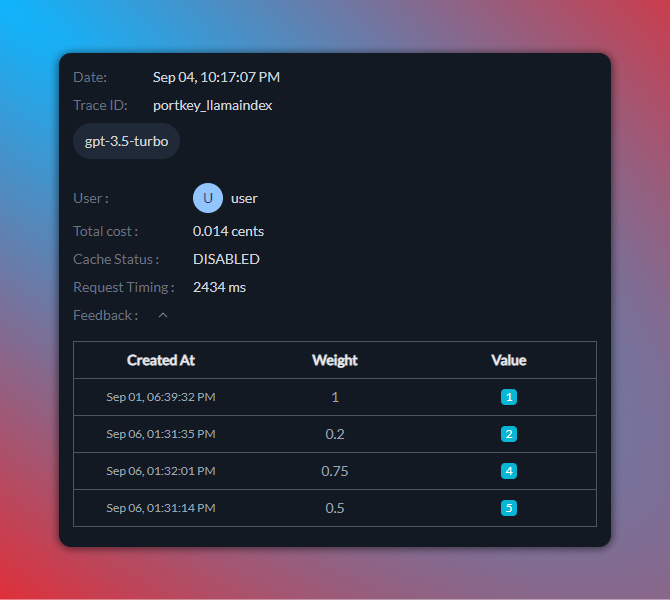
持续改进是 AI 的基石。为确保模型和应用不断演进并更好地服务用户,反馈至关重要。Portkey 的 Feedback API 提供了一种直接的方式来收集用户的加权反馈,让你可以随时间推移不断优化和改进。
以下是如何使用 Portkey 的 Feedback API:
import requests
import json

# Endpoint URL
url = "https://api.portkey.ai/v1/feedback"

# Headers
headers = {
    "x-portkey-api-key": os.environ.get("PORTKEY_API_KEY"),
    "Content-Type": "application/json",
}

# Data
data = {"trace_id": "llamaindex_portkey", "value": 1}

# Making the request
response = requests.post(url, headers=headers, data=json.dumps(data))

# Print the response
print(response.text)每个 trace id 带有 weight 和 value 的所有反馈都可以在 Portkey 仪表板上查看:
✅ 结论
将 Portkey 与 Llamaindex 集成可简化构建健壮且有弹性的 AI 应用的过程。借助语义缓存、可观测性、负载均衡、反馈和回退等功能,你可以确保最佳性能和持续改进。
按照本指南,你已设置并测试了 Portkey 与 Llamaindex 的集成。在继续构建和部署 AI 应用时,请记住充分利用此集成的全部潜力!
如需进一步帮助或有问题,请联系开发者 ➡️
加入我们的从业者社区,一起将 LLM 投入生产 ➡️