
主题
本指南用图示说明每种索引的工作方式。
先明确几个术语:
- Node:对应文档中的一个文本块。LlamaIndex 接收 Document 对象,并在内部把它们解析/切分成 Node 对象。
- Response Synthesis(响应合成):根据检索到的 Node 合成回答的模块。你可以了解如何指定不同的响应模式。
摘要索引(原列表索引)
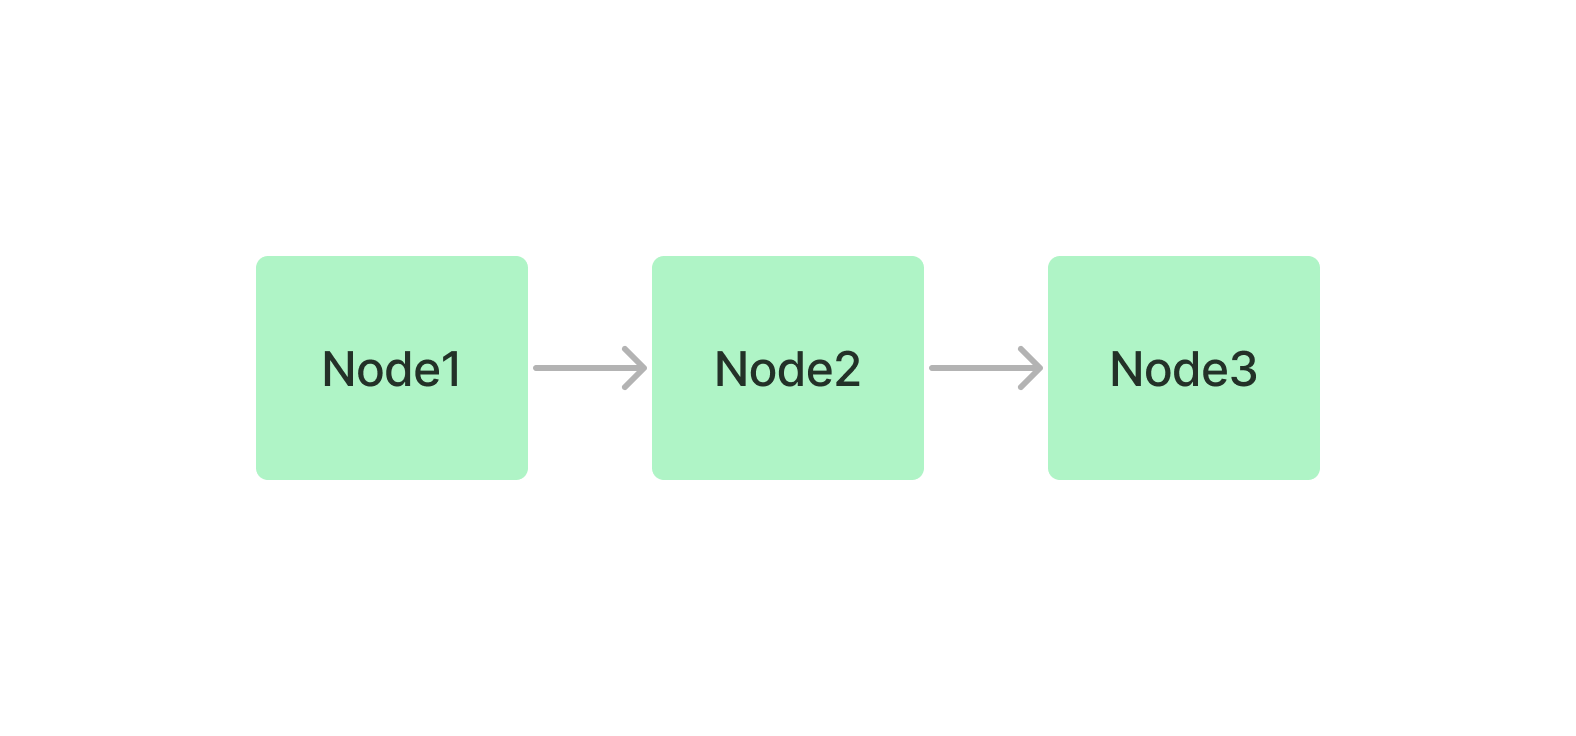
摘要索引只是把 Nodes 存成一条顺序链。
查询
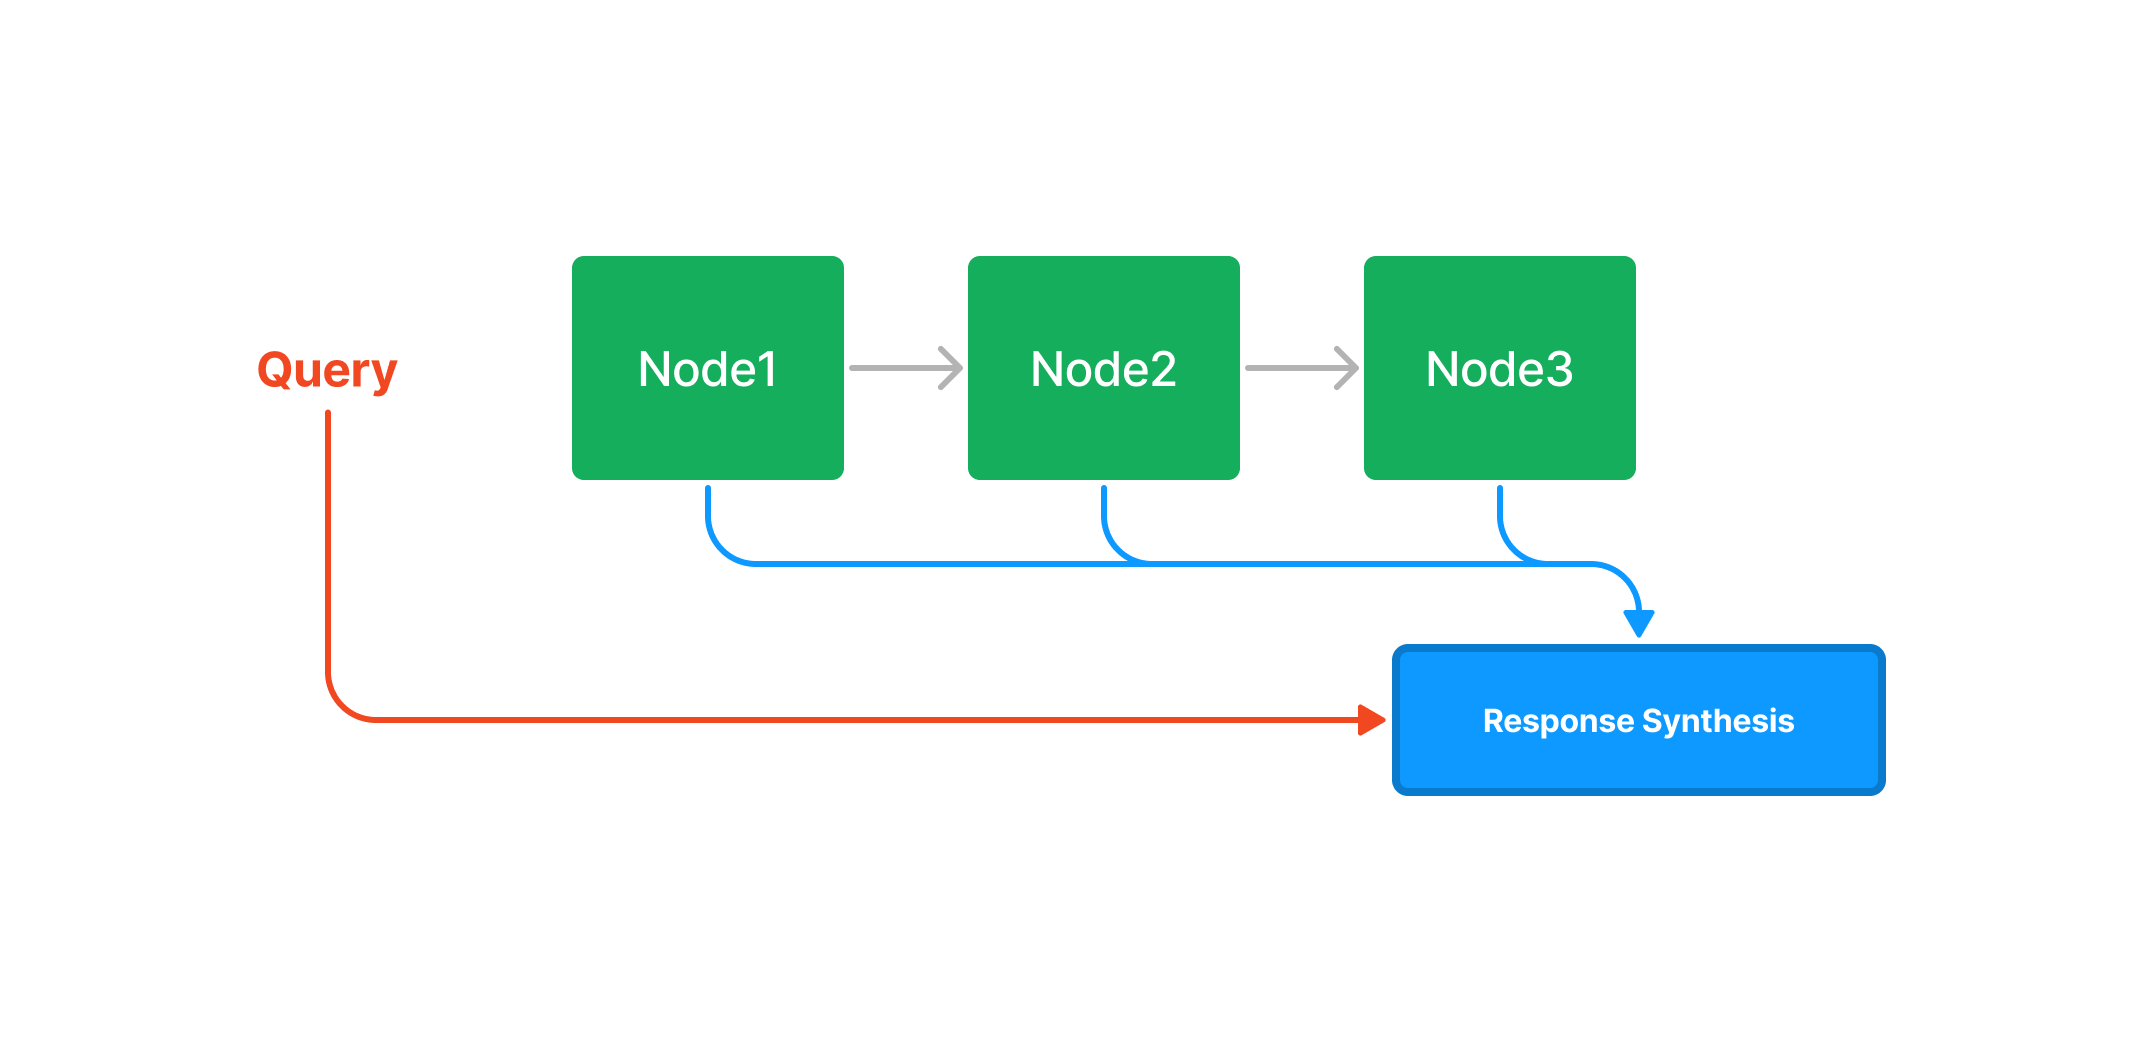
在查询时,若没有指定其他查询参数,LlamaIndex 会把列表中的所有 Nodes 全部交给响应合成模块。
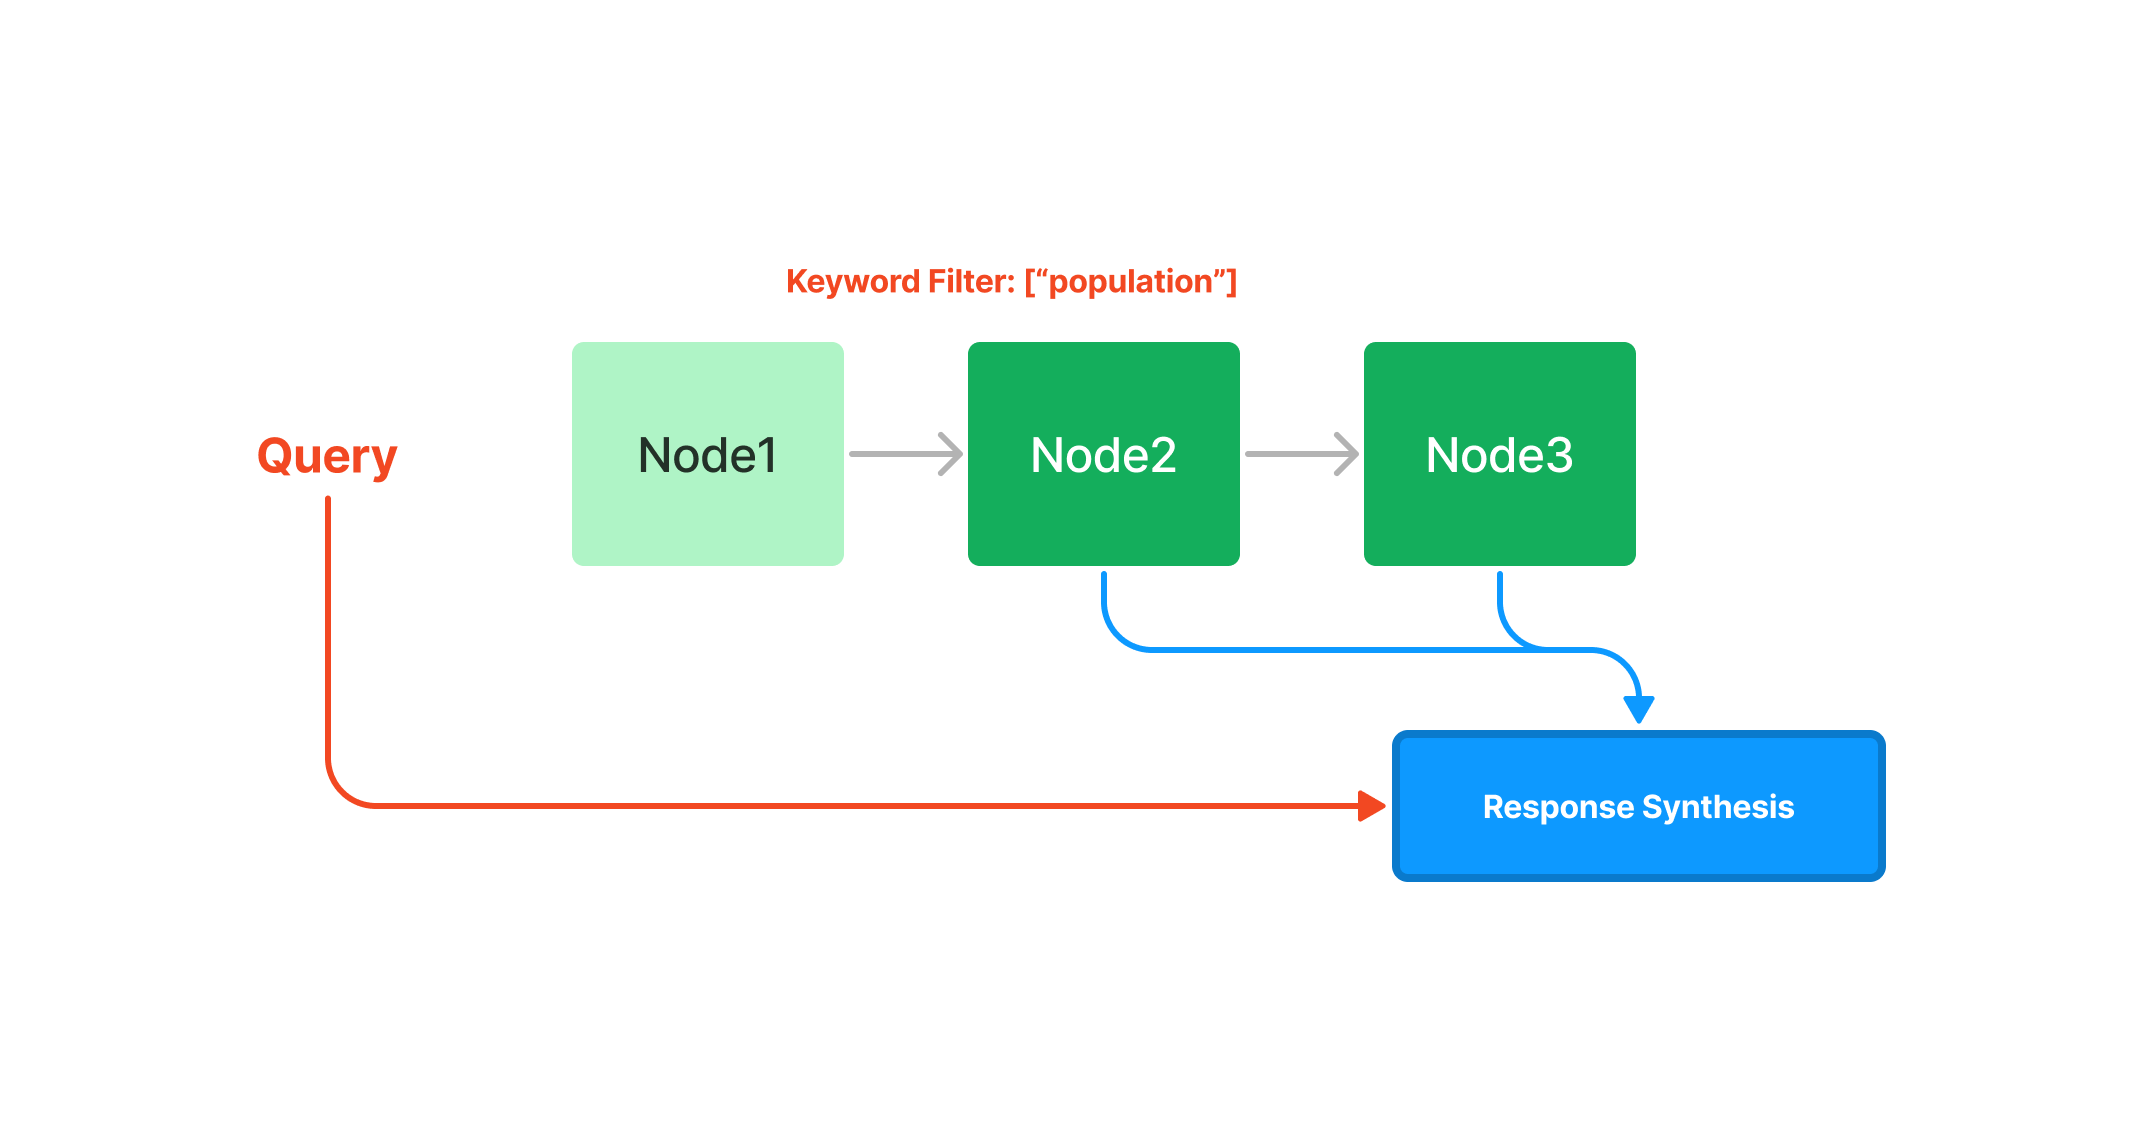
摘要索引也提供了多种查询方式:既可以做基于嵌入的查询以取回 top-k 近邻,也可以再叠加关键词过滤,如下所示:
向量库索引(Vector Store Index)
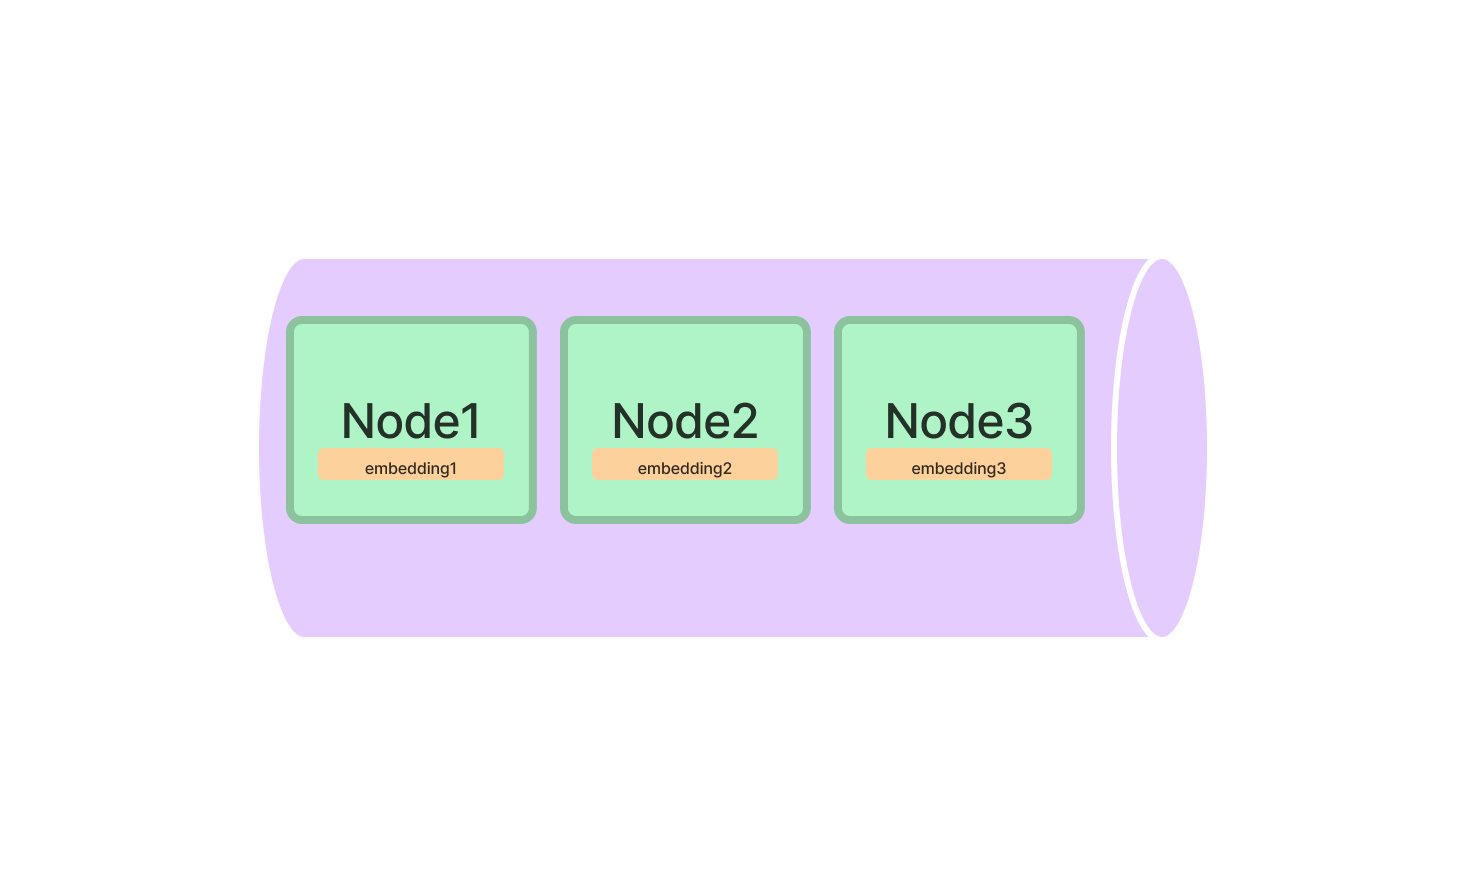
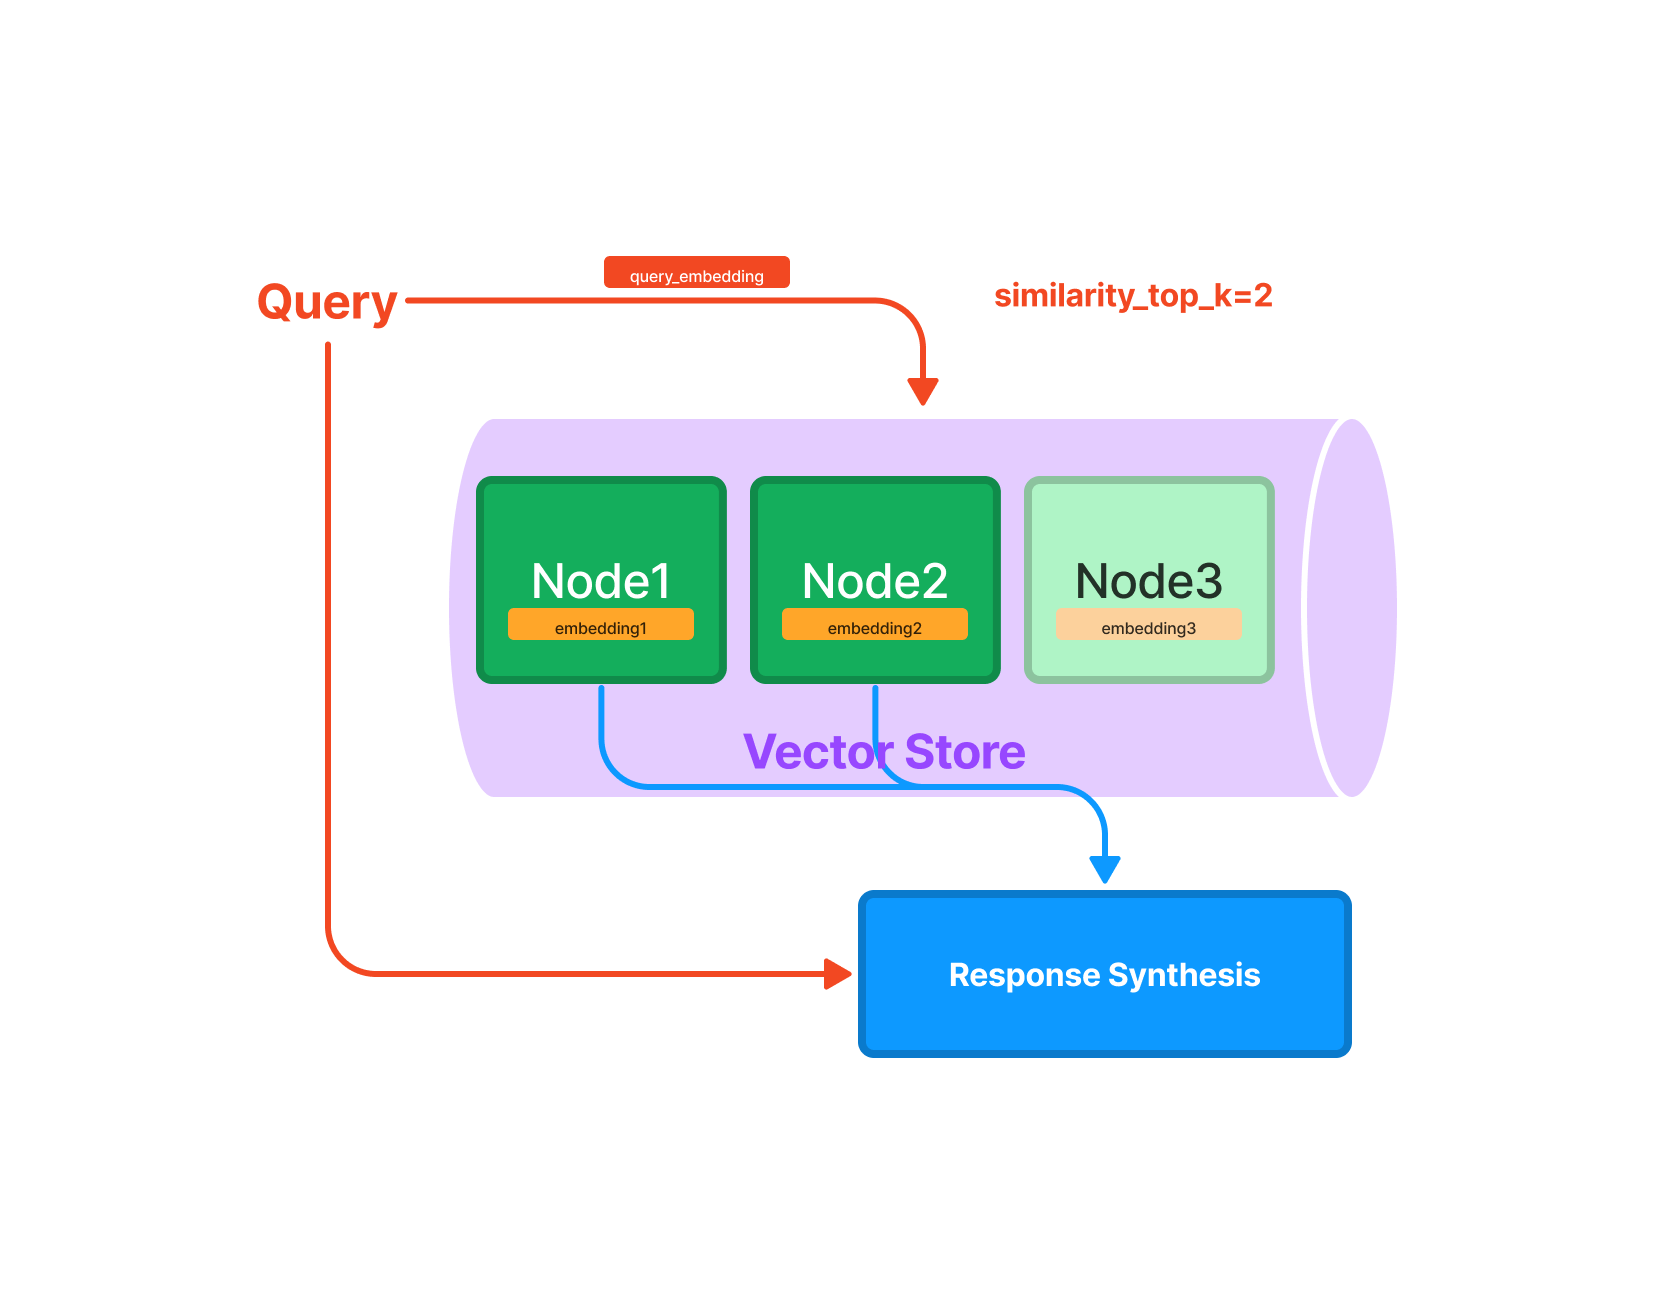
向量库索引把每个 Node 及其对应的嵌入存放在一个向量库里。
查询
查询向量库索引时,会取回最相似的前 k 个 Nodes,并把它们交给响应合成模块。
树索引
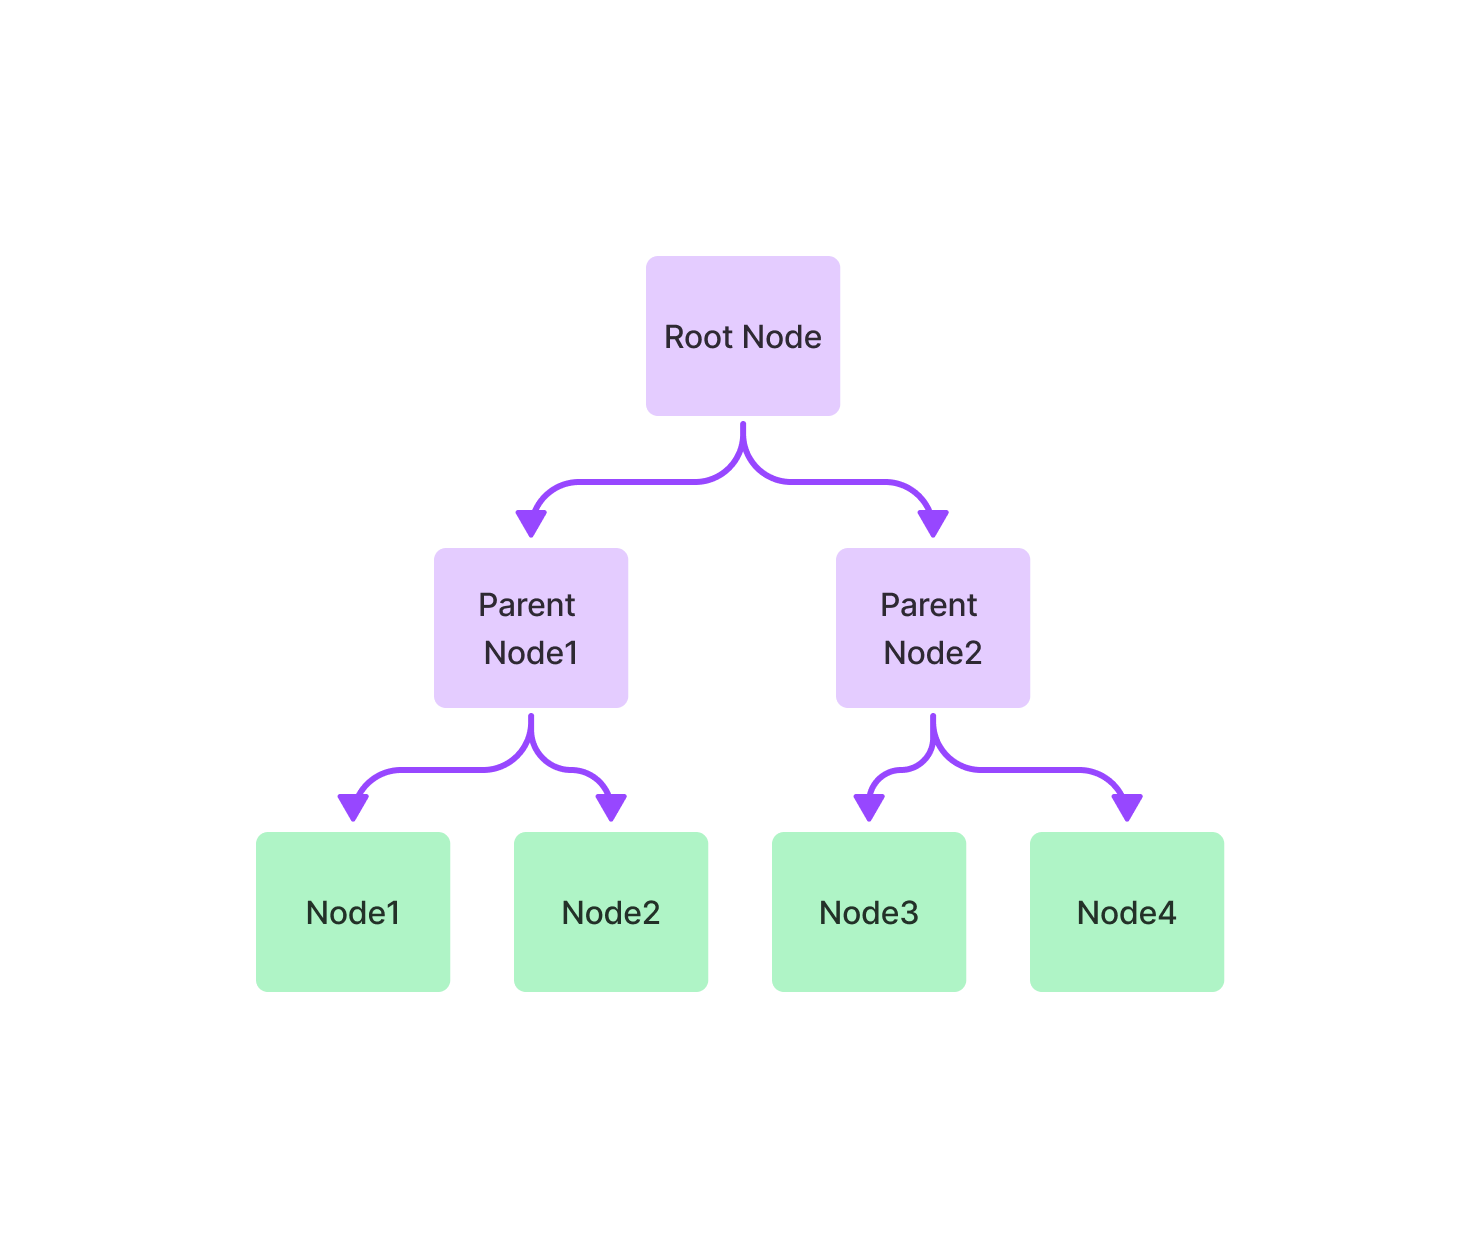
树索引由一组 Nodes 构建出一棵层级树(这些 Node 成为树的叶子节点)。
查询
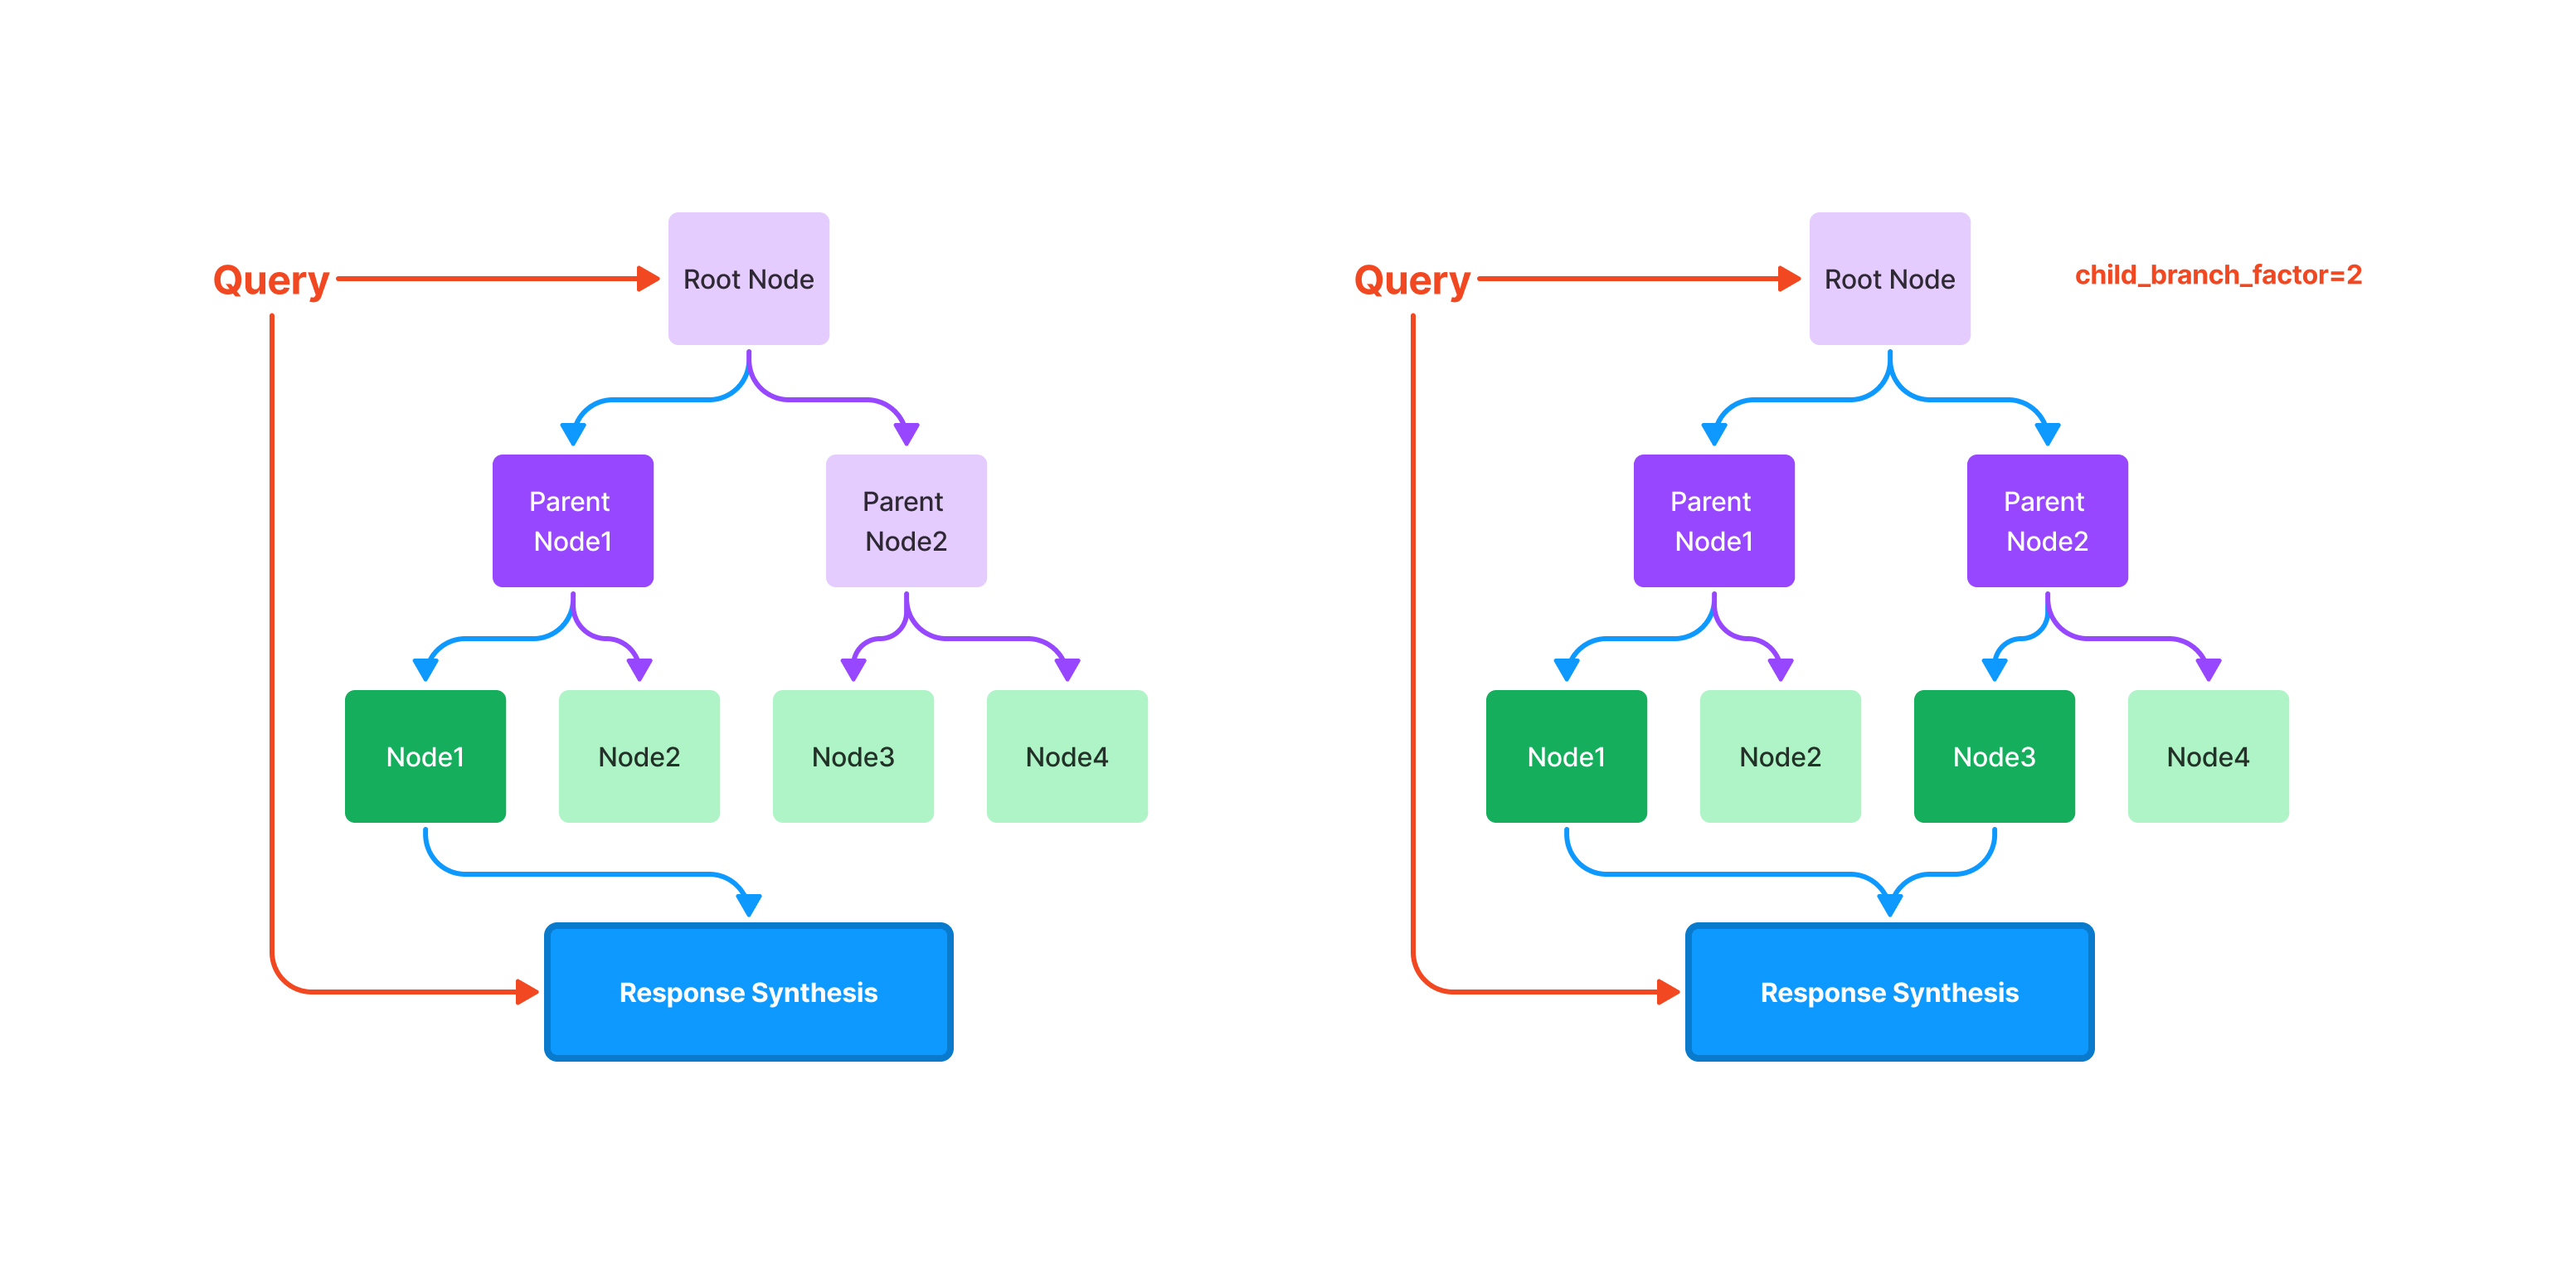
查询树索引时要从根节点往下走到叶子节点。默认(child_branch_factor=1)下,一个查询在每个父节点处选择一个子节点;若 child_branch_factor=2,则每层选择两个子节点。
关键词表索引
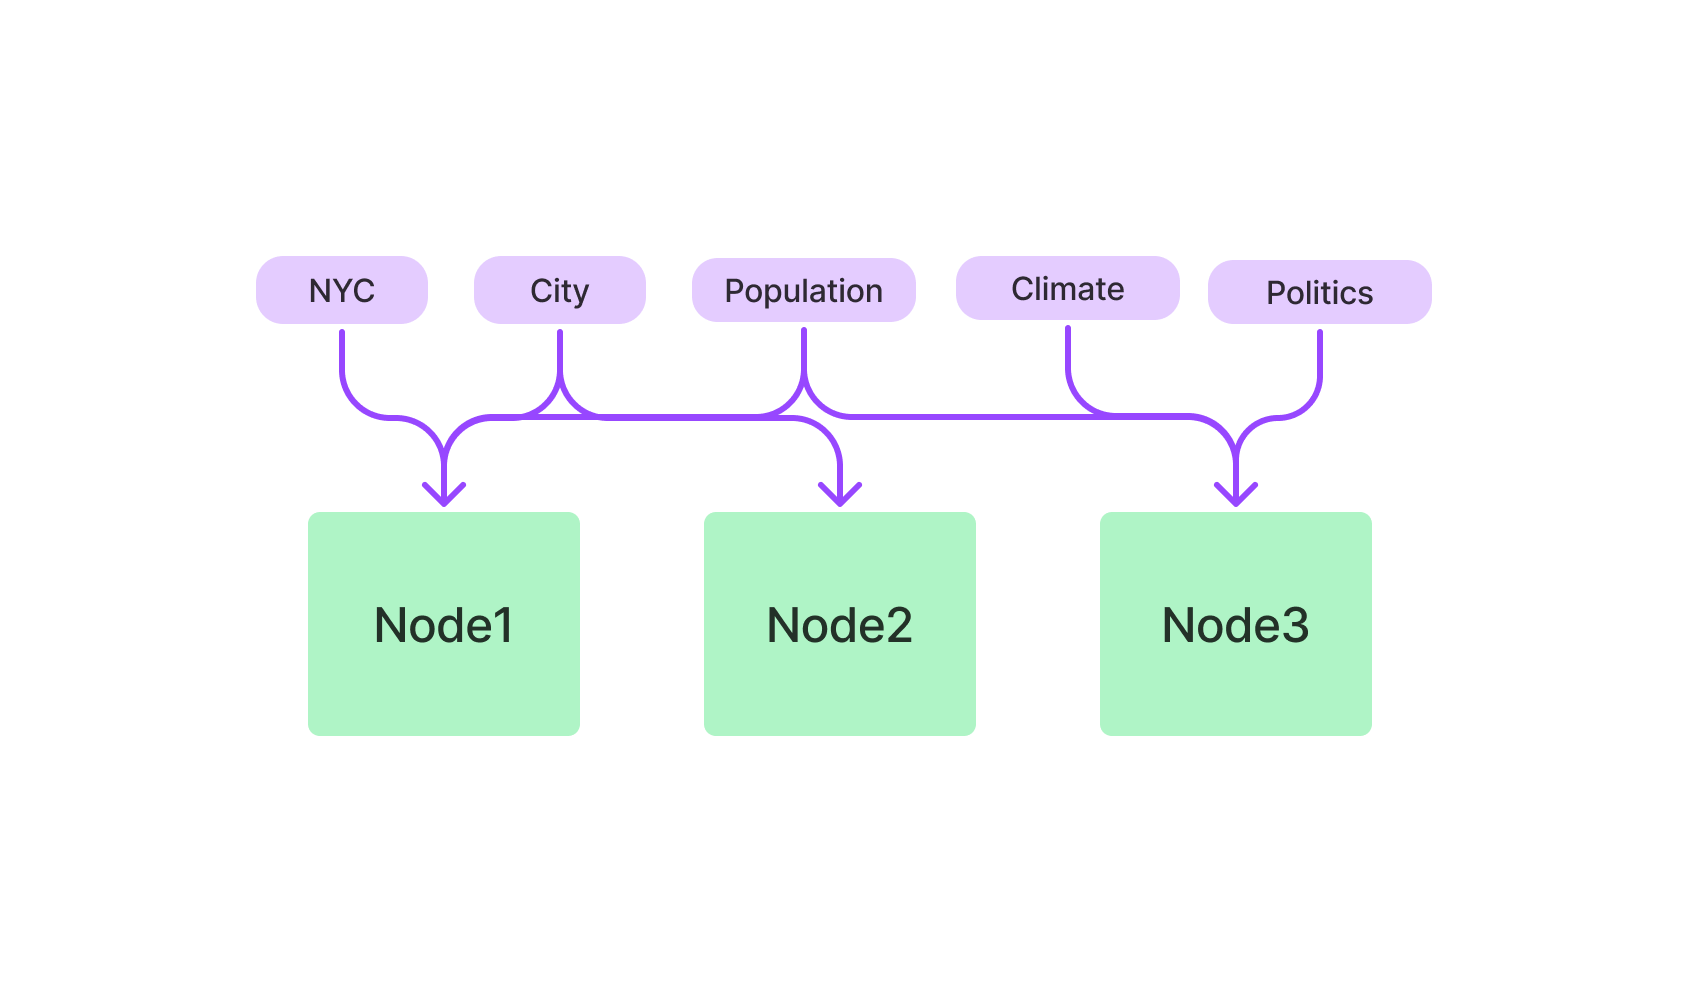
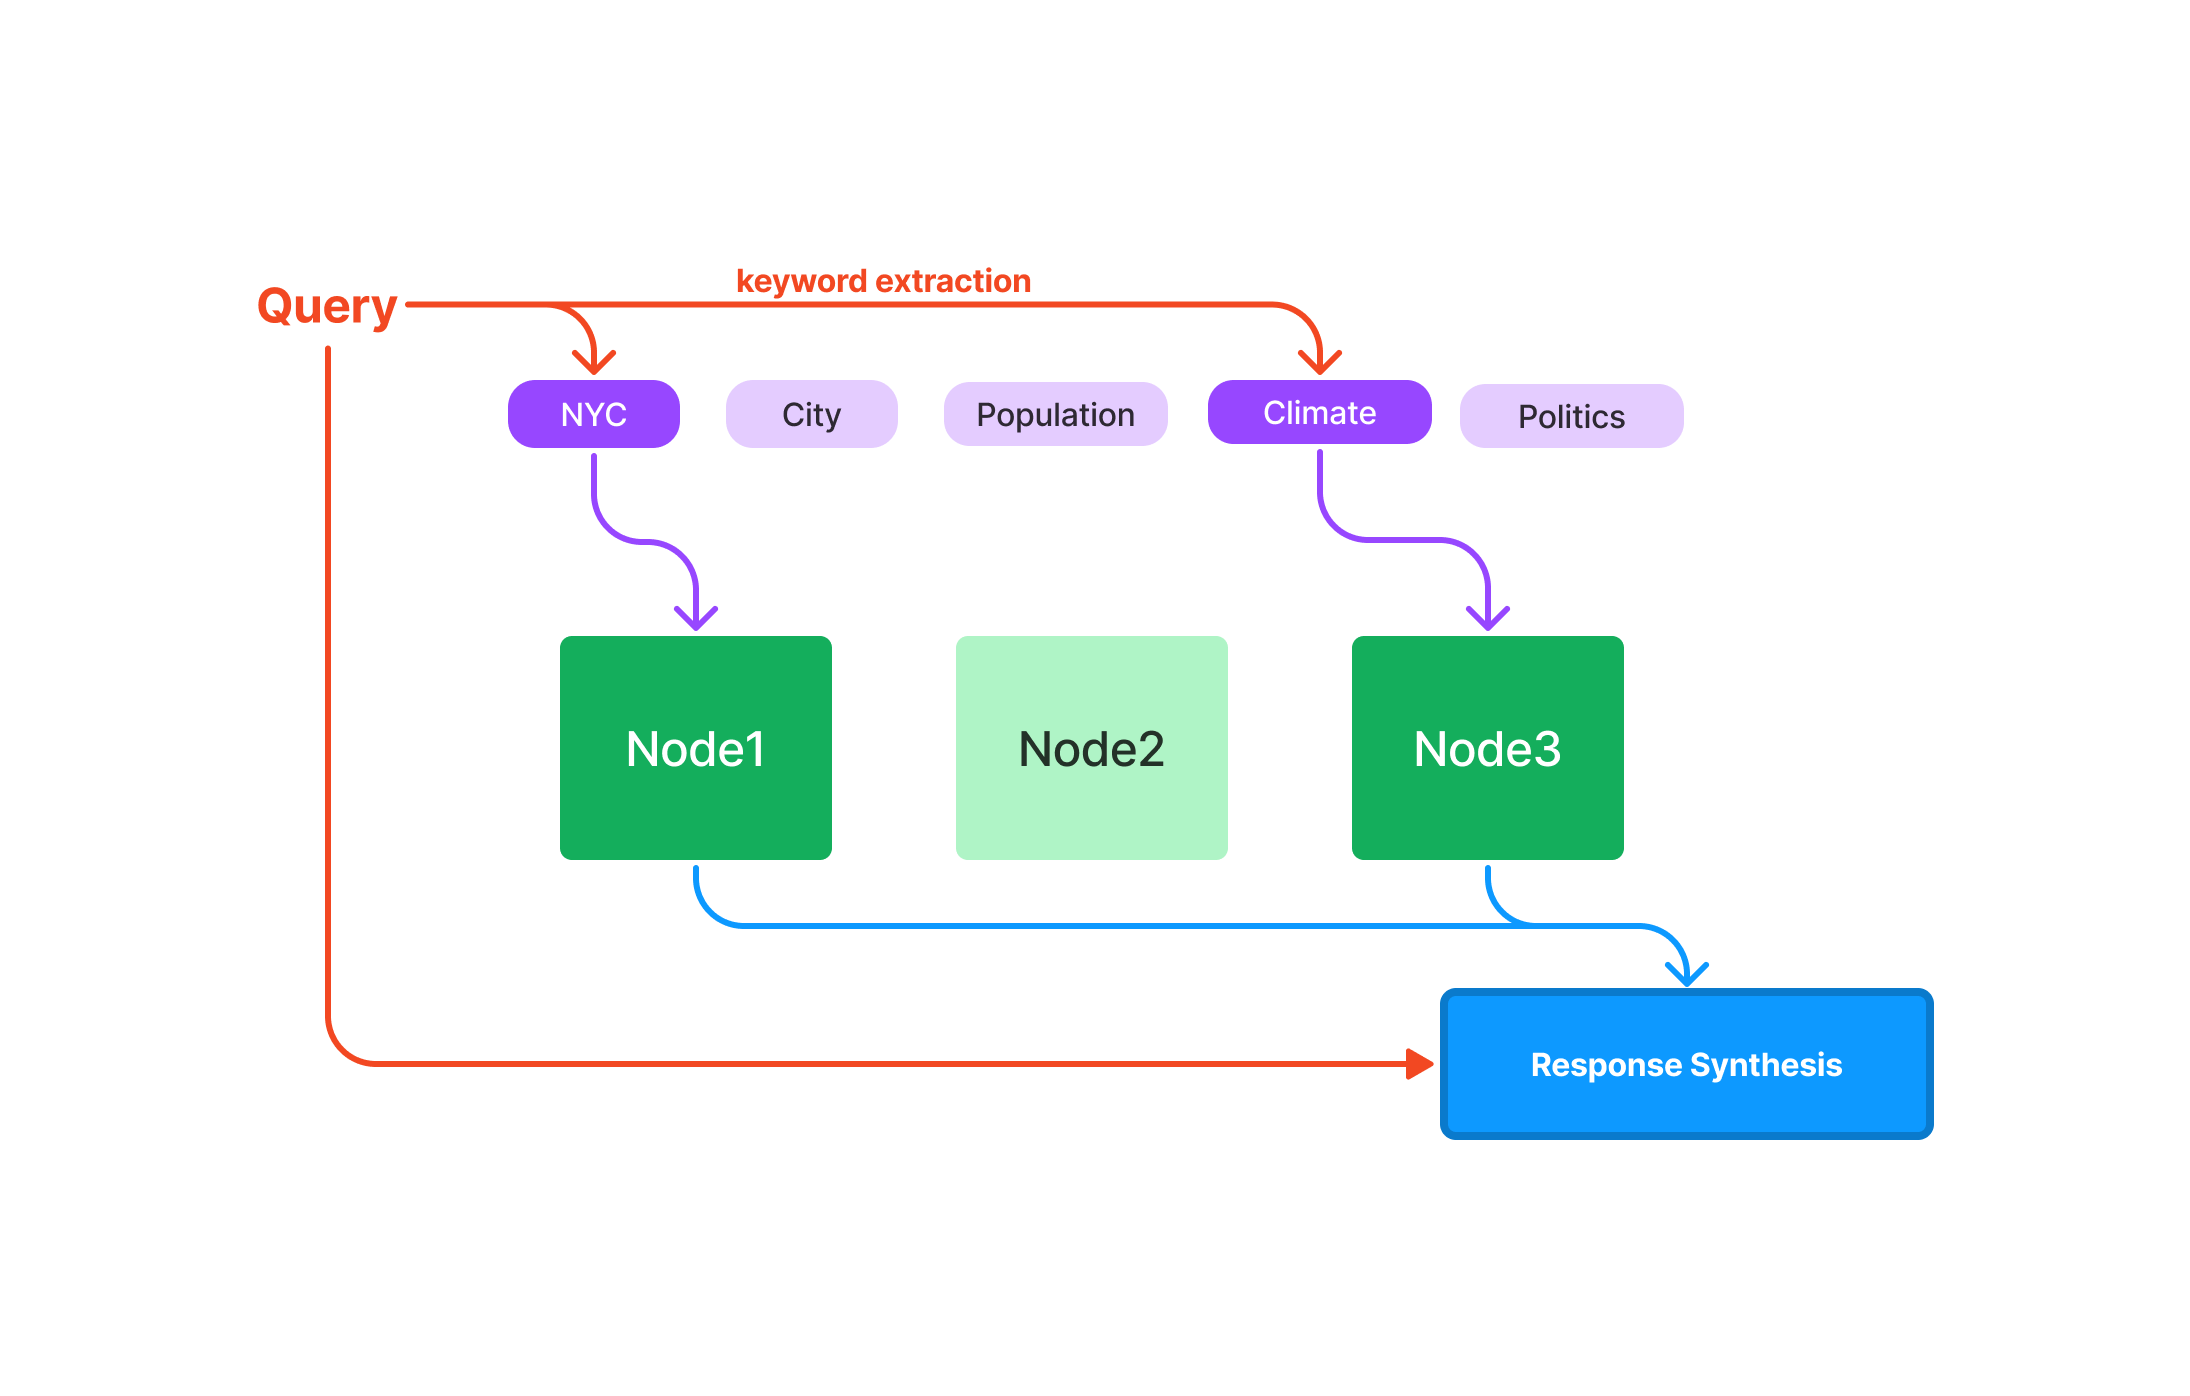
关键词表索引会从每个 Node 抽取关键词,并建立「关键词 → 该关键词对应的 Nodes」的映射。
查询
在查询时,我们从查询本身抽取关键词,并与预先抽取的节点关键词做匹配,取回对应的 Nodes。这些 Node 会被交给响应合成模块。
属性图索引
属性图索引的做法是先构建一张带有标签节点与关系的知识图谱。这张图的构建过程极其可定制:既可以让 LLM 想抽什么就抽什么,也可以按严格 schema 抽取,甚至实现你自己的抽取模块。
也可以选择为节点生成嵌入,以便后续检索。
你还可以跳过创建环节,通过 Neo4j 这类集成直接连到一张已有的知识图谱上。
查询
属性图索引的查询同样非常灵活。检索由若干子检索器协作完成并把结果合并。默认情况下,会使用权重 + 同义词扩展,以及向量检索(如果图已生成嵌入),来取回相关的三元组。
你还可以选择在检索到的三元组之外一并带上源文本(在 LlamaIndex 之外构建的图谱不支持这一点)。
更多内容见属性图完整指南。