
主题
默认情况下,LlamaIndex 把复杂性藏了起来,让你用不到 5 行代码就能查询数据:
from llama_index.core import VectorStoreIndex, SimpleDirectoryReader

documents = SimpleDirectoryReader("data").load_data()
index = VectorStoreIndex.from_documents(documents)
query_engine = index.as_query_engine()
response = query_engine.query("Summarize the documents.")在底层,LlamaIndex 还支持一个可替换的存储层,让你自定义摄取后的文档(即 Node 对象)、嵌入向量与索引元数据存放在哪里。
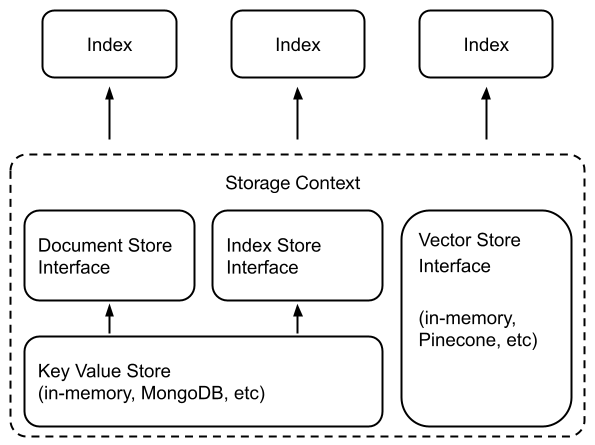
低层 API
要这样做,就不走高层 API,
index = VectorStoreIndex.from_documents(documents)而是使用提供更细粒度控制的低层 API:
from llama_index.core.storage.docstore import SimpleDocumentStore
from llama_index.core.storage.index_store import SimpleIndexStore
from llama_index.core.vector_stores import SimpleVectorStore
from llama_index.core.node_parser import SentenceSplitter

# create parser and parse document into nodes
parser = SentenceSplitter()
nodes = parser.get_nodes_from_documents(documents)

# create storage context using default stores
storage_context = StorageContext.from_defaults(
    docstore=SimpleDocumentStore(),
    vector_store=SimpleVectorStore(),
    index_store=SimpleIndexStore(),
)

# create (or load) docstore and add nodes
storage_context.docstore.add_documents(nodes)

# build index
index = VectorStoreIndex(nodes, storage_context=storage_context)

# save index
index.storage_context.persist(persist_dir="<persist_dir>")

# can also set index_id to save multiple indexes to the same folder
index.set_index_id("<index_id>")
index.storage_context.persist(persist_dir="<persist_dir>")

# to load index later, make sure you setup the storage context
# this will loaded the persisted stores from persist_dir
storage_context = StorageContext.from_defaults(persist_dir="<persist_dir>")

# then load the index object
from llama_index.core import load_index_from_storage

loaded_index = load_index_from_storage(storage_context)

# if loading an index from a persist_dir containing multiple indexes
loaded_index = load_index_from_storage(storage_context, index_id="<index_id>")

# if loading multiple indexes from a persist dir
loaded_indicies = load_index_from_storage(
    storage_context, index_ids=["<index_id>", ...]
)只需一行改动实例化不同的文档存储、索引存储与向量库,就能定制底层存储。更多细节见文档存储、向量库、索引存储三篇指南。
向量库集成与存储
我们大多数向量库集成会把整个索引(向量 + 文本)存进向量库自身。好处就是不必像上面那样显式持久化索引,因为向量库本身就是托管服务、已经在为我们的索引做持久化。
支持这种做法的向量库有:
- AzureAISearchVectorStore
- ChatGPTRetrievalPluginClient
- CassandraVectorStore
- ChromaVectorStore
- EpsillaVectorStore
- DocArrayHnswVectorStore
- DocArrayInMemoryVectorStore
- JaguarVectorStore
- LanceDBVectorStore
- MetalVectorStore
- MilvusVectorStore
- MyScaleVectorStore
- OpensearchVectorStore
- PineconeVectorStore
- QdrantVectorStore
- TablestoreVectorStore
- RedisVectorStore
- UpstashVectorStore
- WeaviateVectorStore
下面是一个用 Pinecone 的小例子:
import pinecone
from llama_index.core import VectorStoreIndex, SimpleDirectoryReader
from llama_index.vector_stores.pinecone import PineconeVectorStore

# Creating a Pinecone index
api_key = "api_key"
pinecone.init(api_key=api_key, environment="us-west1-gcp")
pinecone.create_index(
    "quickstart", dimension=1536, metric="euclidean", pod_type="p1"
)
index = pinecone.Index("quickstart")

# construct vector store
vector_store = PineconeVectorStore(pinecone_index=index)

# create storage context
storage_context = StorageContext.from_defaults(vector_store=vector_store)

# load documents
documents = SimpleDirectoryReader("./data").load_data()

# create index, which will insert documents/vectors to pinecone
index = VectorStoreIndex.from_documents(
    documents, storage_context=storage_context
)如果你已有一个装载好数据的向量库,可以直接连上它并创建 VectorStoreIndex,如下:
index = pinecone.Index("quickstart")
vector_store = PineconeVectorStore(pinecone_index=index)
loaded_index = VectorStoreIndex.from_vector_store(vector_store=vector_store)