主题
这份走查不只讲如何从非结构化文档里抽取结构化信息,还讲这份 schema 一开始该怎么来。LlamaExtract 允许你通过 SDK 或界面定义抽取 schema,也允许你让一个大模型替你生成 schema。
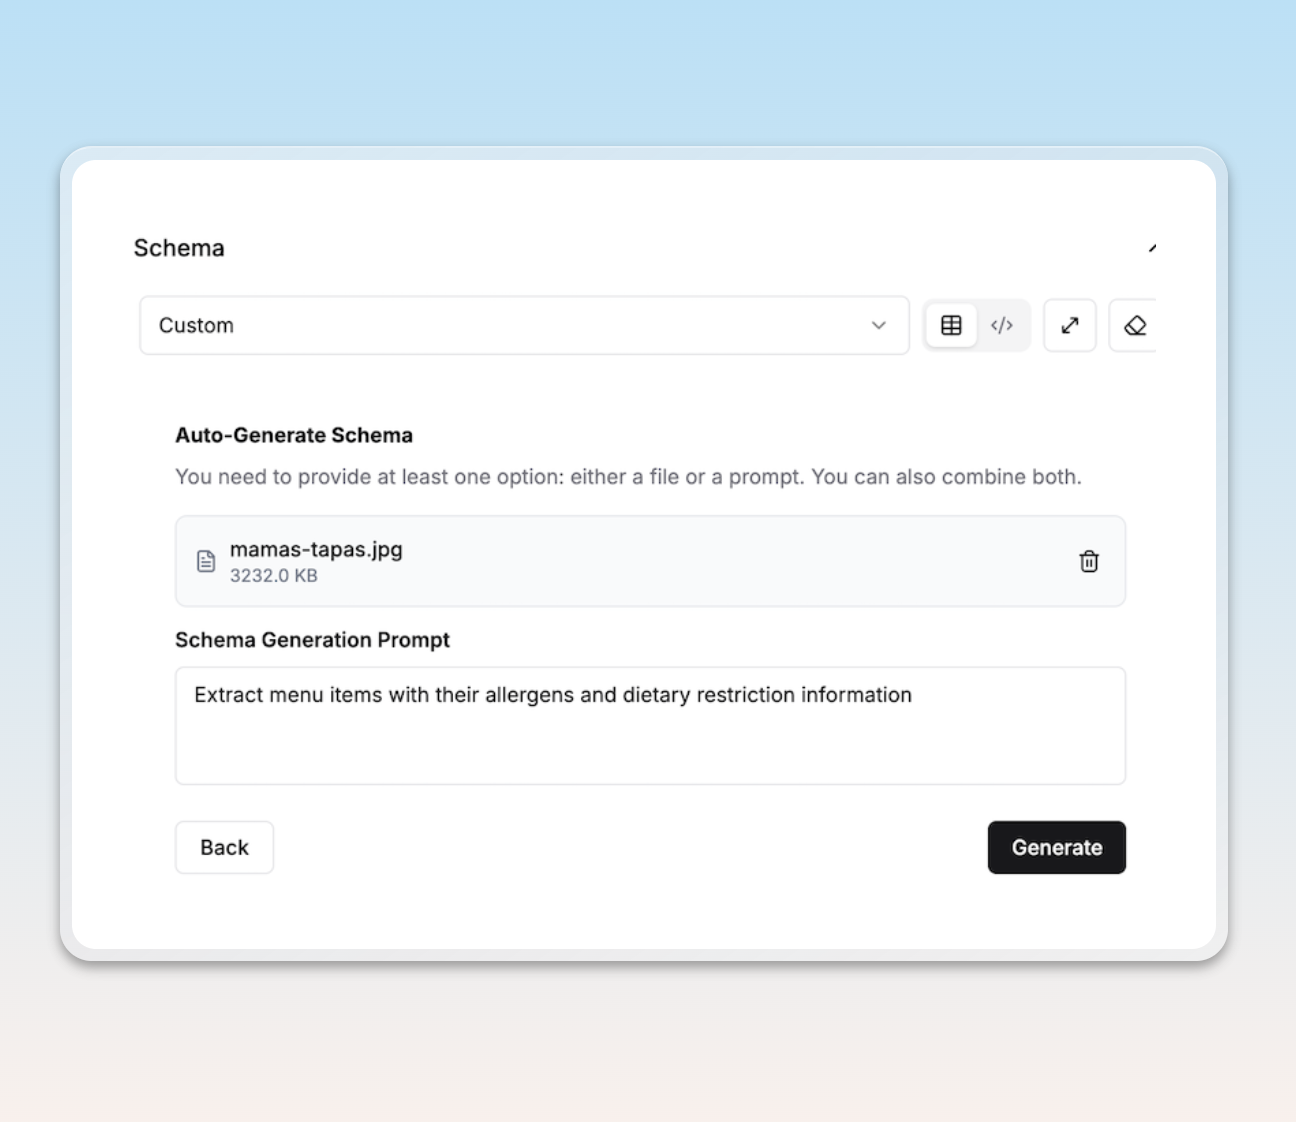
做法是提供下列之一或两者都给:一段简单的提示词描述你要抽什么数据,或者一份你打算从中抽数据的示例文件。
用示例和/或提示词生成 schema
创建抽取配置时,你可以提供:
- 一个文件
- 一段简短的提示词
两者不必都给,但要使用 schema 生成功能,至少得给其中一个。
本例要为菜单生成 schema,目标不只是抽出列出的菜品,还包括过敏原与饮食限制信息 —— 这两者在不同菜单上的呈现方式可能差别很大。
我们从提示词 Extract menu items with their allergens and dietary restriction information 以及一张菜单图片开始:
编辑生成出的 schema
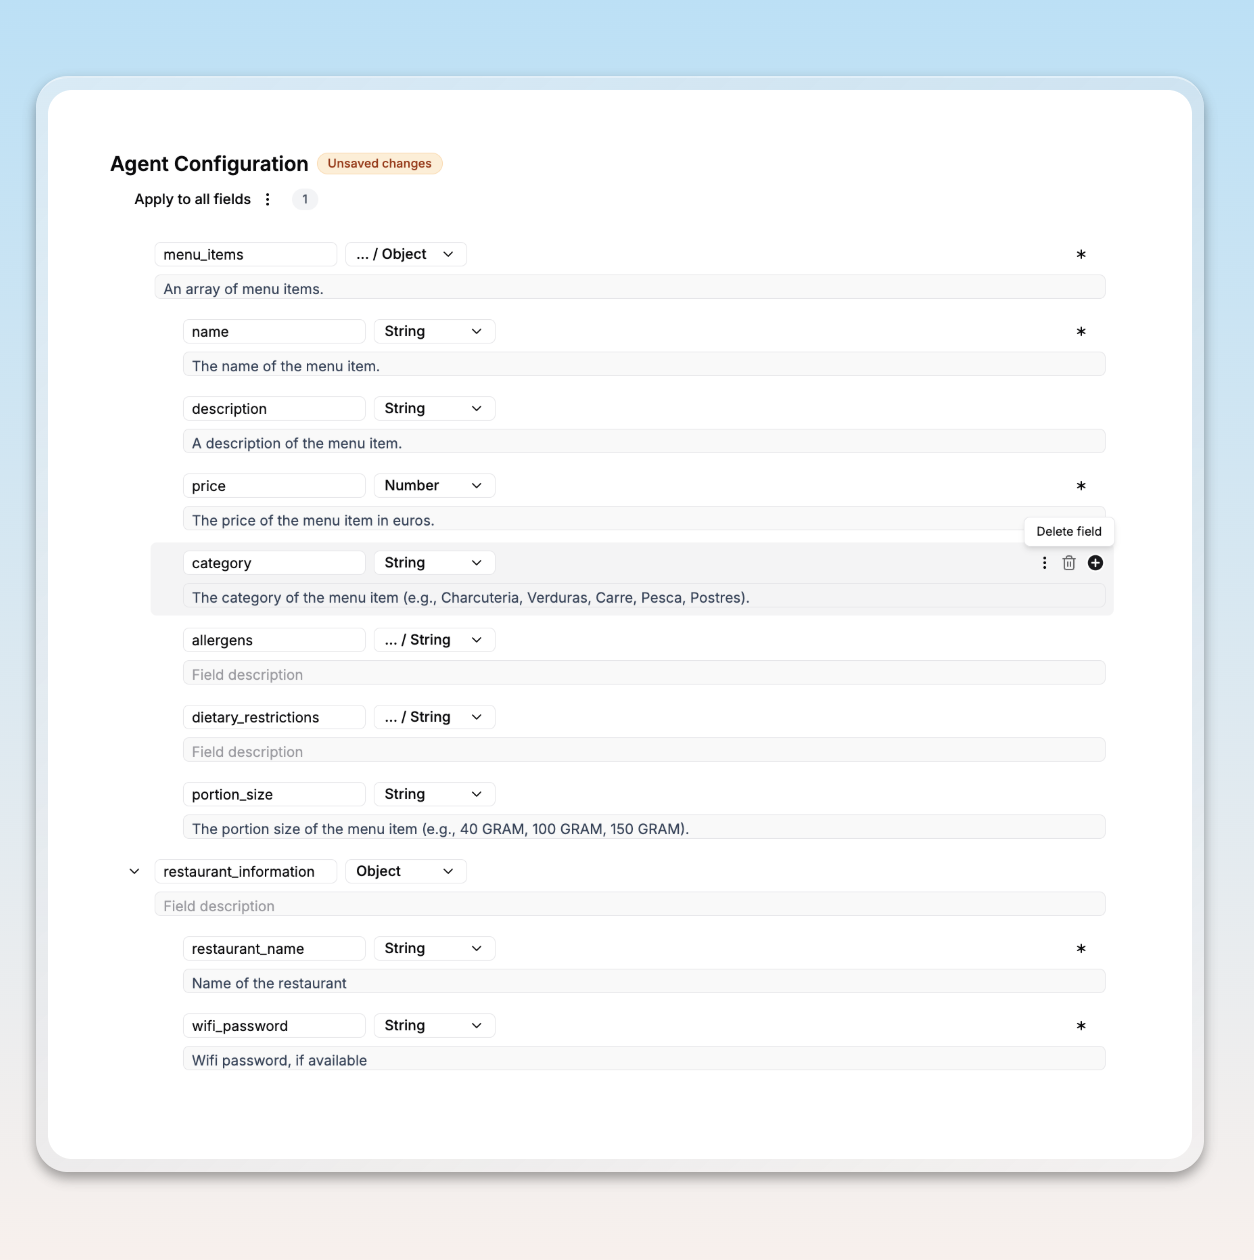
schema 生成后,你可以做最后一轮修改:改字段名、改描述、改是否必填,甚至删除或新增字段。本例我们不关心 category 与 portion_size 这两个字段,就把它们删掉:
发布配置并运行抽取
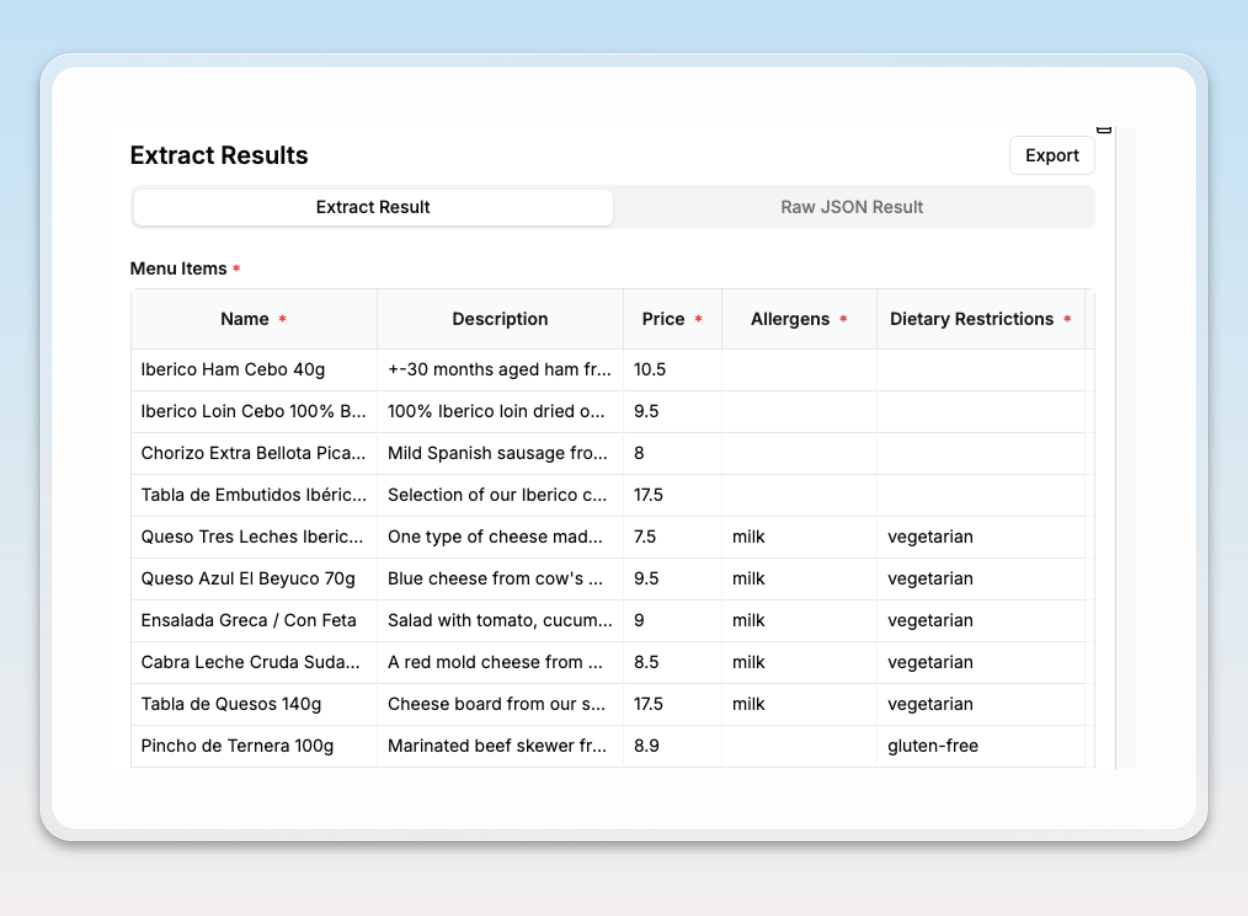
最后,你可以保存这份抽取配置并跑一个抽取任务。本例的抽取结果如下: