
主题
Parse 是 LlamaParse(LlamaIndex 出品的平台)上的文档解析产品。 它为 LLM 流水线而生,能以通用 OCR 与 PDF 转文本工具比不上的版面感知精度,读取表格、图表、扫描页以及 130 多种文件类型 —— 并交给你可直接喂给模型的干净 markdown、纯文本或 JSON。
各团队用 Parse 构建什么
- 金融 RAG —— 解析 10-K、财报与投资人材料里的表格、脚注与图表,且不丢失单元格结构。
- 合规流程 —— 把申报文件、会议记录与政策文档变成干净文本,供自动审阅与标记使用。
- 合同情报 —— 保留章节层级,并用自定义提示词抽取条款。
- 医疗与保险记录 —— 解析扫描的理赔单、化验报告与受理表单,字段抽取可靠。
- 运营单据 —— 从工单、订单、发票与表单里抽取字段,供下游流程使用。
- 科技文献 —— 处理论文与手册里的多栏版式、公式、图表与参考文献。
为什么选 Parse
高质量的文档解析是 LLM 技术栈里最容易被忽视、却也最关键的一步。模型只能就你给它的信息做推理,而现实世界的大多数文档开箱即用都很难读懂:多栏版式、合并的表格单元格、以图片形式嵌入的图表、手写批注、角度歪斜的扫描页。
多数解析器不过是挂在 OCR 引擎上的边界框检测器。 Parse 不一样:它用生成式模型做端到端的文档理解,因此版式、结构、表格、图表与文本都出自同一次推理,而不是靠几十条脆弱的启发式规则再拼回去。这正是它能应付传统解析器会崩掉的复杂真实文档的原因。
Parse 对比:直接把 PDF 塞给 LLM
对一份简短的文档,把原始 PDF 交给多模态模型往往也没问题。但到了规模上就会崩:表格丢结构、扫描页产出噪声很多的 OCR,而 token 成本不管页面内容是否携带有用信息,都随原始页面内容线性增长。Parse 把结构化的工作在上游一次性做完,下游模型看到的就只有干净的、具备版面感知的输入。
5 行完成第一次解析
先下载一份样例 PDF —— 财政服务局的 FY2024 执行摘要,存为 doc.pdf:
终端窗口
curl -fL -o doc.pdf https://fiscal.treasury.gov/system/files/files/reports-statements/financial-report/2024/executive-summary-2024.pdf- Python
- TypeScript
- Go
- Java
- CLI
from llama_cloud import LlamaCloud

client = LlamaCloud()  # reads LLAMA_CLOUD_API_KEY
file = client.files.create(file="doc.pdf", purpose="parse")
result = client.parsing.parse(file_id=file.id, tier="agentic", version="latest", expand=["markdown"])
print(result.markdown.pages[0].markdown)import LlamaCloud from '@llamaindex/llama-cloud';
import fs from 'fs';
const client = new LlamaCloud(); // reads LLAMA_CLOUD_API_KEY
const file = await client.files.create({ file: fs.createReadStream('doc.pdf'), purpose: 'parse' });
const result = await client.parsing.parse({ file_id: file.id, tier: 'agentic', version: 'latest', expand: ['markdown'] });
console.log(result.markdown.pages[0].markdown);package main
import (
"context"
"fmt"
"log"
"os"
"time"
llamacloud "github.com/run-llama/llama-parse-go"
)
func main() {
ctx := context.Background()
client := llamacloud.NewClient() // reads LLAMA_CLOUD_API_KEY
f, err := os.Open("doc.pdf")
if err != nil {
log.Fatal(err)
}
defer f.Close()
file, err := client.Files.New(ctx, llamacloud.FileNewParams{File: f, Purpose: "parse"})
if err != nil {
log.Fatal(err)
}
job, err := client.Parsing.New(ctx, llamacloud.ParsingNewParams{
FileID: llamacloud.String(file.ID),
Tier: llamacloud.ParsingNewParamsTierAgentic,
Version: llamacloud.ParsingNewParamsVersionLatest,
})
if err != nil {
log.Fatal(err)
}
// Poll until the job reaches a terminal status
getParams := llamacloud.ParsingGetParams{Expand: []string{"markdown"}}
result, err := client.Parsing.Get(ctx, job.ID, getParams)
if err != nil {
log.Fatal(err)
}
for result.Job.Status != "COMPLETED" && result.Job.Status != "FAILED" && result.Job.Status != "CANCELLED" {
time.Sleep(2 * time.Second)
result, err = client.Parsing.Get(ctx, job.ID, getParams)
if err != nil {
log.Fatal(err)
}
}
fmt.Println(result.Markdown.Pages[0].Markdown)
}import ai.llamaindex.llamacloud.client.LlamaCloudClient;
import ai.llamaindex.llamacloud.client.okhttp.LlamaCloudOkHttpClient;
import ai.llamaindex.llamacloud.models.files.FileCreateParams;
import ai.llamaindex.llamacloud.models.files.FileCreateResponse;
import ai.llamaindex.llamacloud.models.parsing.ParsingCreateParams;
import ai.llamaindex.llamacloud.models.parsing.ParsingCreateResponse;
import ai.llamaindex.llamacloud.models.parsing.ParsingGetParams;
import ai.llamaindex.llamacloud.models.parsing.ParsingGetResponse;
import java.nio.file.Paths;
public class FirstParse {
public static void main(String[] args) throws Exception {
LlamaCloudClient client = LlamaCloudOkHttpClient.fromEnv(); // reads LLAMA_CLOUD_API_KEY
FileCreateResponse file = client.files().create(FileCreateParams.builder()
.file(Paths.get("doc.pdf"))
.purpose("parse")
.build());
ParsingCreateResponse job = client.parsing().create(ParsingCreateParams.builder()
.fileId(file.id())
.tier(ParsingCreateParams.Tier.AGENTIC)
.version(ParsingCreateParams.Version.LATEST)
.build());
// Poll until the job reaches a terminal status
ParsingGetParams getParams = ParsingGetParams.builder()
.jobId(job.id())
.addExpand("markdown")
.build();
ParsingGetResponse result = client.parsing().get(getParams);
while (!result.job().status().equals(ParsingGetResponse.Job.Status.COMPLETED)
&& !result.job().status().equals(ParsingGetResponse.Job.Status.FAILED)
&& !result.job().status().equals(ParsingGetResponse.Job.Status.CANCELLED)) {
Thread.sleep(2000);
result = client.parsing().get(getParams);
}
System.out.println(result.markdown().get().pages().get(0).asMarkdownResult().markdown());
}
}终端窗口
FILE_ID=$(llp files create --file doc.pdf --purpose parse | jq -r '.id')
JOB_ID=$(llp parsing create --file-id "$FILE_ID" --tier agentic --version latest | jq -r '.id')

# Poll until the job reaches a terminal status
while true; do
  STATUS=$(llp parsing get --job-id "$JOB_ID" | jq -er '.job.status') || break
  case "$STATUS" in COMPLETED|FAILED|CANCELLED) break ;; esac
  sleep 2
done

llp parsing get --job-id "$JOB_ID" --expand markdown | jq -r 'if .job.status == "COMPLETED" then .markdown.pages[0].markdown
else "Parse job failed: \(.job.error_message // .)" end'Python、TypeScript、REST 与 Web 界面的完整配置见 快速上手。
在用 Claude Code、Cursor 或其他编码智能体?
装上 Parse 的智能体技能,你的编码智能体就能在自己的推理过程中随手解析文档:
终端窗口
npx skills add run-llama/llamaparse-agent-skills --skill llamaparse装好之后,你的智能体能解析任意文件、抽取表格、提取图片,而你不必写上一行 SDK 代码。技能与插件 →
核心能力
灵活的档位 —— 为每份任务挑到合适的成本与精度平衡:
- Agentic Plus —— 用最先进的模型,在最难的文档上追求最高精度。
- Agentic —— 面向复杂、视觉丰富文件的高级解析智能体。
- Cost Effective —— 为日常工作负载平衡性能与成本。
- Fast —— 面向海量纯文本文档的最低延迟、最低成本档位;只返回文本与带位置的文本(不返回 markdown)。
完整对比见档位比较 →
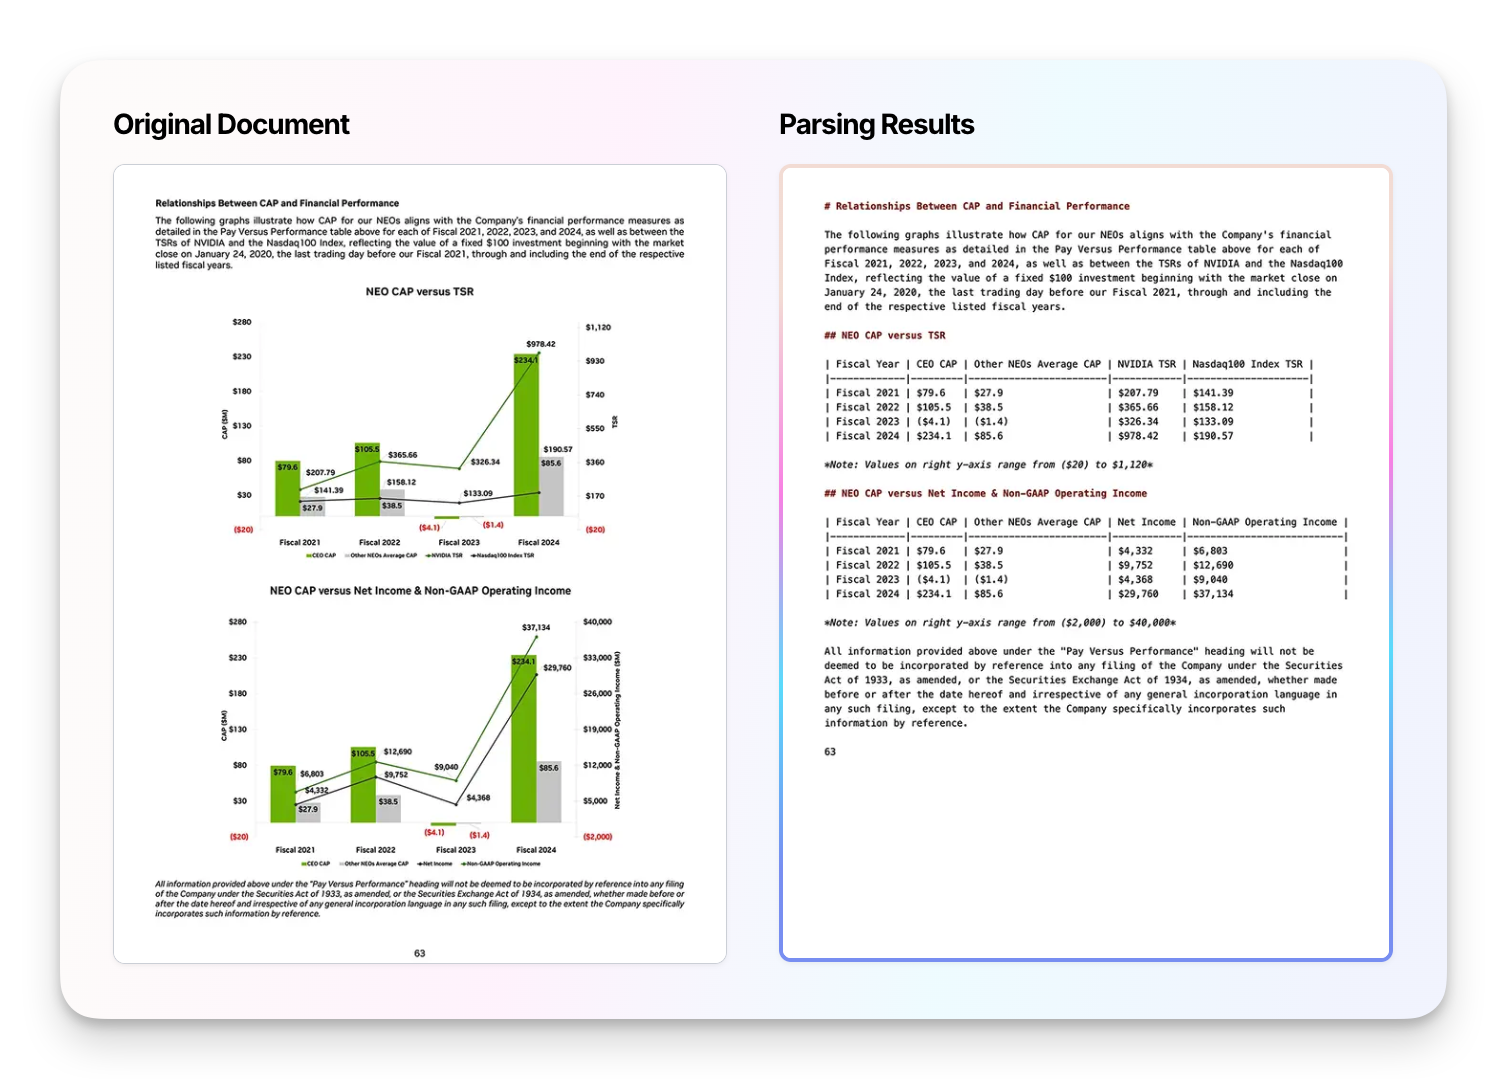
具备版面感知的表格抽取 —— 从 PDF、扫描件与图片中准确还原表格并保留单元格结构,让下游模型与电子表格一次就把数据拿对。
图表与示意图解析 —— 把图表、曲线与示意图抽成结构化数据,让 LLM 能对数字做推理,而不只是对着像素猜。
自定义提示词与输出 schema —— 用自然语言指令或结构化的输出 schema 来引导解析器,让结果贴合你的流水线。
Cost Optimizer —— 只为真正需要的页面付高级价。 Parse 会自动把文档里的每一页路由到合适的档位:简单页面走更便宜的
cost_effective档,复杂页面(表格、图表、多栏版式、示意图)留在你的高级档,两者并行运行故没有额外延迟代价。了解更多 →130 多种文件类型 —— PDF、DOCX、PPTX、XLSX、HTML、JPEG、PNG、XML、EPUB,以及更多类型 →。
可上生产 —— 自动缓存、webhook、页级控制,以及可钉版本的档位,便于在生产里复现输出。
工作流
接入你的文档 通过我们的 API、SDK 或 Web 界面上传或流式传入文档 —— 面向企业数据源自带连接器。
配置解析方式 想快速起步就挑一个档位;要贴合你的用例,则可以自定义配置,指定具体模型、输出形态与解析指令。
拿到干净的结构化结果 收到的解析输出可被流水线直接消费 —— 完整清单见输出选项。