
主题
什么是工作流?
工作流是一种事件驱动、以步骤为单位的应用执行流控制方式。
你的应用被划分成一个个称为步骤的片段。一个步骤接收一个事件、做些工作,然后返回另一个事件。返回的这个事件会触发下一个「类型注解恰好接收它」的步骤。
模型的全部内容就这些。一个步骤可以调用 LLM、执行检索、请求人工输入、更新共享状态,或者派发一批工作。事件类型描述工作流的边,而每条边内部的逻辑就是普通的 Python。
为什么用工作流?
随着生成式 AI 应用越来越复杂,管理数据流向、掌控应用执行变得越来越难。工作流把这些复杂性拆成更小、更易管理的片段,从而让你驾驭它。
其他框架以及 LlamaIndex 自己都曾尝试用有向无环图(DAG)来解决这个问题,但 DAG 有一些工作流所没有的限制:
- 循环、分支这类逻辑要编码进图的边里,这让图很难读懂、理解。
- 在 DAG 的节点之间传递数据,会围绕「可选值与默认值」「该传哪些参数」产生额外复杂性。
- 对要开发复杂、带循环与分支的 AI 应用的开发者来说,DAG 用起来并不自然。
工作流的事件驱动模式加上纯 Python 的写法解决了这些问题。
分支就是返回不同事件类型的普通 if 语句。循环就是返回「更早步骤所处理事件」的步骤。并发工作是一个返回 list[Event] 的步骤,再配上一个接收 list[Event] 的步骤。当流程需要变为动态时,你可以直接从 Context 发送事件。
注意
Workflows 库可以单独安装:pip install llama-index-workflows。不过 llama-index-core 本身就已附带安装了 Workflows。
为了保持 llama_index API 稳定、避免破坏性变更,在安装 llama-index-core 或 llama-index 汇总包时,可以通过导入路径 llama_index.core.workflow 来访问 Workflows。
开始使用
提示
Workflows 把 async 当作一等公民,本页也假定你运行在异步环境中。对你而言,这意味着要把代码正确地按异步方式组织。如果你已经运行在 FastAPI 这类服务端或 notebook 里,你本来就可以自由使用 await!
如果你在跑自己的 Python 脚本,最佳实践是保留一个唯一的异步入口。
async def main():
    w = MyWorkflow(...)
    result = await w.run(...)
    print(result)

if __name__ == "__main__":
    import asyncio

asyncio.run(main())下面是最小的可用形态:先生成点东西,把它传给另一个步骤,最后带着结果结束。
from workflows import Workflow, step
from workflows.events import (
    Event,
    StartEvent,
    StopEvent,
)

# `pip install llama-index-llms-openai` if you don't already have it
from llama_index.llms.openai import OpenAI

class JokeEvent(Event):
    joke: str

class JokeFlow(Workflow):
    llm = OpenAI(model="gpt-4.1")

    @step
    async def generate_joke(self, ev: StartEvent) -> JokeEvent:
        topic = ev.topic

        prompt = f"Write your best joke about {topic}."
        response = await self.llm.acomplete(prompt)
        return JokeEvent(joke=str(response))

    @step
    async def critique_joke(self, ev: JokeEvent) -> StopEvent:
        joke = ev.joke

        prompt = f"Give a thorough analysis and critique of the following joke: {joke}"
        response = await self.llm.acomplete(prompt)
        return StopEvent(result=str(response))

w = JokeFlow(timeout=60, verbose=False)
result = await w.run(topic="pirates")
print(str(result))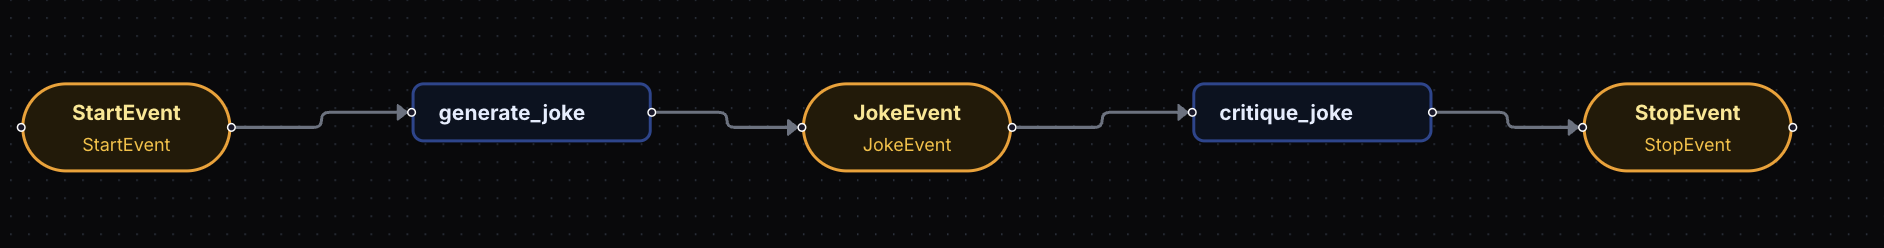
这里有好几个活动部件,我们逐个来看。
定义工作流事件
class JokeEvent(Event):
joke: str事件是由用户定义的 Pydantic 对象。属性以及其他辅助方法都由你来掌控。在这个例子里,工作流只依赖一个自定义事件,即 JokeEvent。
准备工作流类
class JokeFlow(Workflow):
    llm = OpenAI(model="gpt-4.1")
...我们的工作流通过继承 Workflow 类实现。为了简单起见,我们挂了一个静态的 OpenAI LLM 实例。
工作流的入口
class JokeFlow(Workflow):
    ...

    @step
    async def generate_joke(self, ev: StartEvent) -> JokeEvent:
        topic = ev.topic

        prompt = f"Write your best joke about {topic}."
        response = await self.llm.acomplete(prompt)
        return JokeEvent(joke=str(response))

...这里来到工作流的入口。大多数事件都由用户定义,但框架内置了两种特殊情况:StartEvent 与 StopEvent。这里 StartEvent 指明初始工作流输入要发往何处。
StartEvent 有点特殊,因为它可以携带任意属性。这里我们用 ev.topic 取主题,若该属性不存在就会报错。你也可以用 ev.get("topic"),在属性可能缺失时避免抛错。
想要进一步的类型安全,你还可以继承 StartEvent 来做子类化。
到这里你可能已经注意到,我们并没有显式告诉工作流「哪个事件由哪个步骤处理」。相反,@step 装饰器会推断每个步骤的输入与输出类型。而且这些推断出的输入输出类型还会在运行前替你校验工作流是否合法!
工作流的出口
class JokeFlow(Workflow):
    ...

    @step
    async def critique_joke(self, ev: JokeEvent) -> StopEvent:
        joke = ev.joke

        prompt = f"Give a thorough analysis and critique of the following joke: {joke}"
        response = await self.llm.acomplete(prompt)
        return StopEvent(result=str(response))

...这是我们工作流中的第二个、也是最后一个步骤。之所以知道它是最后一步,是因为它返回了特殊的 StopEvent。当工作流遇到返回的 StopEvent,就会立即停止,并返回我们放在 result 参数里的内容。
这里的结果是一个字符串,但它可以是字典、列表或任意其他对象。
你也可以子类化 StopEvent 类以获得进一步的类型安全。
运行工作流
w = JokeFlow(timeout=60, verbose=False)
result = await w.run(topic="pirates")
print(str(result))最后,我们创建并运行工作流。其中有一些设置,比如超时(秒)与 verbose,有助于调试。
.run() 方法启动工作流并返回一个 WorkflowHandler。该 handler 可以被 await,因此 await w.run(...) 会等待最终结果。如果你需要在工作流运行期间拿到流式事件,请把 handler 保留下来:
handler = w.run(topic="pirates")
async for ev in handler.stream_events():
    ...
result = await handler传给 run() 的关键字参数会成为那个特殊 StartEvent 的字段,而该事件会自动发出以启动工作流。正如前面所见,这里 topic 是通过步骤中的 ev.topic 取到的。
如何选择合适的 API
多数工作流代码都应使用带类型的步骤输入与带类型的返回值。这样能带来校验、图示以及可读性:
@step
async def retrieve(self, ev: StartEvent) -> Retrieved:
    ...

@step
async def synthesize(self, ev: Retrieved) -> StopEvent:
...当工作的形态需要时,再使用其他 API:
| 使用这个 | 适用情形 |
|---|---|
| 返回 `A | B` |
接收 list[A] | 步骤在继续之前需要完整批次的结果。 |
返回 list[A] | 步骤拥有有限批次,能在下游 worker 开始前把所有工作项都产出。 |
ctx.send_event(...) | 步骤需要逐个发出事件、发出数量未知的事件,或在工作流运行期间从外部发送事件。 |
ctx.collect_events(...) | 你用了 ctx.send_event,需要手工等待一组已知的事件。 |
ctx.store | 步骤需要共享的单次运行状态。 |
Resource(...) | 步骤需要客户端、索引、模型、配置等不应放进序列化状态的依赖。 |
以类型为先的 API 更容易校验与可视化。基于 context 的 API 更灵活,但也让你自己承担更多的簿记工作。
校验
在工作流运行之前,Workflows 会校验由步骤签名所描述的事件图。它会检查起始与结束事件存在、被产出的事件有消费者、被消费的事件有生产者,并且图中不含意外的死路。
多数校验失败其实是有价值的设计反馈。它们通常意味着以下情况之一成立:
| 症状 | 常见原因 |
|---|---|
| 某步骤消费了一个从未被产生的事件 | 缺少返回类型注解,或该事件只用 ctx.send_event 动态发送。 |
| 某步骤产生的事件没有人消费 | 下一个步骤的事件类型写错了,或这条分支尚未完成。 |
| 工作流没有终止事件 | 没有可达的步骤返回 StopEvent 或自定义的 StopEvent 子类。 |
对于有意做成动态的工作流,请尽量把内容留在类型注解里,只用 ctx.send_event 控制时机。如果某个步骤是有意无法被静态分析发现的,可以在该步骤上跳过这一项检查:
@step(skip_graph_checks=["reachability"])
async def receive_webhook(self, ev: WebhookEvent) -> StopEvent:
...你也可以在测试或启动代码里直接调用 workflow.validate()。资源配置文件默认会被校验;资源工厂只有在你调用 validate(validate_resources=True) 时才会被解析。
示例
为了帮你熟悉工作流的概念与特性,LlamaIndex 文档提供了可直接运行的示例 notebook,供你动手学习:
- 常用工作流模式 带你走一遍用简单工作流实现循环、状态管理等常见用法,通常是最好的起点。
- RAG + 重排 用一个相当简单的工作流实现摄取与查询,展示真实场景的落地方式。
- 引用溯源查询引擎 与 RAG + 重排类似,但重点在于如何在检索与生成之间实现中间步骤。也是在工作流里使用
Context对象的好例子。 - 纠正式 RAG 在 RAG 工作流之上再加一点复杂度,演示如何在一步评估之后去查询网页搜索引擎。
- 利用并发 讲解如何管理工作流中步骤的并行执行——当工作流复杂度上升时,这是必须了解的。
RAG 应用容易理解,也是学习工作流基础的好机会。不过,涉及工具调用、记忆与路由的更复杂智能体场景,才是工作流真正擅长的地方。
下面的示例正是这些场景的体现。
- ReAct Agent 显然是在工作流中实现工具的最佳范例。
- Function Calling Agent 很好地演示了如何在工作流中使用 LlamaIndex 框架原语,即便在函数调用这类复杂场景里也能保持小巧整洁。
- CodeAct Agent 是从零创建 CodeAct Agent 的好例子。
- 人在环路:故事编织 是一个有力示例,展示工作流运行如何做到可交互且有状态——这里用于收集人的输入。
- 可靠的结构化生成 演示如何在工作流中实现循环,这里是通过反思来改进结构化输出。
- 用工作流做查询规划 是一个把查询拆解为更小的条目并逐条执行的工作流示例。它展示了如何从工作流流式输出事件、并行执行步骤,以及循环直到满足条件。
- 编写持久化工作流 演示如何对工作流上下文做检查点,并在重启后恢复运行。
最后但同样重要的是,还有若干更进阶的用例。当你需要快速实现原型(例如复现论文方法)时,它们能说明工作流有多顺手: