
主题
使用 BaseEvaluator
LlamaIndex 中所有评估模块都实现了 BaseEvaluator 类,它有两个主要方法:
evaluate方法接收query、contexts、response以及额外的关键字参数。
    def evaluate(
        self,
        query: Optional[str] = None,
        contexts: Optional[Sequence[str]] = None,
        response: Optional[str] = None,
        **kwargs: Any,
) -> EvaluationResult:evaluate_response方法提供另一种接口:它接收一个 llamaindex 的Response对象(其中包含回答字符串与来源节点),而不是分开传入contexts与response。
def evaluate_response(
    self,
    query: Optional[str] = None,
    response: Optional[Response] = None,
    **kwargs: Any,
) -> EvaluationResult:它在功能上与 evaluate 完全相同,只是当你直接操作 llamaindex 对象时更省事。
使用 EvaluationResult
每个评估器执行后都会输出一个 EvaluationResult:
eval_result = evaluator.evaluate(query=..., contexts=..., response=...)
eval_result.passing  # binary pass/fail
eval_result.score  # numerical score
eval_result.feedback # string feedback不同的评估器可能只填写其中一部分结果字段。
评估响应的忠实度(即是否有幻觉)
FaithfulnessEvaluator 评估回答是否忠实于检索到的上下文(换句话说,是否存在幻觉)。
from llama_index.core import VectorStoreIndex
from llama_index.llms.openai import OpenAI
from llama_index.core.evaluation import FaithfulnessEvaluator

# create llm
llm = OpenAI(model="gpt-4", temperature=0.0)

# build index
...

# define evaluator
evaluator = FaithfulnessEvaluator(llm=llm)

# query index
query_engine = vector_index.as_query_engine()
response = query_engine.query(
    "What battles took place in New York City in the American Revolution?"
)
eval_result = evaluator.evaluate_response(response=response)
print(str(eval_result.passing))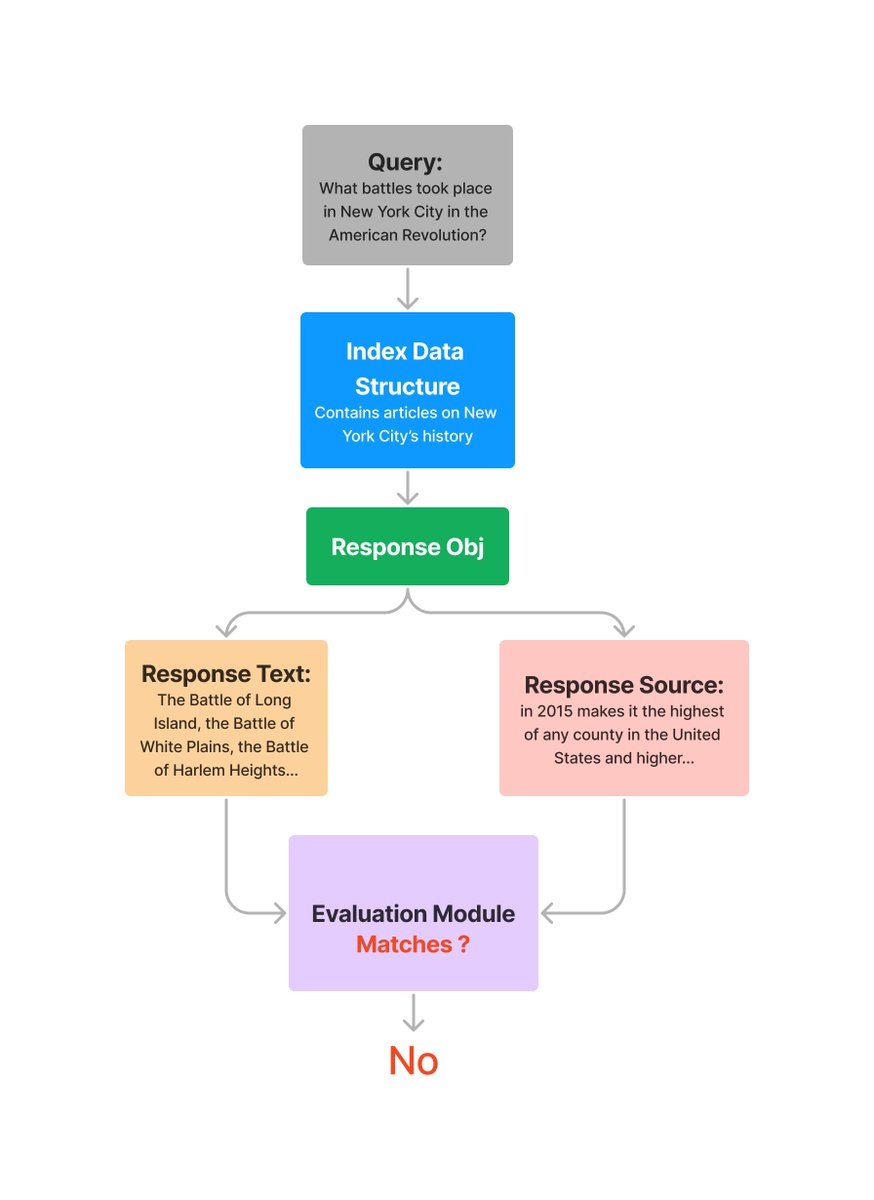
你也可以选择对每个来源上下文分别评估:
from llama_index.core import VectorStoreIndex
from llama_index.llms.openai import OpenAI
from llama_index.core.evaluation import FaithfulnessEvaluator

# create llm
llm = OpenAI(model="gpt-4", temperature=0.0)

# build index
...

# define evaluator
evaluator = FaithfulnessEvaluator(llm=llm)

# query index
query_engine = vector_index.as_query_engine()
response = query_engine.query(
    "What battles took place in New York City in the American Revolution?"
)
response_str = response.response
for source_node in response.source_nodes:
    eval_result = evaluator.evaluate(
        response=response_str, contexts=[source_node.get_content()]
    )
print(str(eval_result.passing))你会拿到一个结果列表,与 response.source_nodes 中的每个来源节点一一对应。
评估「查询 + 回答」的相关性
RelevancyEvaluator 评估针对给定查询,检索到的上下文与回答是否相关且一致。
请注意,除了 Response 对象,这个评估器还要求传入 query。
from llama_index.core import VectorStoreIndex
from llama_index.llms.openai import OpenAI
from llama_index.core.evaluation import RelevancyEvaluator

# create llm
llm = OpenAI(model="gpt-4", temperature=0.0)

# build index
...

# define evaluator
evaluator = RelevancyEvaluator(llm=llm)

# query index
query_engine = vector_index.as_query_engine()
query = "What battles took place in New York City in the American Revolution?"
response = query_engine.query(query)
eval_result = evaluator.evaluate_response(query=query, response=response)
print(str(eval_result))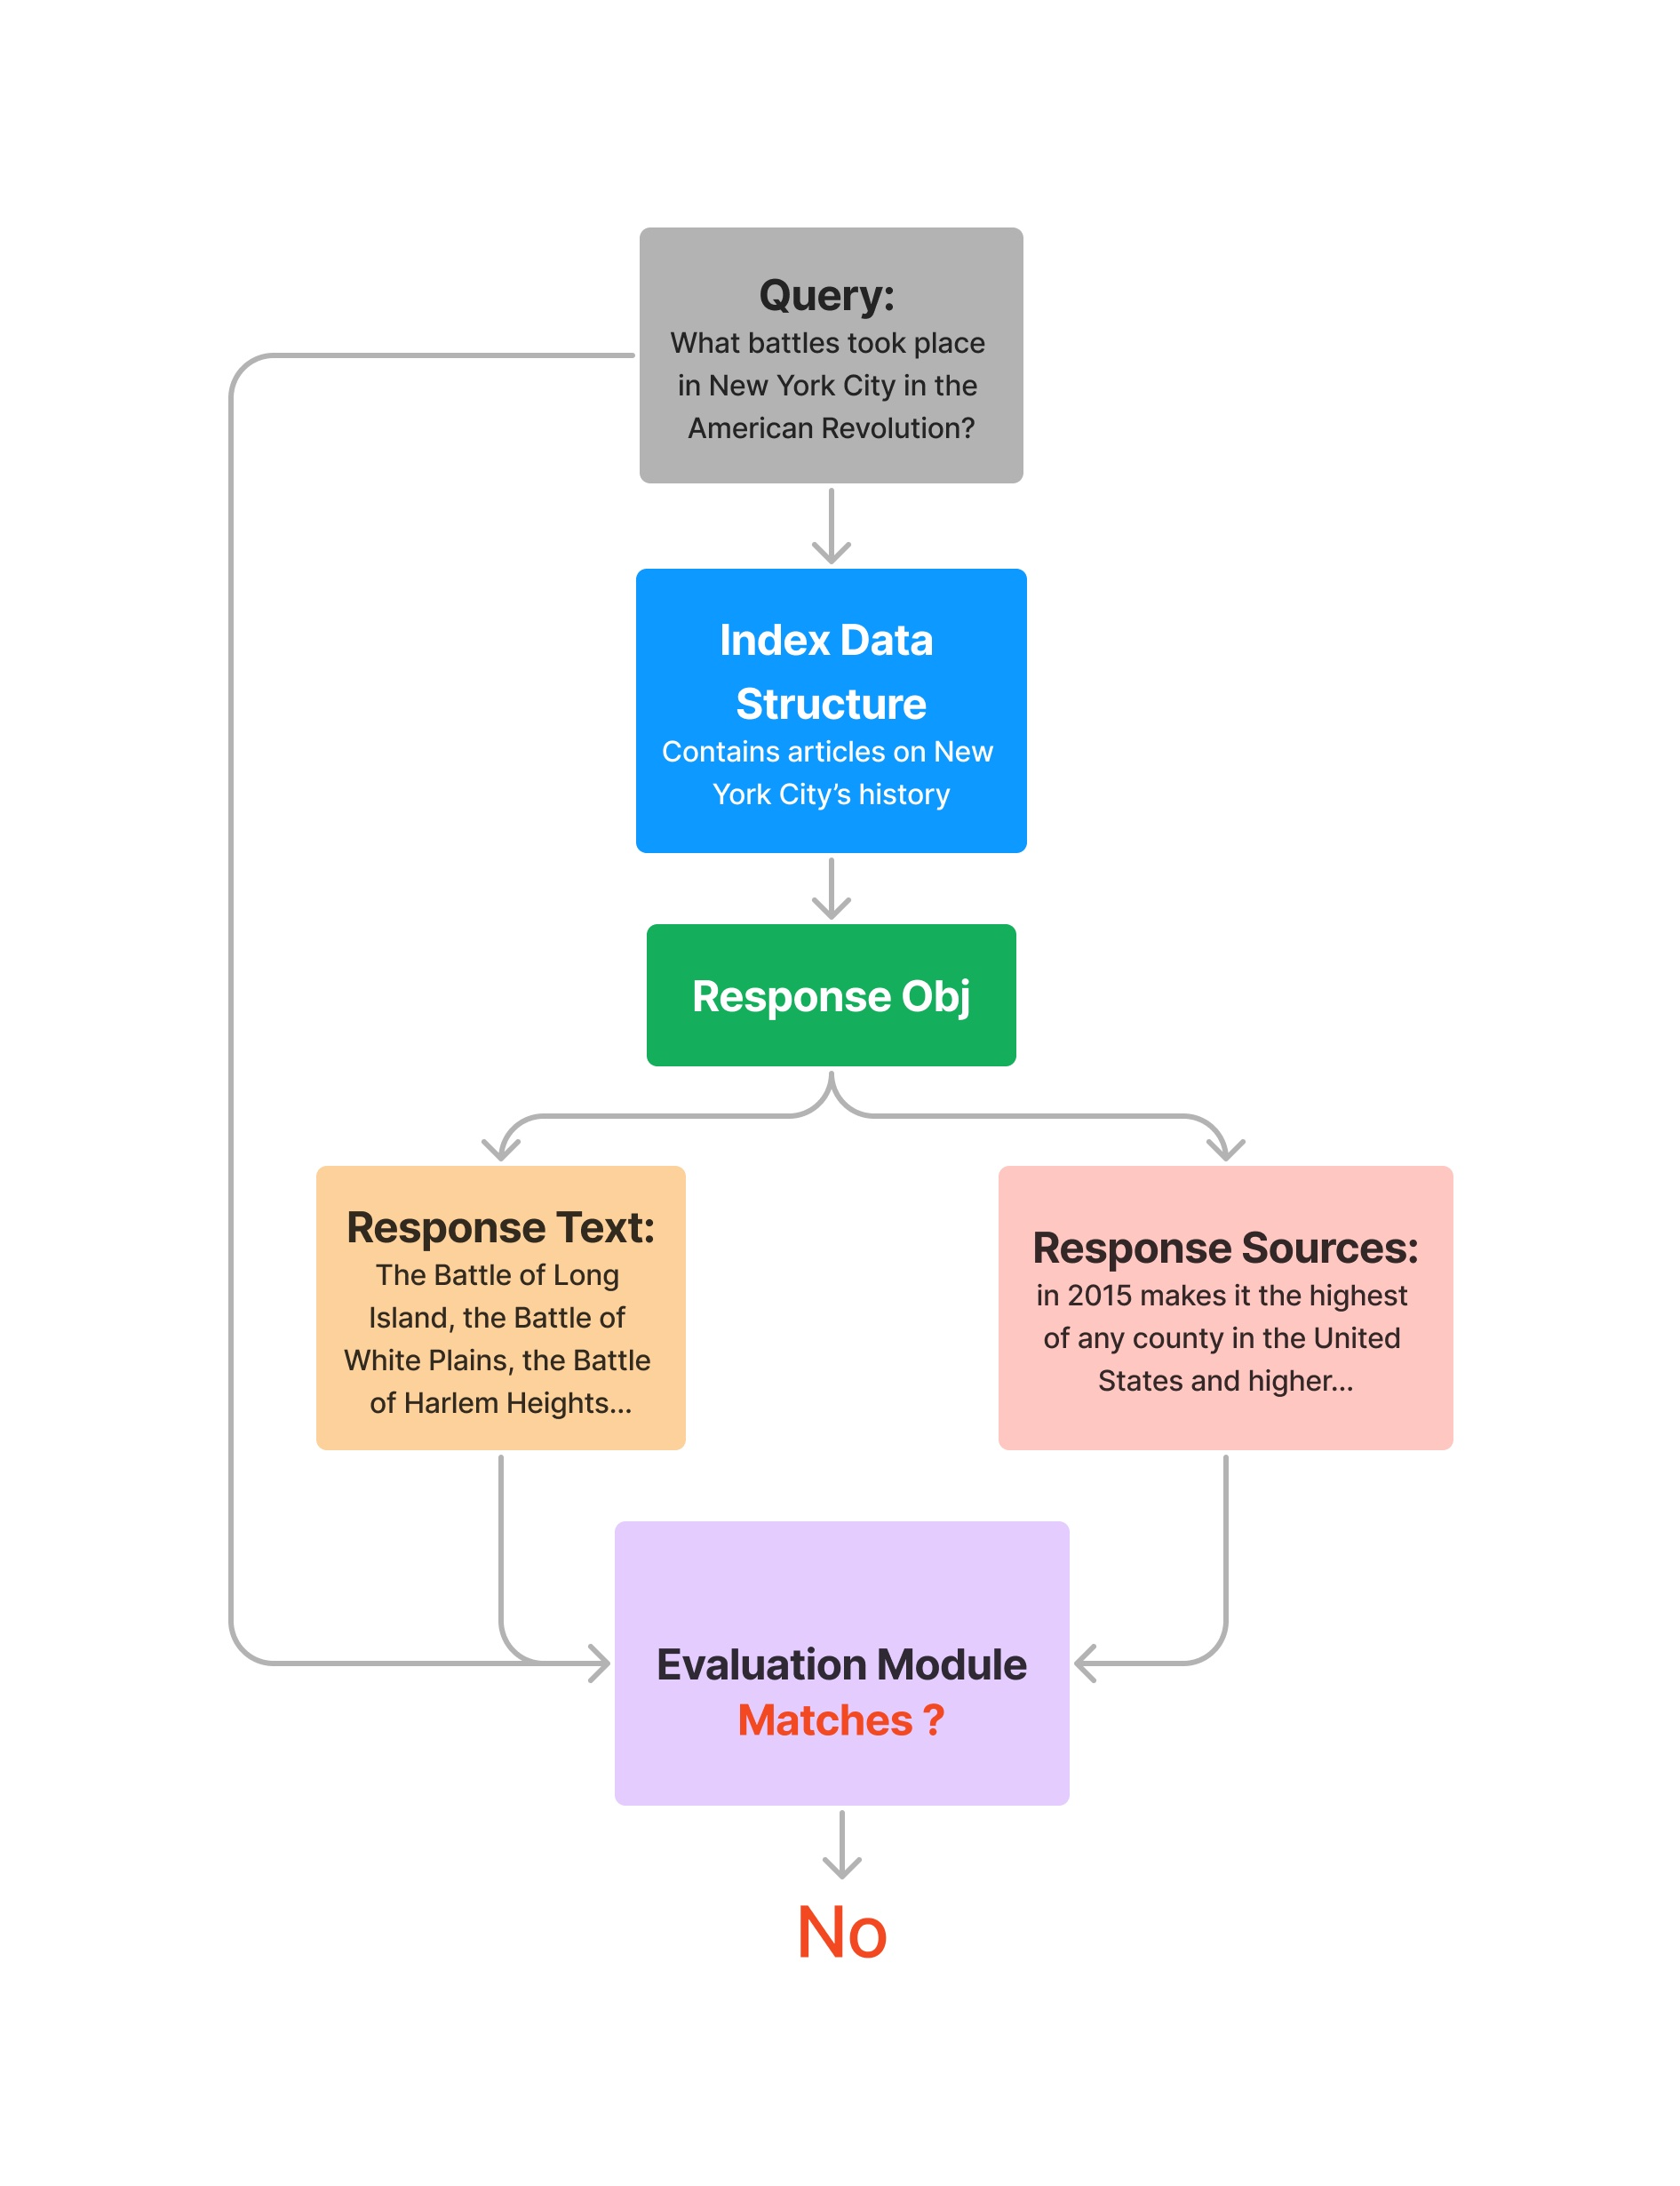
同样,你也可以针对某个具体的来源节点做评估。
from llama_index.core import VectorStoreIndex
from llama_index.llms.openai import OpenAI
from llama_index.core.evaluation import RelevancyEvaluator

# create llm
llm = OpenAI(model="gpt-4", temperature=0.0)

# build index
...

# define evaluator
evaluator = RelevancyEvaluator(llm=llm)

# query index
query_engine = vector_index.as_query_engine()
query = "What battles took place in New York City in the American Revolution?"
response = query_engine.query(query)
response_str = response.response
for source_node in response.source_nodes:
    eval_result = evaluator.evaluate(
        query=query,
        response=response_str,
        contexts=[source_node.get_content()],
    )
    print(str(eval_result.passing))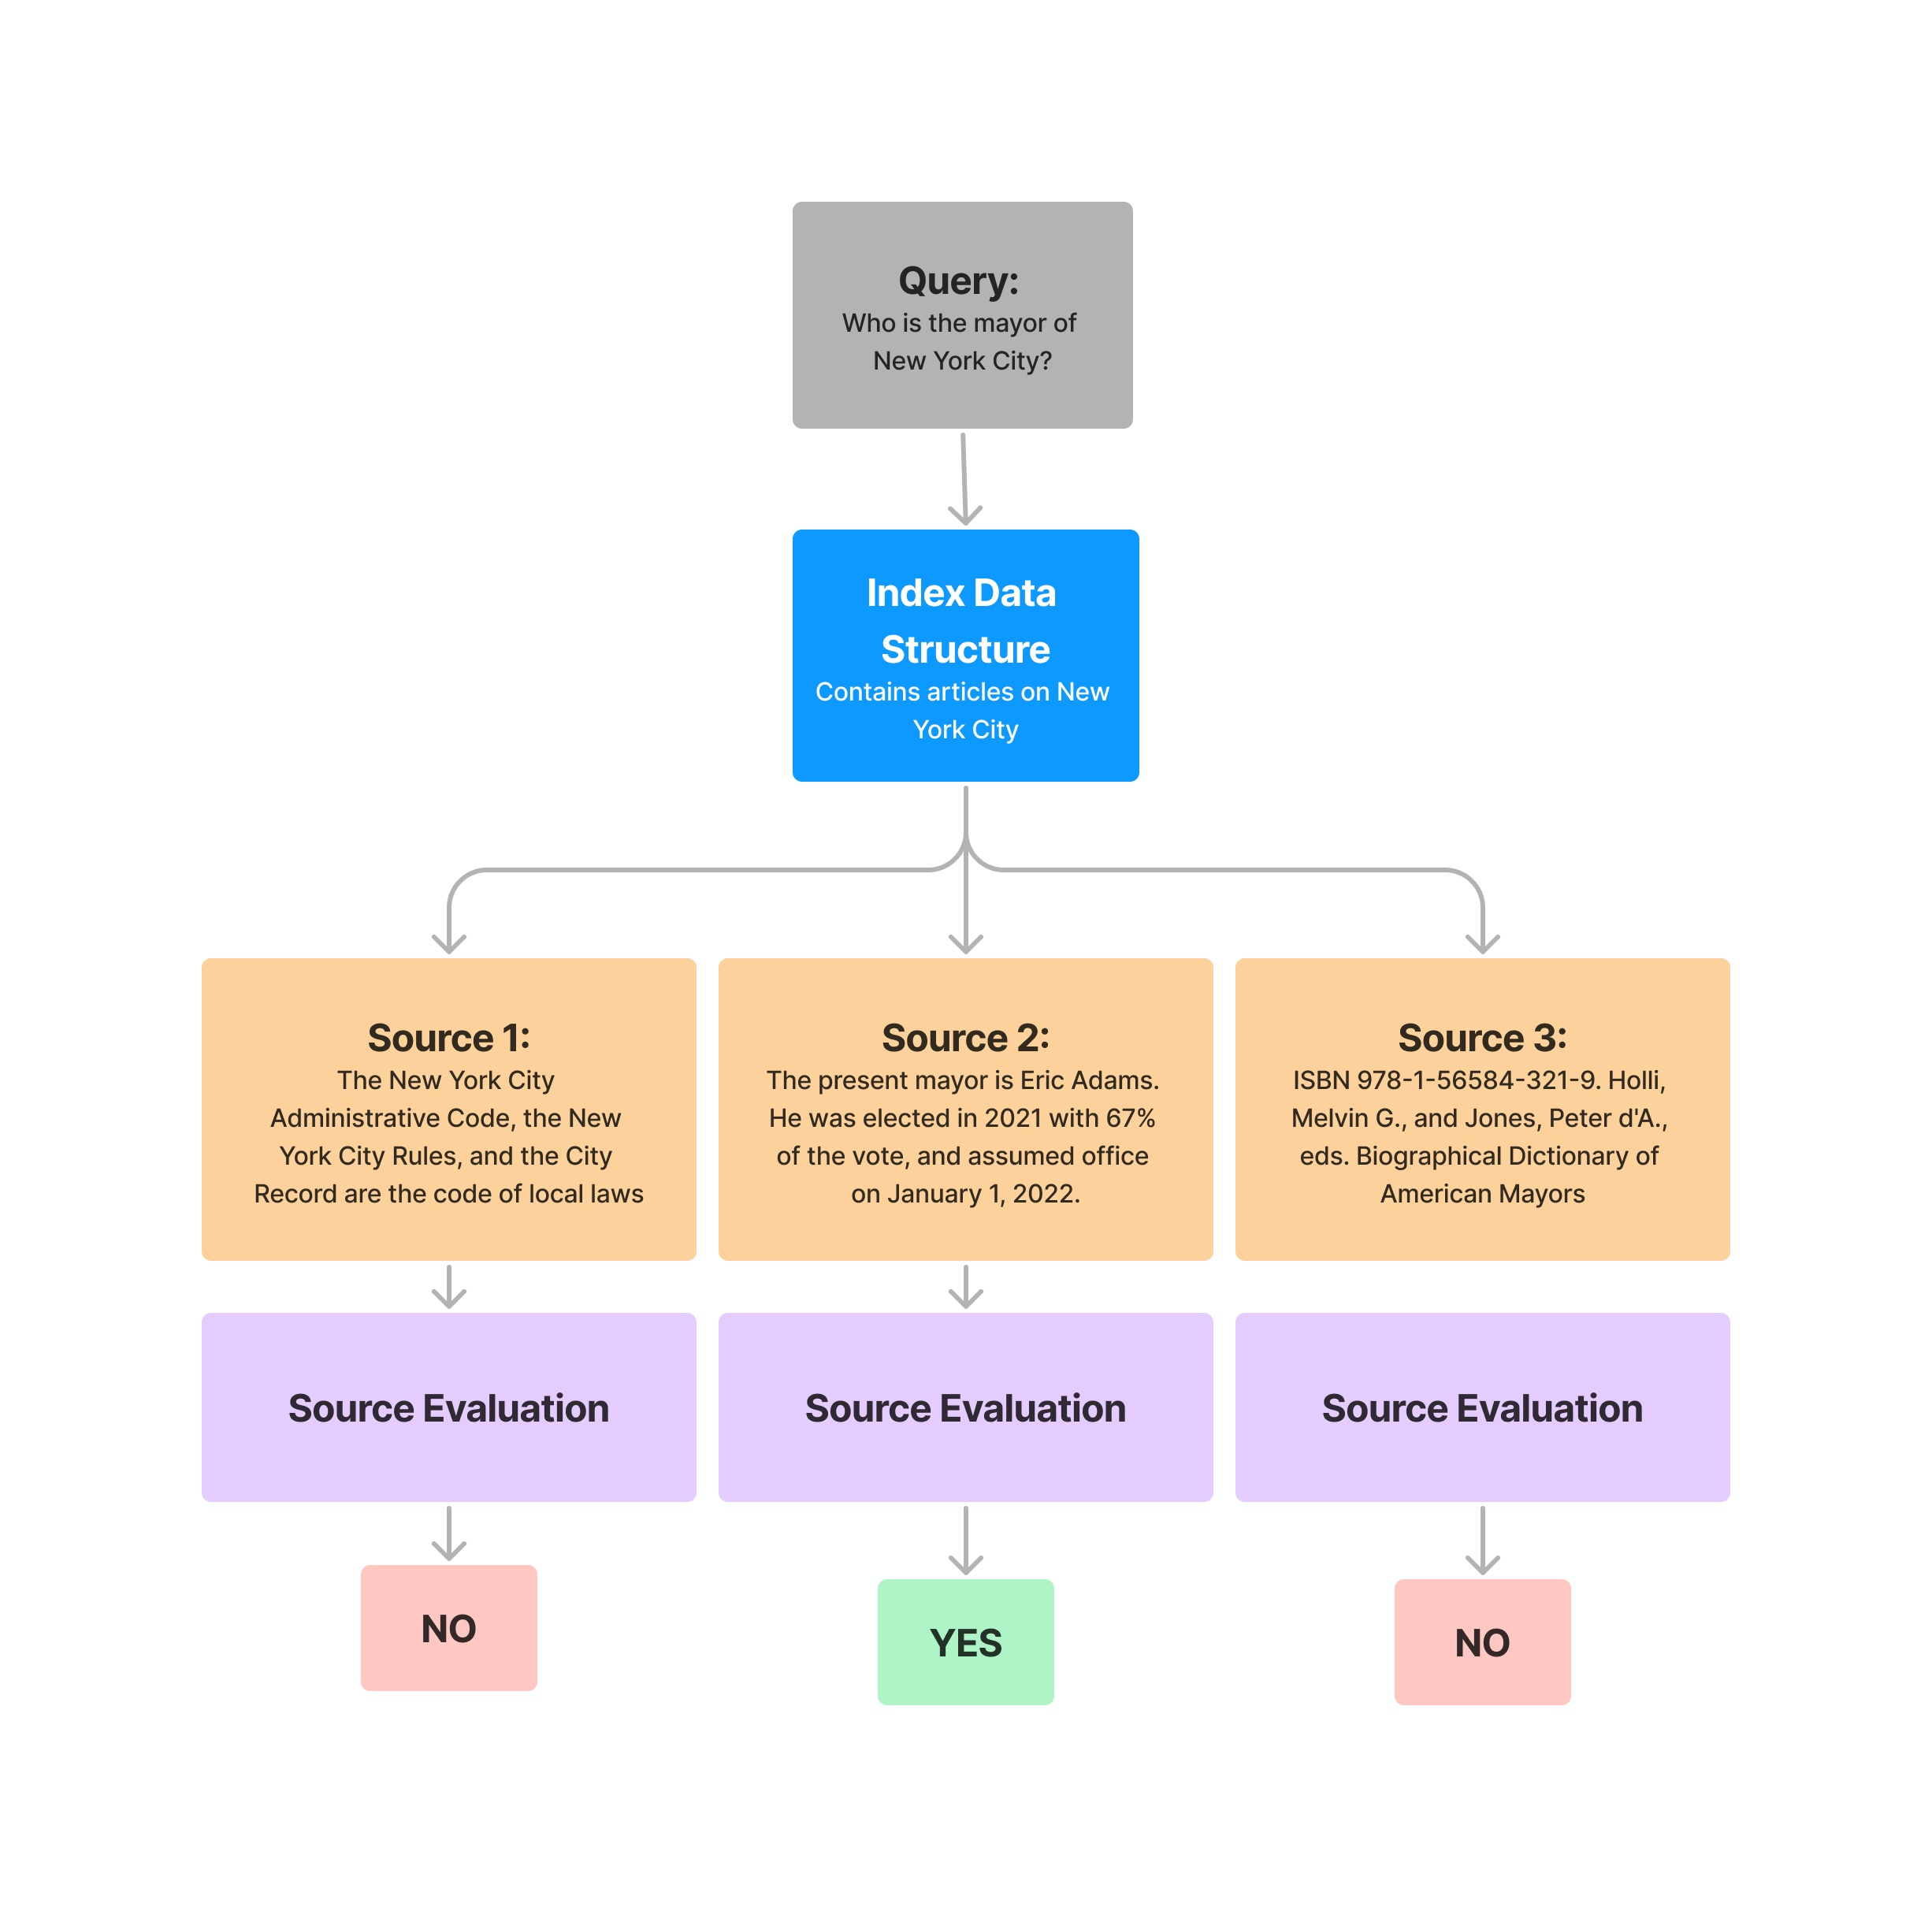
问题生成
LlamaIndex 还能用你的数据生成要回答的问题。把它与上面的评估器结合使用,就能在你的数据上搭出一套全自动的评估流程。
from llama_index.core import SimpleDirectoryReader
from llama_index.llms.openai import OpenAI
from llama_index.core.llama_dataset.generator import RagDatasetGenerator

# create llm
llm = OpenAI(model="gpt-4", temperature=0.0)

# build documents
documents = SimpleDirectoryReader("./data").load_data()

# define generator, generate questions
dataset_generator = RagDatasetGenerator.from_documents(
    documents=documents,
    llm=llm,
    num_questions_per_chunk=10,  # set the number of questions per nodes
)

rag_dataset = dataset_generator.generate_questions_from_nodes()
questions = [e.query for e in rag_dataset.examples]批量评估
我们还提供了批量评估运行器,可以在大量问题上运行一组评估器。
from llama_index.core.evaluation import BatchEvalRunner

runner = BatchEvalRunner(
    {"faithfulness": faithfulness_evaluator, "relevancy": relevancy_evaluator},
    workers=8,
)

eval_results = await runner.aevaluate_queries(
    vector_index.as_query_engine(), queries=questions
)集成
我们还与社区评估工具做了集成。
DeepEval
DeepEval 提供 6 个评估器(其中 3 个是 RAG 评估器,可同时评估检索器与生成器),由其专有的评估指标驱动。首先安装 deepeval:
pip install -U deepeval随后就可以从 deepeval 导入并使用这些评估器。完整示例:
from llama_index.core import VectorStoreIndex, SimpleDirectoryReader
from deepeval.integrations.llama_index import DeepEvalAnswerRelevancyEvaluator

documents = SimpleDirectoryReader("YOUR_DATA_DIRECTORY").load_data()
index = VectorStoreIndex.from_documents(documents)
rag_application = index.as_query_engine()

# An example input to your RAG application
user_input = "What is LlamaIndex?"

# LlamaIndex returns a response object that contains
# both the output string and retrieved nodes
response_object = rag_application.query(user_input)

evaluator = DeepEvalAnswerRelevancyEvaluator()
evaluation_result = evaluator.evaluate_response(
    query=user_input, response=response_object
)
print(evaluation_result)下面是导入 deepeval 全部 6 个评估器的写法:
from deepeval.integrations.llama_index import (
    DeepEvalAnswerRelevancyEvaluator,
    DeepEvalFaithfulnessEvaluator,
    DeepEvalContextualRelevancyEvaluator,
    DeepEvalSummarizationEvaluator,
    DeepEvalBiasEvaluator,
    DeepEvalToxicityEvaluator,
)要了解如何把 deepeval 的评估指标与 LlamaIndex 一起使用、并用上它完整的 LLM 测试套件,请访问文档。