
主题
做一个 RAG 应用原型很容易,但要让它高性能、稳健,并能在大规模知识语料上扩展,就很难。
本指南收录了各种提升 RAG 工作流性能的技巧。我们先概述几种通用技术——大致按从易到难排列;然后逐一深入介绍每项技术所解决的场景,以及在 LlamaIndex 中如何实现!
最终目标是优化你的检索与生成表现,从而在更复杂的数据集上回答更多查询,并且不产生幻觉。
构建生产级 RAG 的通用技术
以下是构建生产级 RAG 时需要优先考虑的几点:
- 把用于检索的块与用于合成的块解耦
- 面向更大文档集合的结构化检索
- 根据任务不同动态地检索块
- 对检索到的节点做重排以提升精度
- 优化上下文的嵌入
我们在生产级 RAG 网络研讨会中详细讨论过这些内容。更多整理后的要点可以看看这条 Tweet 长文。
解耦「用于检索的块」与「用于合成的块」
改善检索的一项关键技术,是把用于检索的块与用于合成的块解耦开来。
动机
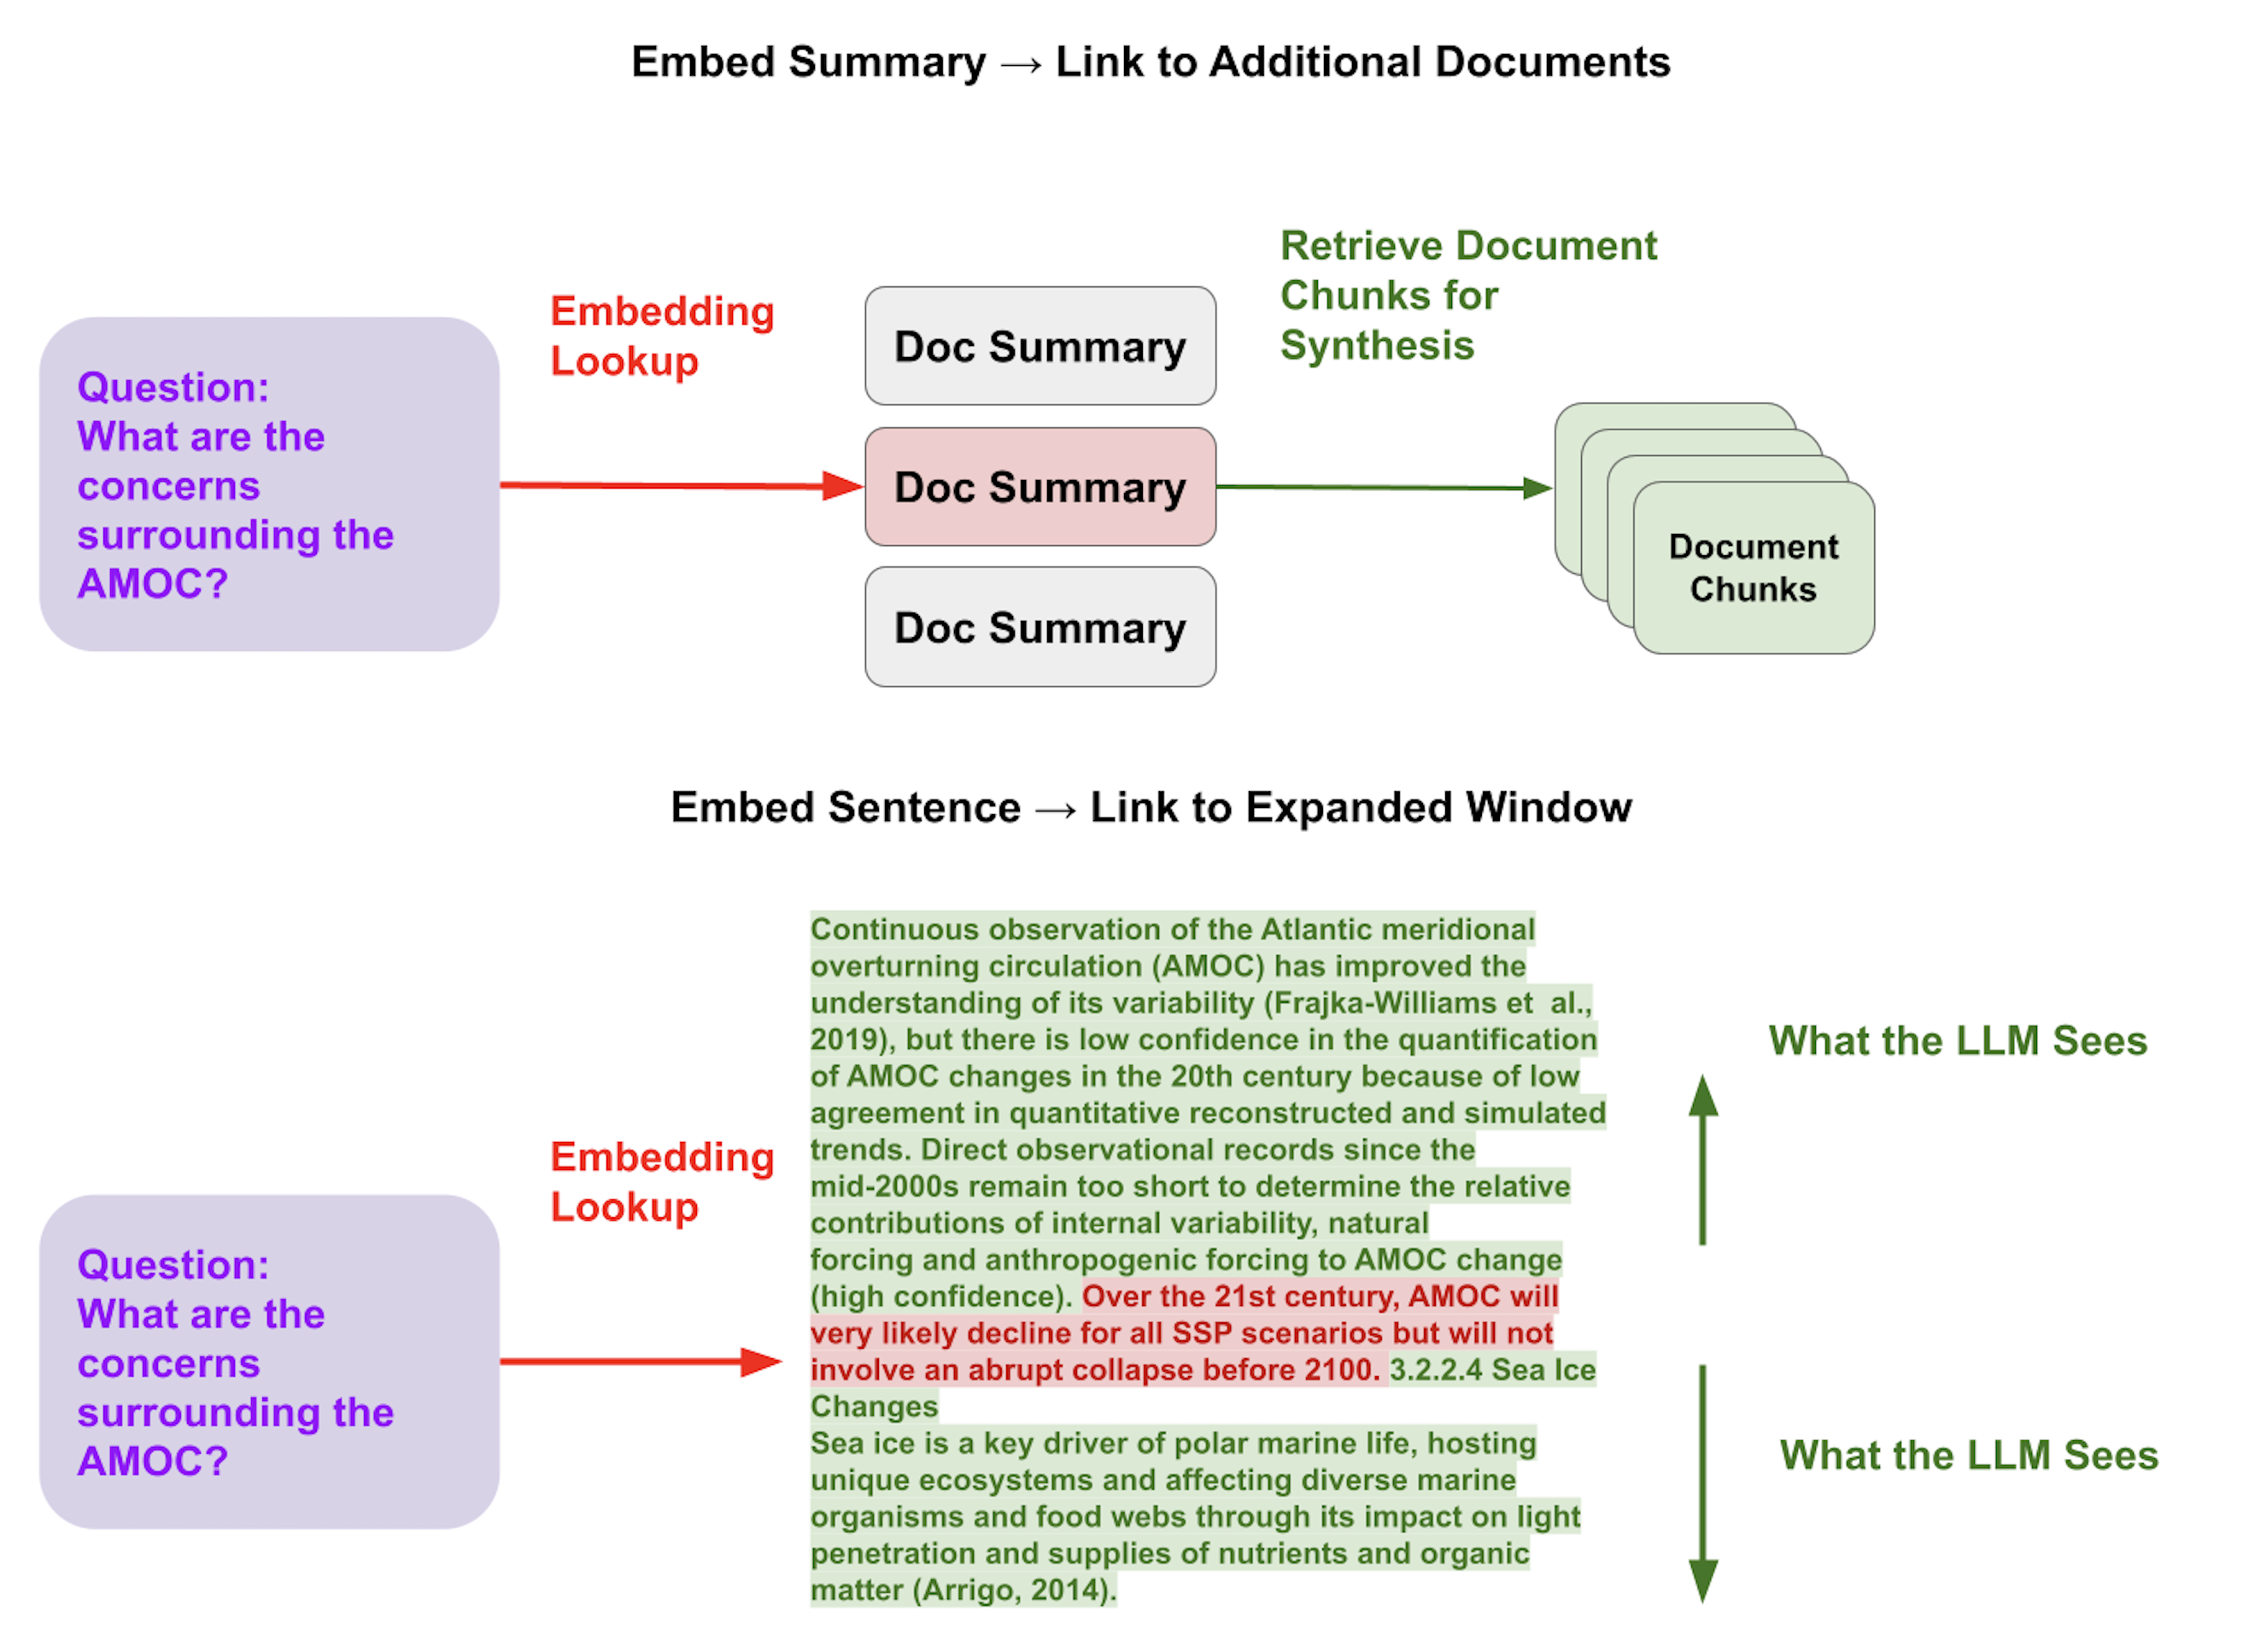
用于检索的最优块表示,可能与用于合成时的最优考虑并不相同。举例来说,原始文本块含有 LLM 针对查询合成更详细答案所需的细节;但它也可能包含会带偏嵌入表示的填充词/信息,或者缺少全局上下文,导致相关查询来了也根本检索不到它。
关键技术
利用这一思路主要有两种方式:
1. 为文档摘要做嵌入,摘要再链接到该文档相关的块。
这样就能先在高层检索相关文档,再检索其中的块,而不是直接去检索块(后者可能来自并不相关的文档)。
资源:
2. 为一个句子做嵌入,句子再链接到它周围的窗口。
这样可以更细粒度地检索相关上下文(给巨大的块做嵌入会带来“中间信息丢失”的问题),同时又保证有足够上下文供 LLM 合成。
资源:
面向更大文档集合的结构化检索
动机
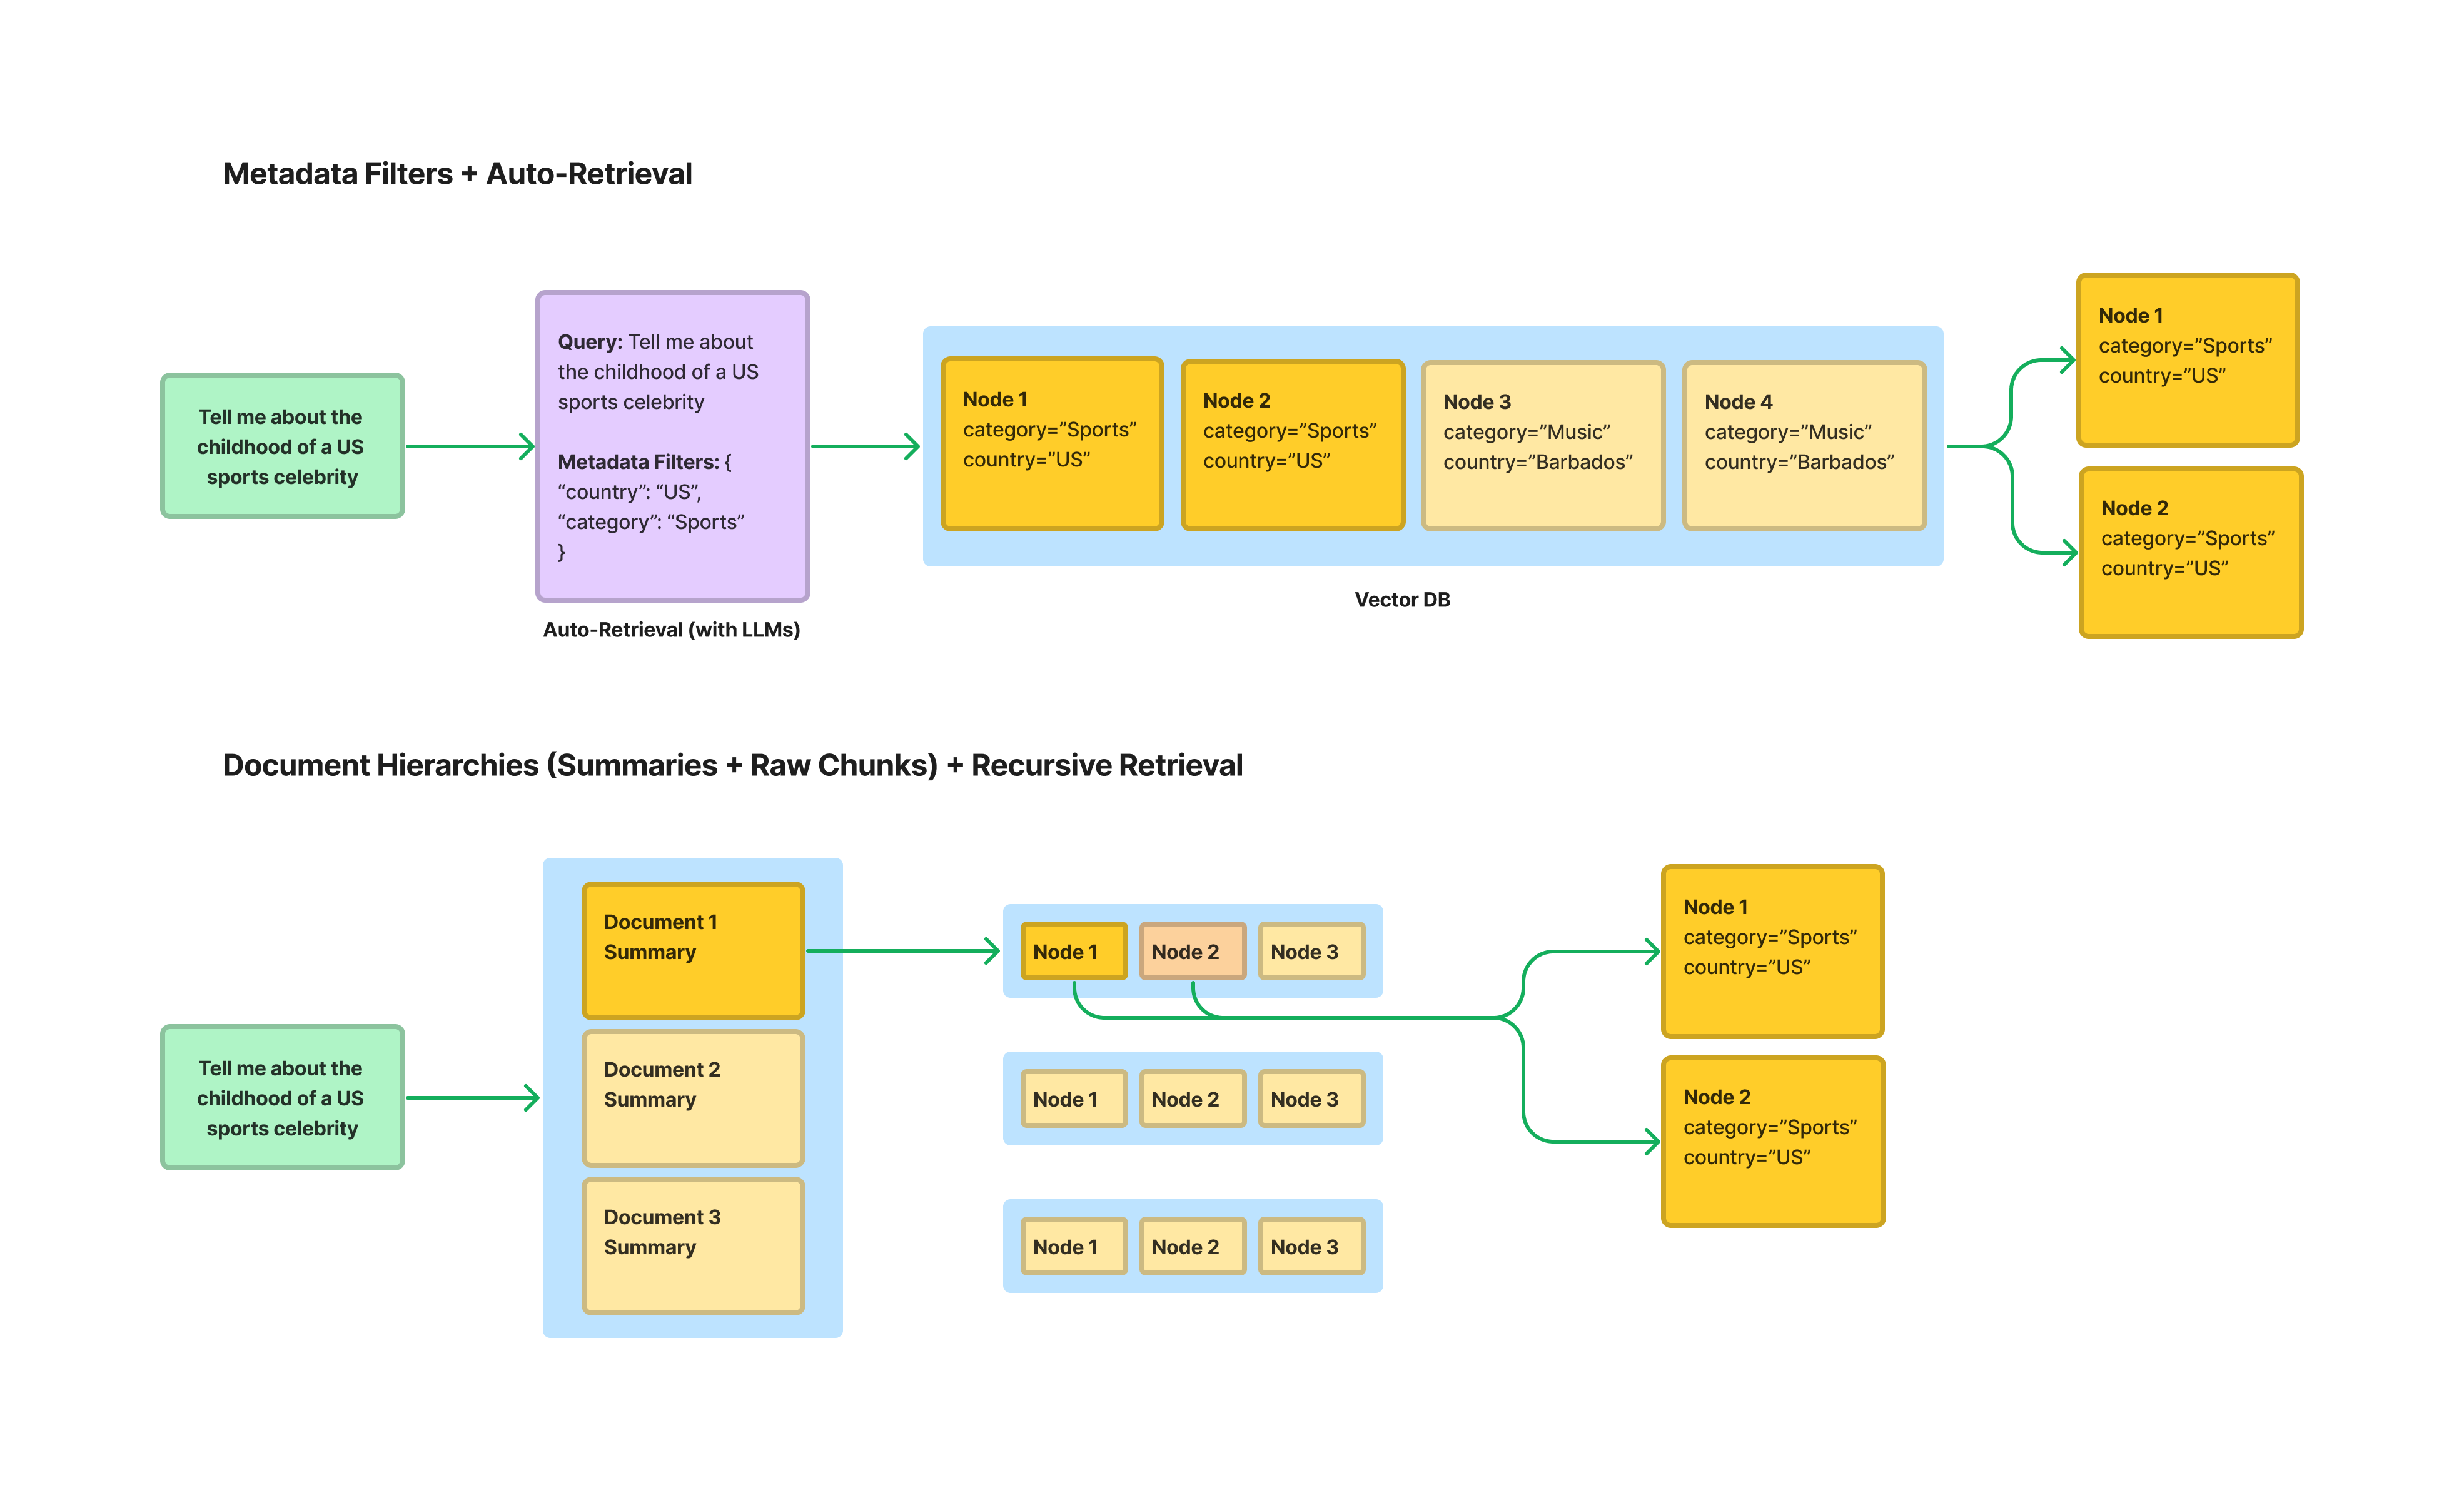
标准 RAG 技术栈(top-k 检索 + 基础文本切分)的一大问题,是文档数量一多就力不从心——比如有 100 份不同的 PDF。这种情况下,给定一个查询,你可能希望借助结构化信息做更精确的检索;例如你问的问题只与其中两份 PDF 相关,那就应该用结构化信息确保这两份 PDF 一定被返回,而不只是靠块与查询之间的原始嵌入相似度。
关键技术
面向生产级 RAG 系统,有多种方式可以做更结构化的标注/检索,各有各的优劣。
1. 元数据过滤 + 自动检索 给每份文档打上元数据,再存入向量库。推理时,除了语义查询串,还用 LLM 推断出该向向量库查询的元数据过滤器。
- 优点 ✅:主流向量库都支持;可以按多个维度过滤文档。
- 缺点 🚫:合适的标签不容易定义;标签可能信息不足,无法支撑更精确的检索。而且标签代表的是文档级的关键词检索,不允许做语义查找。
资源:2. 存放文档层级(摘要 → 原始块)+ 递归检索 给文档摘要做嵌入,并在每份文档内把摘要映射到块。先按文档层取回,再按块层取回。
- 优点 ✅:支持在文档层做语义查找。
- 缺点 🚫:不支持按结构化标签做关键词查找(后者可能比语义检索更精确)。此外自动生成摘要会有额外开销。
资源
根据任务动态检索块
动机
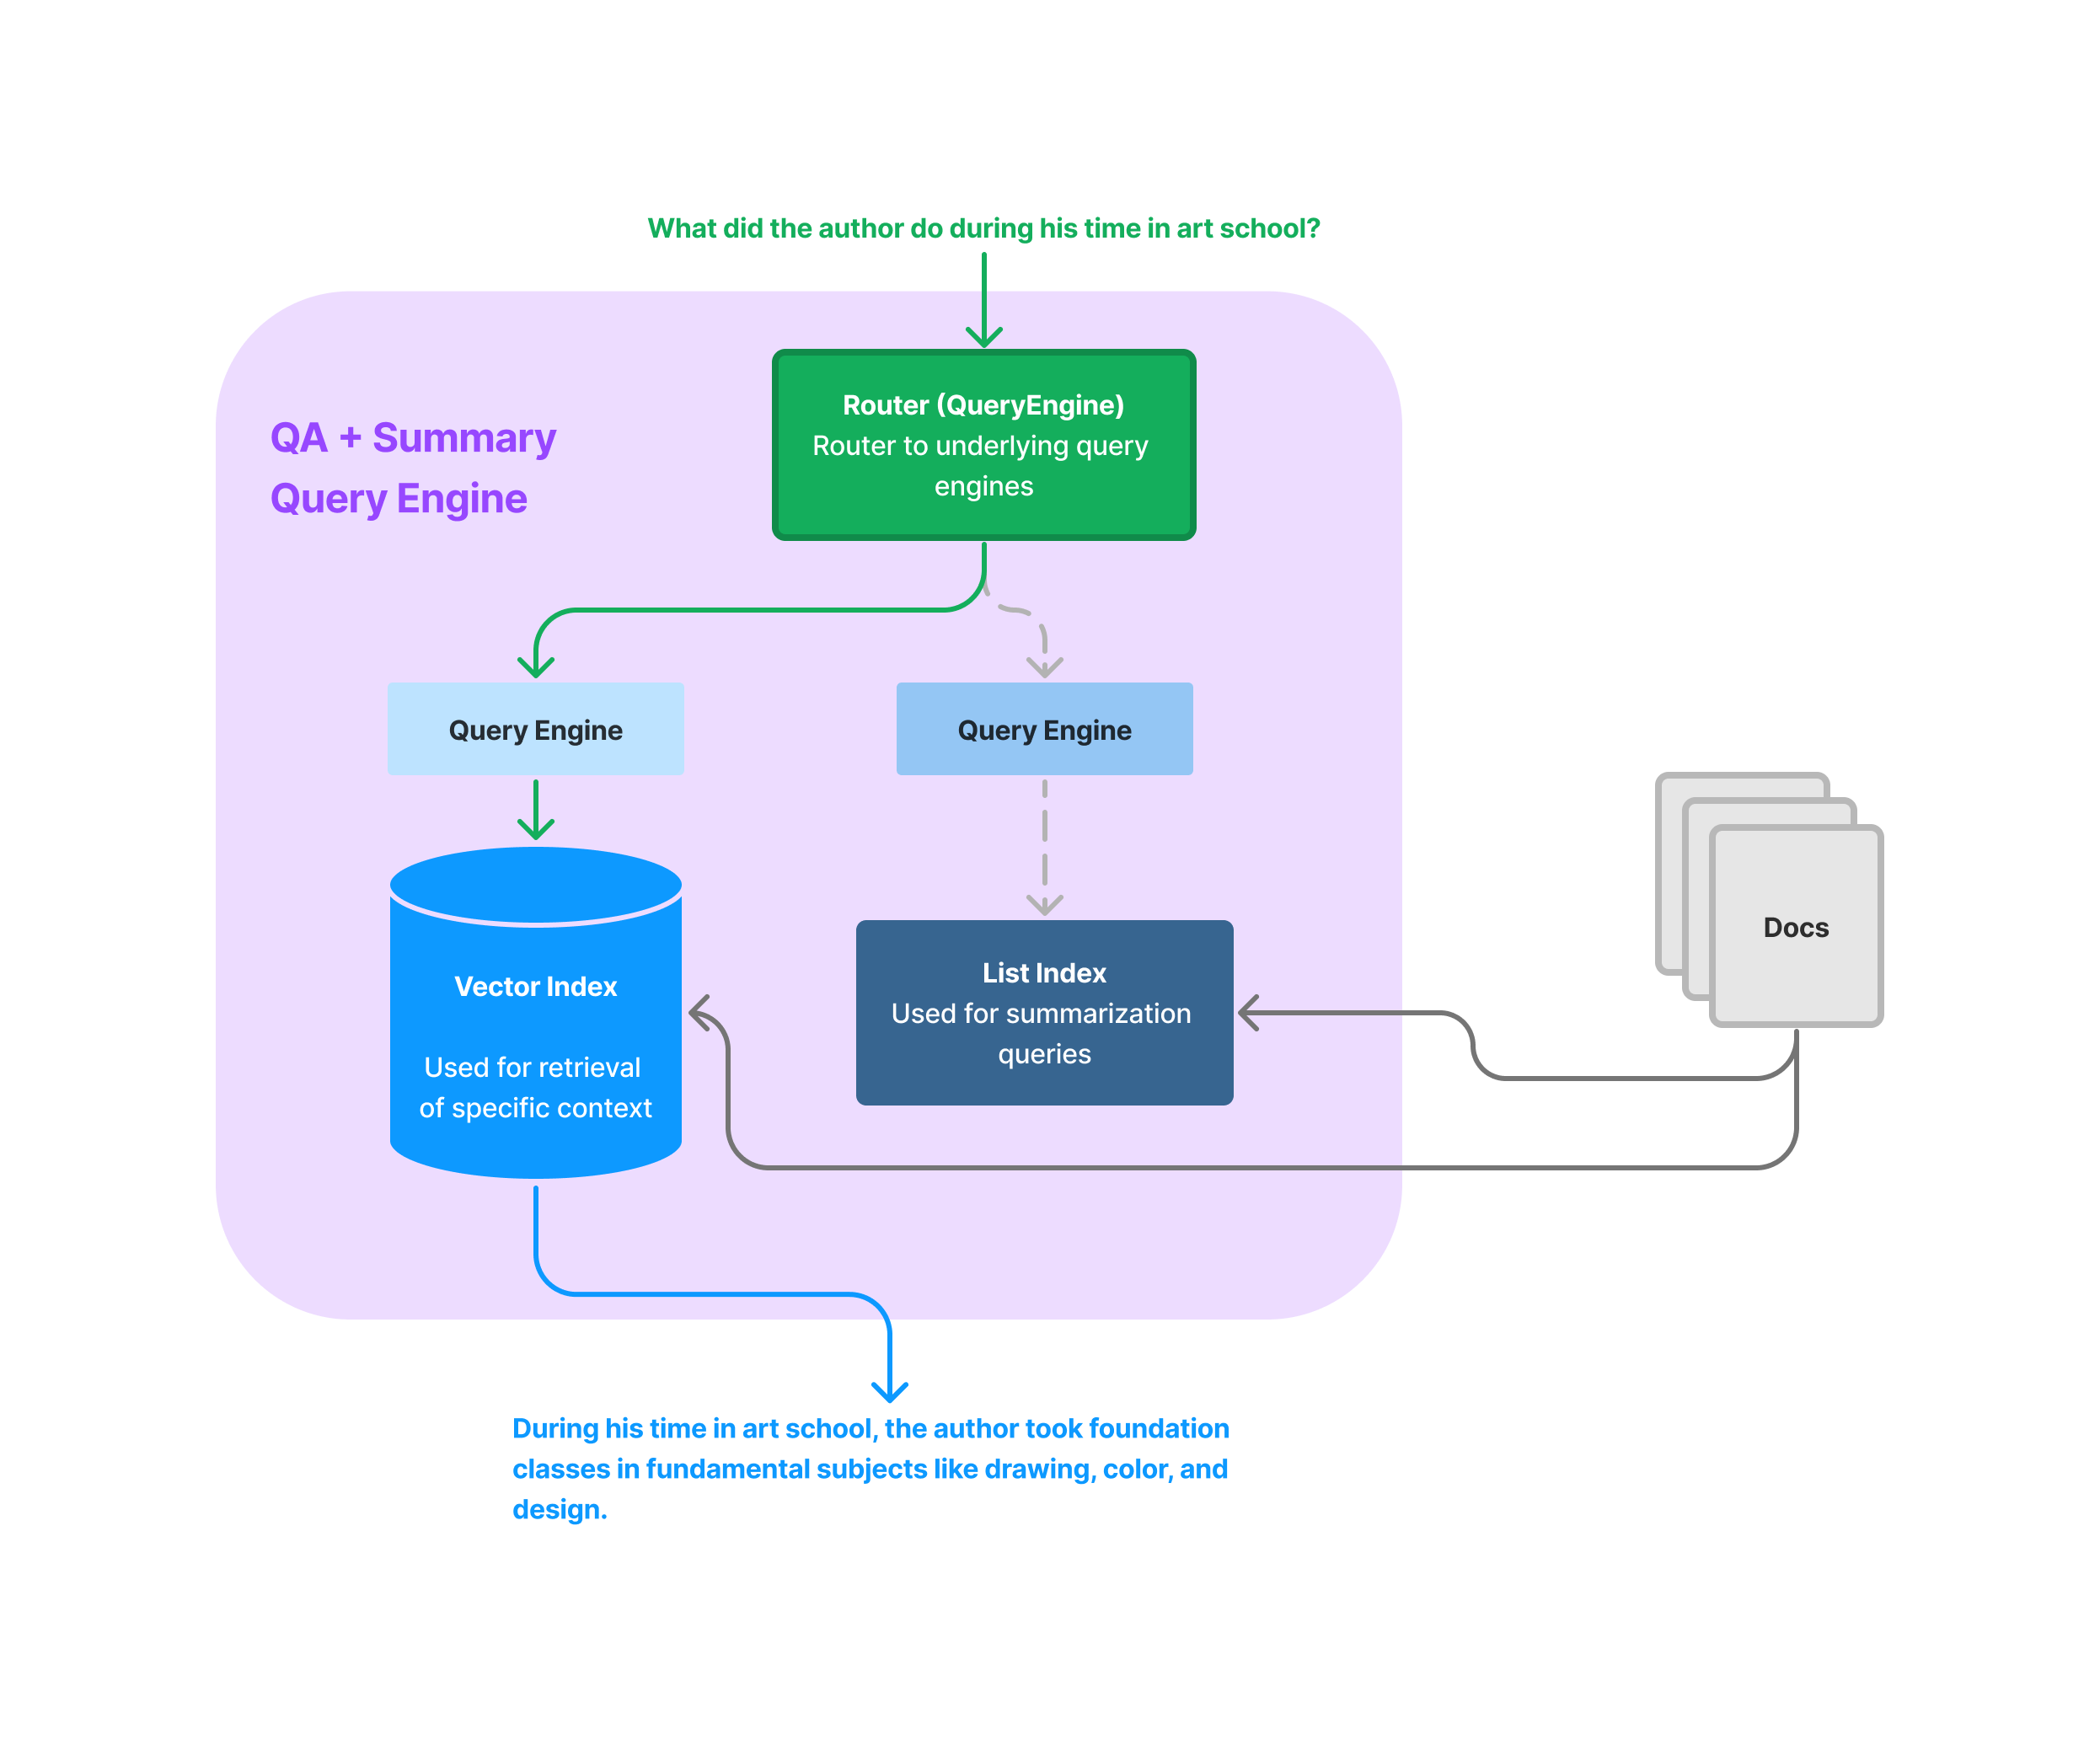
RAG 并不只是就具体事实做问答(top-k 相似度正是为此优化的),用户可能问出的查询种类很宽。朴素 RAG 技术栈能应付的查询包括询问具体事实,例如“讲讲这家公司 2023 年的多元共融举措”或“叙述者在谷歌工作期间做了什么”。但查询也可能是摘要类,例如“给我一个这份文档的高层概览”,或者对比类,例如“你能比较一下 X 和 Y 吗”。这些场景各自需要不同的检索技术。
关键技术
LlamaIndex 提供了若干核心抽象来支持按任务检索,包括我们的路由模块与数据 agent模块,也包括一些进阶查询引擎模块,以及用于连接结构化与非结构化数据的其他模块。
你可以用这些模块把问答与摘要联合起来做,甚至把结构化查询与非结构化查询组合在一起。
核心模块资源
详细指南资源
对检索到的节点做重排以提升精度
动机
稠密检索器与混合检索器是为召回调优的:它们会返回与查询语义相近的候选,但排名第一的并不总是最相关的。在生产中,这表现为“检索看着没问题,模型却还在答错题”。重排器的解法是对前 k 个候选再跑一个更强、更慢的模型,在交给 LLM 之前重新排序。
关键技术
先取回更宽的候选集(例如 similarity_top_k=10-20),再重排收窄到较小的 top_n(3–5)。按成本从低到高排列的选项:
- 本地 cross-encoder:
SentenceTransformerRerank,推荐作为默认。无需 API key,可与嵌入跑在同一套基础设施上。追求速度用cross-encoder/ms-marco-MiniLM-L6-v2,追求更强的多语言质量用Qwen/Qwen3-Reranker-0.6B。 - 托管重排 API:
CohereRerank、JinaRerank、VoyageAIRerank、MixedbreadAIRerank。接入简单、无需运维基础设施,但会增加每次查询的延迟与成本。 - 以 LLM 作重排器:
LLMRerank、RankGPTRerank、RankLLMRerank。质量最高也最贵。留给那些准确度优先于成本的生产流程。
优化上下文嵌入
动机
这与前文“解耦用于检索的块与用于合成的块”的动机相关。我们要确保嵌入是针对你的具体数据语料优化过的,以获得更好的检索。预训练模型未必能捕捉到与你用例相关的那些数据显著特征。
关键技术
除了上面列出的那些技术,我们还可以尝试微调嵌入模型。实际上这件事可以在非结构化文本语料上做,无需标签。
可参考我们的指南: