
主题
提示
如果你还没做过,请先安装 LlamaIndex 并完成起步教程再来读本页,这些步骤会先在你的实际体验里有个着落。
LLM 是在海量数据上训练出来的,但它们并没有在你的数据上训练过。检索增强生成(RAG)通过把「你的数据」加到「LLM 已经能访问的数据」上来解决这个问题。你在本文档里会频繁看到 RAG 的身影——查询引擎、对话引擎和 agent 常常都靠 RAG 来完成任务。
在 RAG 中,你的数据被加载并加工成可供查询的形式,也就是所谓的“索引”。用户的查询作用在索引上,由索引把你的数据筛成最相关的上下文。随后这份上下文连同你的查询以及一段提示词一起交给 LLM,LLM 给出回答。
即便你要构建的是聊天机器人或 agent,也需要掌握用 RAG 把数据接入应用的技巧。
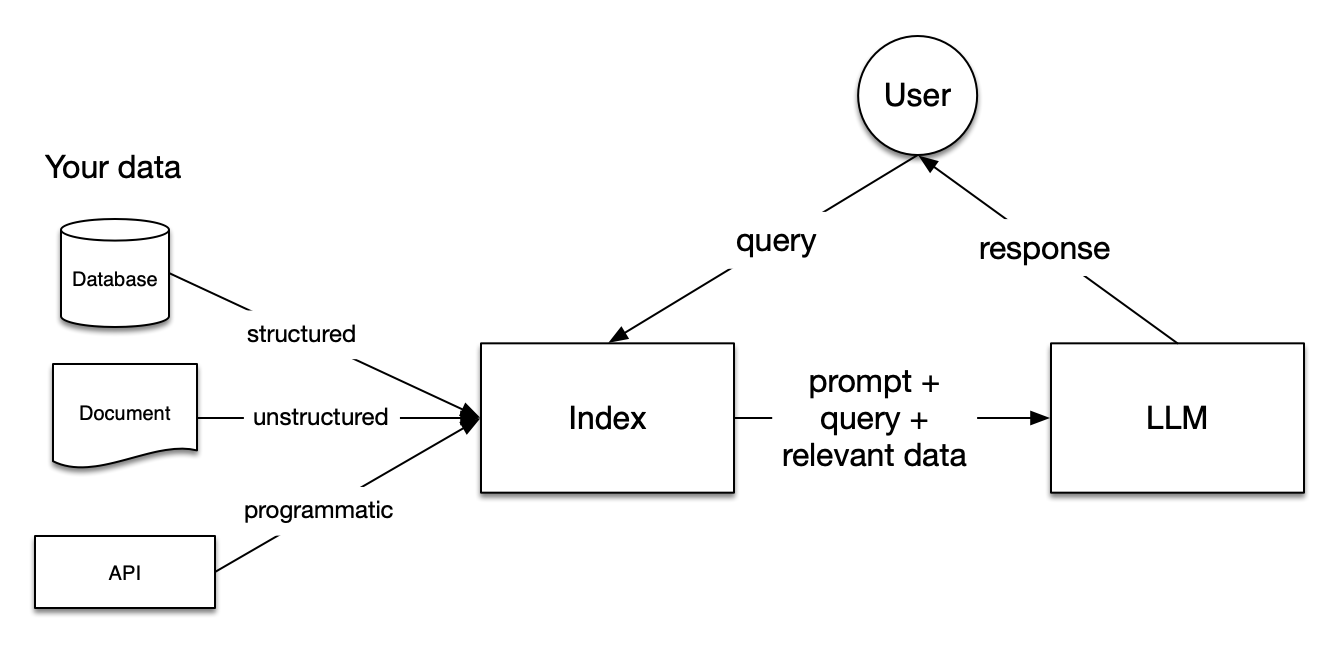
RAG 的各个阶段
RAG 包含五个关键阶段,它们也会是你构建的大多数应用的组成部分。这五个阶段是:
加载(Loading):指把数据从它所在的地方——文本文件、PDF、别的网站、数据库还是某个 API——取进你的工作流。LlamaIndex 提供了数百个连接器可供选择。
索引(Indexing):指创建一种允许对数据进行查询的数据结构。对 LLM 而言,这几乎总意味着生成
vector embeddings(你的数据在语义上的数值表示),并配合大量其他元数据策略,以便准确找到上下文相关的内容。存储(Storing):数据索引好之后,你几乎总会希望把索引以及其他元数据存储下来,以免重新索引。
查询(Querying):对任意一种索引策略,你都有很多方式组合使用 LLM 与 LlamaIndex 的数据结构来查询,包括子查询、多步查询和混合策略。
评估(Evaluation):任何流程里都少不了检验它相对其他策略有多有效、或者在你的改动前后有没有变好。评估为你的回答在准确度、忠实度和速度上提供客观度量。
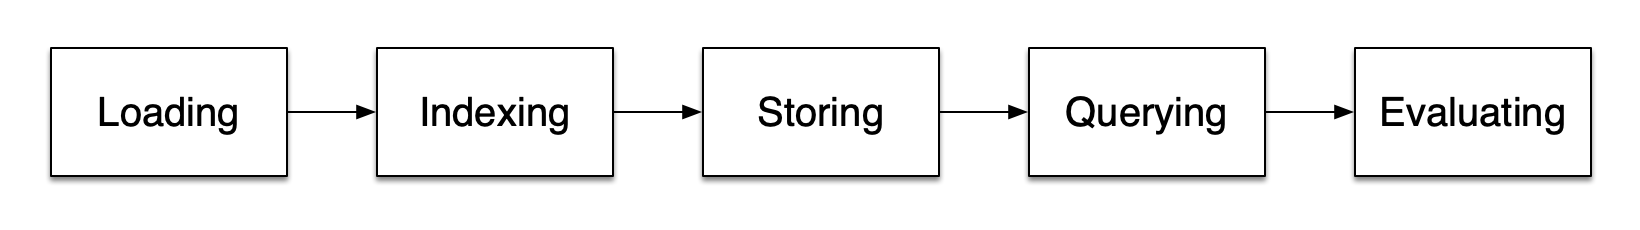
RAG 中的重要概念
还会遇到一些术语,它们指的是上述每个阶段内部的具体步骤。
加载阶段
节点与文档(Nodes and Documents):Document 是围绕任何数据源的容器,比如一个 PDF、一次 API 输出,或从数据库取回的数据。Node 是 LlamaIndex 中数据的最小单元,代表源 Document 的一个“分块”。节点自带元数据,把它们所属的文档和其他节点关联起来。
连接器(Connectors):数据连接器(常称为 Reader)从不同的数据来源和格式摄取数据,产出 Document 与 Node。
索引阶段
索引(Indexes):数据摄取完成后,LlamaIndex 会帮你把它组织成便于检索的结构。这通常涉及生成 vector embeddings,并存储在一种叫做 vector store(向量库)的专用数据库中。索引还可以存放关于你数据的各类元数据。
嵌入(Embeddings):LLM 生成的数据数值表示称为 embeddings。在按相关性筛选数据时,LlamaIndex 会把查询转换成嵌入,而你的向量库负责找出与查询嵌入在数值上相近的数据。
查询阶段
检索器(Retrievers):检索器定义了给定查询时如何从索引中高效地取回相关上下文。你的检索策略直接决定取回数据的相关性以及取回过程的效率。
路由器(Routers):路由器决定用哪个检索器从知识库中取回相关上下文。更具体地说,RouterRetriever 类负责挑选一个或多个候选检索器来执行查询。它借助一个选择器,根据每个候选的元数据以及查询本身选出最合适的选项。
节点后处理器(Node Postprocessors):节点后处理器接收一组检索到的节点,并对它们施加变换、过滤或重排逻辑。
响应合成器(Response Synthesizers):响应合成器基于用户查询和一组检索到的文本块,让 LLM 生成最终回答。