
主题
LLM 产出结构化输出的能力,对那些依赖稳定解析输出值的下游应用至关重要。LlamaIndex 自身也在以下两方面依赖结构化输出。
- 文档检索:LlamaIndex 里的许多数据结构在检索文档时,依赖符合特定 schema 的 LLM 调用。例如树索引就期望 LLM 调用结果形如 “ANSWER: (number)”。
- 响应合成:用户会期望最终回答带有一定结构(比如 JSON 输出、格式化后的 SQL 查询等)。
LlamaIndex 提供了多种模块让 LLM 以结构化格式产出输出。默认情况下,结构化输出由我们的 LLM 类直接提供。此外我们也提供更低层的模块:
- Pydantic Programs:这是一类通用模块,把输入提示词映射为以 Pydantic 对象表示的结构化输出。它们可以使用函数调用 API,也可以用文本补全 API + 输出解析器。这些模块同样可以接入查询引擎。
- 预置 Pydantic Program:我们内置了一些把输入映射到特定输出类型(比如 dataframe)的 Pydantic program。
- 输出解析器(Output Parsers):这类模块在 LLM 文本补全端点的前后起作用。它们不与 LLM 函数调用端点一起使用(因为函数调用本身就自带结构化输出)。
输出解析器与 Pydantic program 的概览见下文各节。
🔬 结构化输出函数的解剖
这里说明一个由 LLM 驱动的结构化输出函数包含哪些部件。流水线形态取决于你用的是通用 LLM 文本补全 API 还是 LLM 函数调用 API。
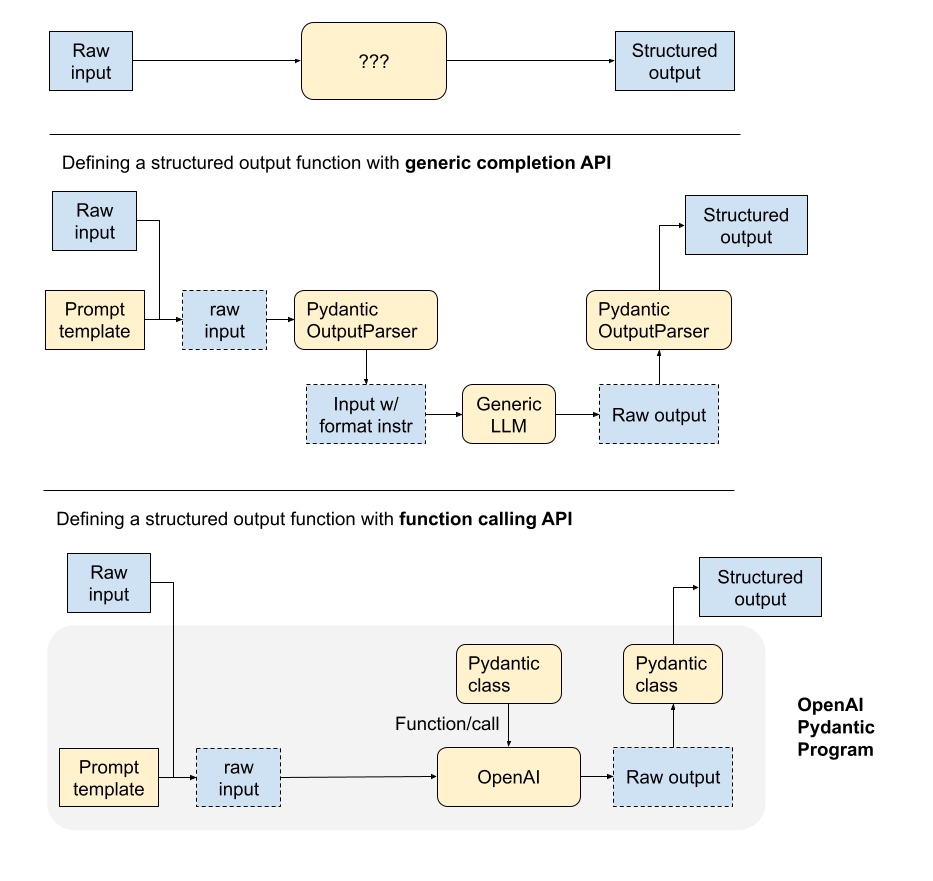
在使用通用补全 API 时,输入与输出都通过文本提示词处理。输出解析器在 LLM 调用前后都发挥作用,用以保证输出结构化:调用前,它可以往提示词里追加格式指令;调用后,它可以按指定指令把输出解析出来。
在使用函数调用 API 时,输出本身就是结构化格式,而输入可以接收目标对象的签名。于是结构化输出只需转换成合适的对象形式(比如 Pydantic)。