
主题
在用编码智能体?
给你的 AI 智能体开放这些文档的访问:claude mcp add llama-index-docs --transport http https://developers.llamaindex.ai/mcp —— 或者用 LlamaParse 的 MCP 工具与技能 给它加强能力。
概述
Extract 是 LlamaParse(LlamaIndex 出品的文档处理平台)的一部分。它提供一个简单的 API,用于从 PDF、文本文件与图片这类非结构化文档里抽取结构化数据。
Extract 有 Web 界面、Python SDK 与 REST API 三种使用方式。
我适合用 Extract 吗?
当你需要下面这些时,Extract 非常合适:
- 给下游任务用的、类型良好的数据:你想从文档里抽数据,再用于训练模型、做仪表盘、入库这类下游任务。Extract 会保证你的数据符合所提供的 schema,不符合时也会给出有用的错误信息。
- 准确的抽取:我们用同级别最好的 LLM 模型从你的文档里抽数据。
- schema 的迭代开发:你想快速打磨 schema,并在样本文档上看到它的效果反馈 —— 某个字段是不是得再多给些示例?某个字段是不是该改成可选?
- 多种文件类型:Extract 支持范围很广的文件类型,包括 PDF、文本文件与图片。若你需要我们支持别的类型,告诉我们!
快速开始
使用网页界面
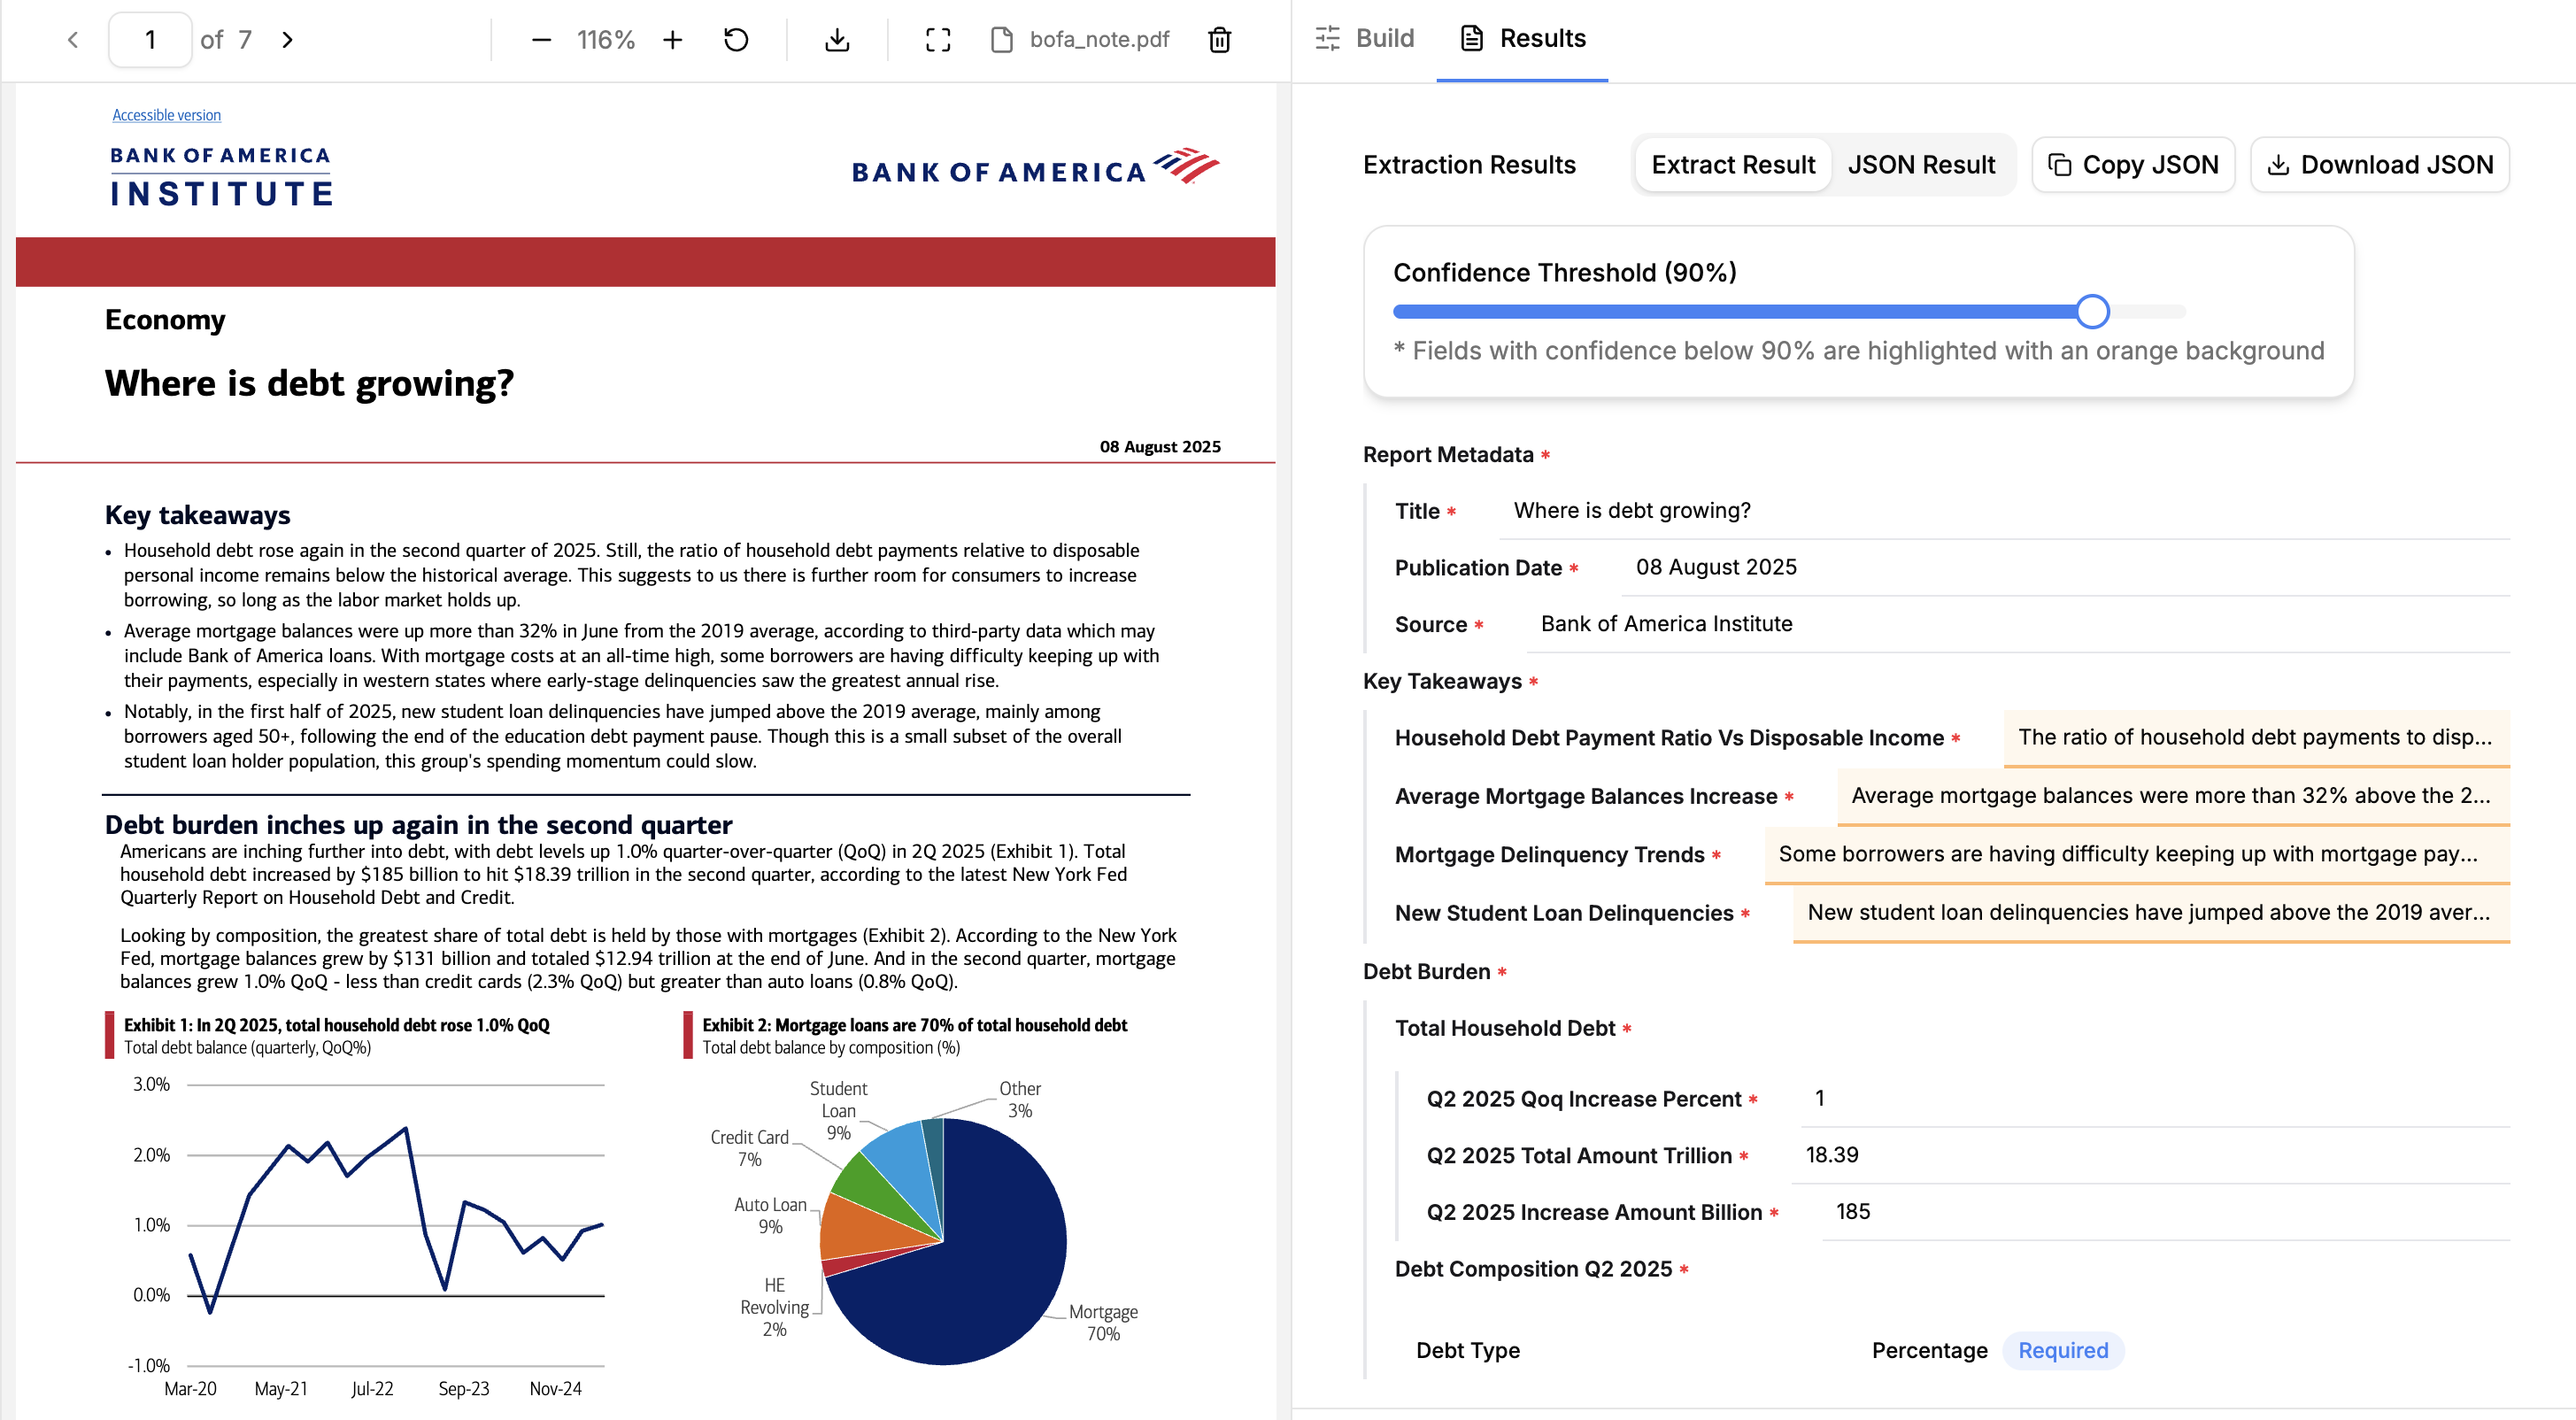
想试 Extract,最简单的方式是使用 Web 界面。
只要定义好你的 Extraction Configuration(schema 与设置),把任意受支持的文档拖进 LlamaParse,就能从文档里抽出数据。
获取 API key
准备好写代码时,取一把 API key 就能用 Python SDK 调用 Extract。
使用我们的库
我们为 Python 与 TypeScript 都提供了库。要大规模跑抽取任务,这是使用 Extract 的推荐方式。起步请看 SDK 快速上手。
REST API
如果你用的不是 Python,可以走 REST API。
档位与版本
Extract 提供三个主要档位:
- Agentic Plus 在各种文档类型上提供最高的抽取质量。想要最好的结果、又能接受更高成本与延迟时用它。它在长或复杂的文档上可能耗时更久,因为对结果投入了更多轮打磨。
- Agentic 在很宽的文档范围内平衡质量、成本与延迟,包括混合版式与表格。
- Cost Effective 为直接的抽取优先兼顾更低成本与更低延迟,尤其适合高并量。
Turbo 是速度档,用于对 PDF 与图片输入的延迟敏感的工作。在我们的抽取基准上,它的准确度高于 Cost Effective。其限制见档位。
特性兼容性见配置 Extract,Extract 与 Parse 合并的费用见定价。
Extract 现在默认跑在 v2 API 上。若你需要使用遗留的 Extract v1 体验,见下文使用 Extract v1。
configuration.version 是 Extract 的版本名,例如 2.5 或 latest。见版本。
直接使用 SDK 或 REST API 时,V2 会把 Parse 与 Extract 的档位解耦。下面列出 V2 配置与 V1 等价物的对应关系:
V2 Extract tier | V2 Parse tier | V1 等价写法(extraction_mode) |
|---|---|---|
cost_effective | fast | FAST |
agentic | agentic | MULTIMODAL |
agentic | agentic_plus | PREMIUM |
使用 Extract v1
Extract v2 是默认也是推荐的体验。若你需要使用遗留的 Extract v1:
- Web 界面:在 LlamaParse 主界面里走到 Settings → Preferences,把 Extract API 设为 v1。这个偏好只保存在该浏览器里,且只有具备遗留 v1 访问权的组织才能看到它。
- Python SDK:使用
llama-cloud-services包(在我们的 SDK 示例里显示为「Python(legacy)」标签页)。细节见 SDK 页。 - REST API:v1 端点的文档在 REST API (v1 Legacy) 页。
- 迁移协助:API/SDK/界面的对应关系见 Extract v1 → v2 迁移指南。
Extract v1 已是遗留版本,未来可能被弃用。新项目我们建议直接用 v2。