
主题
已弃用
本页记录的是已弃用的 Extract v1 API。新的接入请使用 Extract v2;改造已有的 v1 代码请见v1 到 v2 迁移指南。
LlamaExtract 被设计成一个灵活、可扩展的抽取平台。平台核心的概念有以下几个:
- 抽取智能体(Extraction Agents):可复用的抽取器,绑定一套具体的 schema 与抽取设置。
- 数据 schema(Data Schema):用 JSON/Pydantic 格式对你要抽取的数据做结构化定义。详见下文。
- 抽取目标(Extraction Target):定义抽取的范围,以及你的 schema 如何应用到文档上。详见下文。
- 抽取任务(Extraction Jobs):在一组文件上运行某个抽取智能体的异步抽取工作。
- 抽取结果(Extraction Runs):一次抽取任务的结果,含抽出的数据与其他元数据。
数据 schema
数据 schema 定义你想从文档里抽取的数据结构。它是一份 JSON Schema,规定字段的名称、类型与描述,也就是你需要的那些信息的形状。
schema 本质上仍是 JSON Schema(支持完整 JSON Schema 规范的一个子集),不过我们的 Python SDK 允许你使用 Pydantic 模型,从而有更 Pythonic 的体验、带类型校验与 IDE 支持。
怎么定义你的 schema
schema 由字段构成。每个字段有一个名称(输出里的键)与一个类型(string、number、boolean、array、object 等)。你还可以给每个字段一段描述。
- 字段名 —— 使用清晰、稳定的名字,与你对数据的用法相符(例如
invoice_number、vendor_name)。它们会成为抽出 JSON 里的键。 - 字段描述 —— 描述是给底层大模型的额外上下文,不只是给人看的文档:模型会依据它来决定抽什么。请用描述告诉模型该字段的取值是什么 —— 例如这个字段的含义、通常出现在文档的什么位置、可接受的格式或示例。描述写得更好,抽取通常就更准确、更一致。
注意
延伸阅读:schema 设计与限制 —— 写出有效 schema 的最佳实践、常见模式与限制。
抽取目标
抽取目标决定你的 schema 如何应用到文档上、以及你拿到的结果是什么粒度。这是一个很重要的配置项,因为它从根本上改变数据被抽取的方式。
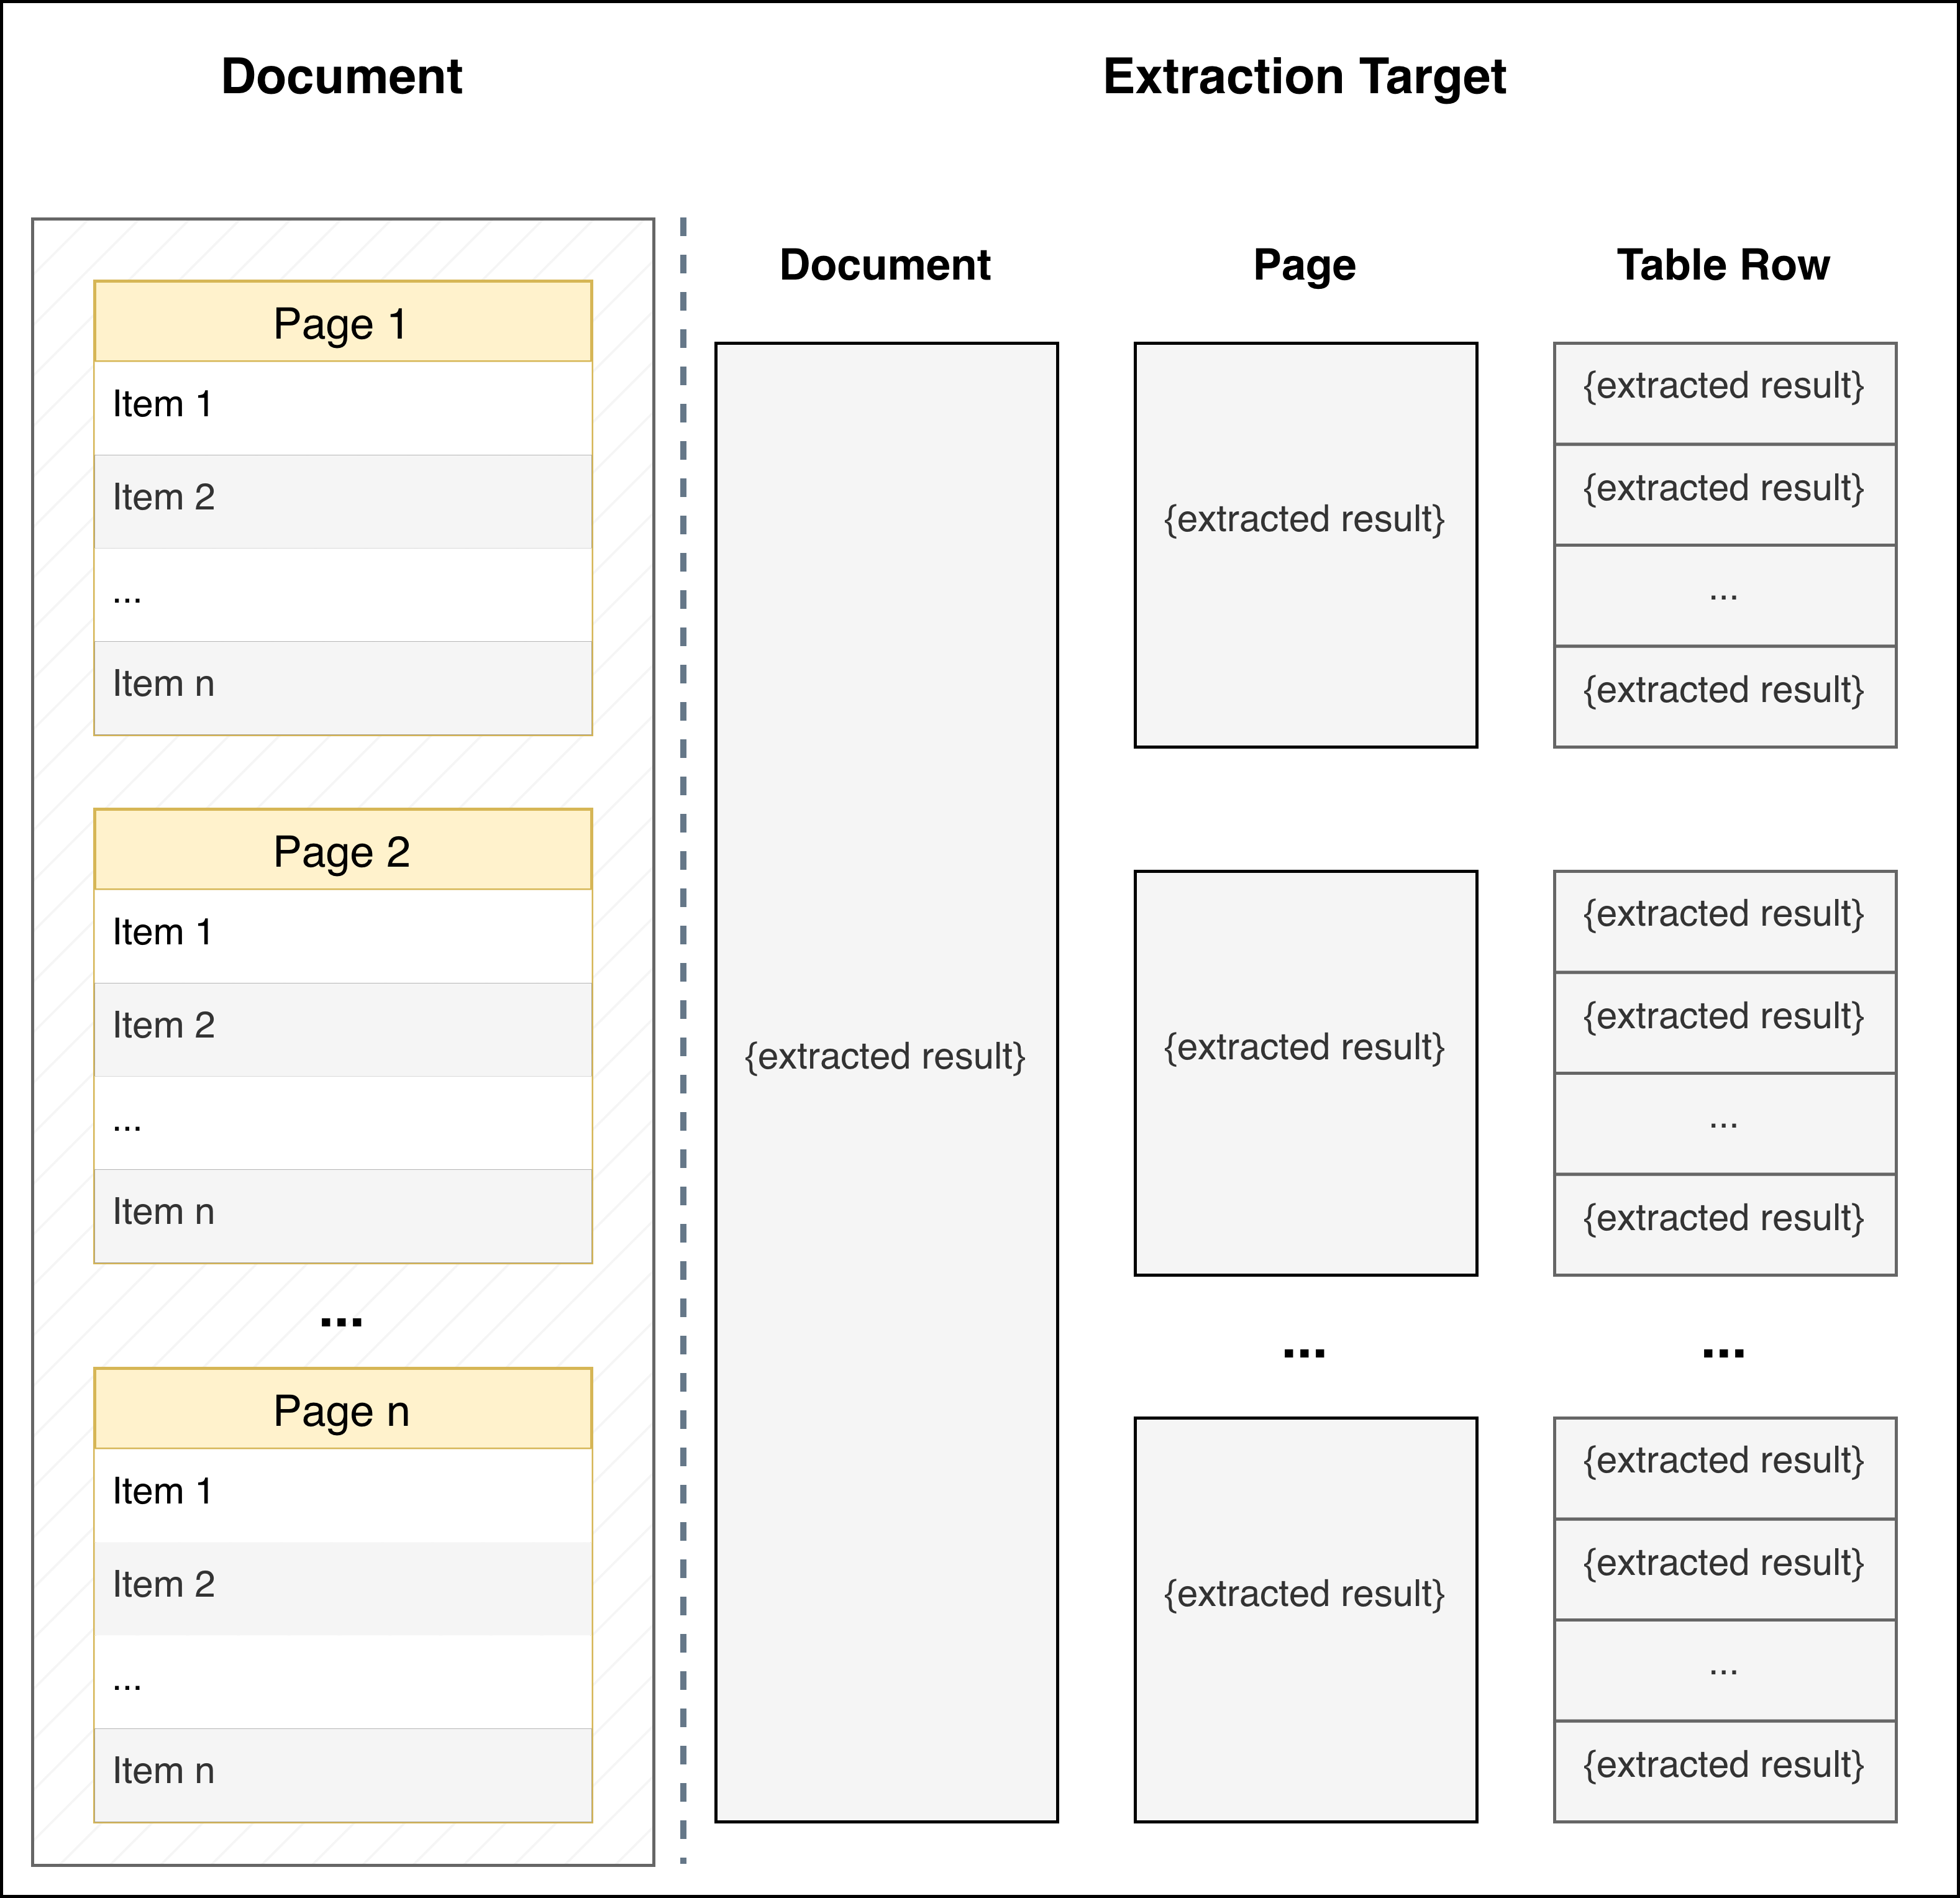
| PER_DOC(默认) | PER_PAGE | PER_TABLE_ROW | |
|---|---|---|---|
| 什么时候用 | 默认模式,按你的 JSON schema 从整份文档抽数据 | 每一页各自包含一个不同实体的信息(例如每页是不同投资组合公司的财务数据) | 文档里是一份实体的有序列表(表格、项目符号或编号列表、或以标题分隔),你想为每个实体抽取同样的信息 |
| 怎么工作 | schema 作为整体应用到整份文档 | schema 独立地应用到文档的每一页 | schema 应用到文档中识别出的每个实体。LlamaExtract 会自动检测区分实体的排版模式(表格行、列表项、章节标题等) |
| 返回什么 | 一个符合你 schema 的 JSON 对象 | 一个 JSON 对象数组,每页一个,各自符合你的 schema | 一个 JSON 对象数组,每个实体/行一个,各自符合你的 schema |
| 典型场景 | 从合同、年报或论文里抽取汇总信息 | 每页代表一个实体的多页表单,或每页一条记录的文档 | - 发票行项目(每行是一个产品/服务) |
- 员工名单或通讯录
- 含多条明细的采购订单
- 任何含重复结构化实体的文档 | | 要点 | - | 你的 schema 应描述单个实体/单页,而不是一个列表。不要写
extracted_result: list[template],而是直接给出会被应用到页级的那个模板 | * 你的 schema 应描述单个实体,而不是一个列表。不要写extracted_result: list[template],而是直接给出会被应用到实体级的那个模板
- 文档需要有某种区分不同实体的排版或结构(表格格式、项目符号、编号、标题等)
- 实体在文档中应按有序方式出现 |