
主题
LlamaIndex 允许你在索引结构之上执行查询变换。查询变换是把一个查询转换成另一个查询的模块。它可以是单步的,即变换只执行一次,随后查询就打到索引上。
它也可以是多步的,即:
- 查询被变换,并打到索引上执行,
- 取回回答。
- 后续的查询以依次递进的方式继续被变换/执行。
下面更详细地列出我们的几种查询变换。
用途
查询变换有多个用途:
- 把初始查询转换成更容易嵌入的形式(例如 HyDE)
- 把初始查询转换成一个更容易从数据中得到答案的子问题(单步查询分解)
- 把初始查询拆成多个各自更容易回答的子问题(多步查询分解)
HyDE(假设文档嵌入)
HyDE 的技术是:给定一个自然语言查询,先生成一个假设性的文档/回答,然后用这个假设文档去做嵌入查找,而不是用原始查询。
使用 HyDE 的示例代码如下。
from llama_index.core import VectorStoreIndex, SimpleDirectoryReader
from llama_index.core.indices.query.query_transform.base import (
    HyDEQueryTransform,
)
from llama_index.core.query_engine import TransformQueryEngine

# load documents, build index
documents = SimpleDirectoryReader("../paul_graham_essay/data").load_data()
index = VectorStoreIndex(documents)

# run query with HyDE query transform
query_str = "what did paul graham do after going to RISD"
hyde = HyDEQueryTransform(include_original=True)
query_engine = index.as_query_engine()
query_engine = TransformQueryEngine(query_engine, query_transform=hyde)
response = query_engine.query(query_str)
print(response)完整演练请看我们的示例 notebook。
多步查询变换
多步查询变换是对既有单步查询变换方法的推广。
给定一个初始的复杂查询,先对它做变换并打到索引上执行,取回该查询的回答。再结合这个回答(以及此前的回答)与原查询,可以继续对索引提出后续问题。这样一来,同一个查询就能反复打到同一个知识源上,直到满足所有子问题为止。
下面是一张示例图。
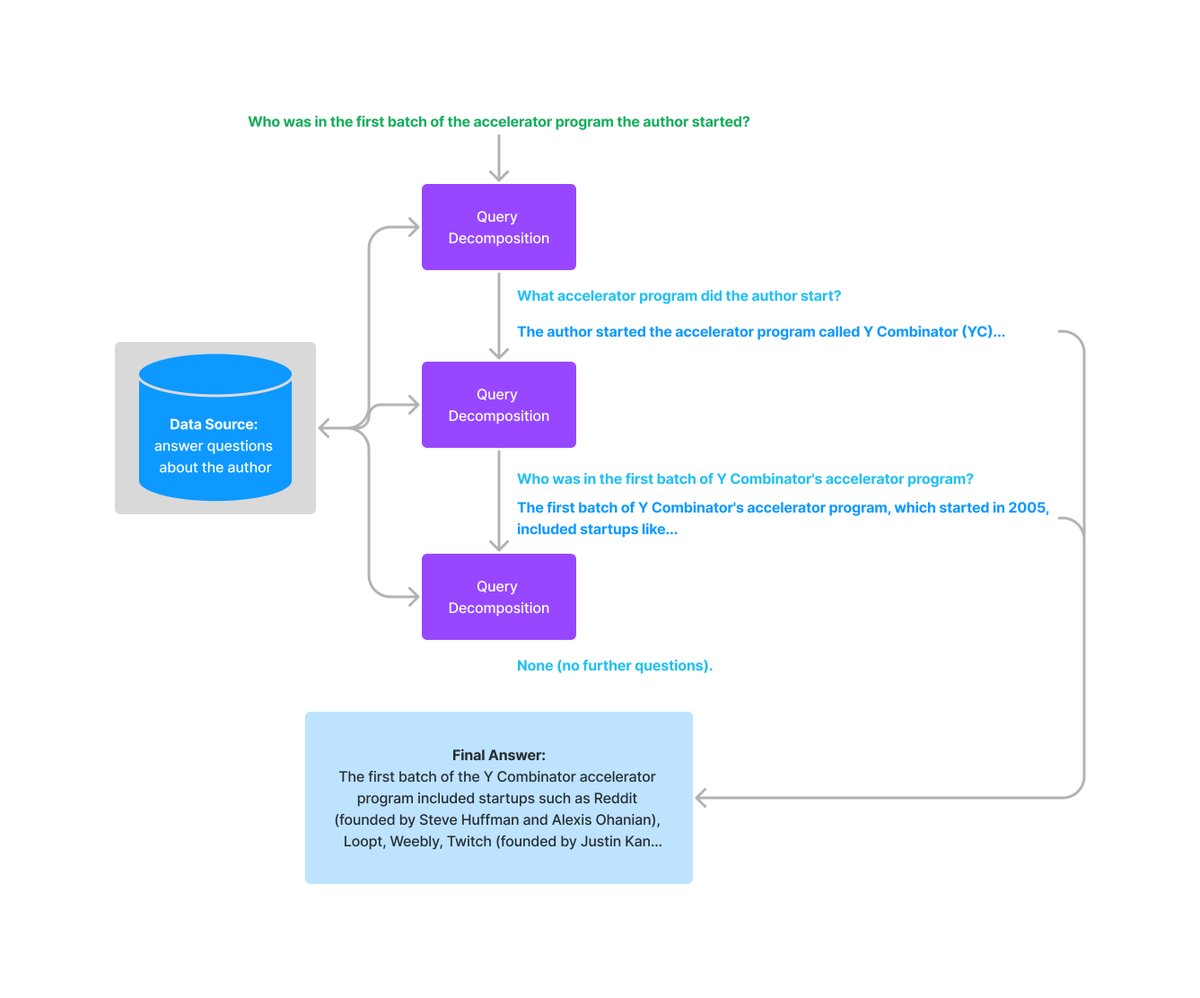
对应的示例代码如下。
from llama_index.core.indices.query.query_transform.base import (
    StepDecomposeQueryTransform,
)

# gpt-4
step_decompose_transform = StepDecomposeQueryTransform(llm, verbose=True)

query_engine = index.as_query_engine()
query_engine = MultiStepQueryEngine(
    query_engine, query_transform=step_decompose_transform
)

response = query_engine.query(
    "Who was in the first batch of the accelerator program the author started?",
)
print(str(response))完整演练请看我们的示例 notebook。