
主题
概念
嵌入(Embeddings)在 LlamaIndex 中用于以精细的数值表示来表征你的文档。嵌入模型接受文本作为输入,返回一长串用于捕捉文本语义的数字。这些嵌入模型本就是按这种方式训练出来的,并支撑起许多应用,其中就包括检索!
往大了说:如果用户提了一个关于狗的问题,那么这个问题的嵌入就会与谈论狗的那段文本的嵌入高度相似。
在计算嵌入之间的相似度时,可选方法有很多(点积、余弦相似度等等)。LlamaIndex 默认使用余弦相似度来比较嵌入。
可挑选的嵌入模型有很多。LlamaIndex 默认使用 OpenAI 的 text-embedding-ada-002。我们也支持 Langchain 在此处提供的任意嵌入模型,并提供一个易于扩展的基类,方便你自己实现嵌入。
使用方式
在 LlamaIndex 里最常见的用法是:在 Settings 对象中指定嵌入模型,然后把它用在向量索引中。构建索引时,嵌入模型用于嵌入各文档;之后你用查询引擎提问时,它也用于嵌入你的查询。你也可以为每个索引单独指定嵌入模型。
如果还没安装你的嵌入包:
终端窗口
pip install llama-index-embeddings-openai然后:
from llama_index.embeddings.openai import OpenAIEmbedding
from llama_index.core import VectorStoreIndex
from llama_index.core import Settings

# changing the global default
Settings.embed_model = OpenAIEmbedding()

# local usage
embedding = OpenAIEmbedding().get_text_embedding("hello world")
embeddings = OpenAIEmbedding().get_text_embeddings(
    ["hello world", "hello world"]
)

# per-index
index = VectorStoreIndex.from_documents(documents, embed_model=embed_model)为了节省成本,你可能想用本地模型。
终端窗口
pip install llama-index-embeddings-huggingfacefrom llama_index.embeddings.huggingface import HuggingFaceEmbedding
from llama_index.core import Settings
Settings.embed_model = HuggingFaceEmbedding(
model_name="BAAI/bge-small-en-v1.5"
)这会使用 Hugging Face 上一个表现良好且快速的默认模型。
更多使用细节与可用的定制选项见下文。
开始使用
嵌入模型最常见的用法是设置到全局 Settings 对象里,然后用它构建索引并查询。输入文档会被切成节点,嵌入模型为每个节点生成一个嵌入。
如果你不设置 Settings.embed_model,LlamaIndex 会退回 OpenAIEmbedding 的默认值 text-embedding-ada-002。下面的例子演示如何显式指定一个当前的 OpenAI 模型——新项目建议都这么做。
from llama_index.core import VectorStoreIndex, SimpleDirectoryReader
from llama_index.embeddings.openai import OpenAIEmbedding
from llama_index.core import Settings
# global default: select a current OpenAI model explicitly
Settings.embed_model = OpenAIEmbedding(model="text-embedding-3-small")
documents = SimpleDirectoryReader("./data").load_data()
index = VectorStoreIndex.from_documents(documents)然后到了查询阶段,这个嵌入模型会再次被用来嵌入查询文本。
query_engine = index.as_query_engine()
response = query_engine.query("query string")选择嵌入模型
可选择的嵌入模型很多。就本文撰写时而言,各常见场景一个合理的起点是:
- 零负担的托管 API:
OpenAIEmbedding(model="text-embedding-3-small")。无需自己托管模型,通用质量不错。 - 本地运行、小巧快速(~22-33M 参数):
HuggingFaceEmbedding("BAAI/bge-small-en-v1.5")或HuggingFaceEmbedding("sentence-transformers/all-MiniLM-L6-v2")。 - 本地运行、中等体量、较新架构(~150M 参数):
HuggingFaceEmbedding("lightonai/DenseOn")(2026 年 4 月发布)。从小基线向上迈一步的自然选择,又不必背上 0.6B+ 的模型。 - 本地运行、精度更强、多语言(~0.6-4B 参数):
HuggingFaceEmbedding("Qwen/Qwen3-Embedding-0.6B")(显存充裕可上-4B)。 - 纯 CPU 部署、在意吞吐:上面任一本地选项加
backend="openvino";基准数据见 ONNX / OpenVINO 一节。
MTEB 榜单是大家常用的比较入口,可在准确度、速度与多语言支持之间横向对比当前模型。
重要:如果你在完成索引之后更换嵌入模型,就必须重建索引。不同模型的嵌入不可互相替换。
定制
批大小
默认情况下,嵌入请求会以每批 10 条发给 OpenAI。对某些用户(很少见)这可能触发限流;而当你需要嵌入大量文档时,这个批大小又可能太小。
# set the batch size to 42
embed_model = OpenAIEmbedding(embed_batch_size=42)本地嵌入模型
使用本地模型最省事的方式,是用 llama-index-embeddings-huggingface 提供的 HuggingFaceEmbedding:
# pip install llama-index-embeddings-huggingface
from llama_index.embeddings.huggingface import HuggingFaceEmbedding
from llama_index.core import Settings

Settings.embed_model = HuggingFaceEmbedding(
    model_name="BAAI/bge-small-en-v1.5"
)它加载的是小巧快速的(~33M 参数)BAAI/bge-small-en-v1.5 嵌入模型。你可以使用 Hugging Face 上任意 Sentence Transformers 嵌入模型。到 MTEB 榜单上可以横向比较当前可选项。
作为中等体量的进阶选择(~150M 参数),lightonai/DenseOn 是 2026 年 4 月的发布:当小基线不够准、而你又不想服务一个 0.6B+ 模型时,它是个不错的选项:
Settings.embed_model = HuggingFaceEmbedding(model_name="lightonai/DenseOn")若追求更强准确度与多语言覆盖,可以换用更大的现代模型,例如 Qwen/Qwen3-Embedding-0.6B(单卡想要更高准确度可用 Qwen/Qwen3-Embedding-4B):
Settings.embed_model = HuggingFaceEmbedding(
    model_name="Qwen/Qwen3-Embedding-0.6B"
)除了 HuggingFaceEmbedding 构造函数自身的关键字参数,其余关键字参数会透传给底层的 SentenceTransformer 实例,例如 backend、model_kwargs、truncate_dim、revision 等。
ONNX 或 OpenVINO 优化
LlamaIndex 也支持用 ONNX 或 OpenVINO 加速本地推理,做法是依托 Sentence Transformers 与 Optimum。
一些前置条件:
终端窗口
pip install llama-index-embeddings-huggingface
# Plus any of the following:
pip install optimum[onnxruntime-gpu] # For ONNX on GPUs
pip install optimum[onnxruntime]     # For ONNX on CPUs
pip install optimum-intel[openvino] # For OpenVINO创建时指定模型与输出路径:
from llama_index.embeddings.huggingface import HuggingFaceEmbedding
from llama_index.core import Settings

Settings.embed_model = HuggingFaceEmbedding(
    model_name="BAAI/bge-small-en-v1.5",
    backend="onnx",  # or "openvino"
)如果模型仓库中还没有 ONNX 或 OpenVINO 模型,就会用 Optimum 自动完成转换。各选项的基准数据见 Sentence Transformers 文档。
如果我想用某个已优化或已量化的模型 checkpoint 呢?
嵌入模型往往同时提供多个 ONNX 和/或 OpenVINO checkpoint,例如 sentence-transformers/all-mpnet-base-v2 就有 2 个 OpenVINO checkpoint 和 9 个 ONNX checkpoint。各选项及其预期性能的更多细节见 Sentence Transformers 文档。
你可以在 model_kwargs 参数里指定 file_name 来加载特定 checkpoint。例如加载 sentence-transformers/all-mpnet-base-v2 仓库中的 openvino/openvino_model_qint8_quantized.xml:
from llama_index.embeddings.huggingface import HuggingFaceEmbedding
from llama_index.core import Settings

quantized_model = HuggingFaceEmbedding(
    model_name="sentence-transformers/all-mpnet-base-v2",
    backend="openvino",
    device="cpu",
    model_kwargs={"file_name": "openvino/openvino_model_qint8_quantized.xml"},
)
Settings.embed_model = quantized_modelCPU 上该选哪个方案?
如 Sentence Transformers 的基准所示,量化到 int8 的 OpenVINO(openvino_model_qint8_quantized.xml)性能非常出色,代价是一点点准确度。如果你要求结果完全一致,那么基础的 backend=“openvino” 或 backend=“onnx” 可能反而是最稳的选择。
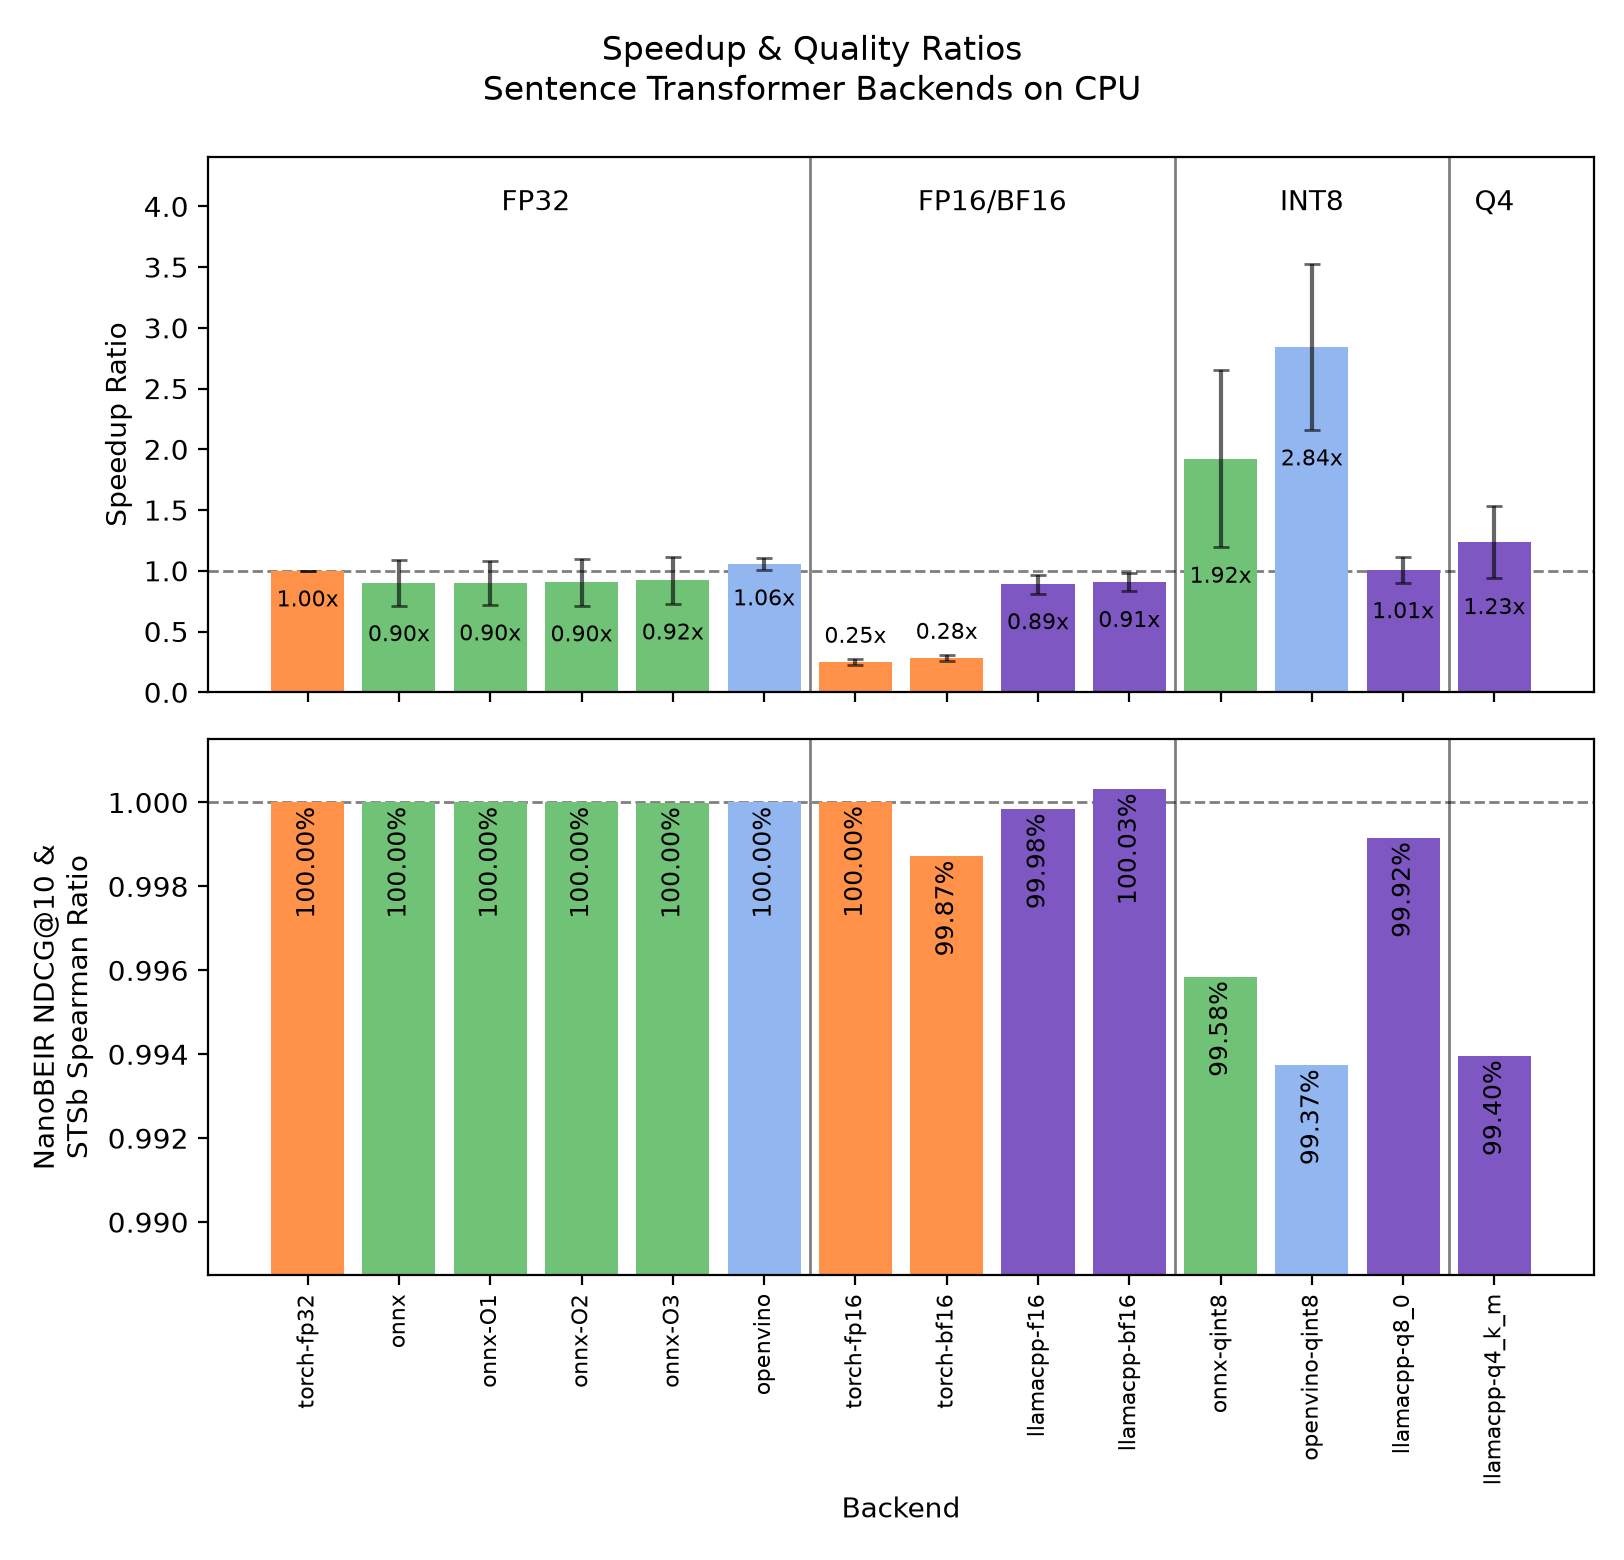
针对这个查询和这批文档,使用 int8 量化的 OpenVINO 与默认的 Hugging Face 模型相比,得到如下结果:
query = "Which planet is known as the Red Planet?"
documents = [
    "Venus is often called Earth's twin because of its similar size and proximity.",
    "Mars, known for its reddish appearance, is often referred to as the Red Planet.",
    "Jupiter, the largest planet in our solar system, has a prominent red spot.",
    "Saturn, famous for its rings, is sometimes mistaken for the Red Planet.",
]HuggingFaceEmbedding(device='cpu'):
- Average throughput: 38.20 queries/sec (over 5 runs)
- Query-document similarities tensor([[0.7783, 0.4654, 0.6919, 0.7010]])
HuggingFaceEmbedding(backend='openvino', device='cpu', model_kwargs={'file_name': 'openvino_model_qint8_quantized.xml'}):
- Average throughput: 266.08 queries/sec (over 5 runs)
- Query-document similarities tensor([[0.7492, 0.4623, 0.6606, 0.6556]])在保持文档排序不变的前提下,这是 6.97 倍加速。
点击查看复现脚本
import time
from llama_index.embeddings.huggingface import HuggingFaceEmbedding
from llama_index.core import Settings

quantized_model = HuggingFaceEmbedding(
    model_name="sentence-transformers/all-mpnet-base-v2",
    backend="openvino",
    device="cpu",
    model_kwargs={"file_name": "openvino/openvino_model_qint8_quantized.xml"},
)
quantized_model_desc = "HuggingFaceEmbedding(backend='openvino', device='cpu', model_kwargs={'file_name': 'openvino_model_qint8_quantized.xml'})"
baseline_model = HuggingFaceEmbedding(
    model_name="sentence-transformers/all-mpnet-base-v2",
    device="cpu",
)
baseline_model_desc = "HuggingFaceEmbedding(device='cpu')"

query = "Which planet is known as the Red Planet?"

def bench(model, query, description):
    for _ in range(3):
        model.get_agg_embedding_from_queries([query] * 32)

    sentences_per_second = []
    for _ in range(5):
        queries = [query] * 512
        start_time = time.time()
        model.get_agg_embedding_from_queries(queries)
        sentences_per_second.append(len(queries) / (time.time() - start_time))

    print(
        f"{description:<120}: Avg throughput: {sum(sentences_per_second) / len(sentences_per_second):.2f} queries/sec (over 5 runs)"
    )

bench(baseline_model, query, baseline_model_desc)
bench(quantized_model, query, quantized_model_desc)

# Example documents for similarity comparison. The first is the correct one, and the rest are distractors.
docs = [
    "Mars, known for its reddish appearance, is often referred to as the Red Planet.",
    "Venus is often called Earth's twin because of its similar size and proximity.",
    "Jupiter, the largest planet in our solar system, has a prominent red spot.",
    "Saturn, famous for its rings, is sometimes mistaken for the Red Planet.",
]

baseline_query_embedding = baseline_model.get_query_embedding(query)
baseline_doc_embeddings = baseline_model.get_text_embedding_batch(docs)

quantized_query_embedding = quantized_model.get_query_embedding(query)
quantized_doc_embeddings = quantized_model.get_text_embedding_batch(docs)

baseline_similarity = baseline_model._model.similarity(
    baseline_query_embedding, baseline_doc_embeddings
)
print(
    f"{baseline_model_desc:<120}: Query-document similarities {baseline_similarity}"
)
quantized_similarity = quantized_model._model.similarity(
    quantized_query_embedding, quantized_doc_embeddings
)
print(
    f"{quantized_model_desc:<120}: Query-document similarities {quantized_similarity}"
)GPU 上该选哪个方案?
在 GPU 上,OpenVINO 并不特别有吸引力;而 ONNX 也未必优于在默认 torch 后端里跑的量化模型。
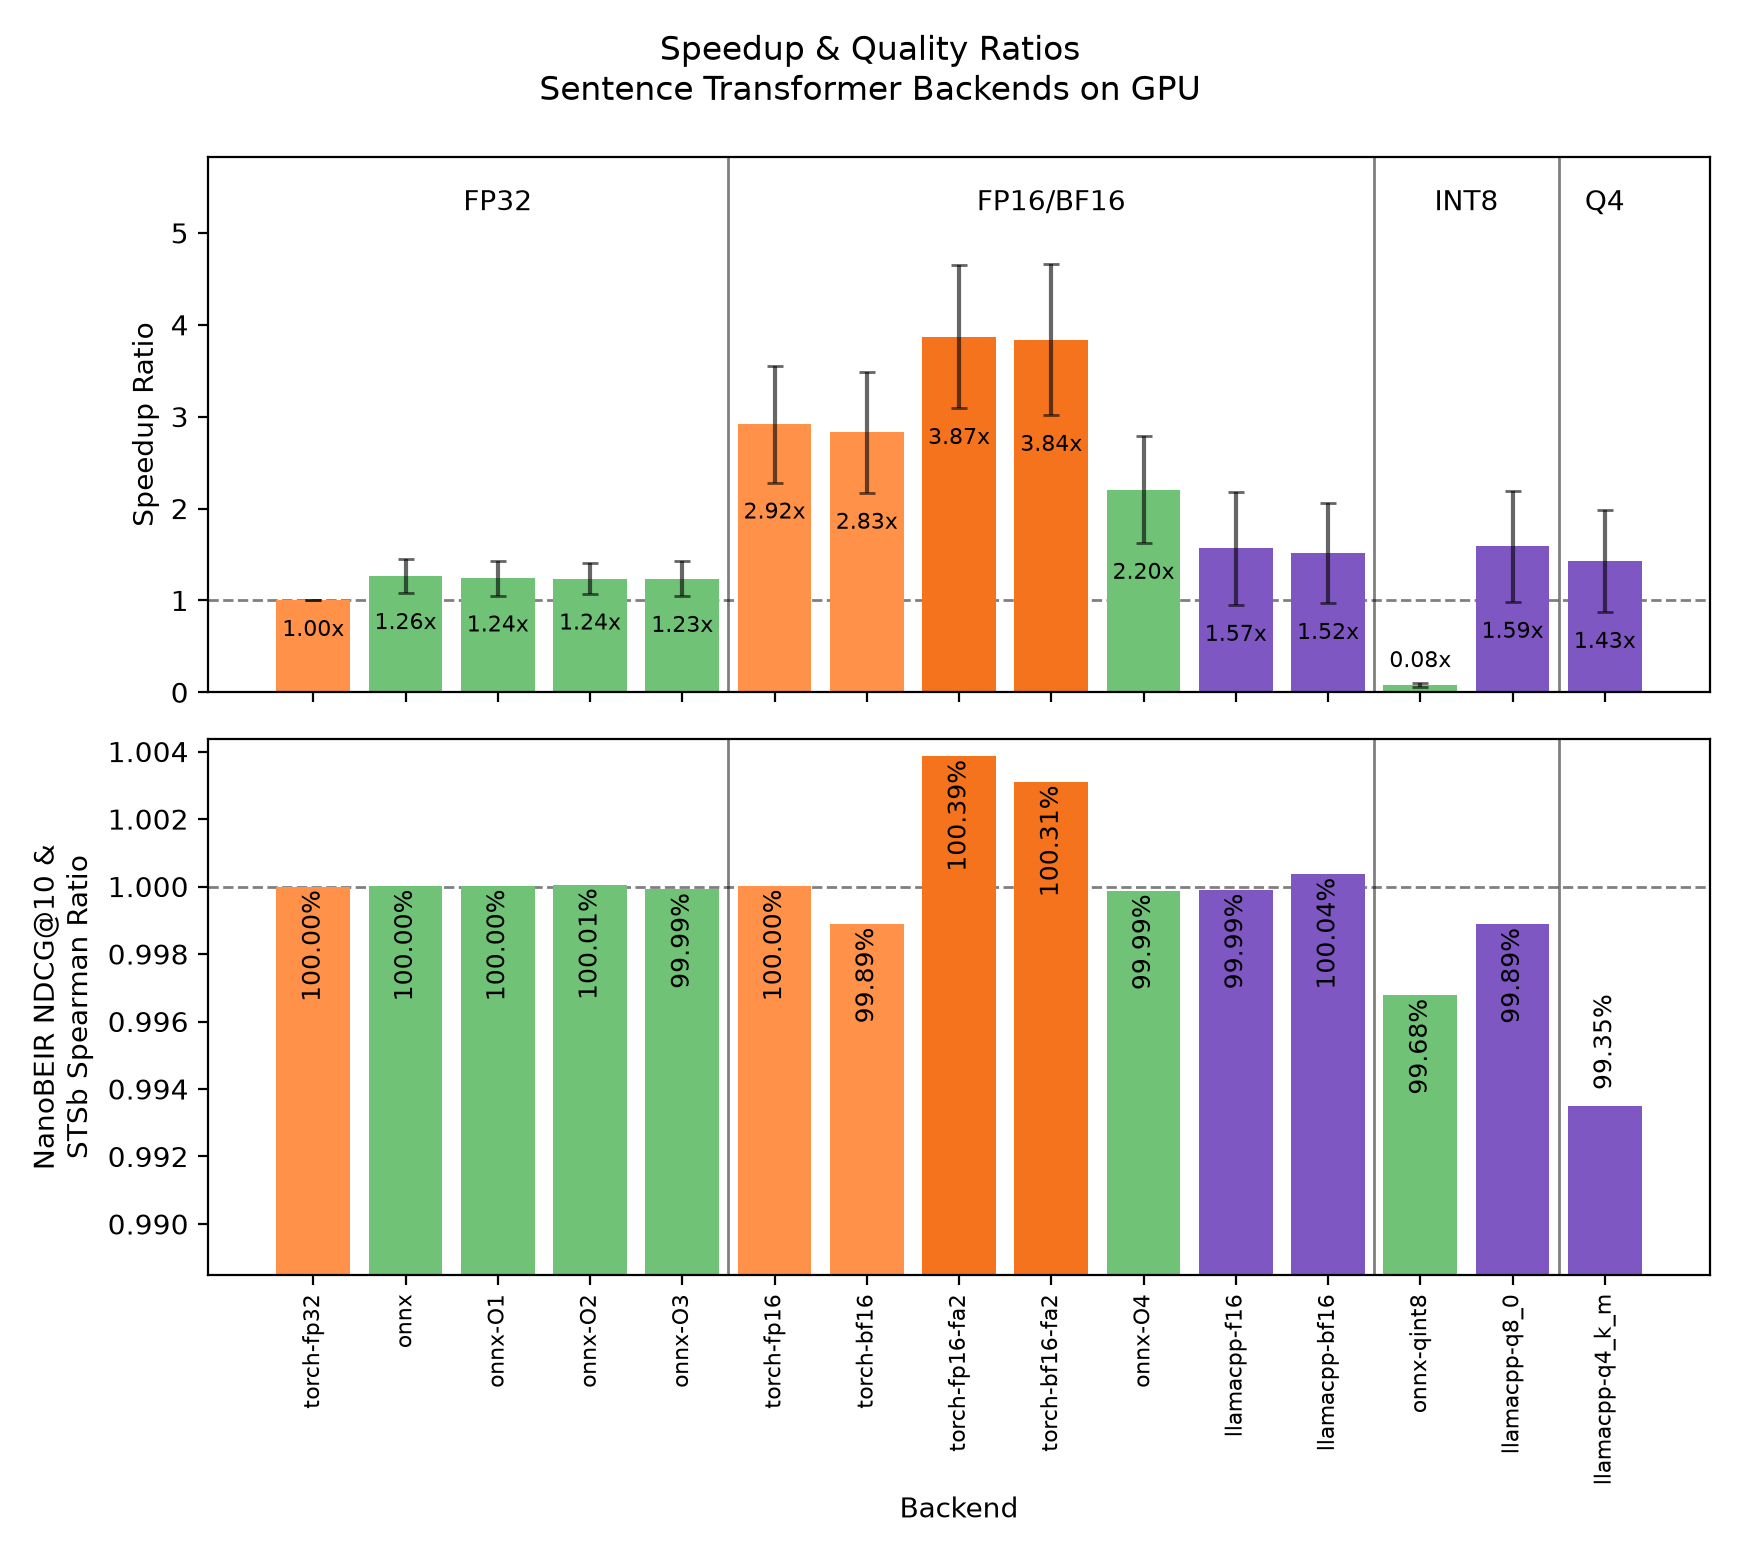
这意味着你在 GPU 上不必引入额外依赖就能获得明显加速,只需在加载模型时使用更低精度:
from llama_index.embeddings.huggingface import HuggingFaceEmbedding
from llama_index.core import Settings

Settings.embed_model = HuggingFaceEmbedding(
    model_name="BAAI/bge-small-en-v1.5",
    device="cuda",
    model_kwargs={"torch_dtype": "float16"},
)如果我想要的模型没有我想要的后端、优化或量化方案呢?
可以用 backend-export 这个 Hugging Face Space,把任意 Sentence Transformers 模型转换成应用了量化或优化的 ONNX 或 OpenVINO 版本。它会向模型仓库发起一个包含转换后文件的 pull request。之后你就能在 LlamaIndex 里通过指定 revision 参数来使用这个模型:
from llama_index.embeddings.huggingface import HuggingFaceEmbedding
from llama_index.core import Settings

Settings.embed_model = HuggingFaceEmbedding(
    model_name="BAAI/bge-small-en-v1.5",
    backend="openvino",
    revision="refs/pr/16",  # for pull request 16: https://huggingface.co/BAAI/bge-small-en-v1.5/discussions/16
    model_kwargs={"file_name": "openvino_model_qint8_quantized.xml"},
)LangChain 集成
我们也支持 Langchain 在这里提供的任意嵌入。
下面的例子用 Langchain 的嵌入类,从 Hugging Face 加载一个模型。
pip install llama-index-embeddings-langchainfrom langchain.embeddings.huggingface import HuggingFaceBgeEmbeddings
from llama_index.core import Settings
Settings.embed_model = HuggingFaceBgeEmbeddings(model_name="BAAI/bge-base-en")自定义嵌入模型
如果你想用的嵌入既不在 LlamaIndex 也不在 Langchain 的提供之列,还可以继承我们的嵌入基类自己实现一个!
下面的例子使用 Instructor Embeddings(安装/配置说明见这里),实现了一个自定义嵌入类。Instructor 嵌入的做法是同时提供文本,以及关于这段文本所属领域的“指示语”。当你要嵌入的主题非常特定、高度专业化时,这很有用。
from typing import Any, List
from InstructorEmbedding import INSTRUCTOR
from llama_index.core.embeddings import BaseEmbedding

class InstructorEmbeddings(BaseEmbedding):
    def __init__(
        self,
        instructor_model_name: str = "hkunlp/instructor-large",
        instruction: str = "Represent the Computer Science documentation or question:",
        **kwargs: Any,
    ) -> None:
        super().__init__(**kwargs)
        self._model = INSTRUCTOR(instructor_model_name)
        self._instruction = instruction

    def _get_query_embedding(self, query: str) -> List[float]:
        embeddings = self._model.encode([[self._instruction, query]])
        return embeddings[0]

    def _get_text_embedding(self, text: str) -> List[float]:
        embeddings = self._model.encode([[self._instruction, text]])
        return embeddings[0]

    def _get_text_embeddings(self, texts: List[str]) -> List[List[float]]:
        embeddings = self._model.encode(
            [[self._instruction, text] for text in texts]
        )
        return embeddings

    async def _aget_query_embedding(self, query: str) -> List[float]:
        return self._get_query_embedding(query)

    async def _aget_text_embedding(self, text: str) -> List[float]:
return self._get_text_embedding(text)独立使用
你也可以把嵌入当作独立模块用在你的项目、既有应用里,或用于一般的测试与探索。
embeddings = embed_model.get_text_embedding(
    "It is raining cats and dogs here!"
)支持的嵌入清单
LlamaIndex 集成了大量嵌入服务商:托管 API、自托管服务以及本地模型。通过 LangChain 集成,你还能使用 LangChain 提供的任意嵌入。